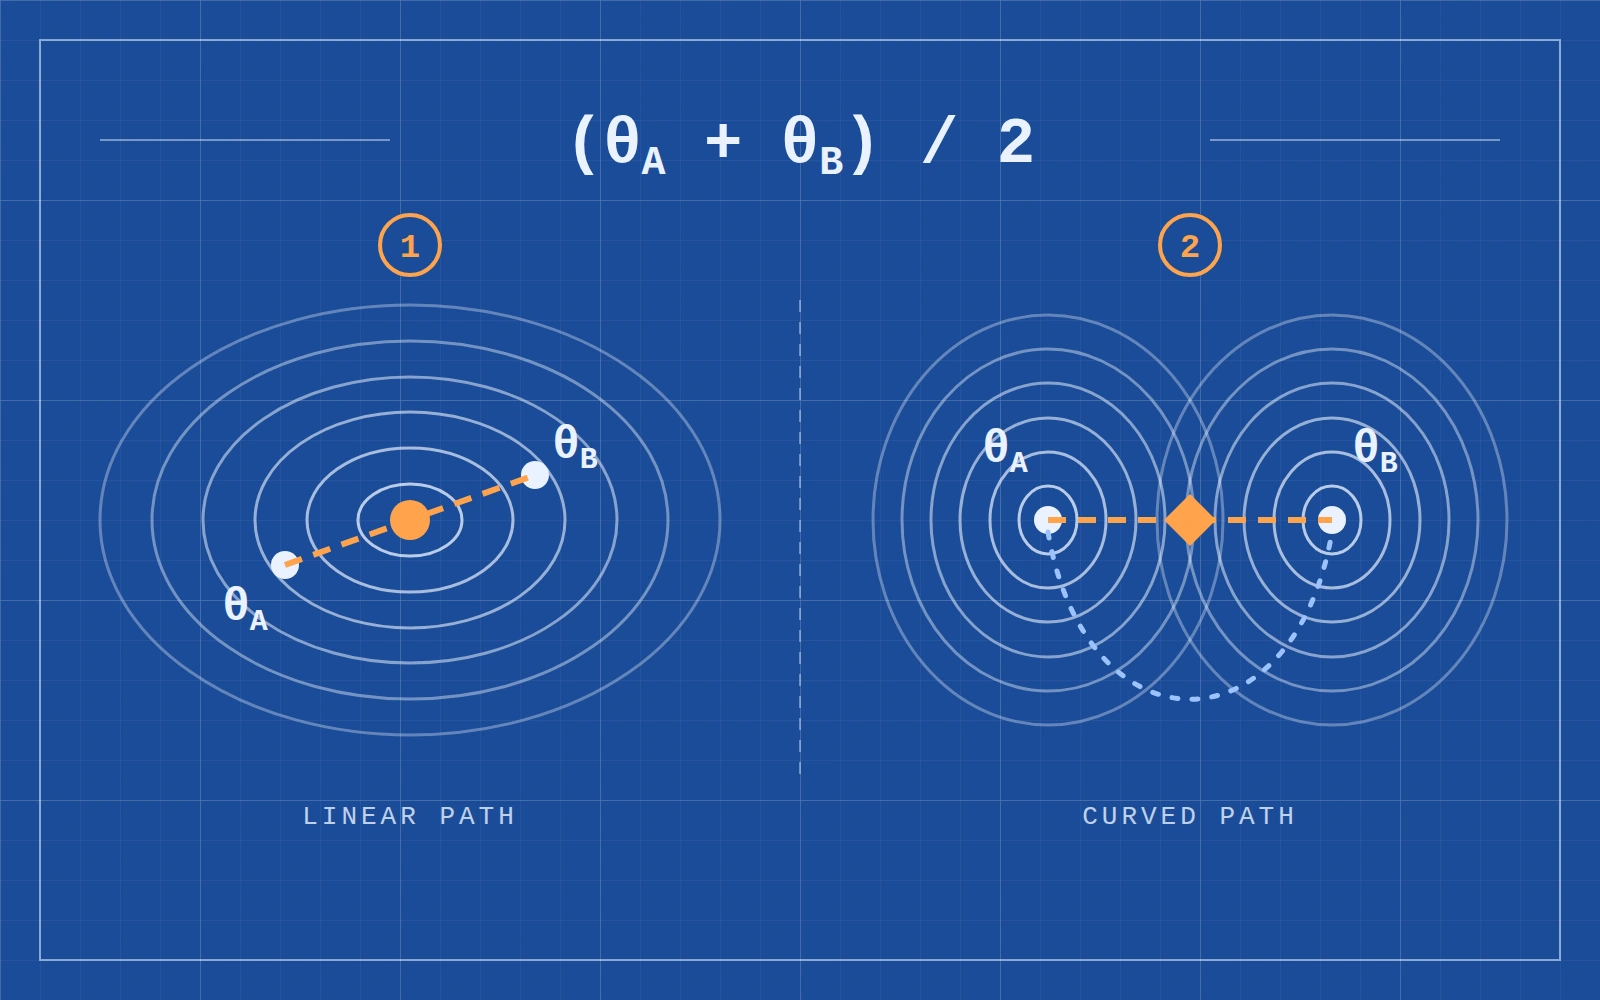
En février 2016, Brendan McMahan et ses collègues de Google déposent sur arXiv un article présentant l'algorithme d'apprentissage fédéré qui sera appelé FedAvg. Chaque appareil entraîne un modèle avec ses propres données ; le serveur se contente de moyenner les poids reçus.
Une difficulté saute aux yeux. La perte d'un réseau neuronal est non convexe ; les auteurs précisent eux-mêmes que moyenner deux modèles dans l'espace des paramètres peut donner un résultat arbitrairement mauvais.
Ils commencent donc par une petite expérience. Deux classificateurs MNIST à deux couches cachées sont entraînés chacun pendant 240 étapes sur 600 chiffres manuscrits, sans recouvrement entre les deux ensembles. Ils mélangent ensuite leurs poids dans différentes proportions et mesurent la perte sur tout l'ensemble d'entraînement.
Avec des graines différentes pour les poids initiaux, la perte explose à mi-chemin. Avec la même graine, le modèle moyen présente au contraire une perte inférieure à celle de chacun des deux modèles parents. FedAvg Figure 1
Regardons les courbes effectivement mesurées. L'abscisse est la proportion du mélange, l'ordonnée la perte sur tout l'entraînement MNIST ; les échelles verticales diffèrent entre les panneaux. À gauche, une montagne se forme au milieu ; à droite, le milieu descend sous les deux extrémités.
Cette observation n'occupe qu'une petite figure dans la deuxième section de l'article.
Huit ans plus tard, les modèles fusionnés occupent le haut de l'Open LLM Leaderboard de Hugging Face. Les tutoriels communautaires présentent la fusion comme un moyen bon marché de créer un modèle, « sans GPU ». En mars 2024, l'équipe du classement masque déjà les fusions par défaut.
Un an plus tard, Cohere réunit six experts par moyenne pondérée dans Command A, à 111 milliards de paramètres, avec seulement 1.8 % de perte moyenne par rapport aux experts individuels. En avril 2026, DeepSeek-V4 entraîne aussi des experts, mais choisit la distillation pour transmettre leurs capacités à un modèle unique. Son rapport technique précise que cela évite la dégradation souvent associée à la fusion des poids.
Partons de cette petite figure. Nous allons moyenner deux modèles sur un ordinateur portable, observer l'échec puis le corriger, avant de suivre le parcours de cette addition suivie d'une division par deux : d'une expérience d'apprentissage fédéré à l'alchimie des classements, puis aux procédures d'entraînement des grands laboratoires.
La première moitié examine les principes : pourquoi des départs différents compliquent la moyenne, et comment l'alignement ou un départ commun traitent le problème.
La seconde passe aux usages : soupes d'ajustements et vecteurs de tâche, puis classements et procédures d'entraînement.
Une première moyenne sur un ordinateur portable
Reprenons les réglages de FedAvg en remplaçant MNIST par digits, intégré à scikit-learn : 1 797 chiffres manuscrits de 8×8 pixels, sans téléchargement supplémentaire. L'architecture, le taux, la taille des lots et la durée suivent l'article : deux couches cachées de 200 unités, taux de 0.1, lots de 50 et 240 étapes.
import torch
import torch.nn as nn
from sklearn.datasets import load_digits

X, y = load_digits(return_X_y=True)                    # 1,797 張 8×8 的手寫數字
X = torch.tensor(X / 16.0, dtype=torch.float32)
y = torch.tensor(y)
perm = torch.randperm(len(X), generator=torch.Generator().manual_seed(0))
idx_a, idx_b, idx_test = perm[:600], perm[600:1200], perm[1200:]

def make(seed):
    torch.manual_seed(seed)                            # 種子決定初始權重
    return nn.Sequential(nn.Linear(64, 200), nn.ReLU(),
                         nn.Linear(200, 200), nn.ReLU(),
                         nn.Linear(200, 10))

def train(model, idx, seed):
    opt = torch.optim.SGD(model.parameters(), lr=0.1)
    g = torch.Generator().manual_seed(seed)            # 種子決定資料順序
    for epoch in range(20):                            # 600 張、批次 50,共 240 步
        order = idx[torch.randperm(len(idx), generator=g)]
        for b in order.split(50):
            loss = nn.functional.cross_entropy(model(X[b]), y[b])
            opt.zero_grad()
            loss.backward()
            opt.step()
    return model
make utilise sa graine pour fixer les poids initiaux ; celle de train fixe l'ordre des données. Les deux ensembles de 600 images sont disjoints ; les 597 restantes servent au test.
Ajoutons deux petits outils. mix mélange les poids selon le coefficient :
correspond à l'addition divisée par deux. evaluate renvoie la perte sur les deux ensembles d'entraînement réunis et la précision de test.
def mix(m1, m2, t):
    sd1, sd2 = m1.state_dict(), m2.state_dict()
    merged = make(0)
    merged.load_state_dict({k: t * sd1[k] + (1 - t) * sd2[k] for k in sd1})
    return merged

@torch.no_grad()
def evaluate(model):
    seen = torch.cat([idx_a, idx_b])                   # 兩份訓練資料合起來
    loss = nn.functional.cross_entropy(model(X[seen]), y[seen]).item()
    acc = (model(X[idx_test]).argmax(1) == y[idx_test]).float().mean().item()
    return f"loss {loss:.3f}, 測試 {acc:.1%}"

for name, seed_a, seed_b in [("不同起點", 1, 2), ("同一起點", 1, 1)]:
    A = train(make(seed_a), idx_a, seed=10)
    B = train(make(seed_b), idx_b, seed=20)
    print(name)
    print("  A   :", evaluate(A))
    print("  B   :", evaluate(B))
    print("  平均:", evaluate(mix(A, B, 0.5)))
不同起點
  A   : loss 0.264, 測試 92.1%
  B   : loss 0.270, 測試 93.0%
  平均: loss 1.277, 測試 83.4%
同一起點
  A   : loss 0.264, 測試 92.1%
  B   : loss 0.266, 測試 93.3%
  平均: loss 0.252, 測試 93.6%
Les modèles de départs différents atteignent chacun environ 92 % et 93 % de précision de test. Leur moyenne descend à 83.4 %, et la perte passe d'environ 0.27 à 1.277.
Avec le départ commun, le modèle moyen a une perte de 0.252, sous les 0.264 de A et les 0.266 de B. Sa précision de test, 93.6 %, dépasse aussi les deux parents. Chacun n'a vu que la moitié des données, mais leur moyenne fait mieux sur l'entraînement réuni. Nous retrouvons sur ce petit jeu la tendance du panneau droit de FedAvg.
Nous n'effectuons ici qu'un entraînement séparé et une moyenne. FedAvg complet renvoie le modèle moyen aux appareils, les laisse effectuer quelques mises à jour, puis recueille et pondère leurs poids selon la quantité de données, à plusieurs reprises. Nos ensembles égaux permettent de diviser par deux ; avec des quantités différentes, les coefficients doivent suivre. Comprendre ce tour unique aidera à suivre les tours fédérés successifs.
Balayons de 0 à 1 pour voir la courbe complète :
Cinq paires de graines donnent la même conclusion. En moyenne, les parents atteignent 92.9 % de précision de test ; la moyenne de départs différents donne 80.2 %, celle d'un départ commun 93.6 %. Les dernières décimales peuvent varier selon la machine ou la version de PyTorch.
Le même réseau, dans un autre ordre
Pourquoi la moyenne échoue-t-elle avec des départs différents ? Prenons un cas encore plus extrême.
Les 200 unités cachées n'ont pas d'ordre imposé. Échanger les unités 3 et 7, en échangeant aussi leurs positions d'entrée dans la couche suivante, conserve exactement le calcul du réseau. Les lignes des matrices ont changé de place, la fonction reste identique.
Hecht-Nielsen discutait déjà cette symétrie de permutation en 1990. Git Re-Basin §1
Avec deux couches de 200 unités, les seules permutations donnent écritures équivalentes, soit environ , toutes pour le même modèle.
Moyennons donc A et une version réordonnée de A :
def permute(model, p1, p2):
    sd = {k: v.clone() for k, v in model.state_dict().items()}
    sd["0.weight"], sd["0.bias"] = sd["0.weight"][p1], sd["0.bias"][p1]  # 第一層的 200 個單元換位
    sd["2.weight"] = sd["2.weight"][:, p1]                              # 下一層讀輸入的順序跟著換
    sd["2.weight"], sd["2.bias"] = sd["2.weight"][p2], sd["2.bias"][p2]  # 第二層的 200 個單元換位
    sd["4.weight"] = sd["4.weight"][:, p2]
    out = make(0)
    out.load_state_dict(sd)
    return out

A = train(make(1), idx_a, seed=10)
g = torch.Generator().manual_seed(100)
A2 = permute(A, torch.randperm(200, generator=g), torch.randperm(200, generator=g))

print(torch.allclose(A(X), A2(X), atol=1e-5))         # 每一張圖的輸出都一樣嗎?
print("A   :", evaluate(A))
print("A2  :", evaluate(A2))
print("平均:", evaluate(mix(A, A2, 0.5)))
True
A   : loss 0.264, 測試 92.1%
A2  : loss 0.264, 測試 92.1%
平均: loss 1.215, 測試 84.3%
True indique des sorties identiques sur les 1 797 images à une tolérance de 0.00001, et les deux précisions valent 92.1 %. Pourtant, la moyenne tombe à 84.3 %.
Même la moyenne d'un modèle avec lui-même échoue si les positions correspondent mal. L'unité 3 de A est moyennée avec la position 3 de A2, occupée en réalité par une autre unité de A, responsable d'une autre caractéristique. Prendre la moitié de deux détecteurs sans rapport produit souvent un détecteur qui ne ressemble à aucun des deux.
Deux modèles entraînés avec des graines différentes peuvent rencontrer le même problème : des caractéristiques semblables, placées ailleurs.
Aligner, puis moyenner
Si l'ordre pose problème, commençons par l'aligner. En 2021, Entezari et al. conjecturent qu'en tenant compte de toutes les permutations, les solutions trouvées par SGD sont généralement reliées par un segment sans barrière. Entezari et al.
En 2022, Git Re-Basin propose des méthodes pour trouver ces permutations. La plus simple, weight matching, apparie les poids sans données. Pour chaque couche, on mesure la similarité de chaque paire d'unités de A et B, puis résout une affectation linéaire, par exemple avec l'algorithme hongrois, pour maximiser la similarité totale d'un appariement un à un. On compare poids entrants, biais et poids sortants. Les permutations des deux couches se contraignent mutuellement : on répète donc plusieurs passages.
from scipy.optimize import linear_sum_assignment

def match(ref, other, iters=20):
    a, b = ref.state_dict(), other.state_dict()
    p1, p2 = torch.arange(200), torch.arange(200)
    for _ in range(iters):
        # 第一層:比對每個單元的輸入權重、偏差,以及它送往下一層的權重
        s1 = (a["0.weight"] @ b["0.weight"].T
              + torch.outer(a["0.bias"], b["0.bias"])
              + a["2.weight"].T @ b["2.weight"][p2])
        p1 = torch.as_tensor(linear_sum_assignment(s1.numpy(), maximize=True)[1])
        # 第二層:同樣的比對,輸入端改用剛排好的 p1
        s2 = (a["2.weight"] @ b["2.weight"][:, p1].T
              + torch.outer(a["2.bias"], b["2.bias"])
              + a["4.weight"].T @ b["4.weight"])
        p2 = torch.as_tensor(linear_sum_assignment(s2.numpy(), maximize=True)[1])
    return permute(other, p1, p2)

A = train(make(1), idx_a, seed=10)
B = train(make(2), idx_b, seed=20)
B2 = match(A, B)
print(torch.allclose(B(X), B2(X), atol=1e-5))         # 換位不改變 B 的功能
print("直接平均  :", evaluate(mix(A, B, 0.5)))
print("對齊後平均:", evaluate(mix(A, B2, 0.5)))
True
直接平均  : loss 1.277, 測試 83.4%
對齊後平均: loss 0.383, 測試 91.6%
B2 conserve exactement la sortie de B. Sa moyenne avec A ramène la précision de test de 83.4 % à 91.6 % et la perte de 1.277 à 0.383. C'est la courbe bleu clair précédente : sa montagne centrale est bien plus basse.
Sur les cinq paires de graines, la précision remonte de 80.2 % à 92.2 %. L'alignement récupère l'essentiel, mais reste sous les 93.6 % du départ commun, sans abaisser la perte sous celle des deux parents.
Git Re-Basin retrouve cette tendance à plus grande échelle. Sur CIFAR-10, deux ResNet-20 indépendants élargis 32 fois atteignent une barrière nulle après alignement, une première à la connaissance des auteurs. Sur ImageNet, ResNet-50 standard réduit sa barrière de 67 %, sans l'annuler. Élargir le réseau facilite la connexion après alignement. Git Re-Basin
Ces courbes montrent succès et limites ensemble. Le gris est l'interpolation directe, le vert le weight matching. Le ResNet-20 élargi du troisième panneau est presque plat ; le ResNet-50 standard à droite garde une bosse. Les traits pleins mesurent l'entraînement, les pointillés le test : il faut lire les deux.
Les expériences CIFAR passent aussi à LayerNorm. ImageNet conserve BatchNorm, dont les statistiques sont réestimées après interpolation. L'alignement doit traiter ensemble biais, normalisations et branches résiduelles ; réordonner les lignes de chaque couche laisse ces contraintes à résoudre. Notre MLP précédent les omet, ce qui permet de tout montrer en quelques dizaines de lignes.
Cette voie fonctionne, avec une affectation à résoudre par couche et une largeur suffisante.
Partir du même point
Une autre voie évite de chercher les permutations : partager une partie de la trajectoire d'entraînement.
FedAvg utilise les mêmes poids initiaux. En 2019, Frankle et al. systématisent l'expérience : dupliquer un réseau, poursuivre avec des ordres de données et augmentations différents, puis mesurer la barrière entre les résultats. Seul le plus petit réseau MNIST est sans barrière dès l'initialisation. Les autres doivent d'abord partager un peu d'entraînement : environ 3 % pour ResNet-20 sur CIFAR-10, 20 % pour ResNet-50 sur ImageNet. Après ce point, les entraînements échantillonnés aboutissent dans des régions linéairement connectées. Frankle et al., §1
La stabilité désigne ici un maximum d'erreur sur le segment inférieur à la moyenne des extrémités plus 2 points. Quand ResNet-20 atteint ce seuil, son erreur de test vaut encore environ 25 %, contre 8.3 % à la fin. Il reste beaucoup à apprendre ; ce sont les futurs points finaux qui deviennent plus faciles à mélanger. Partager seulement l'initialisation et partager une trajectoire déjà entraînée ont donc des effets différents.
En retardant la duplication, on obtient les cinq graphiques suivants. L'ordonnée mesure l'instabilité, le rouge sur le test et le violet sur l'entraînement. LeNet sur MNIST est proche de zéro dès le début ; les autres ont besoin d'un parcours commun. Les trois premiers utilisent des itérations, les deux derniers des époques : les unités de temps comptent aussi.
Notre petit MLP semble appartenir aux plus petits réseaux : dans l'expérience précédente, la même graine suffisait.
Des vallées distinctes peuvent aussi communiquer. En 2018, Garipov et al. et Draxler et al. trouvent indépendamment des chemins courbes de perte presque constante entre deux solutions entraînées séparément. Le segment direct rencontre pourtant un mur, comme dans le panneau droit ci-dessus. Garipov et al., Draxler et al.
Dans la figure originale, les couleurs mesurent réellement la perte. À gauche, les segments entre les trois solutions traversent de fortes pertes. Au centre et à droite, Bézier et ligne brisée passent par les faibles pertes. L'entraînement ajoute un chemin, sans déplacer le milieu arithmétique des extrémités.
La même année, Izmailov et al., coauteurs de Garipov, proposent SWA. Ils moyennent plusieurs instants d'un même entraînement. Un taux relativement élevé, constant ou cyclique, laisse SGD explorer le fond du bassin, puis on moyenne également les poids visités. L'article fait remonter cette idée au travail de Ruppert en 1988. Sur ImageNet, ajouter 10 époques SWA à un ResNet-50 entraîné fait passer le top-1 de 76.15 % à 76.97 %. Les auteurs l'expliquent par une moyenne placée dans une région plus plate, favorable à la généralisation. SWA Table 2
Ces coupes de CIFAR-100 avec ResNet-164 précisent l'explication. À gauche, les trois croix sont les échantillons FGE, et leur moyenne est au milieu. Au centre, on mesure l'erreur de test ; à droite, la perte d'entraînement. SGD et SWA y changent de performance relative : la perte d'entraînement minimale et l'erreur de test minimale peuvent se trouver à des endroits différents.
Ces trois idées ont des rôles distincts. La connectivité des modes montre qu'un détour existe, avec un entraînement pour trouver la courbe. La connectivité linéaire exige que le segment fonctionne aussi, ce qui concerne directement la moyenne des poids. SWA collecte des voisins sur une trajectoire pour ne déployer qu'un modèle. Un passage seulement courbe peut laisser la moyenne des extrémités à l'extérieur.
SWA donne aussi une explication locale de la proximité avec l'ensemble. Soient la moyenne des checkpoints et leurs écarts, d'où . Développons la sortie du réseau près de la moyenne :
Les termes du premier ordre s'annulent et il reste un écart du second ordre entre ensemble des sorties et modèle moyen. Des checkpoints voisins peuvent ainsi fournir un ensemble approché par un seul modèle. Si les points sont éloignés ou la non-linéarité locale forte, ce reste compte. Il faut aussi réestimer BatchNorm pour les poids moyens. Proximité et qualité du segment doivent être vérifiées pour appliquer cette explication.
Le préentraînement rend ce départ commun largement disponible. En 2020, Neyshabur et al. observent que plusieurs ajustements des mêmes poids préentraînés restent dans un même bassin, avec des caractéristiques semblables et des paramètres proches. Les entraînements depuis des initialisations aléatoires n'ont pas cette propriété. Neyshabur et al.
Quand chacun part du même CLIP ou Llama, les ajustements sont des frères issus d'un même départ. La fusion se concentre désormais sur eux.
Une soupe de modèles
La procédure habituelle entraîne plusieurs réglages, conserve le meilleur sur la validation et jette les autres.
En 2021, WiSE-FT propose une première recette simple. CLIP zéro-shot résiste assez bien aux décalages de distribution. L'ajustement améliore ImageNet, mais dégrade les distributions décalées. Mélanger linéairement les poids zéro-shot et ajustés gagne 4 à 6 points sur cinq dérivés décalés d'ImageNet par rapport aux méthodes précédentes, ainsi que 1.6 point sur ImageNet, au même coût d'inférence. WiSE-FT
Regardons les coefficients sur les six jeux. En abscisse, désigne le zéro-shot et le modèle ajusté. Le rose trace les modèles intermédiaires et l'horizontale pointillée la meilleure extrémité. Plusieurs jeux culminent au milieu, à des positions différentes : chaque distribution a son compromis.
En 2022, Model Soups s'intéresse aux modèles qu'on allait jeter. Les auteurs ajustent CLIP ViT-B/32 sur ImageNet 72 fois avec des hyperparamètres tirés aléatoirement :
- Meilleur modèle individuel : 80.38 %
- Moyenne des 72 modèles, uniform soup : 79.97 %, sous le meilleur candidat
- Soupe gloutonne, greedy soup : 81.03 %
- Ensemble des sorties des 72 modèles : 81.19 %, avec 72 exécutions à l'inférence
Ces chiffres viennent de la colonne ImageNet. À droite, Dist. shifts moyenne les cinq distributions décalées, où la soupe uniforme dépasse la gloutonne. Les données de validation choisies influencent les tests sur lesquels le modèle final sera le plus à l'aise.
La recette gloutonne est simple : trier selon la précision de validation, commencer par le meilleur, puis essayer les candidats un par un. On garde les ajouts favorables et saute les autres. Certains réglages, comme un taux trop élevé, mènent dans un autre bassin et dégradent la moyenne uniforme ; la sélection gloutonne les écarte.
Cette soupe CLIP conserve finalement 5 membres. Avec déjà modèles, le nouveau candidat vaut . Une moyenne moitié-moitié répétée favoriserait les derniers arrivés. La sélection utilise environ 2 % de l'entraînement ImageNet réservés à cet effet ; la validation officielle reste le test. Chaque ajout demande l'évaluation d'un nouveau candidat, mais aucune rétropropagation.
La garantie de non-dégradation concerne ces données de sélection ; le test reste à mesurer. Les ensembles améliorent aussi la calibration des probabilités, un gain absent des expériences de calibration des soupes. Avec un seul modèle et la précision comme priorité, la soupe attire ; avec des probabilités servant au refus ou à la revue humaine, la calibration doit aussi être comparée.
Sur ViT-G/14 préentraîné sur JFT-3B, la soupe gloutonne choisit 14 des 58 ajustements et atteint 90.94 % sur ImageNet, devant le record CoAtNet-7 de 90.88 %, avec 25 % de calcul d'inférence en moins. Model Soups Table 1, Table 3
Tous les membres de cette soupe font la même tâche. L'étape suivante réunira des tâches différentes.
Les vecteurs de tâche
Fin 2022, Ilharco et al. représentent l'ajustement par une direction. Avec les poids préentraînés et les poids ajustés sur A , prenons la différence :
est le vecteur de tâche : pour chaque poids, il décrit la direction et l'ampleur du changement pour A. On peut alors faire de l'arithmétique :
Additionner plusieurs vecteurs cherche à réunir leurs tâches ; ajouter l'opposé d'un vecteur teste la réduction de sa capacité en préservant les autres comportements. Le coefficient est choisi sur une validation réservée.
L'article teste CLIP sur huit tâches visuelles, dont voitures, textures, satellites et numéros de rue. Deux vecteurs conservent en moyenne 98.9 % de la précision des experts sur leurs deux tâches ; avec les huit vecteurs disponibles, le meilleur multitâche atteint 91.2 %. Ajuster directement sur toutes les données donne 99.4 %. La fusion évite le réentraînement et l'accès aux données d'origine, en laissant un écart de capacité. Task Arithmetic, §4 et annexe D
Pour ViT-L/14, l'ordonnée divise d'abord la précision de chaque tâche par celle de son expert, puis moyenne les huit tâches. Les points pâles sont les sous-ensembles ; la ligne sombre moyenne ceux de même taille. Ajouter des vecteurs améliore la capacité globale, encore sous 1.0, le niveau des experts séparés.
La soustraction agit aussi. Soustraire le vecteur de GPT-2 Large ajusté sur des commentaires toxiques réduit de 4.8 % à 0.8 % les sorties classées toxiques parmi 1 000 générations à prompts fixes. La perplexité WikiText-103 passe de 16.4 à 16.9. Ce changement comportemental concerne ce protocole ; vérifier la suppression d'une information précise demanderait une autre validation. Task Arithmetic §3
Pourquoi l'addition fonctionne-t-elle ? En 2023, Ortiz-Jimenez et al. mettent en avant le découplage des poids : les vecteurs affectent des régions disjointes de l'espace d'entrée et peuvent ainsi moins interférer. Depuis un ViT initialisé aléatoirement, la même addition donne un multitâche proche du hasard. Ce contrôle soutient le rôle structurant du préentraînement dans ce découplage. Ortiz-Jimenez et al., §6.2
Comme dans FedAvg, il faut donc un départ commun, de préférence préentraîné.
Ce départ fournit les mêmes coordonnées, mais les vecteurs se recouvrent encore par position. L'article trouve surtout des similarités cosinus de 0.01 à 0.03 entre tâches CLIP, contre environ 0.18 pour des tâches proches comme MNIST et SVHN. La quasi-orthogonalité éclaire la faible interférence ; l'effet de chaque changement sur la sortie compte aussi. TIES traite précisément ces conflits locaux malgré une faible similarité globale.
Les paramètres se chamaillent
Les 91.2 % mesurent une rétention relative aux experts. Dans le cadre plus petit de TIES-Merging, les huit experts CLIP ViT-B/32 ont une précision moyenne de 90.5 %. Leur arithmétique donne seulement 70.1 %, même avec un coefficient choisi sur la validation. Ces précisions brutes montrent la difficulté à conserver huit capacités. TIES-Merging Table 1
Suivons la colonne ViT-B/32 originale : 90.5 pour les experts, 70.1 pour l'arithmétique avec validation, 73.6 pour TIES. La colonne Validation change entre les deux moitiés. Les 60.4 du haut et les 70.1 du bas emploient des conditions de choix du coefficient différentes et doivent être comparés séparément.
Yadav et al. attribuent les pertes à deux interférences. La redondance : beaucoup de petits changements contribuent peu, mais diluent les grands changements utiles d'autres modèles. Les conflits de signe : A augmente un paramètre, B le diminue, et l'addition les annule. Ils en observent déjà à deux modèles, puis davantage avec plus de sources. TIES-Merging §3
Prenons trois tâches et six paramètres, avec des nombres inventés pour l'illustration :
import numpy as np

tau = np.array([[ 0.8, -0.1,  0.5,   0.02, -0.6, 0.3 ],   # 任務 A
                [-0.7,  0.4,  0.6,  -0.03,  0.1, 0.05],   # 任務 B
                [ 0.9, -0.2, -0.05,  0.01, -0.5, 0.4 ]])  # 任務 C

print("直接平均:", tau.mean(0).round(3))

# 1. Trim:每個任務只留絕對值最大的一半
k = tau.shape[1] // 2
cut = np.sort(np.abs(tau), axis=1)[:, -k][:, None]
trimmed = np.where(np.abs(tau) >= cut, tau, 0.0)
print(trimmed)

# 2. Elect:每個參數用剩下數值的總和投票,決定正負號
sign = np.sign(trimmed.sum(0))

# 3. Merge:只平均和投票結果同號的值
agree = (np.sign(trimmed) == sign) & (trimmed != 0)
ties = (trimmed * agree).sum(0) / np.maximum(agree.sum(0), 1)
print("TIES    :", ties.round(3))
直接平均: [ 0.333  0.033  0.35   0.    -0.333  0.25 ]
[[ 0.8  0.   0.5  0.  -0.6  0. ]
 [-0.7  0.4  0.6  0.   0.   0. ]
 [ 0.9  0.   0.   0.  -0.5  0.4]]
TIES    : [ 0.85  0.4   0.55  0.   -0.55  0.4 ]
Pour le paramètre 0, A et C veulent une hausse, +0.8 et +0.9, B une baisse, −0.7. La moyenne donne seulement 0.333. La somme étant positive, TIES moyenne A et C et obtient 0.85.
Le paramètre 1 illustre la redondance. B apporte +0.4, mais les −0.1 et −0.2 de A et C ramènent la moyenne à 0.033. Élaguer ces petits changements conserve le 0.4 de B. Au paramètre 3, tous les changements sont de quelques centièmes ; l'élagage les annule.
TIES tient son nom de Trim, Elect sign et Merge : élaguer, choisir le signe, réunir les valeurs de même signe. L'article garde les 20 % de plus forte amplitude, après avoir vérifié que cette fraction conserve presque la performance individuelle du vecteur entier. Le vecteur fusionné est multiplié par , puis ajouté aux poids préentraînés.
Le vote compare les sommes signées : face à deux donne encore un choix positif. Le dénominateur compte seulement les survivants de même signe à cette position, sans les zéros élagués. La justification des 20 % vient de l'ajustement efficace en paramètres de T0-3B, avant les essais complets T5 et CLIP ; pour sa propre tâche, mieux vaut balayer la rétention.
Sur huit tâches ViT-B/32, TIES atteint 73.6 % avec validation, contre 70.1 % pour l'arithmétique. Sans validation, les scores sont 72.4 % et 60.4 %. Ils restent bien sous les 90.5 % des experts.
Un oracle remplace aussi le vote par les signes d'un modèle multitâche entraîné. Sur onze tâches à ajustement efficace en paramètres, la fusion atteint 72.0 %, contre 73.1 % pour le multitâche et 66.4 % pour TIES ordinaire. De meilleures directions laissent une grande marge, mais cet oracle exploite déjà un entraînement multitâche complet, coûteux à obtenir.
En supprimer neuf dixièmes
DARE, publié en novembre 2023, va plus loin. Pour chaque ajustement, il supprime aléatoirement une fraction de sa différence avec le préentraînement, appelée paramètres delta, puis multiplie les survivants par .
Pourquoi amplifier ? Chaque valeur survit avec probabilité et est alors multipliée par ; son espérance retrouve donc la valeur initiale :
La suppression peut être énorme. Les auteurs observent surtout des deltas d'amplitude inférieure à 0.002 après ajustement supervisé, si redondants que supprimer 90 %, voire 99 %, préserve largement les capacités. Les grands modèles tolèrent un plus élevé ; à 70 milliards de paramètres, 99 % de suppression agit encore peu. DARE s'occupe de la suppression, avant l'arithmétique des tâches ou TIES pour la fusion. DARE §1
À gauche, l'effet d'échelle est net : taux de suppression en abscisse, précision GSM8K en ordonnée. À 0.99, 7B chute, 70B reste proche de son score. À droite, trois évaluations de fusion distinguent conservation de la langue, des mathématiques et du code.
L'article montre aussi l'échec avec de grands deltas. Le préentraînement continu peut les porter vers 0.03, où DARE échoue. WizardCoder-Python-13B vient de CodeLlama-13b-Python, avec des deltas inférieurs à 0.0002 contre cette base, mais souvent supérieurs à 0.01 contre Llama 2. Utiliser Llama 2 comme base de suppression pose alors problème.
La chute est brutale : supprimer 10 % fait passer les pass@1 HumanEval et MBPP de 63.41 et 55.4 à 0. L'égalité en espérance reste vraie, mais la variance d'un tirage vaut . Avec de grands deltas et une forte suppression qui amplifie les rares survivants, préserver la sortie devient difficile. Les 0.002 observés se lisent avec les échelles des couches et les données ; chaque modèle demande sa propre vérification.
En prétraitement, DARE a aussi des résultats contrastés. Deux experts 13B d'instructions et de mathématiques donnent 66.34 % sur GSM8K par arithmétique, contre 66.26 % avec DARE. Avec TIES, DARE remonte de 15.77 % à 36.16 %. Pour trois experts par arithmétique, il abaisse GSM8K de 58.45 % à 56.48 %. TIES traite directions et dilution de la moyenne, DARE réduit le recouvrement des différences ; leur combinaison reste à mesurer.
Un autre point compte : seuls les deltas sont supprimés. La base entière reste, et le modèle reconstruit est toujours dense et de même taille. Conserver 1 % des changements laisse le calcul d'inférence à traiter séparément. DARE aide la fusion et la parcimonie des différences ; accélérer le déploiement exige un autre travail.
L'article DARE construit aussi une fusion 7B qui prend la première place des 7B de l'Open LLM Leaderboard, avec une fusion entièrement sur CPU.
Au même moment, la communauté expérimente déjà à plein régime.
L'alchimie sans GPU
Le 5 novembre 2023 apparaît Goliath-120B sur Hugging Face. Son auteur prélève des portions de Xwin et Euryale, deux ajustements de Llama 2 70B, et les entrelace pour former un réseau plus profond, sans entraînement supplémentaire par gradient lors de la fusion. Fiche de Goliath-120B La communauté appelle cela frankenmerge, d'après Frankenstein : assembler des morceaux de modèles en un nouveau. À strictement parler, aucun poids n'est moyenné.
L'outil est mergekit, de Charles Goddard. Moyenne linéaire, SLERP, arithmétique, TIES, DARE et empilement passthrough se décrivent dans un fichier de configuration, avec fusion sur CPU si la mémoire manque. L'article de mars 2024 rapporte déjà plus d'un millier de modèles créés ainsi. SOLAR-10.7B d'Upstage commence aussi par un empilement, suivi d'un préentraînement continu. MergeKit
« Sans GPU » décrit la lecture des tenseurs, leur combinaison et l'écriture du nouveau checkpoint. L'entraînement des sources a déjà consommé du calcul ; évaluation et inférence demandent toujours d'exécuter le modèle complet. En augmentant la profondeur, Goliath allonge aussi le chemin d'inférence et le stockage des poids. Il évite un entraînement supplémentaire par gradient tout en conservant les besoins de déploiement d'un modèle de classe 120B.
Le mot fusion couvre ainsi plusieurs opérations. L'interpolation à profondeur fixe conserve l'architecture ; passthrough change le nombre de couches raccordées ; SOLAR ajoute un apprentissage après l'empilement. Pour comparer les coûts, il faut au moins séparer création, évaluation et déploiement.
Pourquoi suivre un arc ?
SLERP signifie interpolation linéaire sphérique. Ken Shoemake la présente en animation informatique en 1985 pour passer en douceur entre rotations. Début 2024, c'est la fusion la plus populaire de la communauté, limitée à deux modèles à la fois.
Deux vecteurs suffisent à comprendre l'idée. Pour les vecteurs unitaires orthogonaux et , la moyenne directe donne , de norme seulement . SLERP suit l'arc, avec un milieu de norme 1 :
Selon l'explication communautaire, le mélange linéaire en grande dimension raccourcit les poids, alors que leur direction compte souvent davantage que leur norme. Labonne, 2024-01-09 La comparaison précédente porte sur des vecteurs unitaires de même norme. Pour un modèle réel, normes et angles par couche restent à mesurer. Si les ajustements sont faibles relativement à la base commune et l'angle mutuel petit, , les deux coefficients approchent et : SLERP approche l'interpolation linéaire. C'est l'approximation de petit angle de la formule ; une amplitude delta isolée de DARE ne permet pas de calculer l'angle du modèle entier. Nous verrons que Cohere a essayé SLERP sur 111 milliards de paramètres sans bénéfice net.
Les classements
Le 9 janvier 2024, Maxime Labonne publie un tutoriel mergekit sur le blog Hugging Face. Il présente la fusion comme une création peu coûteuse, sans GPU, qui a fourni plusieurs modèles de tête du classement. Sa fusion SLERP Marcoro14-7B-slerp a pris la première place 7B début janvier. Le même texte précise que fusionner les meilleurs modèles réunit aussi leur contamination, et conseille de considérer Marcoro14-7B-slerp comme contaminé. Labonne, 2024-01-09
La contamination correspond à des questions d'évaluation présentes dans l'entraînement. Les tests du classement sont publics et peuvent servir à entraîner des modèles. La provenance des fusions est difficile à vérifier : leurs parents peuvent être eux-mêmes fusionnés et chaque génération réajustée.
En mars 2024, Sakana AI présente la fusion évolutionnaire. L'introduction décrit un classement dominé par les fusions et une pratique souvent vue comme de la magie ou de l'alchimie intuitive. L'évolution cherche la recette et le parcours des données entre couches de plusieurs modèles. EvoLLM-JP, à seulement 7B, atteint 52.0 sur les mathématiques japonaises MGSM-JA et dépasse certains anciens modèles japonais 70B sur plusieurs évaluations japonaises. Akiba et al.
Les versions ultérieures précisent le cadre. Trois sources japonaises et mathématiques Mistral-7B ; seulement une density et un weight recherchés par source dans les résultats principaux, sans multiplier les degrés de liberté par couche. La recherche utilise 1 069 problèmes traduits séparément et réserve les 250 MGSM-JA finaux. PS donne 52.0 % ; ajouter DFS donne 55.2 % et passe de 7B à 10B. Des données distinctes du test choisissent la recette, ce qui permet d'examiner le transfert. Akiba et al., §3.1
Les couleurs de couches distinguent les opérations. PS mélange les tenseurs en nouveaux tenseurs ; DFS choisit les couches et leur ordre. Leur combinaison modifie les deux. Les recherches peuvent donc produire des tailles et des chemins de passe avant différents.
Le classement masque alors déjà les fusions par défaut. Le 11 mars, un auteur proteste dans un fil : plusieurs fois premier, son modèle est caché à cause du tag merge, aux côtés de modèles signalés ou supprimés, ce qu'il vit comme une stigmatisation.
Clémentine Fourrier de Hugging Face répond que la provenance est presque impossible à démêler. Pour un ajustement Llama, base et données sont identifiables ; les fusions peuvent empiler plusieurs générations et des modèles supprimés, rendant les données difficiles à retracer et la contamination accidentelle facile. Après fusion, ajustement, nouvelle fusion et DPO, les scores académiques se transposent souvent mal aux usages. C'est la raison du masquage par défaut. Discussion #629 de l'Open LLM Leaderboard
La controverse touche à la fois transparence des sources et choix d'évaluation. Réutiliser un benchmark pour sélectionner parents et coefficients l'intègre à la recherche de recette. Savoir si ses questions ont aussi servi à l'entraînement exige encore l'examen des données. Il vaut mieux garder un test hors sélection, puis regarder les sorties pour l'usage prévu. Le fil expose des soupçons et une décision de gestion ; une vérification de contamination modèle par modèle reste distincte.
La fusion entre dans l'entraînement
Au-delà des classements, les laboratoires l'adoptent aussi dans leurs propres procédures.
Les rapports publics décrivent surtout la moyenne de plusieurs exécutions d'une même recette :
- Llama 3 (juillet 2024) : à chaque étape, modèle de récompense, SFT et DPO, on moyenne les modèles obtenus avec différentes données ou hyperparamètres. Llama 3 §4.1.5 Pour le SFT visuel, une exploration des hyperparamètres est classée, puis les K meilleurs sont moyennés. Le rapport décrit des gains systématiques sur le meilleur modèle de la grille et une moindre sensibilité aux hyperparamètres. Llama 3 §7.5.2
- Gemma 2 (juillet 2024) : moyenne de modèles d'une même procédure de post-entraînement avec différents hyperparamètres, en citant WARP de Google DeepMind. Gemma 2 §4
- OLMo 2 (décembre 2024) : au mid-training du 7B, les mêmes 50B tokens sont parcourus selon trois ordres puis les poids moyennés. Pour six recettes de données, la moyenne égale ou dépasse la meilleure exécution. OLMo 2 Table 14
- Tülu 3 (novembre 2024) : des soupes de SFT à graines différentes font à peu près comme la meilleure graine ; les auteurs retiennent cette dernière par cohérence. Tülu 3 Table 14
Le cas Tülu 3 mérite attention : la moyenne peut aussi apporter peu.
Le préentraînement s'y met aussi. PMA de l'équipe Seed de ByteDance moyenne les checkpoints à taux constant, d'un modèle dense de 411 millions de paramètres à un MoE de 200 milliards. La moyenne améliore les scores et prédit plus tôt le résultat après recuit du taux. WSM d'Ant Group va plus loin en remplaçant la phase de décroissance par une fusion de checkpoints. PMA, WSM
Les objets moyennés diffèrent. SWA et les moyennes à taux constant prennent des instants d'une même trajectoire. Model Soups et les essais d'ordres de données bifurquent d'un checkpoint commun, puis entraînent séparément. Il faut choisir le début et la durée de collecte dans le premier cas, les branches admises dans le second. Les conditions communes sont des coordonnées compatibles et une nouvelle évaluation après moyenne.
Six experts, deux soupes
Le rapport Command A de Cohere, publié en avril 2025, place la fusion au centre de l'entraînement.
Command A, à 111 milliards de paramètres, commence par un modèle d'instructions général. Il donne six experts : code, sécurité, RAG, mathématiques, multilingue et capacités générales en long contexte. Leur fusion produit une soupe SFT, qui sert de départ à l'optimisation des préférences et au renforcement par domaine pour obtenir les six experts dits RL. Une seconde fusion précède les derniers ajustements. Command A §3
La fusion est une moyenne linéaire pondérée, réglée par heuristiques et recherche exhaustive. SLERP et les vecteurs de tâche ont été essayés, sans progrès net mais avec plus de complexité. Le linéaire a aussi un avantage pratique : une fusion de fusions peut s'écrire en une seule combinaison, facilitant le suivi.
Il faut toutefois conserver tous les coefficients. Moyenner A et B, puis le résultat et C à parts égales, donne ; on peut l'aplatir en une seule fusion, mais la recette diffère de la moyenne égale . Au-delà du départ commun, consigner les sources par couche, coefficients et entraînements intermédiaires permet de retracer le modèle final.
Comparée aux meilleurs experts de domaine, la fusion perd seulement 1.8 % en moyenne, avec la plupart des mesures à moins de 2.5 %, le code perdant le plus. À cette taille, même de fortes variations des poids d'experts changent le domaine correspondant de seulement 2 % à 3 %. Un peu de SFT à faible taux après fusion ramène de nombreuses mesures au niveau des experts, voire au-dessus. Command A §4.9
La figure localise les pertes. À gauche, les mesures sont regroupées par score fusionné moins score expert ; à droite, les moyennes par domaine ont des barres d'écart-type. Le code baisse davantage, RAG reste près de zéro. Une petite moyenne peut masquer une perte sensible pour une famille de travaux.
Quelques leçons du rapport prolongent notre petite figure initiale :
- Un départ commun : tous les experts partent du même modèle d'instructions général. Pour les tokens spéciaux d'outils aussi, fusionner depuis ce départ commun fonctionne bien mieux que sélectionner seulement les experts entraînés à ces tokens.
- Retirer un expert à la fois : refaire la fusion en enlevant chaque expert révèle ceux qui nuisent aux autres capacités. Pour réduire ces conflits, chaque expert reçoit un peu de données des autres domaines. Même de petites différences de style ou de format des données communes peuvent créer des conflits.
- La fusion coûte peu, l'évaluation coûte cher : le modèle final s'appuie sur 500 mesures d'évaluation ; chaque candidat demande beaucoup de calcul d'inférence.
Faire réfléchir le modèle un peu moins
Avec l'essor des modèles de raisonnement, la fusion sert aussi à raccourcir leur réflexion.
Le rapport Kimi k1.5 de janvier 2025 moyenne directement les poids de modèles à chaînes de pensée longues et courtes pour améliorer l'efficacité en tokens. Ce n'est toutefois pas sa meilleure méthode : le renforcement long2short spécialement conçu obtient le meilleur résultat. Kimi k1.5 §2.4, §3.4
Il faut lire ensemble performance et longueur. Dégrader le raisonnement peut aussi raccourcir les réponses, en perdant la capacité recherchée. Kimi compare scores et tokens : la moyenne évite l'entraînement supplémentaire, tandis que rejection sampling, DPO et long2short RL utilisent un apprentissage pour améliorer le compromis longueur-précision. Même la fusion la moins coûteuse se compare aux méthodes entraînées sur cette même courbe.
En avril 2025, TNG Technology Consulting en Allemagne construit R1T Chimera à partir de DeepSeek-V3-0324 et DeepSeek-R1, deux MoE de 671 milliards de paramètres. Attention et experts partagés viennent de V3-0324 ; le groupe entier des experts routés vient de R1. Selon leurs évaluations, Chimera conserve le raisonnement de R1 avec environ 40 % de tokens en moins. Le rapport précise aussi que presque aucun des modèles interpolés à divers coefficients n'est mauvais. Assembly of Experts
Les résultats
Les comparaisons systématiques accumulées ces dernières années donnent des conclusions plus prudentes que chaque article de méthode.
Dans leur synthèse de fin 2025, Yang et al. réévaluent les méthodes avec des réglages unifiés. Pour huit tâches visuelles ViT-B/32, les experts atteignent 90.3 %, la moyenne directe seulement 66.5 %. Pondérations et sous-espaces réduisent une partie de l'écart. Pour cinq experts Llama-3.1-8B, toutes les fusions restent entre préentraînement et experts ; la meilleure conserve seulement 84.8 % de leur performance. Des méthodes plus complexes font parfois moins bien que l'arithmétique élémentaire. Yang et al., §3.2
En 2024, Yadav et al. poussent l'étude jusqu'à 64 milliards de paramètres avec PaLM-2 : deux bases, quatre tailles, quatre méthodes et 2, 4, 6 ou 8 experts. Les grandes tailles et les bases IT se fusionnent généralement mieux. En IT 64B et huit experts, les quatre held-in valent environ 0.93. En 24B, moyenne et arithmétique donnent 0.77 et 0.92 : l'écart reste net. Yadav et al.
Held-in est divisé par les experts, held-out par la base. En 64B, l'arithmétique de huit experts donne 1.09 sur les nouvelles tâches, au-dessus des 1.05 du multitâche, mais 0.93 sur les tâches apprises, sous ses 0.99. La fusion conserve des capacités utiles et peut améliorer la généralisation, avec un compromis à lire sur les deux mesures.
Les quatre méthodes 64B coïncident presque dans ces deux graphiques. À gauche, 1.0 est l'expert ; à droite, 1.0 est la base PaLM-2-IT. Des hauteurs égales ont donc des dénominateurs différents. À huit experts, la fusion dépasse la base à droite, tout en restant sous les experts à gauche.
Une étude publiée dans TMLR en mars 2026 se rapproche du terrain : douze ajustements publics Hugging Face par base, aux objectifs parfois redondants ou conflictuels. Avec quatre modèles, seize évaluations et six familles de fusion, l'arithmétique simple est la plus stable, pour des gains limités. TIES et Model Stock restent près de la base ; TSV-Merge et Iso-C baissent avec les ajouts, tandis que TA avec Subspace Boosting suit largement TA seul. Hitit et al.
Attention : normalization est active. L'arithmétique à moyenne en réalité les deltas ; leur somme directe serait douze fois plus grande à douze versions. En désactivant normalization dans l'annexe, les scores deviennent très sensibles à . Ces détails sont souvent sous-estimés : « TA » ou « TIES » exige aussi de préciser normalisation, rétention et échelle.
Les deux figures montrent la différence produite par un seul réglage manquant. Toutes deux ont en abscisse et la précision moyenne en ordonnée, avec une couleur par base. Normalization active en haut, les scores restent assez stables dans la plage ordinaire. Désactivée en bas, ils chutent vite avec le coefficient. Le haut teste aussi 10 tout à droite ; les positions correspondent aux coefficients listés.
L'étude distingue dépasser la base et dépasser le meilleur ajustement de tout le groupe. La première réussite laisse encore la seconde ouverte. Un Llama 3.1 8B existant est si fort que les fusions ne le dépassent jamais. La valeur d'un nouveau checkpoint doit donc se comparer aux options déjà disponibles.
Arrive ensuite DeepSeek-V4. Son rapport d'avril 2026 entraîne aussi des experts en mathématiques, code, agents et instructions, chacun par SFT puis GRPO. Mais l'intégration utilise la distillation on-policy à plusieurs enseignants : l'étudiant génère ses réponses, puis apprend les distributions que plus de dix experts leur attribuent. Le rapport décrit un alignement des connaissances au niveau des logits dans des paramètres communs, évitant en pratique les dégradations fréquentes de la fusion des poids ou du renforcement mixte. DeepSeek-V4 §5.1
Cohere et DeepSeek forment tous deux des experts, mais les intègrent dans des espaces différents. Command A combine les poids compatibles ; V4 apprend les distributions des enseignants sur les trajectoires de l'étudiant. Le premier évite l'entraînement par gradient à l'intégration, le second investit cet apprentissage pour transmettre les comportements. Modèles, données et objectifs diffèrent : départager généralement fusion et distillation demanderait une comparaison contrôlée distincte.
Ajoutons MoE, souvent associé à ces sujets, pour préciser les options :
| Intégration | Éléments conservés | Exécution à l'inférence | Conditions à vérifier |
|---|---|---|---|
| Moyenne des poids / vecteurs de tâche | Un modèle de même architecture | Une passe avant dans l'architecture initiale | Compatibilité des bases, du sens des tenseurs et des capacités |
| Empilement à chemin fixe | Couches sources sélectionnées | Le même nouveau chemin à chaque fois | Raccord des représentations, profondeur et coût d'inférence |
| MoE | Plusieurs experts internes et leur routage | Une partie des experts par token | Routage, charge et stockage des poids experts |
| Distillation à plusieurs enseignants | Un étudiant | L'architecture de l'étudiant | Évaluation des enseignants, données et capacité de l'étudiant |
Synthèse des modèles et procédures précédents. Ces opérations se combinent : plusieurs modèles de domaine complets peuvent par exemple être distillés dans un étudiant lui-même MoE.
Les six experts de Command A sont six checkpoints entiers, à un autre niveau que les modules experts d'une couche MoE. V4 peut distiller tout en conservant l'inférence clairsemée MoE ; Chimera remplace directement un groupe de paramètres d'un MoE existant. Identifier les objets intégrés et le chemin déployé permet de situer l'économie.
Fusion rapide, évaluations interminables ?
Le coût d'évaluation revient souvent : un passage sur les données de sélection par ajout glouton, des milliers de candidats évolutionnaires, ou une grille croisant bases, tailles et tâches. Additionner les paramètres consiste à lire et écrire des tenseurs ; vérifier l'utilité d'un checkpoint exige le modèle complet sur de multiples entrées.
Pour votre comparaison, fixez données et prompts, gardez base, meilleur modèle individuel et moyenne linéaire comme références, puis explorez une petite plage d'hyperparamètres. Séparez validation de recette et test final. Mesurez capacités à ajouter, capacités à préserver et comportements comme longueur ou refus. Le retrait d'un expert à la fois de Command A révèle aussi ce que chaque source améliore ou sacrifie.
Ces comparaisons décident des méthodes à conserver. Si la moyenne suffit, commencez sans projection plus complexe. Si une capacité essentielle se dégrade, comparez un peu d'entraînement après fusion, une autre répartition des données expertes ou la distillation. Une sélection limitée aux tests du classement favorise des recettes adaptées seulement à ces tests.
Alors, additionner et diviser par deux, ça marche ?
Revenons au titre : cela dépend de ce que l'on moyenne.
- Même départ, même tâche : graines, hyperparamètres ou instants différents d'un entraînement. C'est le cadre le plus fiable, présent de SWA et Model Soups à Llama 3 et OLMo 2. Parfois, comme pour Tülu 3, la moyenne ne fait pourtant pas mieux.
- Même départ, capacités différentes : arithmétique, TIES, DARE et experts de Command A. La fusion est utile, généralement sous les experts individuels. À grande taille, le linéaire suffit souvent ; maintenir leur cohérence compte davantage que pousser chacun à son score maximal. DeepSeek-V4 choisit ici la distillation.
- Départs différents : aligner d'abord les neurones et disposer d'une largeur suffisante pour approcher la barrière nulle. Les fusions de grands modèles de langage contournent presque toujours ce problème en partageant le même préentraînement.
Si vos ajustements partagent une base, commencez par la moyenne linéaire la plus simple, avec des coefficients choisis sur validation. Quand ils sont nombreux, retirez-les un par un comme Cohere pour repérer ceux qui gênent. La couverture de l'évaluation peut peser davantage que le choix de méthode.
Il y a dix ans, les auteurs de FedAvg craignaient une moyenne arbitrairement mauvaise. Les recherches ont précisé des conditions plus fiables : trajectoire partagée, coordonnées compatibles, ajustements contrôlés et évaluations capables de détecter les régressions. Réunir des capacités dans les mêmes poids demande de surveiller chacune.
Pour fusionner, une addition et une division par deux suffisent.
L'ennui, c'est qu'après la division, 500 évaluations attendent encore.