Article original
Arcee's MergeKit: A Toolkit for Merging Large Language Models
- Publication
- EMNLP 2024 Industry Track 2024Conférence
- Premier dépôt sur arXiv
- arXiv:2403.13257
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingmergekit2024,
  title = {{Arcee's MergeKit: A Toolkit for Merging Large Language Models}},
  author = {Charles Goddard and Shamane Siriwardhana and Malikeh Ehghaghi and Luke Meyers and Vlad Karpukhin and Brian Benedict and Mark McQuade and Jacob Solawetz},
  year = {2024},
  eprint = {2403.13257},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.13257}
}
Entre fin 2023 et début 2024, Hugging Face a vu surgir une foule de modèles aux noms à rallonge.
Leurs noms contenaient souvent des mots comme slerp, ties ou dare, ou alignaient tout simplement les noms de deux ou trois modèles. Ces modèles n'avaient subi aucun nouvel entraînement : leurs auteurs avaient seulement mélangé les poids de quelques modèles ajustés existants avant de les publier ; beaucoup sont même montés un temps dans le haut de l'Open LLM Leaderboard.
Derrière, on trouvait le plus souvent le même outil, MergeKit, une bibliothèque open source développée par Charles Goddard et ses collègues chez Arcee. Cet article en est la présentation officielle ; assez court, il décrit surtout la conception de l'outil et les méthodes prises en charge, avec en complément une série d'expériences de fusion dans le domaine médical.
Sa lecture permet de voir à quoi ressemble concrètement la « fusion de modèles » quand elle passe des articles au quotidien de la communauté.
Définir le problème
Les travaux sur la fusion de modèles s'accumulent depuis plusieurs années, de la moyenne de poids à Model Soups et à l'arithmétique des tâches, puis à TIES-Merging et DARE. Mais chaque article a son propre code, le plus souvent conçu pour des modèles et jeux de données particuliers ; pour fusionner deux modèles de langage de 70B, on se heurte à des problèmes très concrets :
- Mémoire : deux modèles de 70B stockés en 16 bits occupent deux à trois cents Go ; une machine ordinaire ne peut pas les charger, encore moins plusieurs à la fois.
- Différences d'architecture : Llama, Mistral et Qwen nomment leurs poids et structurent leurs couches différemment, et chacun doit être traité à part.
- Recettes difficiles à reproduire : quel poids donner à quel modèle, quelle méthode appliquer à quelles couches, tout cela tient dans des scripts improvisés que les autres peinent à suivre.
Les auteurs veulent un outil commun qui permette aux non-programmeurs de fusionner des modèles et aux chercheurs d'ajouter facilement de nouvelles méthodes.
Résoudre le problème
Comment l'article classe les méthodes de fusion
Les auteurs commencent par classer les méthodes de fusion, en indiquant jusqu'où va la prise en charge de MergeKit.
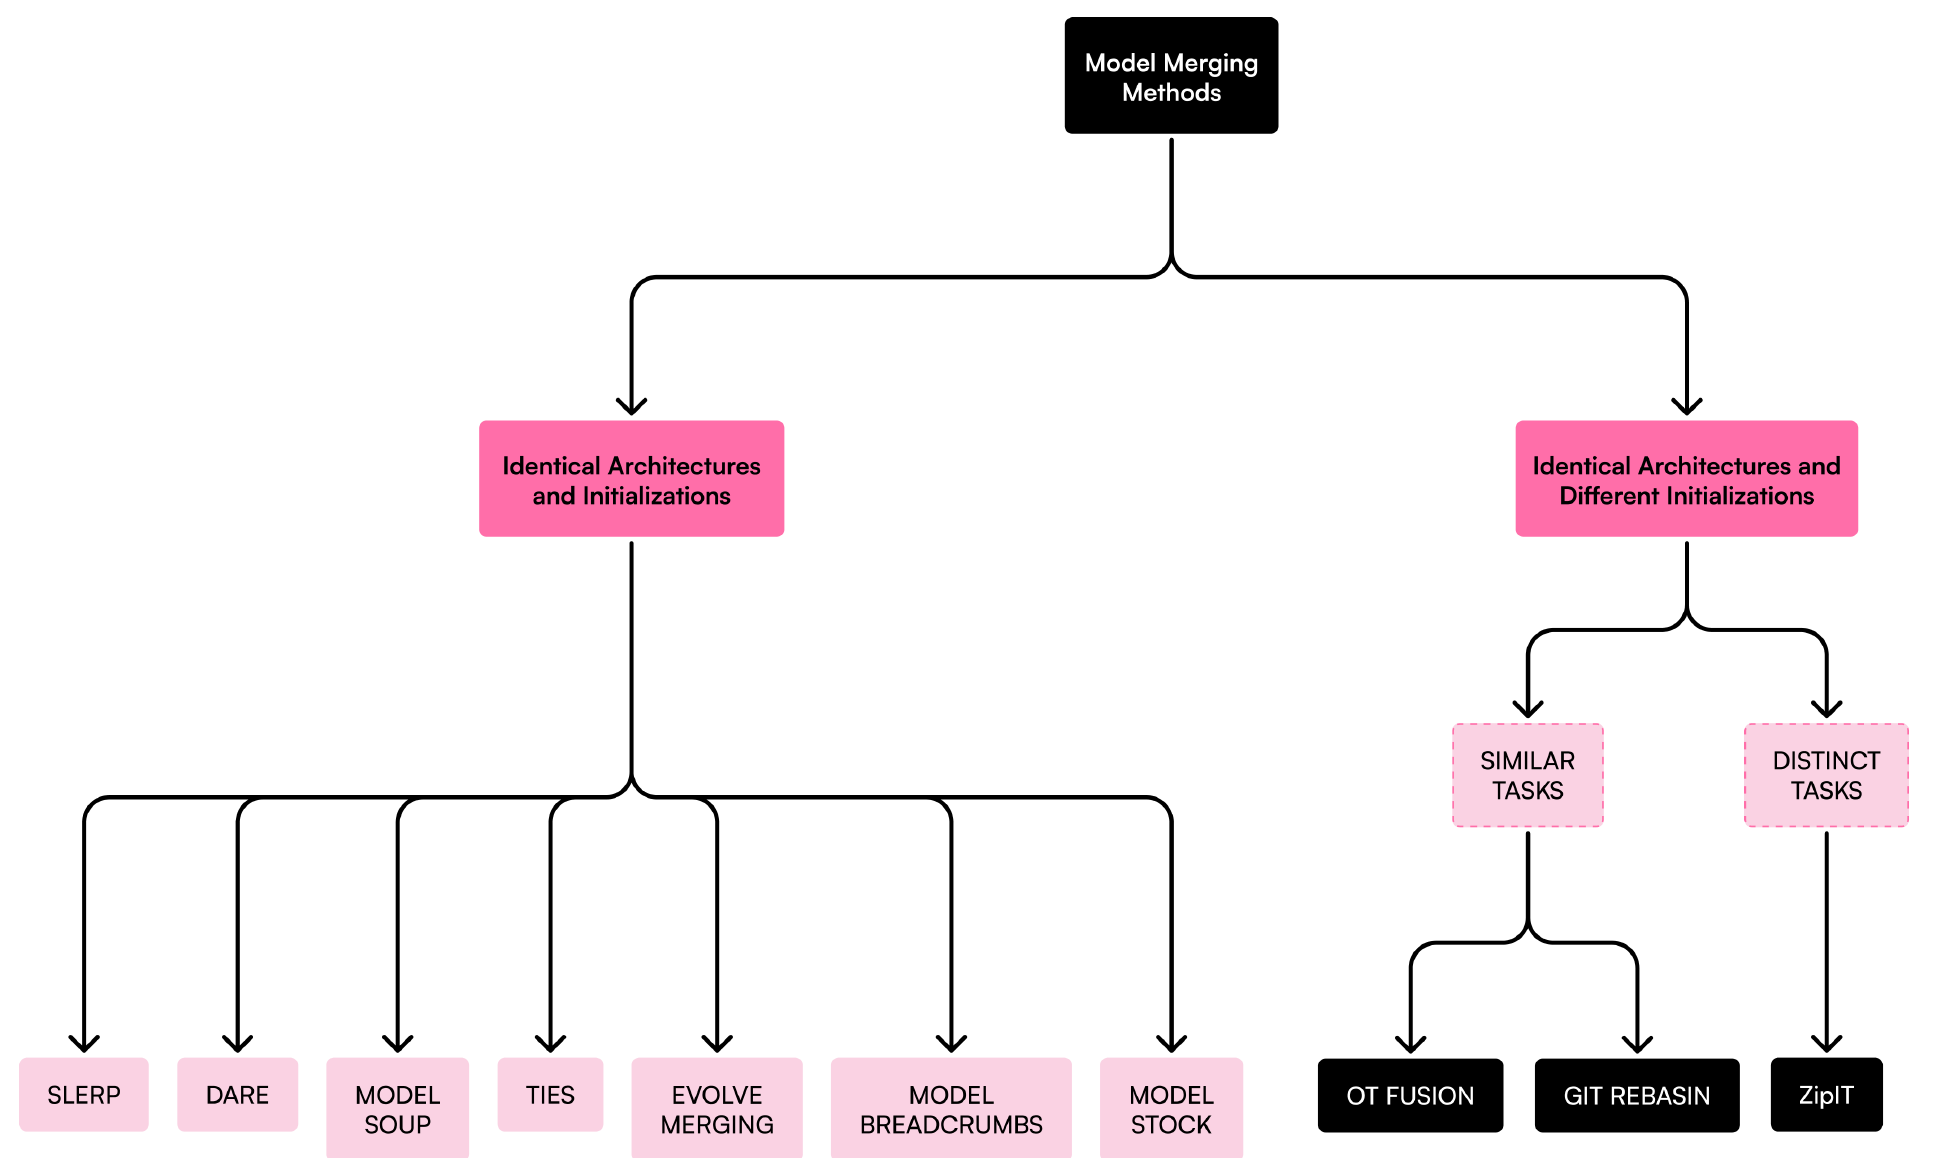
La classification repose sur deux critères : les modèles ont-ils la même architecture, et viennent-ils de la même initialisation ?
La branche de gauche correspond à ce que MergeKit prend réellement en charge ; toutes ces méthodes exigent « même architecture, départ d'un même modèle de base ». Ce sont précisément les conditions de la connectivité linéaire des modes et de l'arithmétique des tâches. La branche de droite traite des modèles entraînés indépendamment, qui demandent d'abord un alignement des neurones ; elle n'était pas prise en charge à la rédaction de l'article. Les auteurs reconnaissent aussi que ces méthodes de droite ne sont pas encore aussi largement utilisées que celles de gauche.
Les modèles d'architectures complètement différentes, comme CALM, qui relie deux modèles par attention croisée, ou FuseLLM, qui aligne les distributions de sortie de deux modèles, demandent tous un entraînement supplémentaire ; les auteurs parlent alors de « model fusion » et non de « model merging ».
La recette de fusion est un fichier YAML
L'interface principale de MergeKit est un fichier de configuration YAML. Il indique la méthode de fusion, les modèles d'entrée et les paramètres requis par la méthode ; l'exécution tient en une commande :
mergekit-yaml path/to/your/config.yml ./output-model-directory
Une configuration de fusion TIES peut s'écrire ainsi (d'après l'exemple officiel examples/ties.yml) :
models:
  - model: psmathur/orca_mini_v3_13b
    parameters:
      density: [1, 0.7, 0.1] # density gradient
      weight: 1.0
  - model: garage-bAInd/Platypus2-13B
    parameters:
      density: 0.5
      weight: [0, 0.3, 0.7, 1] # weight gradient
  - model: WizardLM/WizardMath-13B-V1.0
    parameters:
      density: 0.33
      weight:
        - filter: mlp
          value: 0.5
        - value: 0
merge_method: ties
base_model: TheBloke/Llama-2-13B-fp16
parameters:
  normalize: true
  int8_mask: true
dtype: float16
Les trois modèles 13B sont tous ajustés à partir du même Llama-2-13B ; base_model désigne cette base commune, et chaque vecteur de tâche est la différence entre un modèle et cette base. density est la proportion conservée après l'élagage de TIES, weight le poids de chaque vecteur de tâche.
Ce fichier de configuration utilise en outre deux fonctionnalités.
Premièrement, un paramètre peut s'écrire sous forme de liste. density: [1, 0.7, 0.1] est interpolé le long de la profondeur des couches en un « gradient » : les couches basses conservent tout, et plus on va en profondeur, moins on conserve.
Deuxièmement, filter permet de restreindre la portée d'un paramètre. Pour WizardMath, la configuration donne un poids de 0.5 aux couches MLP et de 0 aux autres tenseurs ; autrement dit, seules les modifications de ses couches MLP sont retenues.
L'avantage du fichier de configuration est de transformer la recette de fusion en un texte que l'on peut partager, reproduire et modifier. Dans la communauté, de nombreuses fiches de modèles fusionnés joignent directement un tel YAML.
Pourquoi SLERP est si courant
Parmi les méthodes prises en charge par MergeKit, l'une des plus utilisées par la communauté est SLERP (spherical linear interpolation, interpolation linéaire sphérique). Elle vient de recherches en animation par ordinateur de 1985, où elle servait à interpoler en douceur des rotations.
Entre deux tenseurs et , l'interpolation linéaire ordinaire est . SLERP calcule d'abord l'angle entre les deux tenseurs normalisés, puis avance le long de la sphère :
Quelle différence ? Prenons deux vecteurs de longueur 1 formant un angle de 90 degrés : le milieu de l'interpolation linéaire n'a plus qu'une longueur de , alors que celui de SLERP garde une longueur de 1. Plus l'angle est grand, plus l'interpolation linéaire « raccourcit » les poids.
Mais pour des modèles de langage ajustés à partir d'une même base, l'angle entre les poids est généralement très petit. Avec un angle de 2 degrés seulement, le milieu de l'interpolation linéaire a une longueur de , et les deux méthodes ne diffèrent presque pas. L'implémentation de MergeKit en tient compte : quand le produit scalaire normalisé de deux tenseurs dépasse 0.9995, elle revient directement à l'interpolation linéaire ordinaire.
L'article affirme que le succès de SLERP montre que « les chemins sphériques ont souvent une barrière de perte plus basse que la ligne droite » ; c'est une affirmation des auteurs, que l'article n'appuie sur aucune mesure de barrière.
Par ailleurs, SLERP ne fusionne que deux modèles à la fois, d'où le choix de TIES dans l'exemple précédent. L'exemple officiel gradient-slerp.yml montre un autre usage de SLERP, avec des coefficients d'interpolation différents pour l'attention et les MLP, qui varient avec la profondeur des couches, par exemple de à pour l'attention et l'inverse pour les MLP.
Deux fusions sans additions ni soustractions
MergeKit propose aussi deux méthodes qui n'opèrent pas du tout dans l'espace des paramètres.
Passthrough, surnommé « FrankenMerging » par la communauté, concatène directement des couches de modèles différents pour produire un nouveau modèle au nombre de couches inhabituel. Le populaire Goliath-120B entrelace des tranches de couches de deux ajustements de Llama-2 70B, Xwin et Euryale, d'environ 16 couches chacune et qui se chevauchent partiellement. La première étape du Depth Up-Scaling de SOLAR-10.7B procède de même : deux copies d'un même modèle de 32 couches, l'une privée de ses 8 dernières couches, l'autre de ses 8 premières, sont mises bout à bout en 48 couches, puis le préentraînement se poursuit.
mergekit-moe, surnommé « FrankenMoE », assemble plusieurs modèles denses comme experts d'un modèle à mélange d'experts (MoE). Le routeur peut faire un routage sémantique à partir des états cachés des prompts, ou être initialisé aléatoirement puis entraîné.
Aucune de ces deux méthodes ne repose sur une théorie de l'alignement ou de l'interpolation ; seule l'évaluation peut dire si l'assemblage fonctionne.
Fusionner un modèle de 70B sur un portable
L'efficacité de MergeKit vient de sa conception « out-of-core ». Au lieu de charger tout le modèle en mémoire, MergeKit ne charge que les tenseurs nécessaires à l'opération en cours.
En interne, une fusion est représentée par un graphe orienté acyclique (DAG), dont chaque nœud est une opération. L'ordonnanceur s'appuie sur ce graphe pour fixer l'ordre d'exécution, de façon à garder le moins de données possible en mémoire à un instant donné ; les résultats intermédiaires devenus inutiles sont libérés automatiquement. Selon les auteurs, MergeKit peut ainsi tourner aussi bien sur un cluster de recherche que sur un portable sans GPU à la mémoire limitée.
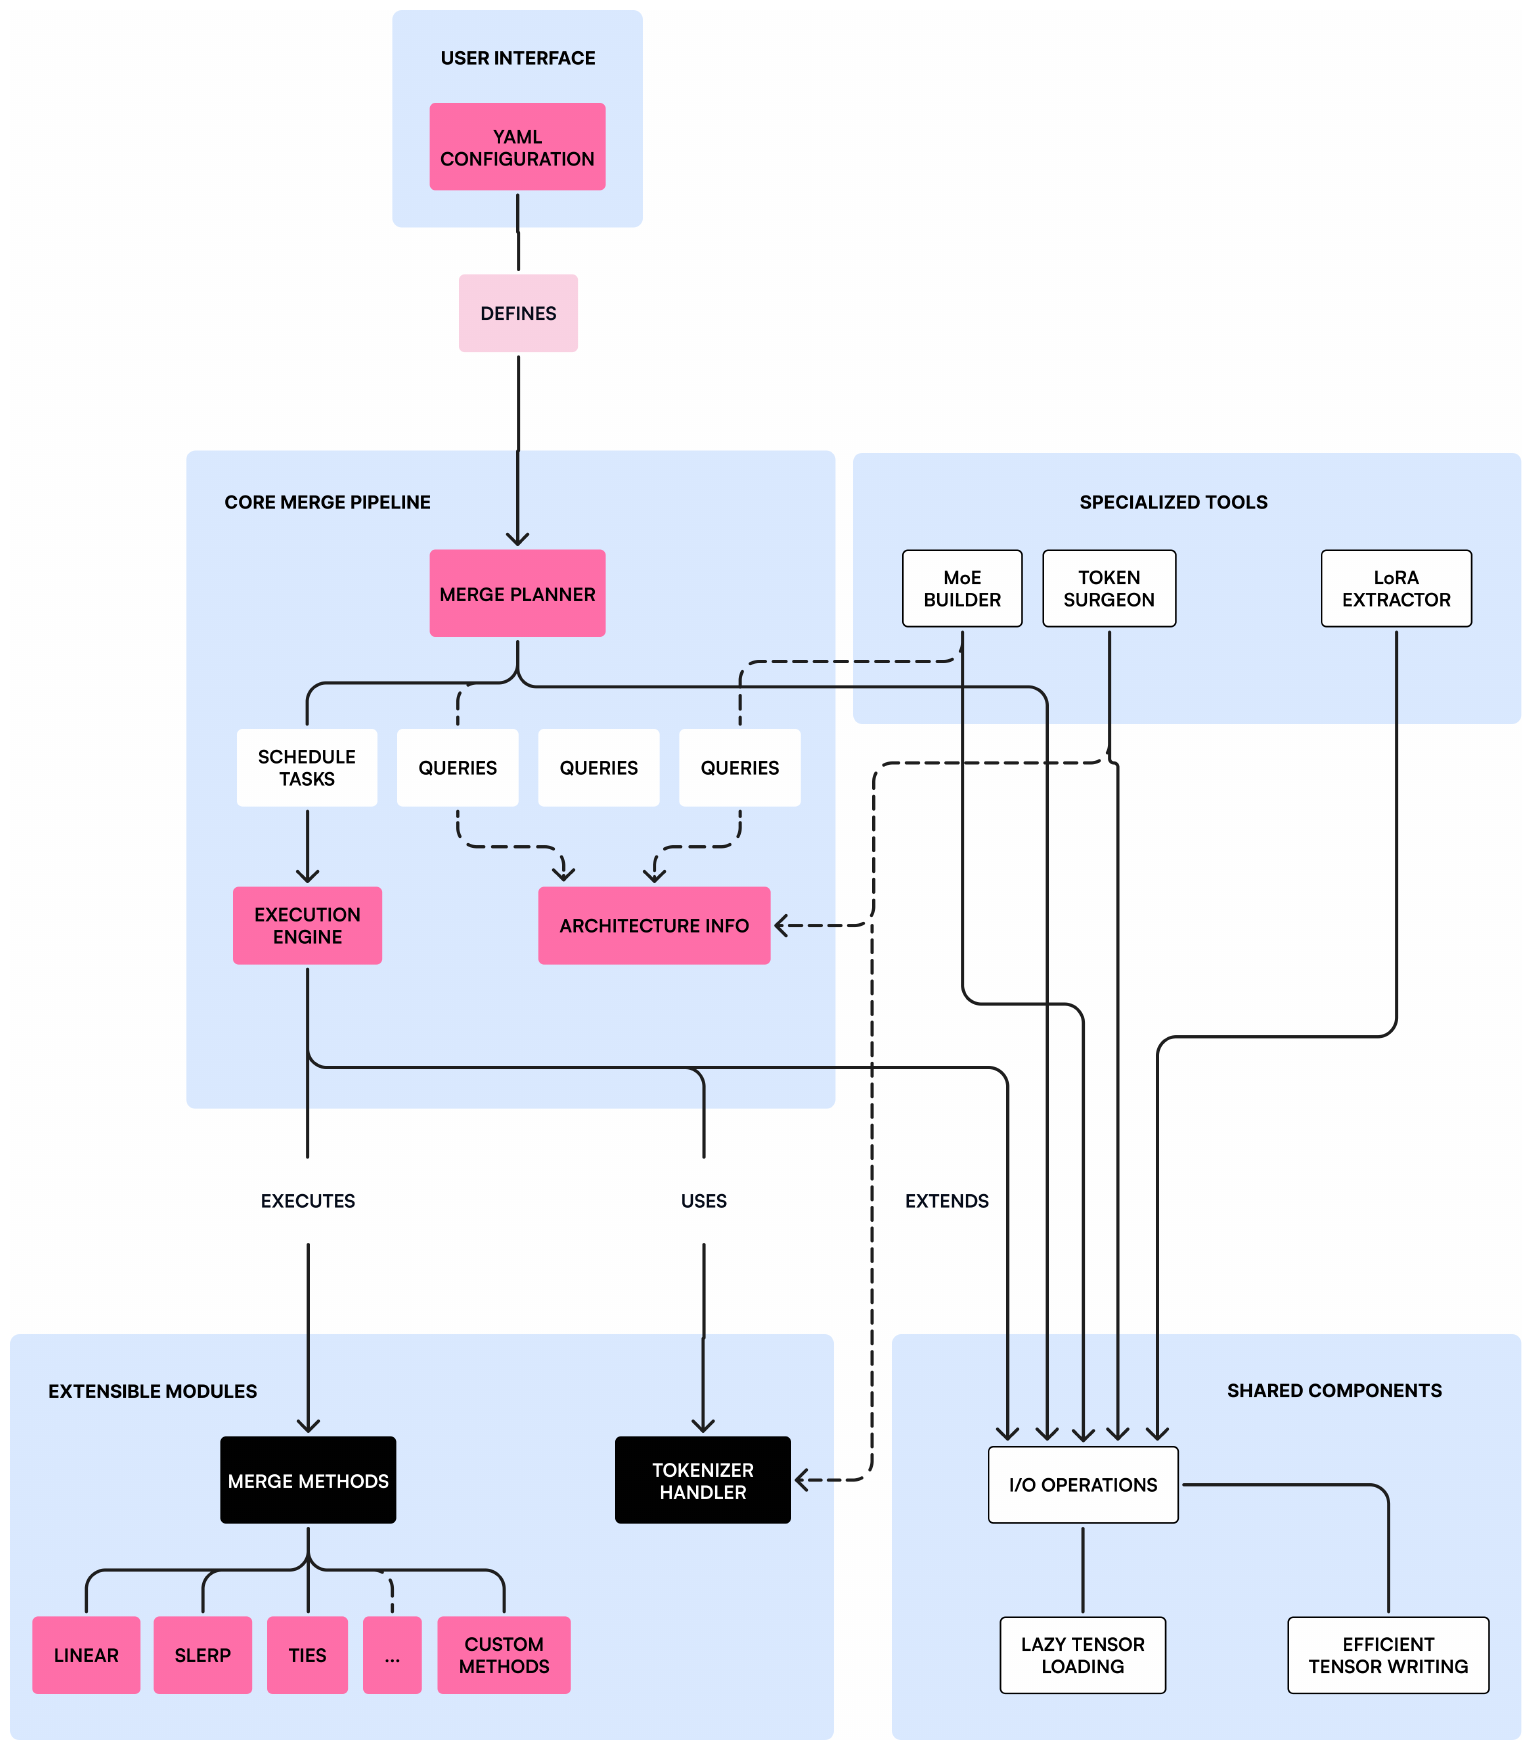
Ce schéma d'architecture est le plus utile à qui veut ajouter une nouvelle méthode. Les auteurs listent quelques modules à connaître d'abord : merge_methods/base.py définit l'interface que doit implémenter une nouvelle méthode, graph.py gère l'ordonnancement et les déplacements de données, plan.py construit le graphe de calcul, et architecture.py décrit la structure des différents modèles, la plupart des architectures étant définies par un simple fichier JSON.
Discussion
Une série d'expériences médicales
La seule expérience de l'article fusionne le modèle médical Meditron-7B avec Llama2-7B-Chat. Les deux partent de la base Llama2-7B ; Meditron a en plus poursuivi son préentraînement sur un vaste corpus médical.
| Modèle | USMLE | MedMCQA | PubMedQA | ARC-C | HellaSwag | MMLU |
|---|---|---|---|---|---|---|
| Llama2-7B-Chat | 35.90 | 35.45 | 73.40 | 44.20 | 55.40 | 46.37 |
| Meditron-7B | 38.40 | 24.07 | 71.40 | 40.20 | 54.50 | 33.06 |
| LERP | 39.10 | 36.65 | 75.60 | 46.76 | 58.66 | 48.44 |
| SLERP | 39.20 | 36.91 | 75.60 | 46.84 | 58.67 | 47.97 |
| DARE-TIES | 36.37 | 27.56 | 72.20 | 42.92 | 54.79 | 41.17 |
| TIES | 38.73 | 32.27 | 75.60 | 45.05 | 58.23 | 45.03 |
Les trois premières colonnes portent sur des questions d'examen et des questions-réponses médicales, les trois dernières sur les capacités générales.
À l'exception de DARE-TIES, qui reste sous Meditron-7B sur USMLE (36.37 contre 38.40), les modèles fusionnés font mieux que Meditron-7B sur les trois épreuves médicales ; LERP et SLERP dépassent aussi Llama2-7B-Chat sur les capacités générales. Les auteurs en concluent que SLERP est le meilleur dans le domaine médical.
Ce tableau demande pourtant quelques précautions. Premièrement, les écarts entre LERP et SLERP sont pour la plupart inférieurs à 0.5 point, et LERP est même devant sur MMLU, ce qui concorde avec le calcul précédent selon lequel « les deux sont presque identiques quand l'angle est petit ». Deuxièmement, le tableau ne précise ni les coefficients de fusion, ni le format des prompts d'évaluation, ni le nombre de répétitions, et ne donne aucune variance : impossible de juger si ces écarts sont stables. Troisièmement, il n'y a qu'une paire de modèles et un seul domaine. Cette expérience tient plutôt de l'exemple d'utilisation et ne suffit pas à départager les méthodes.
La vague des fusions dans les classements
L'article affirme que MergeKit « a permis la fusion de milliers de modèles ». Cette vague a aussi apporté des problèmes.
En mars 2024, des utilisateurs se plaignent sur le forum de l'Open LLM Leaderboard que le classement masque par défaut les modèles portant l'étiquette « merge », ce qui prive leurs modèles fusionnés de visibilité. L'équipe de Hugging Face qui maintient le classement répond que ce masquage s'explique par la quasi-impossibilité de retracer la lignée des modèles fusionnés : après des fusions en cascade, on ne sait plus quelles données s'y sont glissées, ce qui facilite la contamination accidentelle des jeux d'évaluation ; de plus, les scores de ces modèles se traduisent souvent mal en capacités réelles (fil de discussion).
MergeKit lui-même n'y est pour rien, mais l'épisode est révélateur. La fusion fait tendre vers zéro le coût de production d'un nouveau modèle, sans que la fiabilité des évaluations progresse d'autant. Fusionner une pile de modèles bien classés donnera peut-être un score encore plus élevé, mais cela peut se résumer à additionner les questions d'examen que chaque modèle avait vues de son côté.
Le revirement de licence
MergeKit est d'abord publié sous LGPL v3. En février 2025, Arcee passe à la Business Source License lors de la sortie de la v0.1, pour financer le développement à long terme ; le 31 octobre de la même année, l'entreprise annonce le retour à la LGPL v3, les anciennes publications sous BSL restant dans l'historique des versions. Si votre projet est figé sur une ancienne version, vérifiez d'abord quelle licence s'applique à cette version.
Conclusion
L'article MergeKit ne propose aucune nouvelle théorie de la fusion ; sa contribution relève de l'ingénierie. Il réunit les méthodes de différents articles dans un même cadre, rend les recettes de fusion partageables grâce au YAML, et permet de fusionner de grands modèles sur de petites machines grâce au chargement paresseux.
C'est justement parce qu'il est si pratique que la fusion de modèles est passée en 2024 des articles au quotidien de la communauté. Les rapports techniques de modèles ultérieurs comme Llama 3 et Tülu 3 inscrivent eux aussi la fusion dans la procédure d'entraînement officielle.
Avant de vous lancer, retenez une chose. Avec MergeKit, fusionner ne demande plus qu'un fichier YAML ; l'évaluation, elle, ne devient pas plus simple pour autant.