Article original
Task Arithmetic in the Tangent Space: Improved Editing of Pre-Trained Models
- Publication
- NeurIPS 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2305.12827
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingtangenttaskarithmetic2023,
  title = {{Task Arithmetic in the Tangent Space: Improved Editing of Pre-Trained Models}},
  author = {Guillermo Ortiz-Jimenez and Alessandro Favero and Pascal Frossard},
  year = {2023},
  eprint = {2305.12827},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.12827}
}
L'arithmétique des tâches nous a appris qu'en soustrayant les poids d'avant l'ajustement fin à ceux d'après, on obtient un « vecteur de tâche », et que ces vecteurs s'additionnent et se soustraient. Ajoutez les vecteurs de deux tâches, et le modèle sait faire les deux ; retranchez-en un, et il oublie cette tâche.
Ça marche très bien, mais on n'a jamais vraiment su pourquoi.
L'explication alors en vogue était la suivante. Lors de l'ajustement fin d'un grand modèle préentraîné, les poids ne bougent que très peu, et le réseau est à peu près linéaire dans ce petit voisinage ; s'il est linéaire, additionner les poids additionne évidemment les sorties.
Ortiz-Jimenez, Favero et Frossard, de l'EPFL, décident de vérifier sérieusement cette explication. Ils découvrent qu'elle est fausse ; mais en suivant cette fausse piste jusqu'au bout, ils aboutissent à une meilleure méthode.
Définir le problème
Ce qu'exige l'arithmétique des tâches
Précisons d'abord ce que veut dire « l'arithmétique des tâches fonctionne ». Soit les poids préentraînés, les poids après ajustement sur la tâche , et le vecteur de tâche. Chaque tâche a son propre domaine d'entrée , comme les images satellites d'EuroSAT ou les numéros de rue de SVHN, et les domaines d'entrée des différentes tâches ne se recouvrent pas.
Les auteurs formulent l'arithmétique des tâches comme une propriété :
En clair, après l'ajout simultané de plusieurs vecteurs de tâche, le modèle doit, face à une image satellite, se comporter comme s'il n'avait reçu que le vecteur des images satellites ; face à une entrée qui n'appartient à aucune tâche, comme le modèle préentraîné. Chaque vecteur ne modifie que sa propre zone, sans déranger les autres.
L'hypothèse linéaire
Au voisinage de , un réseau de neurones admet un développement de Taylor au premier ordre :
Le membre de droite est linéaire en et équivaut à une méthode à noyau, dont le noyau est le noyau tangent neuronal (neural tangent kernel, NTK) .
Si l'ajustement fin se déroulait vraiment dans ce régime linéaire, la variation de la sortie après ajout de serait la somme des variations propres à chaque tâche, et l'arithmétique des tâches semblerait aller de soi.
Alors, l'ajustement fin de CLIP est-il vraiment linéaire ?
Résoudre le problème
Première vérification : l'ajustement fin n'est pas linéaire
Si l'ajustement fin était linéaire, appliquer le vecteur de tâche issu de l'ajustement fin à l'approximation linéaire devrait donner à peu près le modèle ajusté d'origine. Les auteurs appellent cela la linéarisation a posteriori (post-hoc linearization) :
Les expériences reprennent le cadre de l'article original sur l'arithmétique des tâches : les ViT-B/32, ViT-B/16 et ViT-L/14 de CLIP, ajustés sur huit jeux de données, Cars, DTD, SUN397, EuroSAT, GTSRB, MNIST, SVHN et RESISC45.
Il s'avère que la précision par tâche de la linéarisation a posteriori est nettement inférieure à celle du modèle ajusté d'origine, pour les trois tailles de ViT. Les auteurs appellent cet écart « l'avantage non linéaire ». L'ajustement fin ne reste pas dans le régime linéaire.
Reste une autre possibilité : la partie non linéaire compterait pour chaque tâche isolée, mais l'arithmétique des tâches n'utiliserait que la partie linéaire. Les auteurs vérifient aussi ce point. Ils prennent les vecteurs de tâche de l'ajustement non linéaire et additionnent les huit tâches sur le modèle linéarisé a posteriori :
| Modèle | ViT-B/32 | ViT-B/16 | ViT-L/14 |
|---|---|---|---|
| Préentraîné (zéro-shot) | 48.4 | 55.2 | 64.4 |
| Ajustement non linéaire | 71.4 | 75.5 | 85.1 |
| Linéarisation a posteriori | 57.1 | 65.0 | 75.2 |
Le tableau donne la précision absolue moyenne (%) sur les huit tâches. La linéarisation a posteriori perd plus de 10 points ; l'arithmétique des tâches utilise manifestement aussi la partie non linéaire. L'hypothèse linéaire ne tient pas.
Mais le tableau cache une bizarrerie. En précision normalisée, c'est-à-dire divisée par la précision de l'ajustement sur chaque tâche seule, la linéarisation a posteriori fait au contraire mieux. Sur ViT-B/32, l'ajustement non linéaire obtient 76.5 %, la linéarisation a posteriori 81.9 %. Même chose pour l'oubli de tâche : la linéarisation a posteriori oublie plus proprement.
Le modèle linéarisé fait moins bien sur chaque tâche, mais conserve mieux « ce qui reste après addition ».
Découplage des poids
Selon les auteurs, la condition dont a besoin l'arithmétique des tâches est le découplage des poids (weight disentanglement) :
où n'est non nul que sur , et n'est non nul qu'en dehors de tous les domaines des tâches. La sortie du modèle se décompose en fonctions locales sans recouvrement, chacune contrôlée uniquement par son propre vecteur de tâche.
Cette condition équivaut à la propriété d'arithmétique des tâches énoncée plus haut, et elle n'exige pas la linéarité : peut dépendre des paramètres de n'importe quelle façon. Les auteurs précisent aussi que le découplage des poids porte sur « l'absence d'interférence », une question distincte de la qualité obtenue sur chaque tâche.
Pour mesurer le degré de découplage, les auteurs définissent l'erreur de découplage entre deux tâches :
C'est la proportion, sur les données de la tâche , des prédictions qui diffèrent entre « n'ajouter que son propre vecteur » et « ajouter les deux ». Plus l'erreur est faible, moins les deux vecteurs interfèrent.
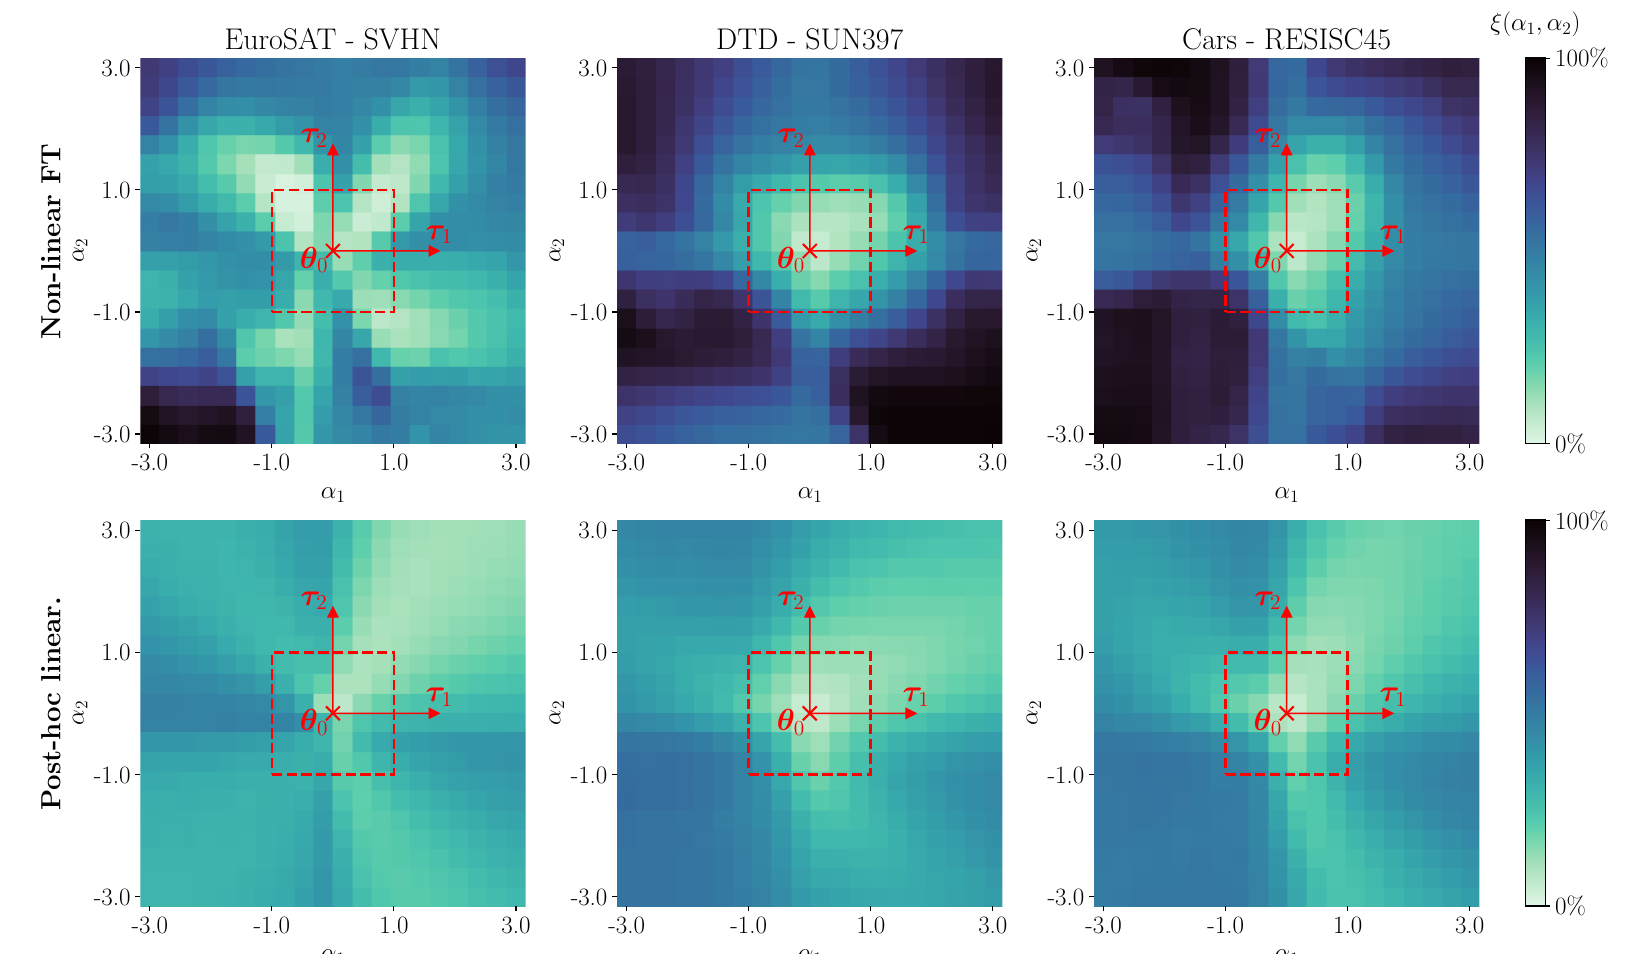
Le centre de chaque carte correspond aux poids préentraînés , et les deux flèches rouges aux deux vecteurs de tâche. En haut, le modèle non linéaire n'est clair que dans une petite zone autour de l'origine ; dès que dépasse 1, l'erreur grimpe rapidement. Cela explique deux observations empiriques de l'article original sur l'arithmétique des tâches : le meilleur coefficient est généralement inférieur à 1, et l'ajustement fin doit utiliser un petit taux d'apprentissage et peu de pas.
En bas, la zone claire du modèle linéarisé a posteriori est bien plus grande. La linéarisation réduit l'interférence entre vecteurs de tâche, d'où sa meilleure précision normalisée.
Le problème devient alors clair. Le modèle linéarisé se découple bien, mais reste trop faible tâche par tâche ; le modèle non linéaire est fort sur chaque tâche, mais se découple moins bien. Peut-on avoir les deux ?
Ajuster directement dans l'espace tangent
Plutôt que de linéariser après coup, les auteurs ajustent dès le départ le modèle linéarisé.
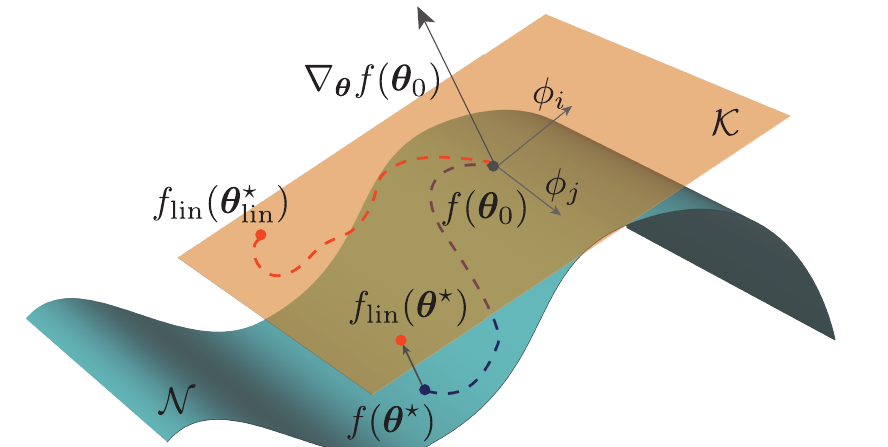
Cette figure réunit les trois approches. La surface courbe représente toutes les fonctions de réseau, le plan l'espace tangent en . L'ajustement ordinaire avance sur la surface jusqu'à ; la linéarisation a posteriori projette ce point d'arrivée sur le plan, d'où la perte de précision ; l'ajustement linéarisé avance dans le plan du début à la fin, et son objectif d'optimisation est le meilleur point du plan, .
Les deux modèles linéaires ont le même noyau, mais le vecteur de tâche est optimisé directement pour le modèle linéaire, d'où de bien meilleures performances par tâche.
En pratique, le modèle linéarisé est un réseau où « est fixé et le déplacement est entraîné ». torch.func.jvp de PyTorch calcule en une seule passe avant et le produit de la jacobienne par le déplacement. Voyons sur un petit MLP quand l'approximation linéaire est précise :
import torch
from torch.func import functional_call, jvp

torch.manual_seed(0)
net = torch.nn.Sequential(torch.nn.Linear(4, 16), torch.nn.Tanh(), torch.nn.Linear(16, 2))
theta0 = {k: v.detach().clone() for k, v in net.named_parameters()}
x = torch.randn(8, 4)

def f(params):
    return functional_call(net, params, (x,))

def f_lin(params):
    delta = {k: params[k] - theta0[k] for k in params}
    out, dp = jvp(f, (theta0,), (delta,))     # f(θ0) et J·(θ − θ0) en une seule passe avant
    return out + dp

direction = {k: torch.randn_like(v) for k, v in theta0.items()}
for scale in [0.01, 0.1, 1.0]:
    theta = {k: theta0[k] + scale * direction[k] for k in theta0}
    gap = (f(theta) - f_lin(theta)).abs().max().item()
    print(f"Facteur de déplacement {scale:<4}  écart maximal entre modèle d'origine et linéarisé {gap:.5f}")
Facteur de déplacement 0.01  écart maximal entre modèle d'origine et linéarisé 0.00152
Facteur de déplacement 0.1   écart maximal entre modèle d'origine et linéarisé 0.13638
Facteur de déplacement 1.0   écart maximal entre modèle d'origine et linéarisé 8.19715
Pour un petit déplacement, les deux sont presque identiques ; dès que le déplacement grandit, l'écart se creuse rapidement. L'ajustement ordinaire va où il veut, hors de portée du modèle linéaire ; l'ajustement linéarisé attache le modèle à l'espace tangent, et quelle que soit la distance parcourue, la relation entre poids et sorties reste linéaire.
Dans les expériences de l'article, les auteurs ne linéarisent que l'encodeur d'images de CLIP, l'encodeur de texte étant de toute façon gelé. Les réglages d'entraînement sont identiques à ceux de l'ajustement ordinaire, 2 000 pas, lots de 128, taux d'apprentissage , AdamW avec calendrier cosinus, sans réglage supplémentaire des hyperparamètres.
Discussion
L'addition comme la soustraction s'améliorent
La dernière ligne donne les résultats de l'ajustement linéarisé :
| Addition de tâches (absolue / normalisée, %) | ViT-B/32 | ViT-B/16 | ViT-L/14 |
|---|---|---|---|
| Ajustement non linéaire | 71.4 / 76.5 | 75.5 / 80.0 | 85.1 / 88.8 |
| Ajustement linéarisé | 76.5 / 85.4 | 81.3 / 86.0 | 88.5 / 93.5 |
La précision absolue moyenne de l'addition des huit tâches progresse de 5.1, 5.8 et 3.4 points pour les trois modèles.
L'oubli de tâche s'évalue en soustrayant un vecteur de tâche et en regardant jusqu'où tombe la tâche cible, sous la condition que la tâche de contrôle, ImageNet, conserve au moins 95 % de la précision du modèle préentraîné. Sur ViT-B/32, l'ajustement non linéaire fait descendre la tâche cible à 24.0 %, l'ajustement linéarisé à 10.9 %, soit 13.1 points d'oubli supplémentaires ; sur ViT-L/14, on passe de 18.0 % à 7.9 %. La précision de la tâche de contrôle est presque identique.
Le choix du coefficient suit l'article original : un seul pour toutes les tâches, cherché entre 0 et 1 par pas de 0.05, en retenant la meilleure valeur sur une petite partie des données d'entraînement.
Le bénéfice de la linéarisation est le plus grand sur les petits modèles ; plus le modèle est grand, plus l'écart se réduit. L'annexe constate aussi que les modèles plus grands sont d'eux-mêmes mieux découplés.
Le coût
La linéarisation n'est pas gratuite. Selon l'annexe, à l'inférence, chaque opération demande un calcul de dérivée supplémentaire, soit environ deux à trois fois le temps du modèle d'origine ; à l'entraînement, le calcul des gradients et la mémoire doublent à peu près. Les auteurs parlent d'une « augmentation d'un facteur constant seulement », mais pour un grand modèle, un coût d'inférence doublé ou triplé se répercute directement sur le déploiement.
C'est aussi par là que les travaux ultérieurs ont attaqué le problème. Partial Linearization, par exemple, ne linéarise que les adapters LoRA, ce qui cantonne le coût à une petite partie des paramètres.
Pourquoi le découplage ?
Les auteurs proposent enfin une explication du point de vue des méthodes à noyau. Le noyau se décompose en un ensemble de fonctions propres . Si chaque tâche n'utilise que des fonctions propres « non nulles uniquement sur son propre domaine d'entrée », les tâches n'interfèrent pas entre elles.
Ils le vérifient concrètement sur ViT-B/32. Après un ajustement linéarisé sur RESISC45, ils décomposent son NTK en éléments propres, puis calculent, en chaque point d'entrée, l'énergie totale des fonctions propres. Les points de RESISC45 ont une énergie nettement plus élevée, tandis que ceux de Cars, pris comme témoin, en ont très peu. Les fonctions propres qui représentent RESISC45 se concentrent bien sur les données de RESISC45.
Les auteurs précisent aussi que cette localisation n'est pas une condition nécessaire de l'arithmétique des tâches, car les fonctions propres pourraient aussi se compenser dans d'autres régions ; elle ne devient nécessaire que si les fonctions propres sont linéairement indépendantes dans chaque région.
Le découplage vient du préentraînement
La dernière expérience supprime le préentraînement. À partir de ViT initialisés aléatoirement, on obtient des vecteurs de tâche par ajustement sur chacune des huit tâches, puis on les additionne.
L'arithmétique des tâches échoue alors complètement. Pour ViT-B/32 initialisé au hasard, la précision moyenne par tâche de l'ajustement non linéaire est de 48.5 % ; après addition des huit vecteurs, il ne reste que 5.5 %, à peu près autant que le modèle initialisé au hasard, avant tout ajustement (5.3 %). L'ajustement linéarisé fait de même.
Le découplage des poids apparaît donc pendant le préentraînement. Le préentraînement n'apprend pas seulement des caractéristiques qui séparent les régions sémantiques ; il sépare aussi les directions de poids qui contrôlent ces régions.
Portée des preuves
Les expériences principales portent sur CLIP ViT et huit jeux de données de classification d'images ; l'annexe ajoute T5 et des réseaux convolutifs. Le non-recouvrement des domaines d'entrée des tâches est la prémisse de toutes les définitions, et il est à peu près vérifié pour les huit jeux de données. Quand les entrées de deux tâches se recouvrent d'emblée, par exemple deux annotations d'un même texte, cette analyse ne s'applique pas directement.
Conclusion
Cet article réfute d'abord l'idée que « l'arithmétique des tâches vient d'un ajustement fin linéaire », puis formule la condition qu'elle exige sous la forme du découplage des poids, c'est-à-dire que chaque vecteur de tâche n'affecte que son propre domaine d'entrée.
Les modèles linéarisés se découplent mieux, mais restent trop faibles par tâche. En déplaçant directement l'ajustement fin dans l'espace tangent, on obtient les avantages des deux, au prix d'une inférence deux à trois fois plus longue.
Si votre budget de déploiement encaisse ce facteur et que vous devez souvent additionner une pile de vecteurs de tâche, l'ajustement linéarisé vaut d'être essayé ; le code officiel enveloppe le modèle linéarisé dans un nn.Module ordinaire, et le script d'entraînement change à peine.
Si le budget ne suit pas, ce n'est pas grave : gardez les coefficients sous 1. Au-delà de 1, les vecteurs de tâche commencent à se battre entre eux.