Article original
Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time
- Publication
- ICML 2022Conférence
- Premier dépôt sur arXiv
- arXiv:2203.05482
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingmodelsoups2022,
  title = {{Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time}},
  author = {Mitchell Wortsman and Gabriel Ilharco and Samir Yitzhak Gadre and Rebecca Roelofs and Raphael Gontijo-Lopes and Ari S. Morcos and Hongseok Namkoong and Ali Farhadi and Yair Carmon and Simon Kornblith and Ludwig Schmidt},
  year = {2022},
  eprint = {2203.05482},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.05482}
}
Pour ajuster un grand modèle, on commence généralement par explorer les hyperparamètres : taux d'apprentissage, décroissance des poids, nombre d'époques et augmentations de données. On entraîne plusieurs modèles, conserve le meilleur sur la validation et supprime les autres.
Ces modèles supprimés ont pourtant consommé du calcul. Six mois après WiSE-FT, où ils mélangeaient CLIP zéro-shot et CLIP ajusté, Wortsman, Ilharco et leurs collègues de l'Université de Washington, de Columbia, de Google, de Meta et de l'Université de Tel-Aviv s'intéressent à ces candidats abandonnés.
Peut-on les moyenner ensemble pour en faire une soupe ?
Définir le problème
Soient les poids préentraînés et les modèles ajustés avec les hyperparamètres , soit pour . Trois usages de ces modèles sont possibles :
| Méthode | Modèle à l'inférence | Coût d'inférence |
|---|---|---|
| Meilleur sur la validation | ||
| Ensemble des sorties | ||
| Soupe de modèles |
D'après la Table 2 de l'article. Les trois approches ont le même coût d'entraînement.
L'ensemble est souvent le plus précis, mais demande d'exécuter modèles. La soupe n'en exécute qu'un : encore faut-il que les poids moyens fonctionnent.
Le cadre diffère des moyennes antérieures. SWA moyenne des points d'une même trajectoire. Ici, les modèles ont été ajustés indépendamment depuis les mêmes poids préentraînés, avec des hyperparamètres parfois très différents.
Résoudre le problème
Trois soupes
La plus directe est la soupe uniforme : moyenner les modèles.
Le risque est évident. Un mauvais réglage, par exemple un taux trop élevé qui mène dans un autre bassin, peut dégrader toute la moyenne.
Les auteurs privilégient donc la soupe gloutonne :
import numpy as np

def average(models):
    return np.mean(np.stack(models), axis=0)

def greedy_soup(models, val_acc):
    """models 依驗證集準確率由高到低排好;val_acc(權重) 回傳驗證集準確率。"""
    soup = [models[0]]
    for m in models[1:]:
        if val_acc(average(soup + [m])) >= val_acc(average(soup)):
            soup.append(m)          # 加進去不會變差,就留下
    return average(soup)

# 小例子:二維輸入、兩個類別,用四筆驗證資料選湯的成員。
X = np.array([[2., 0.], [0., 2.], [1., 0.], [0., 1.]])
y = np.array([0, 1, 0, 1])
models = [np.diag([1., 0.5]), np.diag([0.5, 1.]), -4 * np.eye(2)]
val_acc = lambda w: np.mean((X @ w).argmax(axis=1) == y)
models = sorted(models, key=val_acc, reverse=True)
w = greedy_soup(models, val_acc)
print(w.tolist())
print(f"驗證準確率: {val_acc(w):.0%}")
[[0.75, 0.0], [0.0, 0.75]]
驗證準確率: 100%
On trie les modèles par précision de validation décroissante et on commence par le meilleur. Chaque candidat est ajouté à l'essai : si la précision ne baisse pas, on le garde ; sinon, on le saute. Puisque le premier membre est le meilleur modèle individuel, la soupe gloutonne fait au moins aussi bien sur la validation.
Dans l'exemple, les deux premiers modèles classent correctement les quatre exemples, tout comme leur moyenne. Le troisième inverse la direction de classification et est rejeté. Pour un réseau, il faut moyenner chaque tenseur correspondant ; la sélection reste identique. Avec membres, le candidat vaut . Une moyenne moitié-moitié à chaque ajout donnerait davantage de poids aux derniers arrivés.
L'ordre compte aussi : chaque membre retenu déplace le point moyen utilisé aux essais suivants, et la recherche ne fait qu'un passage. Elle trouve donc une recette acceptable pour cet ordre. En choisissant un ordre aléatoire, les auteurs passent de 81.03 % sur ImageNet à 80.79 % en moyenne. La non-dégradation est vérifiée directement sur la validation ; test et données de déploiement demandent leur propre évaluation.
La validation de sélection ne doit pas être la validation officielle d'ImageNet, généralement utilisée comme test. Les auteurs réservent environ 2 % des images d'entraînement pour choisir la soupe.
La troisième est la soupe apprise : une descente de gradient apprend les coefficients par modèle, voire par couche. Tous les modèles doivent être chargés simultanément en mémoire, peu pratique à grande taille ; l'article la présente en annexe.
Plus précisément, on pose et on effectue la passe avant avec . On minimise l'entropie croisée sur les données de validation réservées, en apprenant aussi une température de sortie. Les poids d'origine restent fixes ; seuls les coefficients changent. Softmax les rend positifs et de somme 1. La variante par couche attribue un distinct à chaque couche. L'annexe utilise AdamW pendant 3 époques à taux constant 0.1, en conservant tous les candidats. Cette méthode remplace les essais gloutons successifs par une optimisation supplémentaire et davantage de mémoire.
Discussion
Le meilleur point est entre les modèles
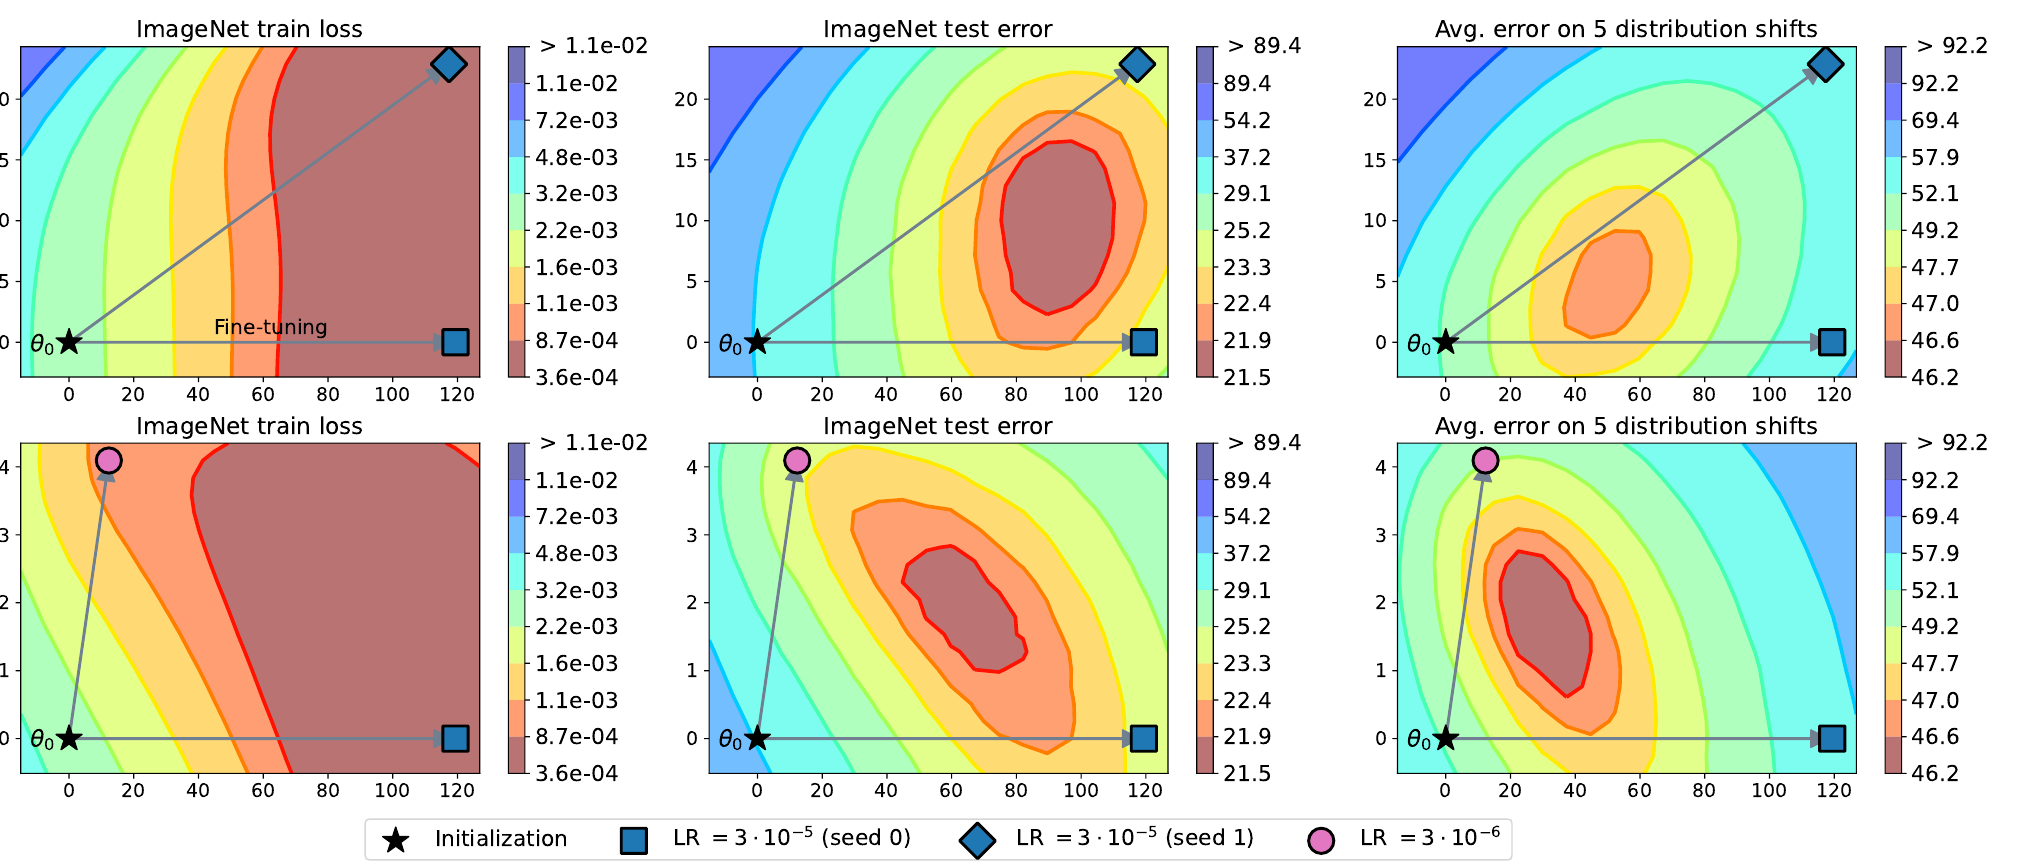
La figure explique le gain possible. Deux ajustements partent de CLIP zéro-shot ; le point initial et leurs deux extrémités définissent un plan où l'on mesure perte et erreur.
Dans la colonne de gauche, les deux ajustements ont atteint une faible perte d'entraînement. Au centre et à droite, le bassin d'erreur de test a son fond entre les deux, sans contenir aucun des trois points. L'ajustement pousse vers une faible perte d'entraînement ; le minimum d'erreur de test se trouve légèrement à côté.
Plus l'angle s'ouvre, plus la moyenne aide
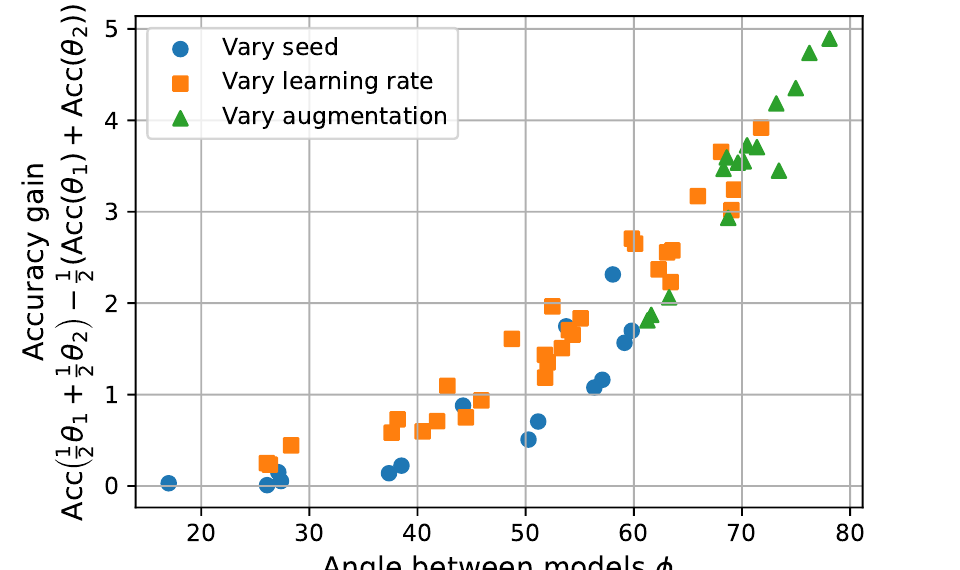
Pour quantifier le bénéfice, les auteurs définissent l'avantage d'interpolation :
Ils le comparent à l'angle entre et , en prenant le préentraînement comme origine pour examiner les directions des deux ajustements.
Les points suivent approximativement une courbe montante. Changer seulement la graine donne surtout des points bleus en bas à gauche : petit angle, petit gain. Changer taux ou augmentations ouvre plus facilement l'angle et augmente le bénéfice, jusqu'à environ 5 points.
Cela motive l'exploration d'hyperparamètres avant la moyenne. Des modèles plus différents peuvent mieux se compléter, tant qu'ils restent dans le même bassin.
72 CLIP
L'expérience principale ajuste CLIP ViT-B/32 sur ImageNet 72 fois avec une recherche aléatoire d'hyperparamètres.
Les modèles partagent le préentraînement ; dans la configuration principale, la tête est initialisée par un linear probe avant l'ajustement de bout en bout. La recherche fait varier le taux de à , le weight decay, la durée de 4 à 16 époques, le label smoothing, mixup et les augmentations. Elle conserve volontairement les bons et mauvais candidats d'une recherche ordinaire pour mesurer le bénéfice récupérable ensuite.
| Méthode | ImageNet | Moyenne sur cinq distributions décalées |
|---|---|---|
| Meilleur modèle individuel | 80.38 | 47.83 |
| Soupe uniforme des 72 modèles | 79.97 | 51.45 |
| Soupe gloutonne | 81.03 | 50.75 |
| Soupe apprise, coefficients par couche | 81.37 | 50.87 |
| Ensemble des sorties des 72 modèles | 81.19 | 50.77 |
Précision (%), d'après la Table 3 de l'article.
La soupe uniforme fait moins bien que le meilleur modèle sur ImageNet, mais gagne plus de trois points sous décalage : certains candidats dégradent bien la moyenne. La soupe gloutonne dépasse le meilleur modèle dans les deux colonnes. Sur ImageNet, elle est seulement 0.16 point sous l'ensemble des 72, avec une seule exécution.
Elle ne conserve finalement que 5 membres. Une autre expérience ALIGN en sélectionne aussi 5 parmi 12. La soupe apprise par couche atteint 81.37 %, mais sa variante à coefficients globaux n'obtient que 80.89 %, sous la soupe gloutonne. Un ensemble glouton des sorties atteint 81.90 % sur ImageNet, mais 49.44 % sous décalage. Le classement dépend de l'objectif de sélection ; la meilleure colonne seule ne décrit pas tous les gains.
Sur les comparaisons à deux modèles, soupe et ensemble ont des précisions très corrélées aux taux modérés. L'ensemble est généralement légèrement meilleur sur ImageNet, la soupe sous décalage. Aux taux trop élevés, les modèles s'éloignent et l'ensemble gagne nettement.
La soupe du record
Le résultat le plus remarqué concerne ViT-G/14, préentraîné sur JFT-3B de Google. Parmi 58 ajustements ImageNet, la soupe gloutonne retient 14 modèles :
| Modèle | ImageNet | Moyenne sous décalage |
|---|---|---|
| CoAtNet-7, record à l'époque | 90.88 | – |
| ViT-G, meilleur candidat de la recherche | 90.78 | 84.68 |
| ViT-G, soupe gloutonne | 90.94 | 85.02 |
Précision top-1 (%), d'après la Table 1 de l'article.
Les 90.94 % établissent alors le record ImageNet, avec 25 % de calcul d'inférence en moins que CoAtNet-7. Le gain sur le meilleur candidat est de 0.16 point, sans budget d'entraînement supplémentaire.
Le périmètre d'efficacité
Les auteurs testent aussi ALIGN, BASIC, deux jeux WILDS et quatre tâches GLUE de classification textuelle avec BERT et T5. La tendance est cohérente en vision ; les gains textuels sont plus faibles et présentés comme préliminaires.
Pour chaque tâche textuelle, 32 réglages sont tirés aléatoirement, en faisant varier taux, taille des lots, époques et graines. Les tâches sont MRPC, reformulation de paires de phrases, RTE, implication textuelle, CoLA, acceptabilité grammaticale, et SST-2, sentiment. Les mesures diffèrent : moyenne accuracy/F1 pour MRPC, corrélation de Matthews pour CoLA, précision pour RTE et SST-2. BERT-base passe de 61.0 à 61.7 sur RTE et de 92.5 à 93.0 sur SST-2, sans gain sur MRPC ni CoLA ; T5-base passe de 78.3 à 79.1 sur RTE. Ces expériences fusionnent des ajustements d'une même tâche ; elles n'évaluent pas une soupe unique résolvant les quatre.
Deux limites sont explicites. D'abord, les modèles étudiés sont surtout préentraînés sur des données vastes et variées. Avec ImageNet-22k, les soupes gloutonnes progressent encore, mais bien moins. Ensuite, l'ensemble améliore la calibration de confiance, un effet que la soupe ne reproduit pas.
Pour la calibration, les auteurs prennent 20 modèles qui ne diffèrent que par la graine, puis mesurent l'expected calibration error, afin d'isoler cet effet des hyperparamètres. Précision des classes et fiabilité des probabilités sont deux besoins distincts ; un seuil de refus fondé sur les probabilités exige de vérifier directement le second.
Pourquoi perdre face à l'ensemble dans le même bassin ?
Au-delà de l'intuition géométrique, l'article analyse l'écart d'entropie croisée entre soupe et ensemble de logits. Pour deux modèles, l'approximation contient un terme lié à la dérivée seconde de la perte sur le segment et un terme de variance des différences de logits aux extrémités, sous la distribution softmax de la soupe.
Une courbure favorable abaisse la perte relative de la soupe ; le second terme favorise l'ensemble. Si les modèles sont très semblables, les écarts de logits sont petits. Si la soupe est très certaine et son softmax presque concentré sur une classe, la variance est faible aussi. La seule appartenance à un même bassin ne permet donc pas de prévoir tout l'écart.
L'approximation suppose des logits presque linéaires sur le segment. Sa corrélation avec l'écart réel s'améliore après exclusion des modèles trop éloignés entraînés à . Dans le paysage obtenu à , une barrière nette apparaît entre les deux ajustements. Même un départ commun peut produire ces mauvais candidats, d'où l'utilité du contrôle glouton.
Conclusion
Model Soups remplace « explorer les hyperparamètres et ne garder qu'un modèle » par « en sélectionner plusieurs et moyenner leurs poids ». Le coût d'entraînement reste identique et un seul modèle est exécuté. Sur CLIP et ViT-G, la soupe dépasse le meilleur candidat individuel.
Comme pour WiSE-FT, tous les membres partent des mêmes poids préentraînés et devraient rester dans le même bassin. La validation gloutonne filtre les candidats qui s'en écartent.
Si vous disposez déjà d'ajustements d'une même base avec différents hyperparamètres, essayez donc cette recette avant de ne conserver que le meilleur.