Article original
Tulu 3: Pushing Frontiers in Open Language Model Post-Training
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2411.15124
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformerstulu32024,
  title = {{Tulu 3: Pushing Frontiers in Open Language Model Post-Training}},
  author = {Nathan Lambert and Jacob Morrison and Valentina Pyatkin and Shengyi Huang and Hamish Ivison and Faeze Brahman and Lester James V. Miranda and Alisa Liu and Nouha Dziri and Shane Lyu and Yuling Gu and Saumya Malik and Victoria Graf and Jena D. Hwang and Jiangjiang Yang and Ronan Le Bras and Oyvind Tafjord and Chris Wilhelm and Luca Soldaini and Noah A. Smith and Yizhong Wang and Pradeep Dasigi and Hannaneh Hajishirzi},
  year = {2024},
  eprint = {2411.15124},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2411.15124}
}
Les poids des modèles préentraînés sont de plus en plus souvent publiés, mais le post-entraînement reste en grande partie dans le brouillard.
Le rapport technique de Llama 3 indique six tours de SFT, d'échantillonnage par rejet et de DPO, mais les données utilisées et la façon de les filtrer restent invisibles de l'extérieur. Une note de bas de page du rapport Tülu 3 cite une statistique : en novembre 2024, aucun des 50 premiers modèles du classement LMSYS Chatbot Arena n'avait publié ses données de post-entraînement.
Les recettes de post-entraînement de la communauté ouverte, comme Tülu 2 et Zephyr-β, s'en sortent correctement sur les évaluations de type conversation, mais restent nettement à la traîne en mathématiques (MATH, GSM8K) et en suivi précis d'instructions (IFEval).
En novembre 2024, Lambert et al., de l'Allen Institute for AI (AI2) et de l'Université de Washington, publient Tülu 3 pour combler ce manque. Un tülu est un hybride de dromadaire et de chameau de Bactriane ; les auteurs gardent ce nom pour la troisième génération. Cette fois, en plus des poids du modèle, ils publient les données d'entraînement, le pipeline de génération de données, le code d'entraînement, les outils d'évaluation et les checkpoints intermédiaires.
Cette note suit sa recette en trois temps : SFT, DPO et RLVR, une méthode nouvellement proposée par les auteurs.
Définir le problème
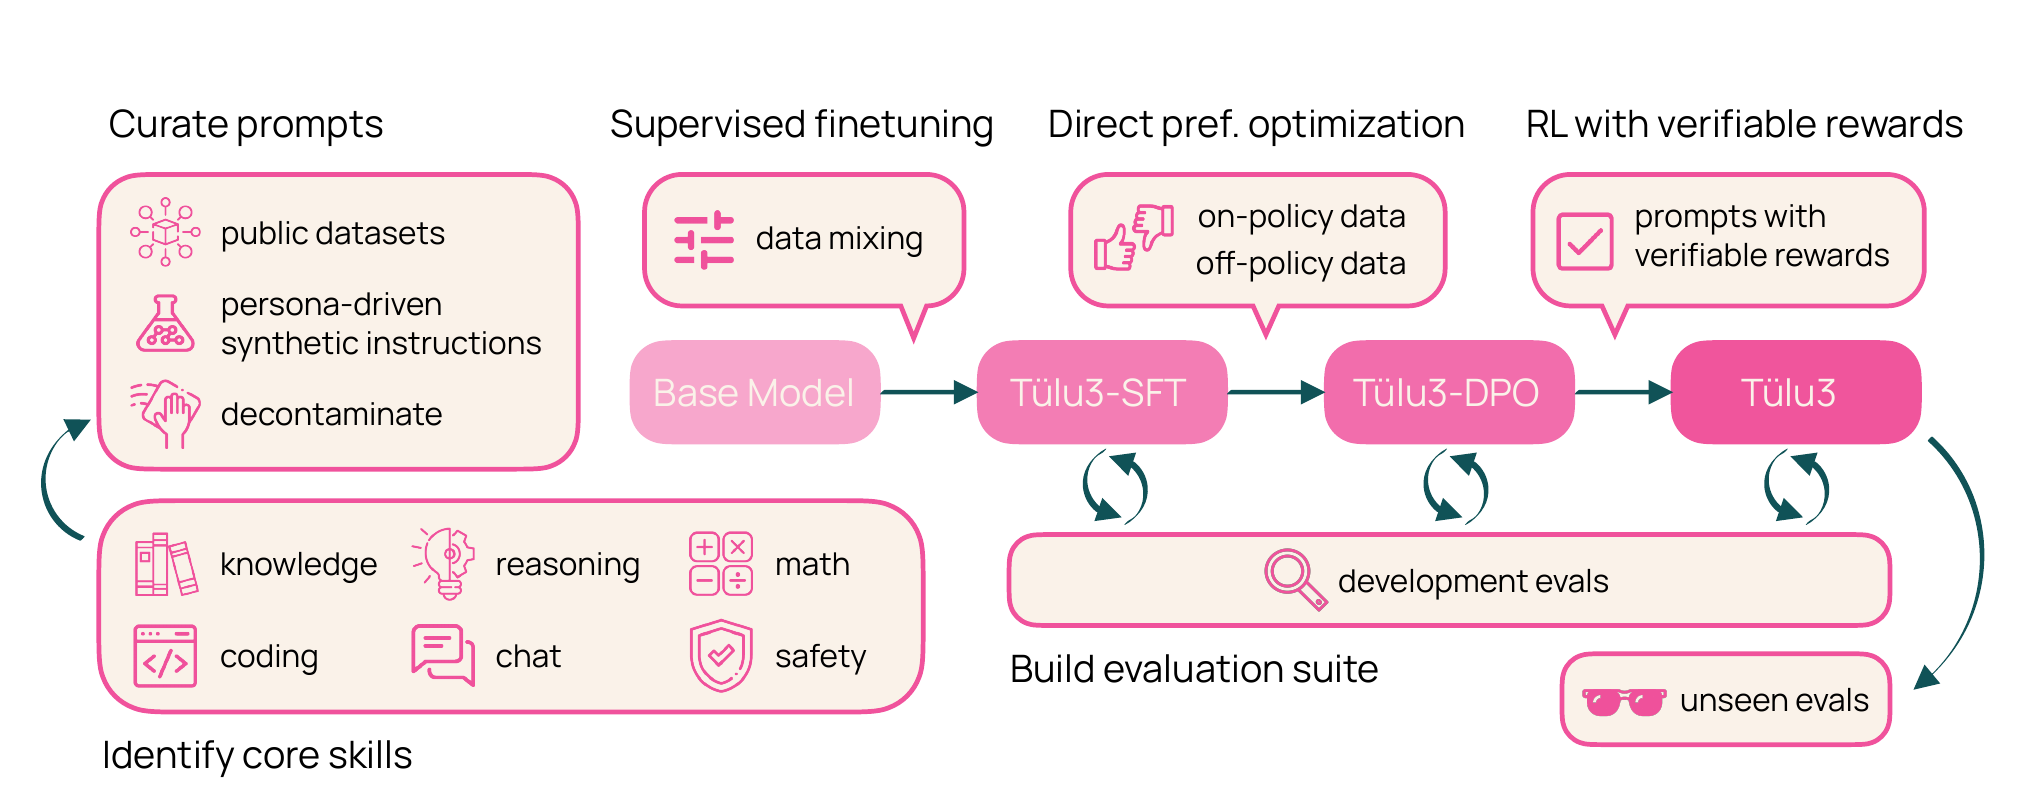
Ce schéma se lit à partir du coin inférieur gauche. Les auteurs fixent d'abord un ensemble de capacités clés à renforcer : connaissances, raisonnement, mathématiques, code, suivi d'instructions et conversation, sécurité. À chaque capacité correspondent quelques évaluations.
Les évaluations forment deux groupes. Le groupe de développement sert tout au long du travail, pour choisir les données et régler les hyperparamètres ; le groupe inédit ne sert qu'une fois, à la fin, pour vérifier que le modèle ne s'est pas trop ajusté au groupe de développement. Par exemple, pour les connaissances, les évaluations de développement sont MMLU, PopQA et TruthfulQA, et les évaluations inédites MMLU-Pro et GPQA ; pour le suivi d'instructions, les évaluations de développement sont IFEval et AlpacaEval 2, et les inédites IFEval-OOD et HREF.
Les modèles de base sont Llama 3.1 8B et 70B, auxquels s'est ajouté plus tard le 405B. Toute la recette répond à une question. En n'utilisant que des données publiques ou publiables, peut-on obtenir un modèle post-entraîné du niveau de Llama 3.1 Instruct, voire meilleur ?
Résoudre le problème
Données : repêcher d'abord les questions d'examen
Les prompts viennent de deux sources. Les uns proviennent de jeux de données publics existants, comme les vraies conversations d'utilisateurs de WildChat ; les autres sont synthétiques. Pour les données synthétiques, la méthode est intéressante. On prépare d'abord un grand nombre de « personas », puis on demande à GPT-4o d'incarner ces personnages pour rédiger des questions, ce qui augmente la diversité des sujets. Environ 220 000 exemples de mathématiques et 35 000 de code ont ainsi été synthétisés.
Le plus grand risque des jeux de données publics est qu'ils contiennent des questions d'évaluation. Les auteurs ont donc mis au point un pipeline de décontamination :
- Ne comparer que les prompts. Les réponses des données d'entraînement sont souvent régénérées ; les comparer n'aurait pas de sens.
- Comparer par 8-grammes. Pour chaque token d'une évaluation, il suffit qu'un des 8-grammes qui le contiennent apparaisse aussi dans un exemple d'entraînement pour que ce token compte comme apparié. Si plus de 50 % des tokens d'une question d'évaluation sont appariés avec un même exemple d'entraînement, on considère que les deux se recouvrent. Les auteurs ont essayé la correspondance exacte de chaînes et la comparaison par vecteurs d'embedding : la première est trop stricte, la seconde distingue mal une « reformulation » d'une simple « similarité de sujet » ; les 8-grammes repèrent des cas comme « le même problème de maths où seuls les nombres ont changé ».
- Garder ou non tout le jeu de données. Un jeu d'entraînement est considéré comme contaminé dès que plus de 2 % de ses questions recouvrent une évaluation, quelle qu'elle soit. S'il recouvre le groupe inédit, tout le jeu est supprimé ; s'il recouvre le groupe de développement, on supprime tout le jeu si cela ne nuit pas aux performances, sinon seulement les exemples en recouvrement.
Ce pipeline a effectivement repéré pas mal de choses. Par exemple, dans NuminaMath-TIR, un jeu de mathématiques couramment utilisé, 11.3 % des problèmes recouvraient l'évaluation MATH ; ils ont été supprimés et le jeu a été republié.
SFT : le mélange des données et le piège d'une fonction de perte
Le point clé du SFT est le mélange. Partant du mélange de Tülu 2, les auteurs ajoutent de nouvelles données tour après tour, font des ablations, puis procèdent à plusieurs tours de décontamination, pour aboutir au mélange SFT final de Tülu 3. La décontamination fait légèrement baisser les scores du groupe de développement, un coût attendu.
L'entraînement dure 2 époques, avec des lots de 128 et des séquences de 4 096 tokens au maximum ; le taux d'apprentissage est de pour le 8B et de pour le 70B. Le 8B s'entraîne 6 heures sur 32 GPU, le 70B 50 heures sur 64 GPU.
Cette section contient deux observations liées à la fois à la fusion de modèles et à l'implémentation.
Model Soups ne bat pas le meilleur modèle individuel. Les auteurs entraînent plusieurs modèles SFT avec différentes graines aléatoires, puis en font une moyenne linéaire avec MergeKit. Pour le 8B, les cinq graines obtiennent des scores moyens de 59.8 à 60.1, et la meilleure soupe (moyenne de deux graines) obtient 60.2 ; pour le 70B, les trois graines obtiennent 71.8, 70.0 et 72.6, et la meilleure soupe 72.5. L'écart entre graines n'est pas négligeable, 2.6 points pour le 70B, mais la soupe ne dépasse pas systématiquement la meilleure graine. Les auteurs retiennent finalement le meilleur modèle SFT individuel.
Cela diffère de la conclusion de Model Soups en classification d'images, ainsi que de la pratique de Llama 3 et de Gemma 2, qui intègrent la moyenne dans leur procédure officielle. Une raison possible est que seules des graines différentes sont moyennées ici, sans varier les données ni les hyperparamètres, si bien que les modèles diffèrent trop peu ; mais l'article ne pousse pas l'analyse plus loin.
La façon de moyenner la perte modifie discrètement la pondération. Au début de l'entraînement, les auteurs constatent que les mêmes données donnent des modèles aux performances différentes selon qu'ils les entraînent avec leur propre framework ou sur TPU. En remontant la piste, ils découvrent que la bibliothèque Transformers calcule mal la perte lors de l'accumulation de gradients.
Faisons le calcul sur un exemple. Un lot contient deux exemples : le premier a 10 tokens valides et une perte totale de 20 ; le second a 90 tokens valides et une perte totale de 90.
- Si les deux exemples passent ensemble dans la propagation avant, la bibliothèque moyenne sur l'ensemble des tokens valides, . Chaque token a le même poids.
- Avec l'accumulation de gradients en deux passes, chaque passe fait sa propre moyenne, puis on moyenne les deux, . Chaque exemple a le même poids, et les tokens de l'exemple court sont amplifiés 9 fois.
Il suffit de changer le nombre d'étapes d'accumulation de gradients pour que l'objectif d'entraînement change aussi. La solution des auteurs est de passer à une perte sommée, sans diviser par le nombre de tokens, et de réajuster le taux d'apprentissage ; cela revient à donner le même poids à chaque token, et cela donne aussi de meilleurs résultats dans leurs expériences. Ce problème a été largement discuté dans la communauté à l'automne 2024 ; l'article cite notamment les explications d'Unsloth.
Ajustement par préférences : données on-policy et DPO normalisé par la longueur
La génération des données de préférences reprend, en l'améliorant, le pipeline d'UltraFeedback :
- Choisir des prompts : ceux déjà utilisés en SFT, ceux de même source mais non utilisés en SFT, et de nouveaux prompts.
- Tirer au hasard, dans un ensemble de 22 modèles, quatre modèles qui répondent chacun au prompt. Ce sont des données off-policy. On ajoute aussi les réponses du modèle Tülu 3 SFT lui-même : ce sont des données on-policy, qui rapprochent les préférences des sorties que produit le modèle en cours d'entraînement.
- Demander à GPT-4o de noter chaque réponse de 1 à 5 sur quatre axes : utilité, suivi d'instructions, véracité et honnêteté. La réponse de meilleure note moyenne devient la réponse « choisie », et une réponse tirée au hasard parmi les moins bien notées devient la réponse « rejetée ».
Pendant les ablations, le 8B utilise 96 911 exemples off-policy et 19 444 exemples on-policy ; les données de préférences finales dépassent 270 000 exemples. Les auteurs constatent aussi que plus le nombre de prompts uniques est élevé dans les données de préférences, meilleurs sont les résultats ; réutiliser simplement les mêmes prompts apporte peu.
Côté algorithme, les auteurs comparent DPO, SimPO, PPO et d'autres méthodes, et choisissent finalement un DPO normalisé par la longueur :
La seule différence avec le DPO original est que chacun des deux rapports de log-probabilités est divisé par la longueur de la réponse, et . Les humains comme les juges automatiques préfèrent les réponses longues ; sans normalisation, le modèle apprend facilement qu'« il suffit d'écrire plus long ». Les auteurs le choisissent aussi parce qu'il est plus simple et plus rapide que PPO, ce qui facilite les ajustements répétés du mélange de données.
RLVR : des points seulement pour les bonnes réponses
La troisième phase est RLVR (Reinforcement Learning with Verifiable Rewards, apprentissage par renforcement à récompenses vérifiables), proposé par les auteurs.
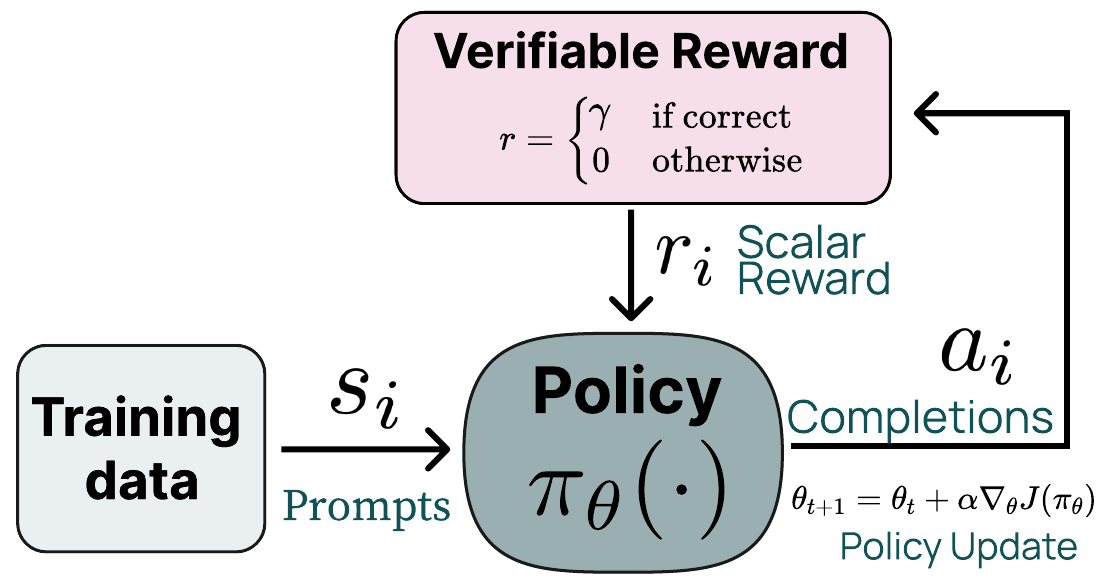
Le RLHF ordinaire attribue les scores avec un modèle de récompense. RLVR remplace ce modèle par une fonction de vérification déterministe :
Le texte note la récompense et la figure ; il s'agit de la même valeur, que les auteurs fixent à 10 d'après des expériences préliminaires, sans la régler ensuite.
La fonction de vérification ne sert que pour trois types de tâches faciles à vérifier : les jeux d'entraînement de GSM8K et de MATH, où l'on extrait la réponse finale pour la comparer à la réponse de référence ; et des instructions tirées des données SFT de Tülu 2, auxquelles on ajoute des contraintes de format à la IFEval (par exemple « répondre en 100 mots au plus »), dont le respect est vérifié par programme. Cela fait environ 30 000 prompts au total.
L'optimisation utilise PPO, et les auteurs listent quelques détails d'implémentation qui stabilisent PPO : initialiser le modèle de valeur à partir d'un modèle de récompense ordinaire, désactiver le dropout pendant l'entraînement, retirer 10 points aux réponses qui ne se terminent pas normalement, standardiser les avantages. Côté infrastructure, la génération des réponses tourne sous vLLM sur des GPU dédiés et l'entraînement sur un autre groupe de GPU, les deux de façon asynchrone ; la politique est toujours entraînée sur l'avant-dernier lot de données générées, un compromis entre efficacité et reproductibilité.
Discussion
Ce qu'apporte RLVR
En partant du meilleur modèle DPO, la Table 23 de l'article donne les résultats suivants :
| 8B DPO | 8B RLVR | 70B DPO | 70B RLVR | |
|---|---|---|---|---|
| Moyenne | 64.4 | 64.8 | 75.9 | 76.0 |
| MATH | 42.0 | 43.7 | 62.3 | 63.0 |
| GSM8K | 84.3 | 87.6 | 93.5 | 93.5 |
| IFEval | 81.1 | 82.4 | 82.6 | 83.2 |
| Sécurité | 87.2 | 85.5 | 89.0 | 88.3 |
Sur le 8B, les trois tâches cibles progressent, GSM8K de 3.3 points ; mais le score de sécurité perd 1.7 point et la moyenne globale ne gagne que 0.4. Sur le 70B, le gain est encore plus faible, GSM8K étant déjà proche de la saturation. Les auteurs reconnaissent aussi que certaines expériences 8B portent GSM8K à 89.4 et IFEval à 84.8, mais en dégradant d'autres indicateurs, si bien que la moyenne globale baisse.
Les courbes d'entraînement montrent que RLVR fait bien monter continuellement la précision sur le jeu d'entraînement, mais que plus la divergence KL est grande, plus le score moyen a tendance à baisser. Autrement dit, plus le modèle s'éloigne de son point de départ, plus le risque de suroptimisation augmente.
Pour le 405B, la démarche diffère un peu. GSM8K est déjà saturé après SFT et DPO, et les données IFEval aidaient peu dans les premières expériences ; seul le jeu d'entraînement de MATH est donc utilisé. En 25 étapes seulement, MATH gagne plus de 5 points ; faute de calcul, l'entraînement s'arrête à 75 étapes, alors que la courbe n'a pas encore saturé. Le 405B utilise 256 GPU, 16 pour la génération sous vLLM et 240 pour l'entraînement ; chaque itération prend environ 550 secondes de génération, 25 secondes de synchronisation des poids et 1 500 secondes d'entraînement. Pour économiser du calcul, le modèle de valeur n'est qu'un 8B.
Résultats globaux
Sur la suite d'évaluation constituée par les auteurs, Tülu 3 8B obtient une moyenne de 65.1, au-dessus des 62.9 de Llama 3.1 8B Instruct, mais légèrement sous les 66.5 de Qwen 2.5 7B Instruct ; Tülu 3 70B obtient 76.2, au-dessus des 74.1 de Llama 3.1 70B Instruct et des 72.8 de Qwen 2.5 72B Instruct, ainsi que des 69.6 de GPT-4o mini et des 75.3 de Claude 3.5 Haiku. La version 405B obtient une moyenne hors sécurité de 80.0, contre 79.0 pour DeepSeek-V3 et 80.5 pour GPT-4o, dans la même zone.
Attention, la plupart de ces évaluations appartiennent au groupe de développement choisi par les auteurs eux-mêmes, celui-là même que tout le développement a optimisé de façon répétée ; le groupe inédit est justement conçu pour couvrir ce risque.
Les tentatives infructueuses
Les auteurs consacrent toute une section aux « tentatives sans résultat », ce qui est rare dans un rapport technique :
- Online DPO : à chaque étape, on échantillonne deux réponses de la politique courante, on marque la préférence avec le modèle de récompense, puis on met à jour. En mathématiques, GSM8K ne progresse presque pas et MATH recule.
- Échantillonnage par rejet : cette méthode, très utilisée par Llama 3, n'apporte ici qu'un gain limité pour le calcul investi. Les auteurs observent que le modèle juge doit être assez fort pour choisir de bonnes réponses, et qu'ajouter la réponse d'origine aux candidates fonctionne bien mieux que de choisir uniquement parmi les réponses nouvellement générées.
Limites
Les données d'entraînement sont surtout des conversations courtes, de 2.4 tours en moyenne, et la plupart des exemples font moins de 2 048 tokens ; le long contexte et le dialogue multi-tours sont des lacunes claires. Les données de préférences et une partie des données synthétiques sont générées ou notées par GPT-4o ; « entièrement ouvert » désigne la publication des données et du pipeline, mais les données elles-mêmes dépendent encore d'un modèle fermé.
Conclusion
La valeur de Tülu 3 tient pour moitié au modèle, pour moitié à cette recette complète. Seuils de décontamination, mélange SFT, manière de sommer la perte, génération des données de préférences, détails à surveiller dans PPO : tout est écrit noir sur blanc, y compris les tentatives ratées.
RLVR lui-même est très simple (des points pour une bonne réponse, aucun pour une mauvaise) et apporte des progrès stables mais modestes en mathématiques et en respect des formats. Quelques mois plus tard, DeepSeek-R1 a poussé bien plus loin le raisonnement avec des récompenses déterminées par des règles, et les « récompenses vérifiables » sont devenues une pratique courante du post-entraînement par renforcement.
Si vous ne deviez retenir qu'une chose de ce rapport, allez vérifier comment votre code d'entraînement moyenne la perte pendant l'accumulation de gradients.