Article original
Communication-Efficient Learning of Deep Networks from Decentralized Data
- Publication
- AISTATS 2017Conférence
- Premier dépôt sur arXiv
- arXiv:1602.05629
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingfedavg2016,
  title = {{Communication-Efficient Learning of Deep Networks from Decentralized Data}},
  author = {H. Brendan McMahan and Eider Moore and Daniel Ramage and Seth Hampson and Blaise Agüera y Arcas},
  year = {2016},
  eprint = {1602.05629},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1602.05629}
}
Pour prédire le mot suivant sur le clavier d'un téléphone, les meilleures données d'entraînement sont les mots que les utilisateurs tapent chaque jour.
Le problème, c'est que ces mots comprennent des messages, des URL, voire des mots de passe. Tout téléverser dans un centre de données pour l'entraînement fait courir un gros risque à la vie privée ; et la langue des conversations est très éloignée de celle de Wikipédia ; en se rabattant sur un corpus public, on n'apprend pas les habitudes de frappe réelles des utilisateurs.
En 2016, McMahan, Moore, Ramage et leurs collègues de Google proposent une approche où les données restent sur le téléphone, et où chaque téléphone renvoie seulement au serveur « comment modifier le modèle ». Ils appellent ce mode d'entraînement apprentissage fédéré (Federated Learning) et donnent un algorithme très simple, FederatedAveraging, que tout le monde abrégera ensuite en FedAvg.
Cet article compte aussi dans l'histoire de la fusion de modèles. Chaque tour de FedAvg répète la même opération, moyenner directement de nombreux jeux de poids entraînés chacun de son côté. L'article contient une petite figure qui explique pourquoi cela fonctionne avec des réseaux de neurones, et les recherches ultérieures sur la fusion de modèles reviennent sans cesse à cette condition.
Définir le problème
Supposons clients (des téléphones, par exemple) ; le client détient exemples, pour un total de . On veut minimiser la perte moyenne sur l'ensemble des données :
est la perte moyenne sur les données propres au client . Si les données sont mélangées puis réparties au hasard, l'espérance de chaque est égale à : c'est le cas IID que suppose habituellement l'entraînement distribué.
Les auteurs relèvent quatre différences entre l'apprentissage fédéré et un centre de données :
- Non-IID : les données de chaque téléphone viennent d'un seul utilisateur, avec une distribution très différente de l'ensemble.
- Déséquilibre : certains tapent des milliers de mots par jour, d'autres ne se servent du clavier qu'une fois par mois.
- Forte dispersion : le nombre de clients participants peut dépasser le nombre moyen d'exemples par client.
- Communication limitée : les téléphones sont souvent hors ligne, leur bande passante montante est généralement inférieure à 1 Mo/s, et ils ne participent volontiers que lorsqu'ils sont en charge et connectés à un Wi-Fi illimité ; chaque jour, ils ne peuvent prendre part qu'à quelques tours.
C'est ce dernier point qui dicte la métrique de tout l'article. Le calcul sur le téléphone est relativement bon marché ; ce qui coûte cher, ce sont les tours de communication. Pour comparer les méthodes, l'article regarde donc combien de tours de communication il faut pour atteindre la précision cible.
L'objectif est clair, dépenser un peu plus de calcul local pour économiser des tours de communication. Mais un gros problème se pose. La perte d'un réseau de neurones n'est pas convexe ; moyenner directement deux jeux de poids entraînés séparément peut, en théorie, donner un très mauvais modèle. Pourquoi aurait-on le droit de moyenner ?
Résoudre le problème
Partir de FedSGD
Les auteurs définissent d'abord une référence. À chaque tour, une fraction des clients est tirée au hasard ; chaque client sélectionné calcule le gradient sur toutes ses données, et le serveur met à jour le modèle avec la moyenne des gradients pondérée par la quantité de données :
C'est une SGD synchrone à grand lot, que l'article appelle FederatedSGD (FedSGD). contrôle la taille du lot global de chaque tour ; correspond à une descente de gradient sur le lot complet.
Les auteurs réécrivent ensuite la même mise à jour. Chaque client fait d'abord un pas avec son propre gradient, puis le serveur moyenne les poids :
Les deux écritures sont mathématiquement équivalentes : tous les clients partent du même , donc moyenner les poids revient à moyenner les gradients.
Sous cette seconde forme, l'étape suivante devient naturelle. Puisque le client fait déjà un pas en local, pourquoi ne pas en faire plusieurs avant de répondre ?
FedAvg
Avec FedAvg, chaque client exécute plusieurs passes de SGD en local, puis renvoie ses poids au serveur, qui en fait la moyenne. Trois paramètres règlent la quantité de calcul :
- : la fraction de clients qui participent à chaque tour.
- : le nombre d'époques que chaque client effectue sur ses données locales.
- : la taille du mini-lot local ; signifie que toutes les données locales forment un seul lot.
Un client qui détient exemples effectue mises à jour locales par tour. Avec et , FedAvg se réduit à FedSGD.
Côté serveur, la procédure s'écrit à peu près ainsi :
def fedavg_round(w, clients, C, E, B, lr):
    m = max(int(C * len(clients)), 1)
    selected = random.sample(clients, m)
    total = sum(c.num_examples for c in selected)

    new_w = zeros_like(w)
    for c in selected:
        w_k = client_update(c, w, E, B, lr)          # part du même w, E époques en local
        new_w += (c.num_examples / total) * w_k      # pondéré par les données des participants du tour
    return new_w
Le dénominateur de la moyenne pondérée est la quantité totale de données des clients sélectionnés à ce tour, . Si un tour retient trois téléphones avec 600, 300 et 100 exemples, les coefficients valent 0.6, 0.3 et 0.1 ; les clients qui ont plus de données pèsent davantage dans le nouveau modèle.
Pourquoi peut-on moyenner ?
Revenons à la question précédente. Les auteurs y répondent par une petite expérience.
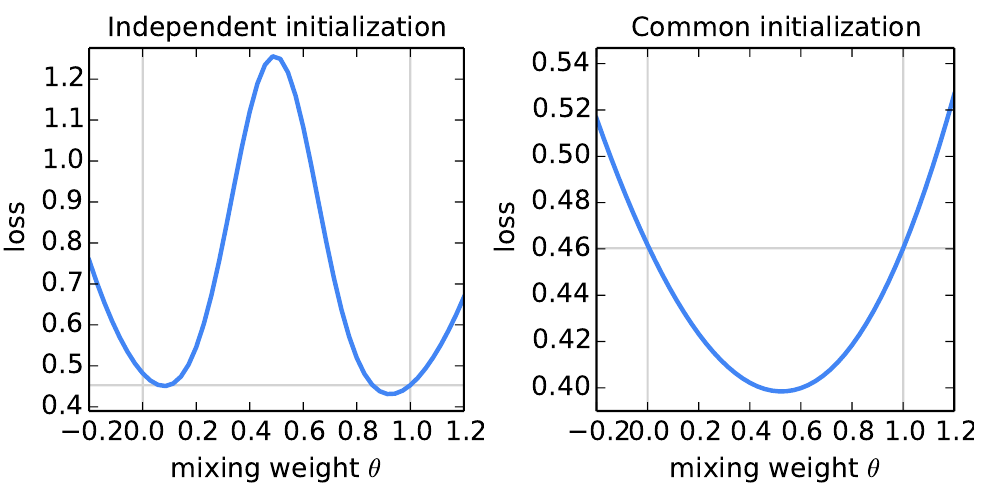
Le dispositif est minuscule. Deux perceptrons multicouches, et , sont entraînés chacun sur 600 exemples MNIST disjoints, avec un taux d'apprentissage de 0.1 et des lots de 50, pendant 240 pas (soit 20 époques), à peu près jusqu'au point où ils commencent à surapprendre leurs données locales. On calcule ensuite la perte de sur l'ensemble d'entraînement complet, pour allant de −0.2 à 1.2.
Regardons d'abord la figure de gauche. Les deux modèles sont initialisés avec des graines aléatoires différentes ; aux deux extrémités, la perte tourne autour de 0.45, mais le modèle moyen du milieu dépasse 1.2, pire que chacun des deux.
Puis celle de droite. Les deux modèles partent de la même initialisation aléatoire et la courbe devient un bol. La perte de vaut environ 0.40, nettement sous les quelque 0.46 de chacun des deux modèles parents. Attention, les échelles verticales des deux graphiques diffèrent : à droite, toute la courbe reste basse.
À chaque tour de FedAvg, tous les clients partent du même : on se trouve exactement dans le cas de droite. Les auteurs ne démontrent pas que cela vaut pour tous les réseaux ; ils citent seulement les observations de l'époque sur le paysage de perte des réseaux surparamétrés, puis illustrent l'intuition avec cette figure.
« Des poids issus d'un point de départ commun peuvent être moyennés directement » : l'idée reviendra souvent dans les travaux de fusion de modèles comme SWA, Model Soups ou l'arithmétique des tâches, toujours avec la même condition d'un point de départ partagé.
Discussion
Dispositif expérimental
Les auteurs entraînent plus de deux mille modèles, répartis entre cinq architectures et quatre jeux de données :
- MNIST 2NN : perceptron multicouche à deux couches de 200 unités, 199 210 paramètres.
- MNIST CNN : deux convolutions 5×5 suivies d'une couche entièrement connectée de 512 unités, 1 663 370 paramètres.
- Shakespeare LSTM : LSTM à deux couches au niveau des caractères, 866 578 paramètres.
- CIFAR-10 : le petit CNN du tutoriel TensorFlow, environ paramètres.
- LSTM de prédiction du mot suivant à grande échelle : vocabulaire de 10 000 mots, 4 950 544 paramètres.
Le découpage des données est le point central de l'article. La version IID de MNIST est mélangée et répartie entre 100 clients, à raison de 600 exemples chacun. La version non IID trie d'abord les exemples par chiffre, les coupe en 200 tranches de 300, et donne deux tranches à chaque client ; la plupart des clients n'ont vu que deux chiffres, un cas extrême construit délibérément par les auteurs.
Shakespeare se rapproche davantage de la réalité. Chaque rôle de chaque pièce des œuvres complètes de Shakespeare devient un client, soit 1 146 clients. Les rôles bavards et ceux qui n'ont que quelques répliques diffèrent beaucoup : les données sont naturellement déséquilibrées et non IID.
Chaque configuration est balayée sur une grille de taux d'apprentissage ; on retient le meilleur, puis on relève le nombre de tours auquel la courbe d'apprentissage franchit la précision cible.
Parallélisme : combien de participants ?
La première série d'expériences fixe et fait varier la fraction de participants par tour. Pour 2NN avec , sur les données IID, passer d'un client par tour à (10 clients) fait tomber le nombre de tours nécessaires pour atteindre 97 % de précision de 316 à 87 ; sur les données non IID, de 3 275 à 664.
Avec , augmenter a beaucoup moins d'effet. Les auteurs retiennent finalement comme valeur par défaut pour la suite, y voyant un compromis entre efficacité de calcul et vitesse de convergence.
Quelques pas locaux de plus
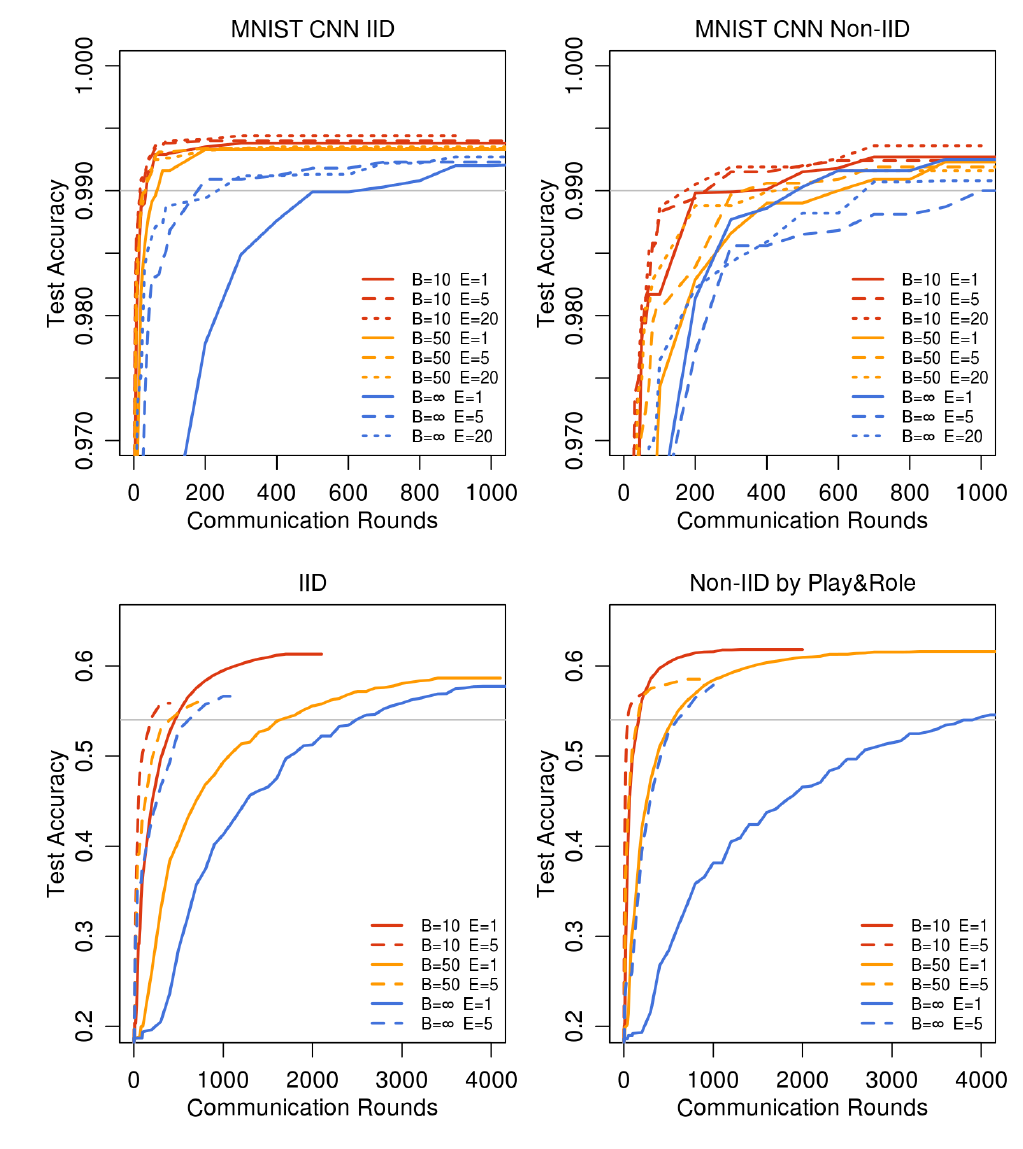
Dans cette figure, il faut regarder l'écart entre la ligne bleue continue et les courbes rouges. La ligne bleue continue correspond à , , c'est-à-dire FedSGD ; les courbes rouges correspondent à , avec le plus de mises à jour locales par tour. Dans les quatre graphiques, les courbes rouges franchissent la ligne grise de la cible bien avant la ligne bleue continue.
En tours de communication nécessaires pour atteindre la cible, FedAvg est plusieurs fois plus rapide dans les quatre configurations.
- MNIST CNN, IID : FedSGD met 626 tours pour atteindre 99 % ; avec , , il suffit de 18 tours, soit 34.8 fois plus vite.
- MNIST CNN, non IID pathologique : 483 tours pour FedSGD, 173 pour la meilleure configuration, soit 2.8 fois plus vite.
- Shakespeare, IID : FedSGD met 2 488 tours pour atteindre 54 % ; , en demande 192, soit 13.0 fois plus vite.
- Shakespeare, découpage par rôle : 3 906 tours pour FedSGD, seulement 41 avec la même configuration, soit 95.3 fois plus vite.
Le deuxième cas mérite qu'on s'y arrête. Chaque client n'a que deux chiffres ; les modèles entraînés séparément diffèrent beaucoup, et leur moyenne reste pourtant plus rapide que FedSGD. Les auteurs reconnaissent eux-mêmes qu'il est déjà surprenant que la moyenne apporte le moindre bénéfice au lieu de diverger. L'accélération se limite toutefois à environ 2.8 fois, et le tableau contient même des configurations plus lentes que FedSGD, par exemple , , qui demande 1 000 tours sur les données non IID.
Le quatrième cas réserve la surprise inverse. Le découpage par rôle accélère davantage que la version IID. Les auteurs supposent que certains rôles ont beaucoup de répliques, ce qui rend quelques pas locaux supplémentaires particulièrement utiles ; c'est une hypothèse, que l'article ne vérifie pas davantage.
Au-delà du nombre de tours, FedAvg atteint aussi une précision finale plus élevée. Sur MNIST CNN, FedSGD atteint 99.22 % après 1 200 tours et ne progresse plus jusqu'à 6 000 tours ; FedAvg avec , atteint 99.44 % dès 300 tours. Les auteurs supposent que la moyenne de modèles a un effet régularisant proche de celui du dropout, là encore sans expérience de vérification.
Trop de calcul local
Plus est grand, plus chaque modèle local se rapproche de l'optimum de ses propres données. Pour un problème convexe, quand , le point de départ n'a plus d'importance, et des tours de moyenne supplémentaires n'apportent plus d'amélioration.
Les auteurs poussent aussi très haut sur Shakespeare LSTM (jusqu'à 200). Avec un trop grand, la perte d'entraînement stagne, voire diverge. MNIST CNN ne montre pas de dégradation nette ; sur la grande tâche de prédiction du mot suivant, fait aussi légèrement mieux que . Les auteurs suggèrent donc de réduire le calcul local par tour en fin d'entraînement, comme on fait décroître un taux d'apprentissage.
C'est le point de FedAvg le plus souvent remis en question. Chaque client part dans sa propre direction ; plus il va loin, plus la moyenne risque de s'écarter de l'objectif global.
CIFAR-10 et échelle réelle
Sur CIFAR-10, les 50 000 images d'entraînement sont réparties équitablement entre 100 clients, dans un cadre IID équilibré. Une autre référence est une SGD ordinaire sur les données non découpées, avec des lots de 100.
Pour atteindre 80 % de précision, SGD demande 18 000 mises à jour (dans un cadre fédéré, chacune compterait comme un tour de communication), FedSGD 3 750 tours et FedAvg seulement 280. Pour une cible de 85 %, SGD demande 99 000 mises à jour, FedAvg 2 000 tours, et FedSGD ne l'atteint pas dans la durée des expériences.
La dernière série porte sur la prédiction du mot suivant à échelle réelle. Dix millions de publications publiques d'un réseau social sont regroupées par auteur, ce qui donne plus de 500 000 clients ; 200 clients participent à chaque tour, et FedAvg utilise , . FedSGD met 820 tours pour atteindre 10.5 % de précision, FedAvg seulement 35, soit 23 fois moins ; la précision de FedAvg fluctue aussi moins d'une évaluation à l'autre.
Ce que l'article laisse en suspens
Toutes ces expériences sont des simulations. L'ensemble des clients est fixe, chaque tour est synchrone, sans déconnexion ni mise à jour malveillante : les auteurs excluent d'emblée ces questions pratiques. L'indicateur est le nombre de tours de communication ; ni le temps réel écoulé ni la consommation des téléphones ne sont mesurés directement.
La convergence ne repose, elle aussi, que sur des preuves expérimentales. L'accélération est nettement plus faible dans le cas non IID pathologique, et des travaux ultérieurs ont mieux décortiqué ce problème. Federated Learning with Non-IID Data, de Zhao et al., constate qu'avec un découpage extrême où chaque client ne possède qu'une classe, la précision peut perdre jusqu'à 55 %, et attribue la cause à la divergence entre poids locaux et poids globaux. SCAFFOLD nomme ce même phénomène client drift et corrige les mises à jour locales avec des variables de contrôle ; l'analyse de convergence de Li et al. montre, sous des hypothèses de forte convexité et de régularité, que le taux d'apprentissage doit décroître dans le cas non IID.
Côté vie privée, l'article avance deux principes, « les données ne quittent pas l'appareil » et « seule la mise à jour minimale nécessaire est transmise ». Il n'offre aucune garantie formelle de confidentialité différentielle ni d'agrégation sécurisée ; les auteurs rangent ces deux points dans les travaux futurs.
Conclusion
L'algorithme FedAvg tient en une demi-page. Les clients partent des mêmes poids, exécutent plusieurs passes de SGD en local, et le serveur fait la moyenne pondérée par la quantité de données. On y gagne un à deux ordres de grandeur sur le nombre de tours de communication, ainsi que des preuves expérimentales que l'entraînement fonctionne encore sur des données non IID.
Google l'a ensuite bel et bien utilisé pour la prédiction du mot suivant de Gboard.
Vu sous l'angle de la fusion de modèles, le plus intrigant reste cette petite expérience qui mélange deux jeux de poids. Deux modèles initialisés indépendamment se cassent dès qu'on les moyenne ; partis du même point, ils s'améliorent au contraire une fois moyennés. Pendant les années qui ont suivi, cette condition n'a jamais quitté les recherches sur la moyenne de poids.
Si vous voulez essayer vous-même, l'article conseille de régler d'abord : tant que le lot sature encore le parallélisme du téléphone, le réduire ne coûte presque pas de temps. Quant à , inutile d'être gourmand ; à trop tourner en local, chaque téléphone tire le modèle vers ses propres données.