Article original
The Role of Permutation Invariance in Linear Mode Connectivity of Neural Networks
- Publication
- ICLR 2022Conférence
- Premier dépôt sur arXiv
- arXiv:2110.06296
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingpermutationinvariance2021,
  title = {{The Role of Permutation Invariance in Linear Mode Connectivity of Neural Networks}},
  author = {Rahim Entezari and Hanie Sedghi and Olga Saukh and Behnam Neyshabur},
  year = {2021},
  eprint = {2110.06296},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2110.06296}
}
Vers 2018, les recherches sur le paysage de perte nous ont appris une chose étrange.
Entre deux réseaux entraînés depuis des initialisations aléatoires différentes, on peut trouver un chemin courbe de faible perte ; mais si on les relie directement par un segment, la perte grimpe quand même en flèche au milieu. Le détour passe, la ligne droite non.
Entezari, Sedghi, Saukh et Neyshabur, de TU Graz et de Google, envisagent une cause possible. Les unités cachées d'un réseau de neurones n'ont pas d'ordre fixe : échanger les neurones d'une même couche laisse la fonction calculée strictement identique, mais déplace le vecteur de paramètres vers un autre point. Si deux réseaux se heurtent à un mur sur le segment, c'est peut-être seulement parce que leurs neurones « ne sont pas à la bonne place ».
Ils formulent cette idée en conjecture, en reconnaissant franchement son audace.
Définir le problème
Mesurer la barrière
Soit la perte du réseau pour un jeu de paramètres (l'erreur d'entraînement, par exemple). La barrière d'interpolation linéaire entre deux jeux de paramètres et est définie par
Le premier terme est la perte du modèle interpolé, le second l'interpolation linéaire des pertes aux extrémités. Leur différence mesure « ce qui dépasse la ligne droite attendue ».
Cette définition diffère légèrement de celle de Frankle et al., qui prend pour référence la moyenne des pertes aux extrémités, . Quand les deux pertes sont égales, les deux définitions coïncident ; sinon, cette version ne compte pas comme barrière le simple passage linéaire de la perte d'une extrémité à l'autre.
Quand , on dit que les deux réseaux présentent une connectivité linéaire des modes (linear mode connectivity, LMC). Les auteurs constatent expérimentalement qu'une seule mesure en s'écarte de moins de du supremum sur tout le chemin ; les figures suivantes ne rapportent donc que la valeur au milieu.
De quoi dépend la barrière ?
Avant d'énoncer la conjecture, les auteurs dressent un état des lieux systématique. Les architectures comprennent un MLP à une couche, un Shallow CNN à deux couches de convolution, VGG et ResNet ; les jeux de données, MNIST, SVHN, CIFAR-10 et CIFAR-100. Pour chaque configuration, 10 modèles sont entraînés avec des graines différentes, et la barrière d'erreur d'entraînement est mesurée sur 5 paires tirées au hasard.
- Largeur : la barrière augmente d'abord avec la largeur, puis se met à baisser au-delà d'une certaine largeur, une forme qui rappelle beaucoup la double descente. En comparant avec l'erreur de test, les auteurs constatent que le pic de la barrière se situe à peu près à la largeur où le modèle parvient tout juste à s'ajuster aux données d'entraînement. Les jeux de données simples (MNIST, SVHN) amorcent la baisse plus tôt que CIFAR.
- Profondeur : avec une largeur fixée à par couche pour le MLP et le Shallow CNN, chaque couche ajoutée élève nettement la barrière. Celles de VGG et ResNet restent bloquées très haut, sans varier avec la largeur.
- Difficulté de la tâche : la barrière du MLP n'est que de 0.0174 sur MNIST, contre 0.7965 sur CIFAR-100 ; celle du Shallow CNN passe de 0.0161 à 0.4861. Pour les réseaux peu profonds, barrière et erreur de test sont fortement corrélées. ResNet18 et VGG16 se situent entre 0.84 et 0.99 sur les quatre jeux de données : leur erreur de test est faible, leur barrière très haute.
Cet état des lieux conclut que la largeur réduit la barrière et que la profondeur l'augmente. Ces phénomènes demandent une explication.
Résoudre le problème
Deux invariances
Si la fonction représentée par un réseau ne change pas sous une transformation, on dit que le réseau est invariant par cette transformation. Deux invariances sont courantes.
La première est l'homogénéité positive de ReLU. Multiplier les poids d'entrée d'un neurone par et diviser ses poids de sortie par laisse la fonction inchangée. Les auteurs jugent cette invariance peu importante, car le biais implicite de SGD tend à équilibrer la taille des poids entre les couches et fait converger vers une mise à l'échelle particulière.
La seconde est l'invariance par permutation. Réordonner les unités cachées de la couche transforme les paramètres en
où est une matrice de permutation ; les couches d'entrée et de sortie ne sont pas permutées. change l'ordre des sorties de cette couche, et compense la permutation de la couche précédente. Pour SGD, toutes les permutations sont également probables ; leur effet sur le paysage de perte mérite donc qu'on s'y intéresse sérieusement.
Vérifions-le sur un réseau à une couche cachée. La couche cachée compte unités ; on réordonne avec la même permutation les lignes de la première matrice de poids, les biais, et les colonnes de la seconde matrice de poids :
def permute(params, p):
    W1, b1, W2, b2 = params        # W1: [h, d], b1: [h], W2: [10, h], b2: [10]
    return [W1[p], b1[p], W2[:, p], b2]
Dans la petite expérience présentée plus loin dans cette note, une permutation aléatoire est appliquée une fois à des réseaux de largeur 16, 64 et 256 ; torch.allclose, qui compare les sorties avant et après permutation sur tout le jeu de données, renvoie True les trois fois. La fonction est strictement la même, mais dans l'espace des paramètres, ce sont deux points très éloignés.
Une couche de largeur admet à elle seule ordres possibles. Une même fonction possède un nombre astronomique de doubles dans l'espace des paramètres.
La conjecture
En langage courant, la conjecture des auteurs se formule ainsi :
La plupart des solutions de SGD appartiennent à un ensemble ; moyennant une permutation appropriée des éléments de , l'interpolation linéaire entre deux éléments quelconques ne présente aucune barrière.
La version formelle ajoute une condition de largeur. Il existe une largeur telle que, pour tout réseau suffisamment large, il existe un ensemble de solutions et une fonction attribuant une permutation, de sorte que la barrière entre deux solutions quelconques de , après permutation, soit approximativement nulle, et que les solutions de SGD tombent dans avec une forte probabilité.
Si la conjecture est vraie, les nombreux bassins qui semblent séparés dans le paysage de perte ne sont que des copies d'un même bassin, produites par permutation.
Théorie : seul le cas le plus simple est démontré
Les auteurs démontrent une version très restreinte. Pour un réseau entièrement connecté ReLU à une couche cachée, , à l'initialisation aléatoire, avec des poids tirés d'une distribution uniforme spécifiée, il existe avec forte probabilité une permutation telle que l'écart entre la sortie du réseau interpolé et l'interpolation des sorties aux extrémités ne soit que de
est le nombre d'unités cachées et la dimension d'entrée. Pour une largeur suffisante, l'écart tend vers zéro.
Ce théorème ne porte que sur l'initialisation, pas sur les réseaux entraînés. Le de l'exposant montre aussi que la largeur nécessaire croît très vite avec la dimension d'entrée. Les auteurs indiquent qu'une démonstration plus élaborée pourrait peut-être s'étendre au régime NTK, mais laissent cela à des travaux futurs.
Expériences : un espace de permutations trop grand, une vérification indirecte
Une vérification directe exige de chercher des permutations, mais leur nombre croît comme la factorielle de la largeur. Les auteurs ont tenté une recherche exhaustive : pour un MLP à une couche cachée, ils n'ont pas pu dépasser 16 neurones, soit déjà permutations.
Même avec un algorithme de recherche plus astucieux, un échec ne permet pas de distinguer un algorithme trop faible d'une permutation qui n'existe tout simplement pas.
Les auteurs changent d'angle. Étant donnée une solution SGD , ils rassemblent toutes ses permutations en un ensemble
satisfait forcément la conjecture : chacun de ses éléments est un double de , et inverser la permutation ramène la barrière à zéro. L'article appelle « notre modèle », et l'ensemble réel des solutions SGD , « le monde réel ».
Il reste alors à vérifier que et se comportent de la même façon. Si la barrière entre une solution entraînée indépendamment et est à peu près celle entre et « une permutation aléatoire de », pour toutes sortes de largeurs, profondeurs et jeux de données, alors « n'est en fait qu'une permutation de , plus une petite perturbation » devient une explication raisonnable.
Essayer soi-même
Cet argument se reproduit à très petite échelle.
La figure ci-dessous provient d'une petite expérience réalisée pour cette note ; ce ne sont pas des résultats de l'article. Les données sont les chiffres manuscrits 8×8 intégrés à sklearn (1 797 images), le modèle un MLP ReLU à une couche cachée. Deux modèles, A et B, sont entraînés avec des graines différentes, tous deux jusqu'à une perte d'entraînement d'environ 0.001. On compare ensuite trois interpolations linéaires : de A à B, de A à « A permuté au hasard », et de A à « B aligné ».
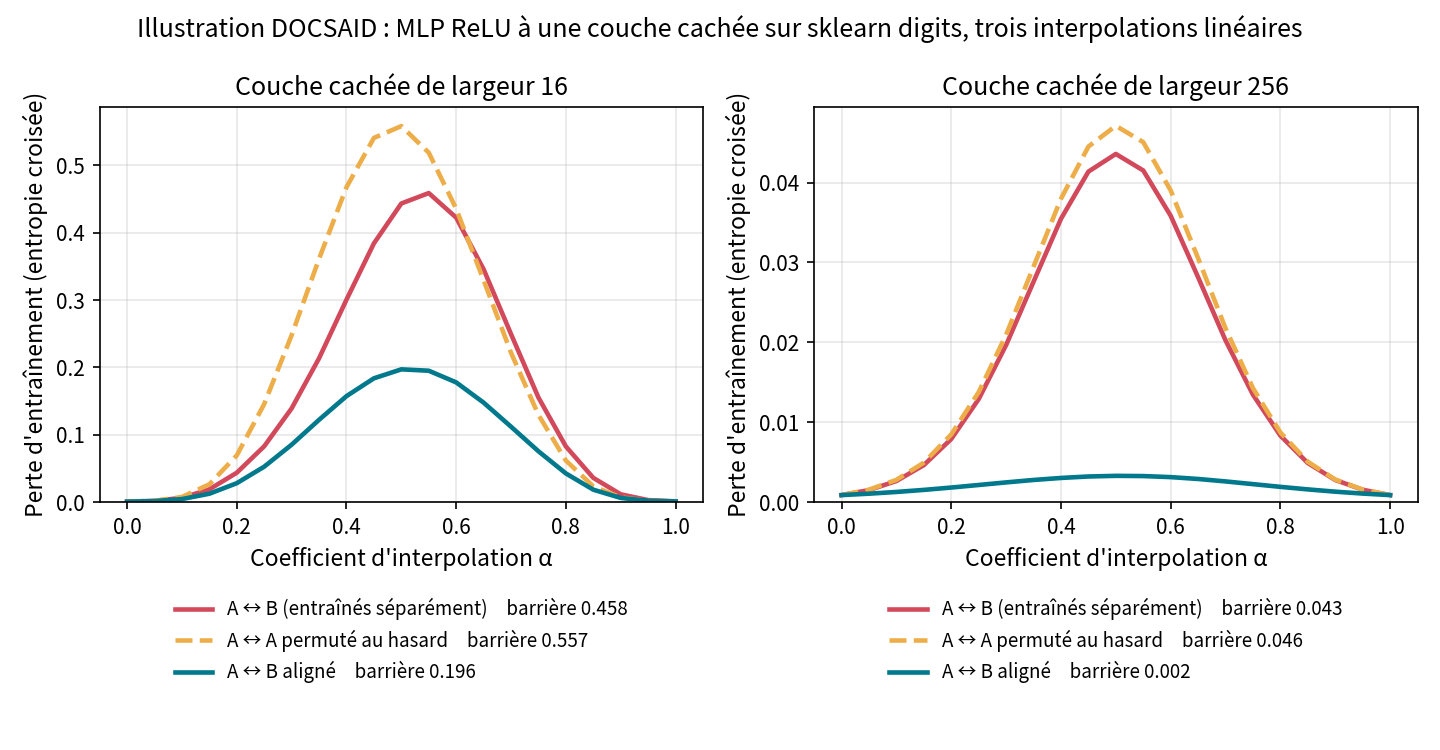
Regardons d'abord les lignes rouge et orange. A et B sont entraînés séparément ; A et A permuté sont une seule et même fonction ; pourtant, les deux pics ont à peu près la même hauteur. L'observation centrale de l'article est là. La barrière due à un entraînement indépendant et celle que crée un simple « changement de places » ont des hauteurs proches.
La ligne bleu-vert est un ajout. Les unités cachées de B sont appariées une à une à celles de A selon la corrélation de leurs activations, par l'algorithme hongrois, avant l'interpolation. À la largeur 16, la barrière passe de 0.458 à 0.196 ; à la largeur 256, de 0.043 à 0.002. Cette méthode d'alignement vient de travaux ultérieurs ; ce n'est pas la recherche employée dans cet article. Elle figure ici pour vous montrer jusqu'où « remettre chacun à sa place » peut réellement aller.
Par ailleurs, à la largeur 64, les trois barrières valent 0.094, 0.070 et 0.006. Plus la largeur augmente, plus la barrière baisse, et plus elle se rapproche de zéro après alignement, conformément à la tendance relevée par l'état des lieux de l'article.
Les preuves de l'article
Revenons à l'article. Les auteurs comparent et sur des MLP et des Shallow CNN ; pour toutes sortes de largeurs, profondeurs et jeux de données, les courbes de barrière des deux se superposent presque.
Ils ajoutent ensuite une recherche. Les permutations sont cherchées par recuit simulé (simulated annealing), un algorithme d'approximation courant pour le problème du voyageur de commerce, en deux versions :
- SA1 : minimiser directement la barrière moyenne entre les cinq solutions prises deux à deux.
- SA2 : moyenner d'abord les solutions permutées en un seul modèle, puis minimiser l'erreur d'entraînement de ce modèle moyen.
Les deux donnent des résultats proches, SA2 étant bien moins coûteux ; seul SA2 est utilisé par la suite. Mais quand il faut aligner cinq solutions à la fois, il ne réduit presque pas la barrière.
Les auteurs réduisent donc l'espace de recherche : deux solutions seulement, avec fixé et seul permuté. Les barrières des MLP et Shallow CNN sur MNIST et SVHN baissent alors nettement, et celle du MLP à une couche sur MNIST tombe même à zéro pour toutes les largeurs. Surtout, avant comme après la recherche, les barrières de et de restent presque identiques. Là où la recherche réussit sur , elle réussit aussi sur ; là où elle échoue sur , elle échoue aussi sur .
Au total, les expériences entraînent plus de trois mille réseaux ; les auteurs les représentent dans une carte de densité, où les barrières du « monde réel » et de « notre modèle » se répartissent à peu près le long de la diagonale.
Discussion
La manière d'argumenter de cet article est intéressante. Il ne démontre pas la conjecture ; il conçoit des expériences où « si la conjecture était fausse, on devrait voir une différence », et n'en voit aucune. Les auteurs choisissent leurs mots avec prudence : ces tentatives « n'ont pas réussi à réfuter » la conjecture.
Mais il faut distinguer la force des différentes preuves.
Les plus convaincantes concernent les réseaux peu profonds. Sur les MLP et les Shallow CNN, et se ressemblent avant comme après la recherche, et la recherche parvient effectivement à ramener la barrière à zéro sur les jeux de données simples.
Les preuves sont plus faibles pour les réseaux profonds. Les barrières de VGG et ResNet sont hautes sur comme sur , et le recuit simulé ne trouve, d'un côté comme de l'autre, aucune permutation qui les réduise. « Échouer des deux côtés » est compatible avec la conjecture, mais ne permet pas non plus de distinguer un algorithme de recherche trop faible de l'existence d'autres barrières propres aux réseaux profonds. Les auteurs reconnaissent aussi que la taille de l'espace de recherche est la principale limite de l'article, et que toutes les expériences portent sur la reconnaissance d'images.
L'argument par repose en outre sur une prémisse implicite. Que et se ressemblent pour la « barrière d'interpolation directe » et la « barrière après recherche » ne garantit pas qu'ils se ressemblent pour la « barrière sous la permutation optimale » ; or c'est cette dernière que vise réellement la conjecture.
Des travaux ultérieurs ont comblé la lacune des réseaux profonds. Git Re-Basin passe à l'appariement des poids et, sur des ResNet élargis de nombreuses fois, obtient pour la première fois une barrière nulle entre deux modèles entraînés indépendamment sur CIFAR-10 ; il construit aussi un contre-exemple de solutions non obtenues par SGD, qui montre que la restriction aux « solutions de SGD » ne peut pas être retirée de la conjecture. REPAIR, que nous verrons dans la note suivante, identifie une autre cause des barrières qui subsistent après alignement dans les réseaux profonds ; le problème tient à la variance des activations après interpolation.
Conclusion
Cet article avance une idée simple : de nombreux bassins apparemment distincts du paysage de perte pourraient n'être que des copies permutées d'un même bassin.
Sa théorie ne couvre que le cas d'une couche cachée à l'initialisation aléatoire ; ses expériences recourent à un substitut astucieux, « utiliser les permutations d'une solution pour simuler des solutions entraînées indépendamment », et apportent un soutien assez cohérent sur les réseaux peu profonds.
Pour le constater de vos propres mains, pas besoin d'un grand modèle. Entraînez deux petits MLP, mélangez au hasard les unités cachées de l'un, puis interpolez-le avec sa version d'origine : vous verrez une montagne à peu près aussi haute que celle qui sépare les deux modèles indépendants.