Article original
The Llama 3 Herd of Models
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2407.21783
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformersllama32024,
  title = {{The Llama 3 Herd of Models}},
  author = {Aaron Grattafiori and Abhimanyu Dubey and Abhinav Jauhri and Abhinav Pandey and Abhishek Kadian and Ahmad Al-Dahle and Aiesha Letman and Akhil Mathur and Alan Schelten and Alex Vaughan and Amy Yang and Angela Fan and Anirudh Goyal and Anthony Hartshorn and Aobo Yang and Archi Mitra and Archie Sravankumar and Artem Korenev and Arthur Hinsvark and Arun Rao and Aston Zhang and Aurelien Rodriguez and Austen Gregerson and Ava Spataru and Baptiste Roziere and Bethany Biron and Binh Tang and Bobbie Chern and Charlotte Caucheteux and Chaya Nayak and Chloe Bi and Chris Marra and Chris McConnell and Christian Keller and Christophe Touret and Chunyang Wu and Corinne Wong and Cristian Canton Ferrer and Cyrus Nikolaidis and Damien Allonsius and Daniel Song and Danielle Pintz and Danny Livshits and Danny Wyatt and David Esiobu and Dhruv Choudhary and Dhruv Mahajan and Diego Garcia-Olano and Diego Perino and Dieuwke Hupkes and Egor Lakomkin and Ehab AlBadawy and Elina Lobanova and Emily Dinan and Eric Michael Smith and Filip Radenovic and Francisco Guzmán and Frank Zhang and Gabriel Synnaeve and Gabrielle Lee and Georgia Lewis Anderson and Govind Thattai and Graeme Nail and Gregoire Mialon and Guan Pang and Guillem Cucurell and Hailey Nguyen and Hannah Korevaar and Hu Xu and Hugo Touvron and Iliyan Zarov and Imanol Arrieta Ibarra and Isabel Kloumann and Ishan Misra and Ivan Evtimov and Jack Zhang and Jade Copet and Jaewon Lee and Jan Geffert and Jana Vranes and Jason Park and Jay Mahadeokar and Jeet Shah and Jelmer van der Linde and Jennifer Billock and Jenny Hong and Jenya Lee and Jeremy Fu and Jianfeng Chi and Jianyu Huang and Jiawen Liu and Jie Wang and Jiecao Yu and Joanna Bitton and Joe Spisak and Jongsoo Park and Joseph Rocca and Joshua Johnstun and Joshua Saxe and Junteng Jia and Kalyan Vasuden Alwala and Karthik Prasad and Kartikeya Upasani and Kate Plawiak and Ke Li and Kenneth Heafield and Kevin Stone and Khalid El-Arini and Krithika Iyer and Kshitiz Malik and Kuenley Chiu and Kunal Bhalla and Kushal Lakhotia and Lauren Rantala-Yeary and Laurens van der Maaten and Lawrence Chen and Liang Tan and Liz Jenkins and Louis Martin and Lovish Madaan and Lubo Malo and Lukas Blecher and Lukas Landzaat and Luke de Oliveira and Madeline Muzzi and Mahesh Pasupuleti and Mannat Singh and Manohar Paluri and Marcin Kardas and Maria Tsimpoukelli and Mathew Oldham and Mathieu Rita and Maya Pavlova and Melanie Kambadur and Mike Lewis and Min Si and Mitesh Kumar Singh and Mona Hassan and Naman Goyal and Narjes Torabi and Nikolay Bashlykov and Nikolay Bogoychev and Niladri Chatterji and Ning Zhang and Olivier Duchenne and Onur Çelebi and Patrick Alrassy and Pengchuan Zhang and Pengwei Li and Petar Vasic and Peter Weng and Prajjwal Bhargava and Pratik Dubal and Praveen Krishnan and Punit Singh Koura and Puxin Xu and Qing He and Qingxiao Dong and Ragavan Srinivasan and Raj Ganapathy and Ramon Calderer and Ricardo Silveira Cabral and Robert Stojnic and Roberta Raileanu and Rohan Maheswari and Rohit Girdhar and Rohit Patel and Romain Sauvestre and Ronnie Polidoro and Roshan Sumbaly and Ross Taylor and Ruan Silva and Rui Hou and Rui Wang and Saghar Hosseini and Sahana Chennabasappa and Sanjay Singh and Sean Bell and Seohyun Sonia Kim and Sergey Edunov and Shaoliang Nie and Sharan Narang and Sharath Raparthy and Sheng Shen and Shengye Wan and Shruti Bhosale and Shun Zhang and Simon Vandenhende and Soumya Batra and Spencer Whitman and Sten Sootla and Stephane Collot and Suchin Gururangan and Sydney Borodinsky and Tamar Herman and Tara Fowler and Tarek Sheasha and Thomas Georgiou and Thomas Scialom and Tobias Speckbacher and Todor Mihaylov and Tong Xiao and Ujjwal Karn and Vedanuj Goswami and Vibhor Gupta and Vignesh Ramanathan and Viktor Kerkez and Vincent Gonguet and Virginie Do and Vish Vogeti and Vítor Albiero and Vladan Petrovic and Weiwei Chu and Wenhan Xiong and Wenyin Fu and Whitney Meers and Xavier Martinet and Xiaodong Wang and Xiaofang Wang and Xiaoqing Ellen Tan and Xide Xia and Xinfeng Xie and Xuchao Jia and Xuewei Wang and Yaelle Goldschlag and Yashesh Gaur and Yasmine Babaei and Yi Wen and Yiwen Song and Yuchen Zhang and Yue Li and Yuning Mao and Zacharie Delpierre Coudert and Zheng Yan and Zhengxing Chen and Zoe Papakipos and Aaditya Singh and Aayushi Srivastava and Abha Jain and Adam Kelsey and Adam Shajnfeld and Adithya Gangidi and Adolfo Victoria and Ahuva Goldstand and Ajay Menon and Ajay Sharma and Alex Boesenberg and Alexei Baevski and Allie Feinstein and Amanda Kallet and Amit Sangani and Amos Teo and Anam Yunus and Andrei Lupu and Andres Alvarado and Andrew Caples and Andrew Gu and Andrew Ho and Andrew Poulton and Andrew Ryan and Ankit Ramchandani and Annie Dong and Annie Franco and Anuj Goyal and Aparajita Saraf and Arkabandhu Chowdhury and Ashley Gabriel and Ashwin Bharambe and Assaf Eisenman and Azadeh Yazdan and Beau James and Ben Maurer and Benjamin Leonhardi and Bernie Huang and Beth Loyd and Beto De Paola and Bhargavi Paranjape and Bing Liu and Bo Wu and Boyu Ni and Braden Hancock and Bram Wasti and Brandon Spence and Brani Stojkovic and Brian Gamido and Britt Montalvo and Carl Parker and Carly Burton and Catalina Mejia and Ce Liu and Changhan Wang and Changkyu Kim and Chao Zhou and Chester Hu and Ching-Hsiang Chu and Chris Cai and Chris Tindal and Christoph Feichtenhofer and Cynthia Gao and Damon Civin and Dana Beaty and Daniel Kreymer and Daniel Li and David Adkins and David Xu and Davide Testuggine and Delia David and Devi Parikh and Diana Liskovich and Didem Foss and Dingkang Wang and Duc Le and Dustin Holland and Edward Dowling and Eissa Jamil and Elaine Montgomery and Eleonora Presani and Emily Hahn and Emily Wood and Eric-Tuan Le and Erik Brinkman and Esteban Arcaute and Evan Dunbar and Evan Smothers and Fei Sun and Felix Kreuk and Feng Tian and Filippos Kokkinos and Firat Ozgenel and Francesco Caggioni and Frank Kanayet and Frank Seide and Gabriela Medina Florez and Gabriella Schwarz and Gada Badeer and Georgia Swee and Gil Halpern and Grant Herman and Grigory Sizov and Guangyi and Zhang and Guna Lakshminarayanan and Hakan Inan and Hamid Shojanazeri and Han Zou and Hannah Wang and Hanwen Zha and Haroun Habeeb and Harrison Rudolph and Helen Suk and Henry Aspegren and Hunter Goldman and Hongyuan Zhan and Ibrahim Damlaj and Igor Molybog and Igor Tufanov and Ilias Leontiadis and Irina-Elena Veliche and Itai Gat and Jake Weissman and James Geboski and James Kohli and Janice Lam and Japhet Asher and Jean-Baptiste Gaya and Jeff Marcus and Jeff Tang and Jennifer Chan and Jenny Zhen and Jeremy Reizenstein and Jeremy Teboul and Jessica Zhong and Jian Jin and Jingyi Yang and Joe Cummings and Jon Carvill and Jon Shepard and Jonathan McPhie and Jonathan Torres and Josh Ginsburg and Junjie Wang and Kai Wu and Kam Hou U and Karan Saxena and Kartikay Khandelwal and Katayoun Zand and Kathy Matosich and Kaushik Veeraraghavan and Kelly Michelena and Keqian Li and Kiran Jagadeesh and Kun Huang and Kunal Chawla and Kyle Huang and Lailin Chen and Lakshya Garg and Lavender A and Leandro Silva and Lee Bell and Lei Zhang and Liangpeng Guo and Licheng Yu and Liron Moshkovich and Luca Wehrstedt and Madian Khabsa and Manav Avalani and Manish Bhatt and Martynas Mankus and Matan Hasson and Matthew Lennie and Matthias Reso and Maxim Groshev and Maxim Naumov and Maya Lathi and Meghan Keneally and Miao Liu and Michael L. Seltzer and Michal Valko and Michelle Restrepo and Mihir Patel and Mik Vyatskov and Mikayel Samvelyan and Mike Clark and Mike Macey and Mike Wang and Miquel Jubert Hermoso and Mo Metanat and Mohammad Rastegari and Munish Bansal and Nandhini Santhanam and Natascha Parks and Natasha White and Navyata Bawa and Nayan Singhal and Nick Egebo and Nicolas Usunier and Nikhil Mehta and Nikolay Pavlovich Laptev and Ning Dong and Norman Cheng and Oleg Chernoguz and Olivia Hart and Omkar Salpekar and Ozlem Kalinli and Parkin Kent and Parth Parekh and Paul Saab and Pavan Balaji and Pedro Rittner and Philip Bontrager and Pierre Roux and Piotr Dollar and Polina Zvyagina and Prashant Ratanchandani and Pritish Yuvraj and Qian Liang and Rachad Alao and Rachel Rodriguez and Rafi Ayub and Raghotham Murthy and Raghu Nayani and Rahul Mitra and Rangaprabhu Parthasarathy and Raymond Li and Rebekkah Hogan and Robin Battey and Rocky Wang and Russ Howes and Ruty Rinott and Sachin Mehta and Sachin Siby and Sai Jayesh Bondu and Samyak Datta and Sara Chugh and Sara Hunt and Sargun Dhillon and Sasha Sidorov and Satadru Pan and Saurabh Mahajan and Saurabh Verma and Seiji Yamamoto and Sharadh Ramaswamy and Shaun Lindsay and Shaun Lindsay and Sheng Feng and Shenghao Lin and Shengxin Cindy Zha and Shishir Patil and Shiva Shankar and Shuqiang Zhang and Shuqiang Zhang and Sinong Wang and Sneha Agarwal and Soji Sajuyigbe and Soumith Chintala and Stephanie Max and Stephen Chen and Steve Kehoe and Steve Satterfield and Sudarshan Govindaprasad and Sumit Gupta and Summer Deng and Sungmin Cho and Sunny Virk and Suraj Subramanian and Sy Choudhury and Sydney Goldman and Tal Remez and Tamar Glaser and Tamara Best and Thilo Koehler and Thomas Robinson and Tianhe Li and Tianjun Zhang and Tim Matthews and Timothy Chou and Tzook Shaked and Varun Vontimitta and Victoria Ajayi and Victoria Montanez and Vijai Mohan and Vinay Satish Kumar and Vishal Mangla and Vlad Ionescu and Vlad Poenaru and Vlad Tiberiu Mihailescu and Vladimir Ivanov and Wei Li and Wenchen Wang and Wenwen Jiang and Wes Bouaziz and Will Constable and Xiaocheng Tang and Xiaojian Wu and Xiaolan Wang and Xilun Wu and Xinbo Gao and Yaniv Kleinman and Yanjun Chen and Ye Hu and Ye Jia and Ye Qi and Yenda Li and Yilin Zhang and Ying Zhang and Yossi Adi and Youngjin Nam and Yu and Wang and Yu Zhao and Yuchen Hao and Yundi Qian and Yunlu Li and Yuzi He and Zach Rait and Zachary DeVito and Zef Rosnbrick and Zhaoduo Wen and Zhenyu Yang and Zhiwei Zhao and Zhiyu Ma},
  year = {2024},
  eprint = {2407.21783},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2407.21783}
}
En juillet 2024, Meta publie les poids de la série Llama 3.1 ; le plus grand modèle compte 405 milliards de paramètres.
Jusque-là, les modèles capables de se mesurer directement à GPT-4 n'étaient accessibles que par API. Pour la première fois, les poids d'un modèle à égalité avec GPT-4 sur la plupart des benchmarks sont directement téléchargeables.
Les poids s'accompagnent d'un rapport technique de plus de quatre-vingt-dix pages. Intitulé « le troupeau de modèles Llama 3 » (Herd of Models), il couvre trois tailles, 8B, 70B et 405B, et traite du nettoyage des données, des lois d'échelle, de l'infrastructure d'entraînement, du post-entraînement et de l'inférence, avant de finir par des expériences d'extension à l'image, à la vidéo et à la parole.
Un rapport aussi long se lit facilement comme une liste. Cette note prend un autre chemin et suit un principe que le rapport met lui-même en avant : garder un processus de développement simple. Au nom de ce principe, Meta a renoncé à des choix plus en vogue et, à quelques endroits clés, a employé une technique très modeste, la moyenne de plusieurs modèles.
Définir le problème
Selon les auteurs, développer un modèle de fondation de haute qualité repose sur trois leviers : les données, l'échelle et la gestion de la complexité.
Les deux premiers sont intuitifs. Côté données, Llama 3 est préentraîné sur environ 15T tokens multilingues, contre 1.8T pour Llama 2. Côté échelle, le modèle phare de 405B consomme FLOPs, environ 50 fois la plus grande version de Llama 2.
Le troisième levier mérite qu'on s'y arrête. Pour l'architecture, les auteurs choisissent un Transformer dense standard plutôt qu'un mélange d'experts (MoE) ; pour le post-entraînement, une combinaison d'ajustement supervisé (SFT), d'échantillonnage par rejet (rejection sampling) et de DPO, plutôt qu'un apprentissage par renforcement de type PPO. Dans les deux cas, la raison est la même, un entraînement stable et facile à passer à l'échelle.
Vérifions d'abord l'échelle. Le calcul nécessaire pour entraîner un Transformer dense s'estime souvent par , où est le nombre de paramètres et le nombre de tokens d'entraînement :
Cela concorde avec les du rapport. Si l'entraînement utilisait 16 384 H100 de bout en bout, chacune atteignant réellement 400 TFLOPs, le temps de calcul pur serait d'environ secondes, soit 67 jours environ. Ce n'est qu'une estimation grossière : en réalité, le début de l'entraînement utilise moins de GPU, sans compter les interruptions de toutes sortes.
Quand il faut faire tourner plus de dix mille GPU de façon continue et stable pendant plus de deux mois, chaque choix qui ajoute « un peu de complexité » peut se transformer en interruption de l'entraînement. C'est le contexte de tout le rapport.
Résoudre le problème
Données : le nettoyage demande plus d'efforts que la quantité
Les connaissances contenues dans les données de préentraînement s'arrêtent à fin 2023 ; ces données proviennent pour l'essentiel du web. Le nettoyage comprend les étapes suivantes :
- Un analyseur HTML maison. Les contenus mathématiques et de code gardent leur structure ; comme les mathématiques apparaissent souvent sous forme d'images, avec la formule dans l'attribut alt, le texte alt est conservé aussi. Les auteurs constatent par ailleurs que, pour un modèle nourri surtout de données web, les balises Markdown sont nuisibles ; elles sont donc toutes retirées.
- Une déduplication à trois niveaux. Au niveau des URL, on garde la version la plus récente ; au niveau des documents, MinHash élimine les quasi-doublons ; au niveau des lignes, l'opération est très agressive : toute ligne qui apparaît plus de 6 fois dans chaque tranche de 30 millions de documents est supprimée. Les auteurs reconnaissent que cela retire aussi des textes courants de haute qualité, mais l'effet sur les évaluations est nettement positif.
- Un filtrage de qualité par des modèles. fastText juge si un texte « serait cité par Wikipédia », puis un DistilRoberta entraîné sur des données annotées par Llama 2 attribue un score de qualité ; le code et les mathématiques ont leurs propres classifieurs et pipelines d'extraction. Les données multilingues sont d'abord réparties en 176 langues par identification de la langue, puis dédupliquées et filtrées séparément.
Le mélange final comprend environ 50 % de connaissances générales, 25 % de mathématiques et de raisonnement, 17 % de code et 8 % de données multilingues.
Ces proportions sont fixées par des expériences de lois d'échelle : on essaie différents mélanges sur de petits modèles, puis on prédit les performances du grand modèle. Pour estimer la valeur de petits jeux de données spécialisés, les auteurs emploient une méthode moins coûteuse. Ils prennent un modèle 8B entraîné à mi-parcours, font descendre linéairement le taux d'apprentissage à 0 sur 40B tokens, avec 30 % du nouveau jeu dans les données de recuit, et observent l'évolution des scores. C'est bien plus économique que de lancer une expérience de lois d'échelle pour chaque petit jeu de données.
Échelle : une loi d'échelle qui prédit les notes d'examen
Une loi d'échelle ordinaire prédit la perte sur le token suivant, alors que ce qui intéresse vraiment, ce sont les scores aux benchmarks. Les auteurs procèdent en deux étapes :
- Ajuster d'abord la relation entre le « calcul » et la « log-vraisemblance négative (NLL) de la bonne réponse sur les tâches en aval », à l'aide de petits modèles de 40M à 16B paramètres, pour des budgets de calcul de à FLOPs.
- Ajuster ensuite la relation sigmoïde entre la « NLL » et la « précision ». Cette étape ajoute la série Llama 2, dont le calcul dépasse largement celui des petits modèles.
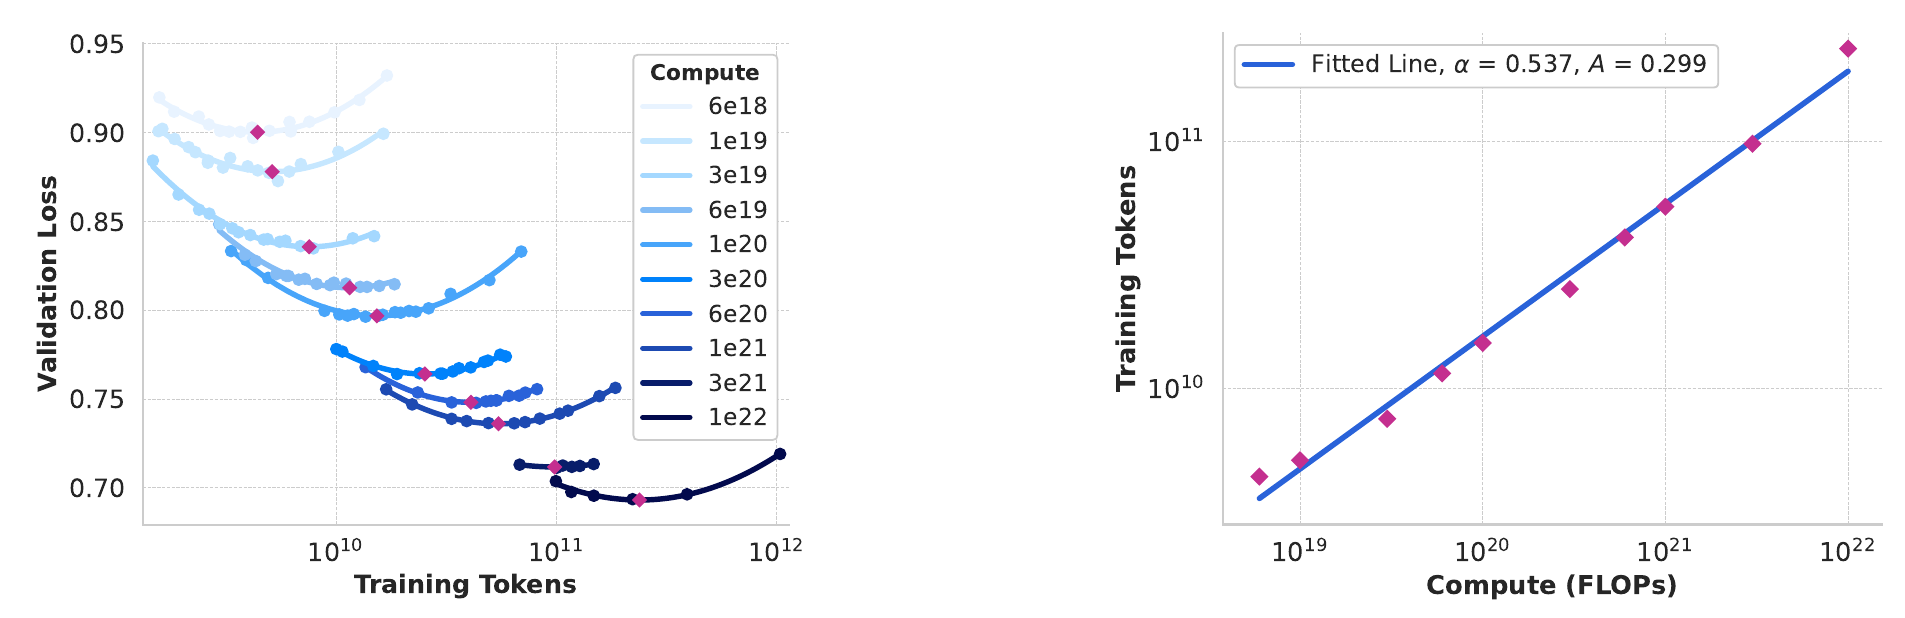
À gauche, chaque courbe correspond à un budget de calcul fixe. À budget égal, un modèle un peu plus petit voit davantage de tokens, un modèle plus grand en voit moins ; le minimum de la courbe donne la meilleure répartition pour ce budget. À droite, ces minimums sont reliés entre eux. Le nombre optimal de tokens d'entraînement suit une loi de puissance du calcul :
En extrapolant à FLOPs, le rapport obtient la recommandation « 402B paramètres, 16.55T tokens ». Un petit détail mérite qu'on refasse le calcul soi-même. Avec les valeurs du graphique, et , on obtient environ 16.3T tokens, proche du chiffre du rapport ; mais le texte donne les paramètres tronqués à deux décimales, , qui conduisent à environ 10.5T. L'exposant ne diffère que de 0.007, et après une extrapolation sur quatre ordres de grandeur l'écart atteint 50 %. Voilà à quel point l'extrapolation des lois d'échelle est sensible.
Les auteurs observent aussi que plus le budget de calcul est grand, plus le fond des courbes IsoFLOPs est plat : s'écarter un peu de la taille optimale a peu d'effet, d'où le choix final de 405B. La prédiction en aval fonctionne bien elle aussi : sur ARC Challenge, la méthode en deux étapes extrapole sur quatre ordres de grandeur et ne sous-estime que légèrement le score final.
Architecture : presque inchangée
L'architecture de Llama 3 ressemble beaucoup à celle de Llama 2 ; les auteurs disent clairement que les progrès viennent surtout des données et de l'échelle. Il n'y a que quatre modifications :
- Attention à requêtes groupées (GQA) : 8 têtes key-value, pour réduire le cache KV à l'inférence.
- Masque de documents : lorsqu'une séquence concatène plusieurs documents, l'attention d'un document à l'autre est interdite. L'effet est faible en préentraînement ordinaire, mais important quand on poursuit le préentraînement sur de très longues séquences.
- Vocabulaire de 128K : les 100K tokens de tiktoken plus 28K tokens non anglais. La compression de l'anglais passe de 3.17 à 3.94 caractères par token ; à calcul égal, le modèle « lit » davantage de texte.
- Fréquence de base de RoPE portée à 500 000 : pour prendre en charge des contextes plus longs.
Le 405B compte 126 couches, une dimension cachée de 16 384 et 128 têtes d'attention.
Infrastructure : le quotidien de seize mille GPU
Le 405B a utilisé jusqu'à 16K H100 en même temps. Le modèle est découpé par un parallélisme 4D : parallélisme de tenseur, de pipeline, de contexte et de données (FSDP). Sur 8K GPU avec des séquences de 8K, le taux d'utilisation des FLOPs du modèle (MFU) en BF16 est d'environ 43 % ; à 16K GPU, il est de 41 % ; pendant la phase de long contexte, avec des séquences de 131K, de 38 %.
Le passage le plus concret du rapport est une statistique des pannes. Sur une période d'observation de 54 jours, l'entraînement a été interrompu 466 fois au total : 47 interruptions planifiées pour maintenance et 419 imprévues. Environ 78 % des interruptions imprévues sont attribuées à des problèmes matériels confirmés ou suspectés, le plus souvent les GPU eux-mêmes et la mémoire HBM3. Malgré cela, le temps d'entraînement effectif dépasse 90 %.
Cela explique pourquoi les auteurs tiennent tant à la stabilité. En entraînement synchrone, la défaillance d'un seul GPU peut obliger à relancer tout le job.
Recette de préentraînement : trois phases
- Préentraînement initial : AdamW, taux d'apprentissage maximal de , 8 000 étapes d'échauffement, puis décroissance cosinus jusqu'à . Pour la stabilité, les lots sont d'abord petits, 4M tokens avec des séquences de 4 096 ; à 252M tokens, ils doublent à 8M tokens avec des séquences de 8 192 ; à 2.87T tokens, ils doublent encore à 16M. Selon les auteurs, cette recette est très stable, avec presque aucun pic de perte. Le mélange de données a aussi été ajusté en cours de route, par exemple en augmentant les données non anglaises, en suréchantillonnant les mathématiques et en ajoutant des pages web plus récentes.
- Préentraînement en long contexte : le contexte passe progressivement de 8K à 128K en six étapes, pour environ 800B tokens au total. À chaque étape, il faut vérifier que les performances en contexte court sont entièrement rétablies et que le test de « l'aiguille dans une botte de foin » est réussi sans faute à cette longueur avant de passer à l'étape suivante.
- Recuit : sur les 40 derniers millions de tokens, le taux d'apprentissage descend linéairement à 0, les données de haute qualité sont suréchantillonnées et la moyenne des checkpoints pris pendant le recuit sert de modèle préentraîné final.
Ce troisième point est la première « moyenne » qui intéresse cette note. Le rapport n'y consacre qu'une phrase, en citant la moyenne de Polyak, sans préciser combien de checkpoints ont été moyennés ni quel gain cela apporte.
Post-entraînement : six tours de SFT et de DPO
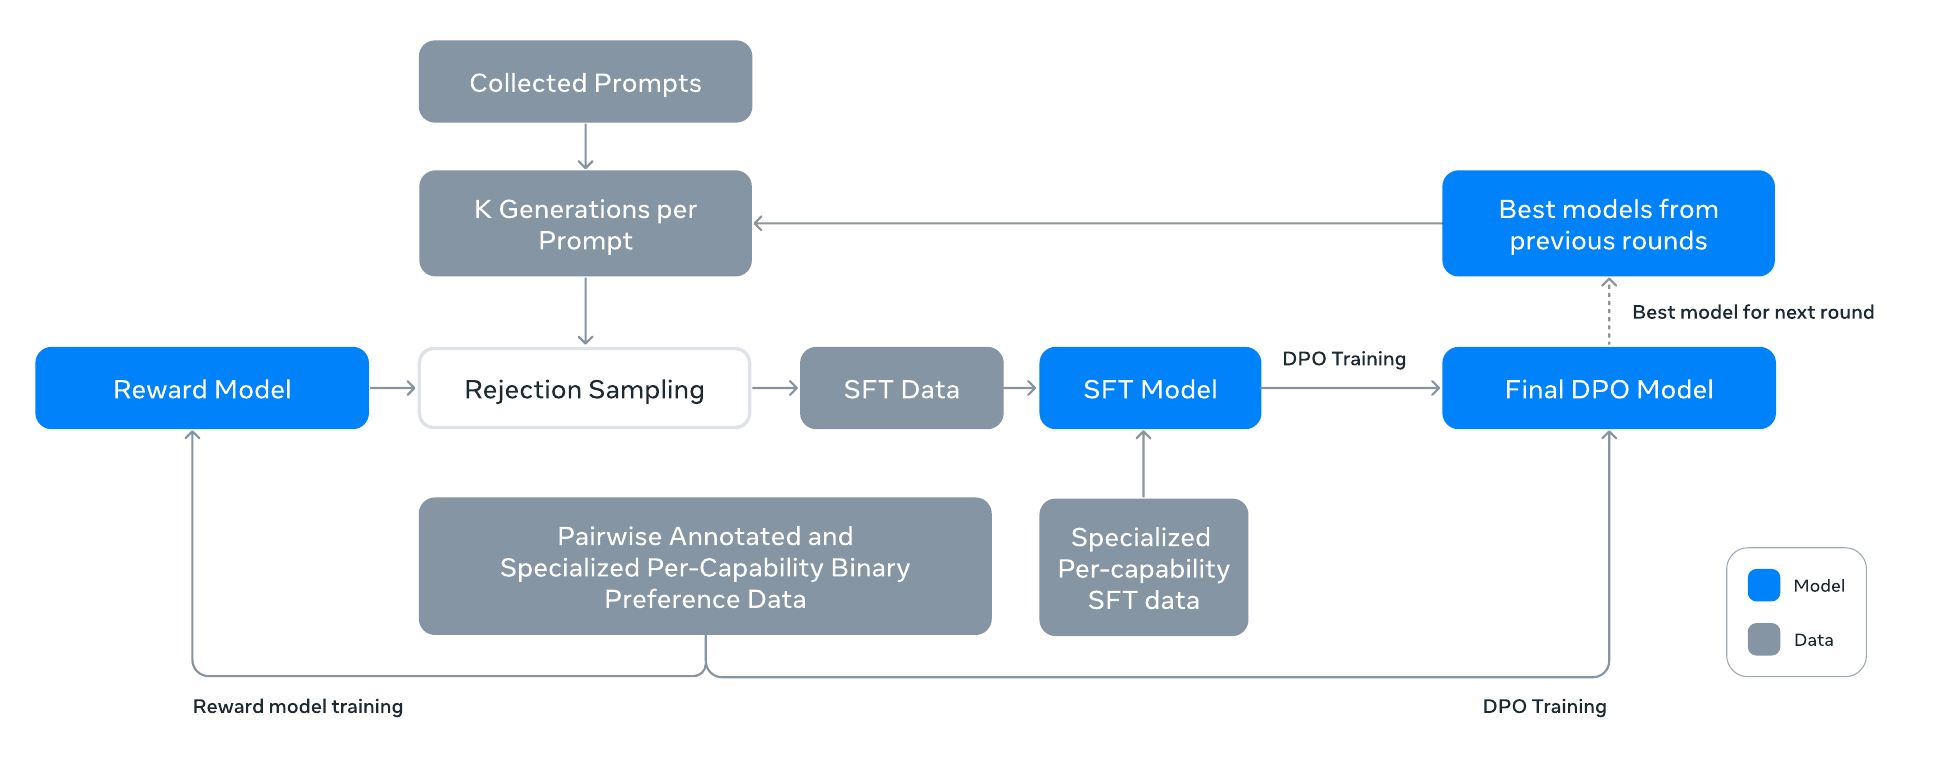
Ce schéma se lit de gauche à droite, puis on revient au début en suivant la flèche du haut.
On entraîne d'abord un modèle de récompense sur des données de préférences annotées par des humains. En plus de choisir la meilleure réponse, les annotateurs la retouchent parfois pour l'améliorer encore ; un exemple peut donc comporter trois niveaux, « modifiée > choisie > rejetée ». Ensuite, pour chaque prompt, on échantillonne 10 à 30 réponses du meilleur modèle du tour précédent, et le modèle de récompense retient la meilleure. C'est l'échantillonnage par rejet ; les réponses retenues deviennent les données d'entraînement du SFT.
Le SFT utilise un taux d'apprentissage de sur 8 500 à 9 000 étapes. Vient ensuite DPO, avec un taux de et , et deux modifications :
- Pas de perte sur les tokens de format. Les marqueurs de début et de fin de dialogue figurent à la fois dans la bonne et dans la mauvaise réponse ; DPO doit donc en même temps augmenter et diminuer leur probabilité, ce qui, d'après les auteurs, provoque des répétitions ou des fins abruptes.
- Un terme de régularisation NLL, de coefficient 0.2, pour empêcher la probabilité des réponses choisies de baisser sans cesse.
Les auteurs ont aussi essayé PPO, mais sur les grands modèles DPO demande moins de calcul et obtient de meilleurs résultats sur les évaluations de suivi d'instructions comme IFEval.
Tout le processus est répété sur six tours, chacun avec de nouvelles annotations et des données synthétiques générées par le dernier modèle.
Vient alors la deuxième « moyenne ». À chaque étape, modèle de récompense, SFT et DPO, les auteurs font la moyenne de modèles entraînés avec différentes versions des données ou différents hyperparamètres, en citant précisément SWA et Model Soups. Là encore, le rapport ne donne aucune ablation.
Capacités : branches expertes et retour d'exécution
L'essentiel des données de post-entraînement est généré par des modèles ; le contrôle de qualité devient donc central. Les auteurs classent les thèmes avec Llama 3 8B, estiment la qualité par deux signaux, le score du modèle de récompense et l'auto-évaluation de Llama, puis estiment la difficulté, et dédupliquent enfin au sein de clusters sémantiques en privilégiant les échantillons de haute qualité et de forte difficulté.
Chaque capacité a aussi ses méthodes propres. Voici les deux plus représentatives.
Code. Les auteurs détachent une branche du préentraînement principal et poursuivent le préentraînement sur 1T tokens composés à plus de 85 % de code. Ils obtiennent ainsi un expert en code, chargé de produire des données de haute qualité liées au code. Les données synthétiques dépassent 2.7 millions d'exemples au total.
Le résultat le plus intéressant est que le 8B et le 70B progressent nettement lorsqu'on les entraîne sur des données générées par le 405B, alors que le 405B entraîné sur ses propres données n'y gagne rien, voire se dégrade. La solution des auteurs consiste à introduire un retour d'exécution : le code généré doit passer une vérification syntaxique, une analyse statique et des tests unitaires écrits par le modèle lui-même ; en cas d'échec, le message d'erreur est renvoyé au modèle avec une demande de correction, et seuls les dialogues qui passent tous les contrôles entrent dans les données d'entraînement. Environ 20 % des solutions étaient fausses au départ, puis ont été corrigées avec succès par le modèle lui-même.
Long contexte. Un SFT sur des données courtes uniquement dégrade nettement la capacité de long contexte acquise au préentraînement. Or annoter manuellement de longs documents est presque impossible ; les auteurs se tournent donc vers des données synthétiques : questions-réponses sur de longs documents, résumés hiérarchiques, recherche d'un fichier de code supprimé. Les ablations montrent qu'il suffit de mêler 0.1 % de données synthétiques de long contexte au SFT.
Discussion
Résultats
Après post-entraînement, le 405B se situe globalement, dans la Table 2 du rapport, au niveau des meilleurs modèles fermés de l'époque :
| Benchmark | Llama 3 405B | GPT-4o | Claude 3.5 Sonnet |
|---|---|---|---|
| MMLU (5-shot) | 87.3 | 89.1 | 89.9 |
| MMLU-Pro (5-shot, CoT) | 73.3 | 74.0 | 77.0 |
| HumanEval (0-shot) | 89.0 | 90.2 | 92.0 |
| GSM8K (8-shot, CoT) | 96.8 | 96.1 | 96.4 |
| MATH (0-shot, CoT) | 73.8 | 76.6 | 71.1 |
| GPQA (0-shot, CoT) | 51.1 | 53.6 | 59.4 |
Sur la plupart des lignes, l'écart tient en quelques points ; Llama 3 l'emporte légèrement sur GSM8K et IFEval, et reste nettement derrière sur GPQA.
Les évaluations humaines vont dans le même sens. Le modèle fait à peu près jeu égal avec GPT-4 (version 0125) ; face à GPT-4o et à Claude 3.5 Sonnet, il gagne sur certains points et perd sur d'autres, et reste derrière Claude 3.5 Sonnet en code et en raisonnement. Les auteurs rappellent aussi que les évaluations humaines sont très sensibles à des détails comme le ton, la structure et la longueur.
Inférence : une seule machine ne suffit pas
Stocké en BF16, le 405B ne tient pas sur une machine à 8 H100 ; il faut le répartir sur deux machines en parallélisme de pipeline. Les auteurs ont donc mis en place une quantification FP8. Elle porte sur la plupart des poids et activations du réseau feed-forward, qui représente environ la moitié du temps de calcul à l'inférence ; les couches d'attention ne sont pas quantifiées, pas plus que la première et la dernière couche Transformer.
Cette partie contient une observation très pratique. Les évaluations standard montrent FP8 et BF16 à peu près équivalents ; pourtant, les auteurs constatent que si le facteur d'échelle dynamique n'est pas plafonné, le modèle produit de temps en temps des réponses incohérentes, invisibles dans les évaluations. Ils comparent donc les deux versions sur la distribution des scores du modèle de récompense pour 100 000 réponses, plafonnent le facteur d'échelle à 1200 et passent à une quantification ligne par ligne. En phase de préremplissage, FP8 augmente le débit de 50 % au maximum.
Le multimodal reste expérimental
Les capacités image, vidéo et parole sont obtenues en branchant des encodeurs et des adaptateurs à côté du modèle de langage gelé : l'image entre par des couches d'attention croisée, tandis que la parole est convertie en représentations de tokens fournies directement en entrée. Au moment de la rédaction du rapport, ces modèles étaient encore en développement et n'ont pas été publiés avec la version 3.1.
Le post-entraînement visuel fait apparaître une troisième « moyenne », décrite cette fois de façon plus concrète. Le SFT sur les images s'inspire de Model Soups : on lance d'abord une recherche d'hyperparamètres en faisant varier sous-ensemble de données, taux d'apprentissage et décroissance des poids, on classe les modèles selon leurs performances, puis on fait la moyenne des poids des premiers ; lui-même est choisi en évaluant les modèles moyennés. Selon les auteurs, le modèle moyenné surpasse systématiquement le meilleur modèle individuel trouvé par recherche en grille et se montre moins sensible aux hyperparamètres. Pour le DPO visuel, le modèle de référence n'est plus fixe : il est mis à jour toutes les étapes par moyenne mobile exponentielle, ce qui améliore les résultats des évaluations humaines.
Un passage rare dans un rapport
La conclusion contient un passage rare dans un rapport technique. Au-delà des questions techniques, disent les auteurs, les décisions d'organisation sont elles aussi déterminantes. Par exemple, les données de préentraînement sont obtenues et traitées par une autre équipe, à qui il a été explicitement demandé d'éviter toute contamination par les benchmarks ; les évaluations humaines ne peuvent être lancées et consultées que par un petit nombre de chercheurs qui ne participent pas au développement du modèle.
Ce qu'il faut garder en tête en lisant ce rapport
Le rapport décrit abondamment « ce que nous avons fait », mais beaucoup de décisions ne sont pas accompagnées d'ablations. Pourquoi ne pas utiliser de MoE, combien apportent la moyenne des checkpoints et la moyenne des modèles : le rapport ne livre qu'une conclusion ou une phrase. Les sources et le contenu des données de préentraînement ne sont pas publiés non plus ; un tiers ne peut pas reproduire l'entraînement.
Du point de vue de la fusion de modèles, l'intérêt du rapport est de montrer que la « moyenne » est déjà une étape standard dans les grands laboratoires : moyenne des checkpoints pendant le recuit du préentraînement, moyenne de modèles aux réglages différents à chaque étape du post-entraînement, moyenne des meilleurs modèles pour le SFT de l'adaptateur visuel. Reste à savoir comment faire la moyenne et sur combien de modèles ; ces réponses sont laissées aux articles suivants.
Conclusion
Llama 3 mise sur des données plus nombreuses et plus propres, une plus grande échelle, ainsi qu'une architecture et un post-entraînement volontairement simples. Le rapport montre qu'un modèle sans MoE ni PPO peut rivaliser avec les meilleurs modèles fermés de son époque, pourvu que les données et l'échelle soient au rendez-vous.
Le rapport laisse aussi beaucoup de détails pratiques : évaluer de petits jeux de données par recuit, ne pas nourrir le 405B de ses seules données générées, se contenter de 0.1 % de données synthétiques pour le long contexte, juger la quantification FP8 sur la distribution des scores de récompense plutôt que sur les seuls benchmarks.
Quant au rappel sur l'organisation, il a pris un poids particulier un an plus tard. À la sortie de Llama 4 en avril 2025, son rang élevé sur LMArena venait d'une version expérimentale spécialement ajustée pour la conversation ; LMArena a ensuite déclaré que l'interprétation de ses règles par Meta ne correspondait pas à ce qu'elle attendait des fournisseurs de modèles, et a mis à jour sa politique de classement. Un rapport technique a beau être minutieux, c'est à l'organisation de préserver la crédibilité des évaluations.