Article original
Kimi k1.5: Scaling Reinforcement Learning with LLMs
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2501.12599
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformerskimik152025,
  title = {{Kimi k1.5: Scaling Reinforcement Learning with LLMs}},
  author = {Kimi Team and Angang Du and Bofei Gao and Bowei Xing and Changjiu Jiang and Cheng Chen and Cheng Li and Chenjun Xiao and Chenzhuang Du and Chonghua Liao and Chuning Tang and Congcong Wang and Dehao Zhang and Enming Yuan and Enzhe Lu and Fengxiang Tang and Flood Sung and Guangda Wei and Guokun Lai and Haiqing Guo and Han Zhu and Hao Ding and Hao Hu and Hao Yang and Hao Zhang and Haotian Yao and Haotian Zhao and Haoyu Lu and Haoze Li and Haozhen Yu and Hongcheng Gao and Huabin Zheng and Huan Yuan and Jia Chen and Jianhang Guo and Jianlin Su and Jianzhou Wang and Jie Zhao and Jin Zhang and Jingyuan Liu and Junjie Yan and Junyan Wu and Lidong Shi and Ling Ye and Longhui Yu and Mengnan Dong and Neo Zhang and Ningchen Ma and Qiwei Pan and Qucheng Gong and Shaowei Liu and Shengling Ma and Shupeng Wei and Sihan Cao and Siying Huang and Tao Jiang and Weihao Gao and Weimin Xiong and Weiran He and Weixiao Huang and Weixin Xu and Wenhao Wu and Wenyang He and Xianghui Wei and Xianqing Jia and Xingzhe Wu and Xinran Xu and Xinxing Zu and Xinyu Zhou and Xuehai Pan and Y. Charles and Yang Li and Yangyang Hu and Yangyang Liu and Yanru Chen and Yejie Wang and Yibo Liu and Yidao Qin and Yifeng Liu and Ying Yang and Yiping Bao and Yulun Du and Yuxin Wu and Yuzhi Wang and Zaida Zhou and Zhaoji Wang and Zhaowei Li and Zhen Zhu and Zheng Zhang and Zhexu Wang and Zhilin Yang and Zhiqi Huang and Zihao Huang and Ziyao Xu and Zonghan Yang and Zongyu Lin},
  year = {2025},
  eprint = {2501.12599},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2501.12599}
}
Le 20 janvier 2025, DeepSeek publie R1 ; environ une heure plus tard, Moonshot AI publie à son tour Kimi k1.5.
Les deux modèles visent à peu près le même but. Après la présentation d'o1 par OpenAI en septembre 2024, tout le monde savait que « laisser le modèle réfléchir longtemps avant de répondre » améliore fortement les résultats en mathématiques et en code, mais OpenAI n'avait pas dit comment faire. Les deux rapports apportent une réponse, et leurs réponses se ressemblent : utiliser l'apprentissage par renforcement pour entraîner le modèle à écrire de longs raisonnements, sans recherche arborescente Monte-Carlo, sans fonction de valeur et sans modèle de récompense de processus qui note chaque étape.
La différence, c'est que les poids de R1 sont publics et pas ceux de k1.5, accessible seulement via les produits et l'API de Kimi. Le rapport ne donne pas non plus le nombre de paramètres du modèle. Lire k1.5, c'est donc s'intéresser moins au modèle qu'à sa méthode d'entraînement. On y trouve deux choses absentes du rapport R1 : l'extension du contexte de l'apprentissage par renforcement à 128K, et toute une section sur la manière de transférer la capacité de réflexion longue vers un modèle à réponses courtes, dont l'une des méthodes est justement la fusion de modèles.
Définir le problème
Le passage à l'échelle du préentraînement est limité par la quantité totale de données de haute qualité. Les auteurs cherchent une autre voie qui puisse continuer à grandir : laisser le modèle explorer par lui-même grâce aux récompenses, au lieu de n'apprendre qu'un jeu de données fixe.
Le cadre est très simple. Étant donné une question et une réponse de référence , le modèle écrit d'abord un raisonnement , puis donne une réponse . La récompense vaut seulement 0 ou 1. Pour le code, on regarde si les tests passent ; pour les mathématiques, si la réponse est juste :
Les auteurs ont un point de vue intéressant sur la « réflexion longue ». Une recherche classique au moment de l'inférence, comme une recherche arborescente, a besoin d'un évaluateur qui juge quelle branche est la plus prometteuse avant de décider quel nœud développer. Mais si l'on écrit toutes les tentatives, évaluations et retours en arrière de la recherche sous la forme d'un très long texte, un modèle capable d'écrire très long peut mener la recherche implicitement dans son propre contexte.
Ce point de vue ramène le problème à deux questions : jusqu'où peut-on étendre le contexte, et l'apprentissage par renforcement peut-il apprendre au modèle à bien exploiter cette longueur ?
Résoudre le problème
D'abord, bien choisir les questions
Les auteurs constatent que la réussite de l'apprentissage par renforcement dépend en grande partie de l'ensemble de questions. Un bon ensemble couvre plusieurs domaines, avec une répartition équilibrée des difficultés et des réponses vérifiables avec précision.
La difficulté est estimée par le modèle lui-même. Le modèle SFT répond 10 fois à chaque question avec une température d'échantillonnage assez élevée ; plus le taux de réussite est bas, plus la question est difficile. Cela permet au passage d'écarter les questions trop faciles.
La vérification doit, elle, empêcher de « deviner juste ». Pour certaines questions de raisonnement, la réponse est facile à deviner : le modèle peut obtenir la bonne réponse avec un raisonnement faux, et la récompense est trompée. Les auteurs excluent les QCM, les questions vrai/faux et les démonstrations ; pour les questions-réponses ordinaires, ils laissent d'abord le modèle deviner directement 8 fois, sans réfléchir, et s'il tombe juste ne serait-ce qu'une fois, la question est jugée trop facile à deviner et supprimée.
L'échauffement de la réflexion longue
Avant l'apprentissage par renforcement proprement dit, les auteurs génèrent par prompt engineering un petit lot d'exemples de réflexion longue de haute qualité. Ces exemples contiennent volontairement des comportements comme planifier, évaluer les étapes intermédiaires, réfléchir et se corriger, essayer d'autres solutions ; un SFT léger est ensuite effectué. Le but est que le modèle apprenne d'abord cette façon d'écrire, que l'apprentissage par renforcement amplifiera ensuite.
Optimisation de la politique : descente miroir en ligne
Les auteurs utilisent une variante de la descente miroir en ligne (online mirror descent). Au tour , le modèle courant sert de référence, et l'on résout un problème régularisé par KL :
Ce problème a une solution fermée, . En prenant le logarithme des deux côtés, on obtient une égalité qui doit tenir pour tout échantillon ; les auteurs la réécrivent en une perte de substitution par erreur quadratique :
est approché par la récompense moyenne de réponses échantillonnées pour la même question. En prenant le gradient de cette perte, le premier terme donne un gradient de politique avec la récompense moyenne comme référence, et le second un terme de régularisation .
En clair, pour une même question, on échantillonne réponses ; on augmente la probabilité de celles qui sont justes (récompense au-dessus de la moyenne) et on abaisse celle des fausses, tout en restant proche du modèle du tour précédent. À la fin de chaque tour, le modèle de référence est remplacé par le nouveau modèle, et l'état de l'optimiseur est réinitialisé.
Cette méthode n'a pas de réseau de valeur. La justification des auteurs est éclairante. Supposons qu'à mi-chemin, le modèle puisse prendre soit un chemin menant directement à la bonne réponse, soit un chemin qui l'amènera à se tromper. Une fonction de valeur classique pénaliserait le second ; mais si le modèle, après l'erreur, la repère et la corrige pour finalement répondre juste, cette expérience « se tromper puis se corriger » est justement ce dont il a le plus besoin pour apprendre la réflexion longue. Les auteurs ne regardent donc que la réponse finale, sans attribution de crédit aux étapes intermédiaires.
Pénalité de longueur
Pendant l'apprentissage par renforcement, les réponses s'allongent de plus en plus. Les performances progressent bel et bien, mais le coût d'inférence ne cesse de grimper. Les auteurs ajoutent une récompense de longueur.
Parmi les réponses à une même question, on note min_len et max_len les longueurs minimale et maximale ; la récompense de longueur de la -ème réponse est
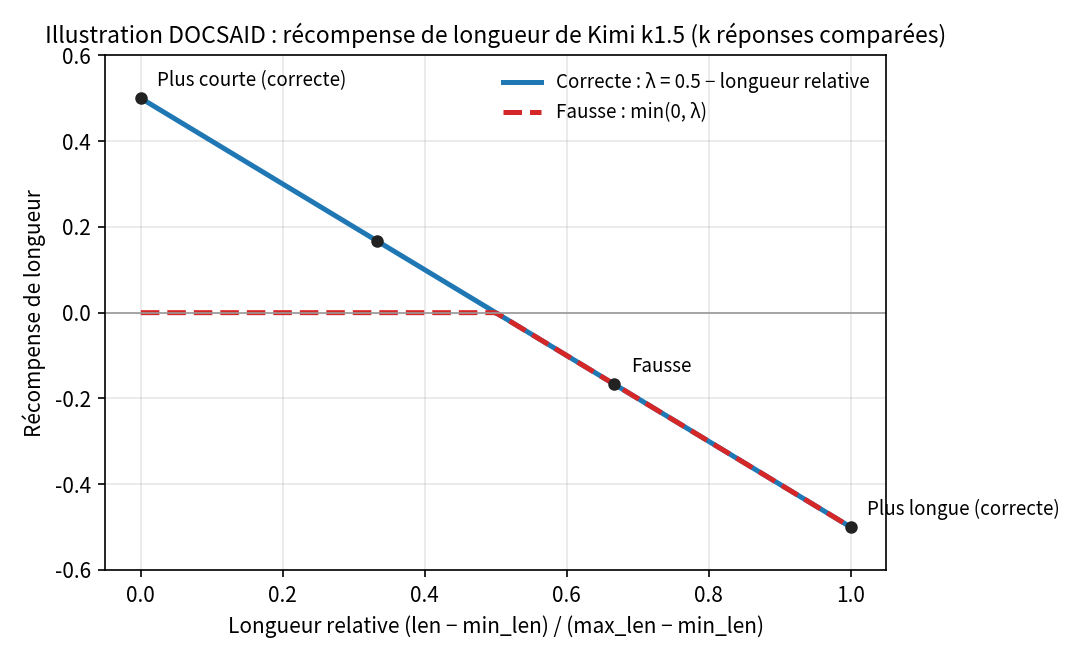
Faisons le calcul sur un exemple. On échantillonne quatre réponses à une même question, longues de 1 000, 2 000, 3 000 et 4 000 tokens ; la troisième est fausse :
def length_reward(lengths, correct):
    lo, hi = min(lengths), max(lengths)
    if hi == lo:
        return [0.0] * len(lengths)
    out = []
    for n, ok in zip(lengths, correct):
        lam = 0.5 - (n - lo) / (hi - lo)
        out.append(lam if ok else min(0.0, lam))
    return out

lengths = [1000, 2000, 3000, 4000]
correct = [True, True, False, True]
for n, ok, r in zip(lengths, correct, length_reward(lengths, correct)):
    print(f"longueur {n:>5}  {'correcte' if ok else 'fausse  '}  récompense de longueur {r:+.3f}")
longueur  1000  correcte  récompense de longueur +0.500
longueur  2000  correcte  récompense de longueur +0.167
longueur  3000  fausse    récompense de longueur -0.167
longueur  4000  correcte  récompense de longueur -0.500
Parmi les réponses correctes, la plus courte est la meilleure ; une réponse fausse n'est pas récompensée pour sa brièveté, mais elle est pénalisée tout autant si elle est trop longue. Remarquez que la réponse correcte la plus longue reçoit une récompense de longueur de −0.5, plus basse que celle de la réponse fausse. Ce n'est pas un problème, car la récompense de longueur s'ajoute, avec un certain poids, à la récompense d'exactitude qui vaut 0 ou 1, et le 1 d'une bonne réponse reste dominant.
Les auteurs constatent aussi que la pénalité de longueur ralentit les progrès au début de l'entraînement. Ils ne l'ajoutent donc pas d'emblée, mais seulement après un certain temps d'entraînement, et la maintiennent ensuite.
Stratégies d'échantillonnage et modèles de récompense
Deux stratégies servent à échantillonner les questions. L'échantillonnage par curriculum fait travailler d'abord les questions faciles, puis les difficiles, car au début le modèle est trop faible et le calcul dépensé sur les questions difficiles ne produit presque aucun échantillon correct. L'échantillonnage prioritaire enregistre le taux de réussite de chaque question et tire les questions proportionnellement à , pour faire travailler le modèle là où il est le plus faible.
Les problèmes de programmation trouvés sur le web n'ont souvent pas de cas de test ; les auteurs les génèrent automatiquement avec un modèle associé à la bibliothèque de génération de tests CYaRon. Pour chaque problème, ils génèrent d'abord 50 cas de test et les vérifient avec 10 solutions correctes ; un cas n'est conservé que si au moins 7 solutions donnent le même résultat. Un problème n'entre dans le jeu d'entraînement que si au moins 9 solutions passent tous les cas conservés. Sur 1 000 problèmes de concours en ligne, seuls 323 ont finalement été retenus.
La difficulté des mathématiques est qu'une même réponse peut s'écrire de bien des façons, par exemple et . Les auteurs comparent deux modèles de récompense : un modèle de récompense classique qui produit un score, d'une précision d'environ 84.4 % sur un contrôle manuel ; et un modèle de récompense CoT, qui écrit d'abord un raisonnement avant de juger, d'une précision d'environ 98.5 %. L'apprentissage par renforcement utilise le second.
Contexte long de 128K et déroulements partiels
Quand le modèle écrit jusqu'à 128K tokens pendant l'apprentissage par renforcement, une réponse particulièrement longue monopolise les ressources d'échantillonnage et ralentit tout le lot d'entraînement. C'est le principal problème d'ingénierie.
La solution des auteurs s'appelle les déroulements partiels (partial rollouts). Chaque échantillonnage fixe une limite de longueur de sortie ; une réponse inachevée est stockée dans un tampon de rejeu et poursuivie au tour suivant. Seul le segment en cours doit être calculé avec la politique actuelle ; les segments précédents sont repris directement du tampon. Les processus d'échantillonnage fonctionnent de façon asynchrone : certains traitent les réponses longues pendant que d'autres traitent des réponses courtes, et les ressources ne restent pas inactives. Le système détecte aussi les contenus répétitifs, les tronque tôt et les pénalise.
Discussion
Les résultats de la réflexion longue
La version à réflexion longue de k1.5 obtient des résultats comparables à ceux d'OpenAI o1. AIME 2024 : 77.5 (o1 : 74.4) ; MATH-500 : 96.2 (o1 : 94.8) ; Codeforces : 94e centile (comme o1) ; LiveCodeBench : 62.5 (o1 : 67.2). Côté vision, MathVista atteint 74.9 et MMMU 70.0.
Les auteurs observent aussi le passage à l'échelle sur un modèle de taille moyenne. Au fil de l'entraînement, la longueur des réponses et la précision augmentent ensemble ; plus l'évaluation est difficile, plus la longueur croît vite.
Une autre ablation compare taille du modèle et réflexion longue. Avec les mêmes données, on entraîne un grand et un petit modèle : le grand part avec de meilleurs résultats, mais le petit peut le rattraper grâce à une réflexion plus longue ; le grand modèle reste toutefois plus efficace en tokens. Pour viser les meilleures performances, étendre le contexte d'un grand modèle offre un plafond plus élevé ; avec un budget d'inférence limité, entraîner un petit modèle à écrire un peu plus long est aussi une option viable.
Il y a encore deux ablations. Par rapport à ReST, qui n'apprend que des meilleures réponses sans pénaliser les mauvaises, la méthode des auteurs est nettement plus efficace en échantillons, ce qui montre l'importance des gradients négatifs pour apprendre la réflexion longue. L'échantillonnage par curriculum fait aussi nettement mieux que l'échantillonnage uniforme.
Pour faire court
La réflexion longue est puissante, mais coûteuse. Dans la section 2.4, les auteurs comparent quatre méthodes pour transférer la capacité de réflexion longue vers un modèle à réponses courtes :
- Fusion de modèles : moyenner directement les poids du modèle à réflexion longue et du modèle à réponses courtes, sans aucun entraînement.
- Échantillonnage par rejet de la réponse la plus courte : échantillonner 8 fois la même question et utiliser la plus courte des réponses correctes pour le SFT.
- DPO : la plus courte réponse correcte sert d'exemple positif ; les réponses longues fausses et les réponses correctes plus de 1.5 fois plus longues que l'exemple positif servent d'exemples négatifs.
- Apprentissage par renforcement long2short : choisir le modèle au meilleur équilibre entre performance et longueur, puis lancer un tour supplémentaire d'apprentissage par renforcement avec une pénalité de longueur et une limite de longueur d'échantillonnage fortement réduite.
C'est la quatrième méthode qui offre la meilleure efficacité en tokens. La version à réponses courtes de k1.5 obtient 60.8 sur AIME 2024 avec seulement 3 272 tokens en moyenne, contre 9.3 pour GPT-4o et 16.0 pour Claude 3.5 Sonnet. Sur MATH-500, la version la plus courte obtient 88.2 avec un nombre de tokens proche de celui des autres modèles à réponses courtes.
Ici, la fusion de modèles est efficace sans être la meilleure méthode. Son avantage est de ne demander aucun entraînement ; les méthodes avec entraînement, en comparaison, contrôlent plus précisément la longueur. Cette conclusion a d'ailleurs été citée plus tard par Assembly of Experts, pour illustrer les limites de la fusion quand il s'agit de raccourcir le raisonnement.
Ce qu'il faut garder en tête en lisant ce rapport
Le modèle n'est pas ouvert, son nombre de paramètres et l'échelle de son préentraînement ne sont pas publiés ; les chiffres du rapport ne peuvent pas être vérifiés par un tiers. La comparaison long2short ne présente l'efficacité en tokens que sous forme de graphiques, et la plupart des chiffres précis par méthode ne sont pas donnés. La plupart des ablations sont faites sur des modèles plus petits.
Conclusion
Kimi k1.5 et DeepSeek-R1 ont donné le même jour des réponses proches. Avec une simple récompense fondée sur la justesse du résultat et un contexte suffisamment long, on peut apprendre à un modèle la réflexion longue, sans recherche arborescente, fonction de valeur ni récompense de processus.
La contribution propre de k1.5 est d'avoir décrit très concrètement les détails d'ingénierie de cette voie : comment choisir les questions, comment empêcher de deviner, comment échantillonner efficacement à 128K, comment freiner la sur-réflexion avec la récompense de longueur, et comment ramener la réflexion longue à des réponses courtes.
Si vous voulez bâtir un produit sur un modèle à réflexion longue, et qu'il partage sa base avec votre modèle à réponses courtes, commencez par essayer de faire la moyenne des deux. Pas d'entraînement, une simple opération sur les poids ; si ce n'est pas assez bon, envisagez alors un tour d'apprentissage par renforcement long2short.