Article original
Language Models are Super Mario: Absorbing Abilities from Homologous Models as a Free Lunch
- Publication
- ICML 2024Conférence
- Premier dépôt sur arXiv
- arXiv:2311.03099
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingdare2023,
  title = {{Language Models are Super Mario: Absorbing Abilities from Homologous Models as a Free Lunch}},
  author = {Le Yu and Bowen Yu and Haiyang Yu and Fei Huang and Yongbin Li},
  year = {2023},
  eprint = {2311.03099},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2311.03099}
}
Au second semestre 2023, Hugging Face héberge déjà de nombreux ajustements du même Llama 2 : WizardLM suit les instructions, WizardMath fait des mathématiques, d'autres écrivent du code.
Pour réunir ces capacités, on peut rassembler les données et réajuster le modèle. Mais souvent seuls les poids sont publics ; même avec les données, réentraîner 13B ou 70B coûte cher.
Le Yu, Bowen Yu, Haiyang Yu, Fei Huang et Yongbin Li, d'Alibaba, comparent le problème à Super Mario qui absorbe des bonus. Un modèle peut-il absorber directement les capacités de modèles de même origine, sans nouvel entraînement, voire sans GPU ?
L'article commence par une question plus fondamentale : quelle part des poids l'ajustement modifie-t-il réellement ?
Définir le problème
Soient les poids préentraînés et les poids après ajustement supervisé, SFT, sur la tâche . Les paramètres delta sont :
C'est le vecteur de tâche de l'arithmétique des tâches. TIES-Merging a déjà montré que beaucoup de deltas redondants diluent les changements importants d'autres modèles. Il les élague par amplitude pour garder les 20 % les plus grands.
Les auteurs vont plus loin. Dans plusieurs modèles de langage, les deltas restent surtout dans une amplitude de 0.002 et semblent très redondants. Peut-on en supprimer presque tout et conserver le modèle ?
Résoudre le problème
Supprimer, puis amplifier
Le nom décrit la méthode : Drop And REscale.
Chaque delta est annulé avec probabilité ; les survivants sont multipliés par . Finalement, .
La suppression est aléatoire, sans regarder l'amplitude, contrairement à TIES et à l'élagage habituel.
Pourquoi amplifier ?
Pour une couche linéaire d'entrée , de poids et biais préentraînés et , et de deltas et , la sortie vaut :
DARE modifie seulement les deltas. Chaque survit avec probabilité , multiplié par , ou devient nul avec probabilité . L'espérance de sa contribution est donc :
Avec , on retrouve en espérance. L'égalité concerne une seule couche linéaire à entrée fixe. Les non-linéarités et les entrées modifiées par les couches précédentes exigent une évaluation du réseau complet.
Les auteurs parlent d'une démonstration approximative. Une espérance préservée laisse encore ouverte l'erreur d'un tirage individuel ; le taux tolérable doit être mesuré.
Deux deltas suffisent à voir la nuance. Voici les quatre masques équiprobables pour , sans entraînement de réseau :
import numpy as np
from itertools import product

delta = np.array([0.001, 0.002])
x = np.array([1., 2.])
p = 0.5
outputs = []
for dropped in product([0, 1], repeat=2):
    kept_delta = (1 - np.array(dropped)) * delta / (1 - p)
    outputs.append(float(kept_delta @ x))
print("各遮罩的 delta 輸出:", np.round(outputs, 6).tolist())
print(f"原本: {delta @ x:.6f}, 遮罩平均: {np.mean(outputs):.6f}")
各遮罩的 delta 輸出: [0.01, 0.002, 0.008, 0.0]
原本: 0.005000, 遮罩平均: 0.005000
La moyenne des quatre sorties est correcte, mais un masque seul peut donner zéro ou le double de l'original. DARE tire le masque une seule fois lors de la création du modèle ; il reste fixe au déploiement et les quatre modèles ne sont pas exécutés ensemble. La conservation des capacités dépend donc aussi de l'ampleur de la perturbation.
Pour un delta fixe , la variance après DARE est :
Ce calcul découle directement du masque de Bernoulli. Le multiplicateur vaut 9 à , 99 à : plus le delta et le taux augmentent, plus une perturbation isolée devient difficile à contenir. Pour une couche linéaire à entrée fixe et masques indépendants, la variance de sortie additionne les contributions en . Ce calcul éclaire les échecs suivants ; le lien entre taille du modèle et tolérable reste expérimental.
Un prétraitement de fusion
DARE ne fusionne pas lui-même les modèles. Il s'applique séparément à chaque candidat avant une méthode existante. Pour l'arithmétique des tâches :
Chaque modèle n'ayant plus qu'une petite fraction de deltas non nuls, leurs positions se recouvrent moins et devraient moins interférer.
Avec deux masques indépendants, une position survit dans les deux avec probabilité . À , seulement environ 1 % des coordonnées que les deux deltas pouvaient modifier survivent conjointement. La parcimonie réduit ainsi le recouvrement, mais les survivants sont aussi multipliés par dix : qualité des sources, recouvrement et échelle doivent être examinés ensemble.
Discussion
Combien peut-on supprimer ?
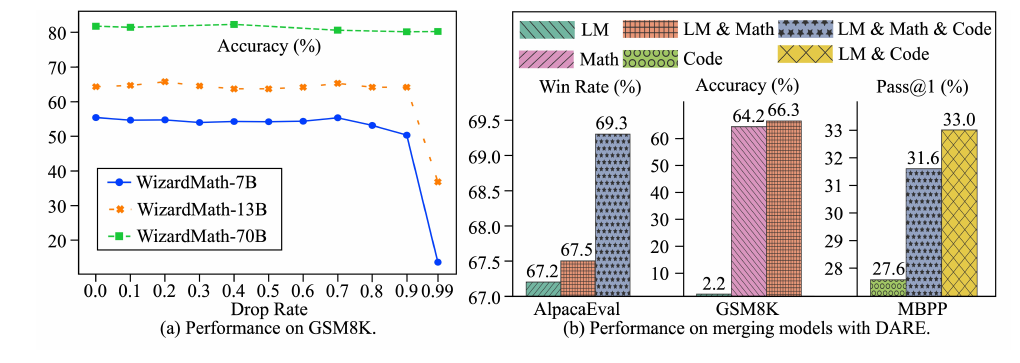
À gauche, les trois tailles de WizardMath conservent presque leur performance avec 90 % de suppression. À 99 %, 7B et 13B cèdent, mais 70B tient encore.
Les auteurs y voient une forte redondance des deltas SFT, permettant parfois 90 % ou 99 % de suppression, avec une tolérance plus élevée pour les grands modèles. Les encodeurs BERT et RoBERTa sur GLUE montrent aussi une dégradation surtout au-delà de 0.9.
Le balayage est . Pour les décodeurs, le suivi d'instructions est évalué par le win rate AlpacaEval, les mathématiques la précision GSM8K et MATH, le code le pass@1 HumanEval et MBPP, avec décodage glouton. Pour BERT-base et RoBERTa-base, huit tâches GLUE utilisent selon le cas précision, F1 ou corrélation. La conservation doit donc être lue avec la mesure de chaque graphique ; la forte tolérance de WizardMath-70B sur GSM8K ne s'étend pas automatiquement à tous les experts.
Les auteurs réservent 10 % de l'entraînement GLUE à la validation et utilisent la validation officielle comme test. Le taux peut ainsi être choisi sur des données réservées. Les 99 % montrent un cas extrême atteignable ; en pratique, on peut commencer par des suppressions plus faibles.
Réunir trois modèles 13B
Les trois sources ajustées depuis Llama-2-13b sont WizardLM-13B pour les instructions, WizardMath-13B pour les mathématiques et llama-2-13b-code-alpaca pour le code. WizardCoder-Python-13B est écarté car il part de CodeLlama-13b-Python, une autre base.
| Modèle | DARE | AlpacaEval | GSM8K | HumanEval | MBPP |
|---|---|---|---|---|---|
| LM | – | 67.20 | 2.20 | 36.59 | 34.00 |
| Math | – | – | 64.22 | – | – |
| Arithmétique : LM + Math | Non | 67.04 | 66.34 | 28.66 | 30.60 |
| Arithmétique : LM + Math | Oui | 67.45 | 66.26 | 26.83 | 32.40 |
| TIES : LM + Math | Non | 68.63 | 15.77 | 37.80 | 35.60 |
| TIES : LM + Math | Oui | 68.70 | 36.16 | 36.59 | 37.00 |
| Arithmétique : LM + Math + Code | Non | 69.03 | 58.45 | 18.29 | 29.80 |
| Arithmétique : LM + Math + Code | Oui | 69.28 | 56.48 | 23.17 | 31.60 |
Sélection de la Table 1. « – » désigne une mesure non effectuée pour ce modèle.
Le contraste majeur relie les première et troisième lignes : WizardLM vaut 2.20 sur GSM8K, contre 66.34 avec WizardMath par arithmétique, même au-dessus des 64.22 de WizardMath seul. Ce gain existe déjà sans DARE ; avec DARE, 66.26 est presque identique.
DARE aide surtout TIES. Dans ces modèles, l'élagage par amplitude abîme les mathématiques et donne 15.77 ; DARE avant TIES remonte à 36.16. Les auteurs expliquent qu'après DARE, la plupart des deltas sont déjà nuls : l'élagage TIES retire surtout ces zéros et préserve les valeurs utiles.
Cette configuration TIES diffère de la recette fixe originale. Pour les décodeurs, l'article DARE cherche des rétentions de 0.5, 0.7 et 0.9, et des coefficients de 0.5 ou 1.0, puis compare avec et sans DARE. Les 15.77 décrivent ces sources et cette recherche, plutôt que les autres tâches de TIES.
Les gains varient par mesure. Pour les trois modèles, GSM8K baisse de 58.45 à 56.48. Sur les encodeurs, le gain moyen avec cinq fusions va seulement de −0.03 % à 0.84 %, et les modèles fusionnés restent souvent derrière les experts individuels.
Les auteurs notent aussi que llama-2-13b-code-alpaca code moins bien que WizardLM-13B. Leur conclusion : chaque source doit déjà être suffisamment bien entraînée.
L'amplification est nécessaire
Le contrôle DropOnly supprime sans amplifier. Les auteurs comparent alors, couche par couche et pour les mêmes entrées, les représentations cachées aux originales.
À gauche, WizardMath-7B reçoit GSM8K ; à droite, BERT reçoit CoLA. L'abscisse parcourt les couches, l'ordonnée mesure la similarité cosinus moyenne avec la représentation originale. Il faut comparer DARE et DropOnly au même taux.
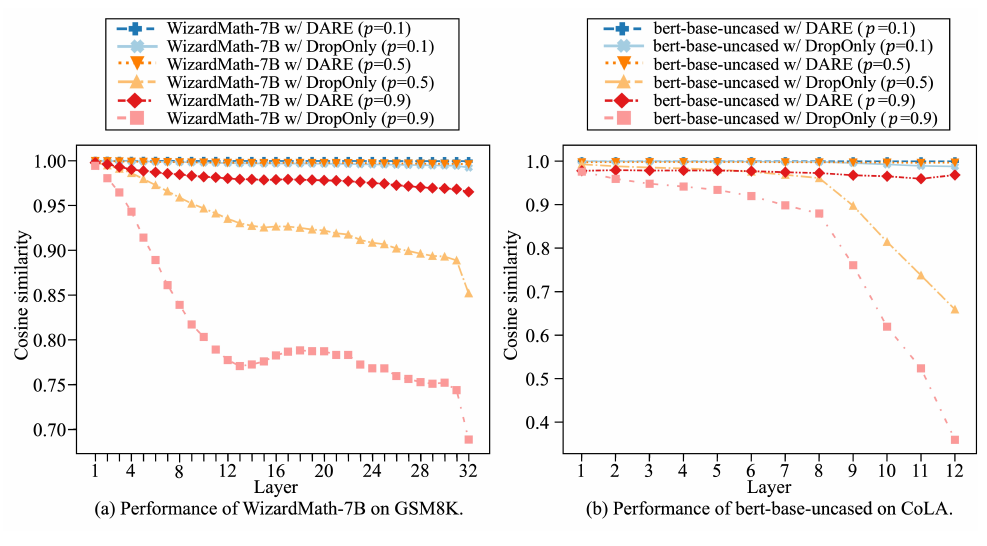
Avec 90 % supprimés, DARE reste au-dessus de 0.95 à chaque couche. DropOnly tient surtout à ; sur WizardMath-7B, il descend vers 0.85 à et 0.68 à . L'écart de performance se creuse aussi avec le taux.
Un autre contrôle applique un élagage par amplitude, MP, suivi de l'amplification. Avec 70 % supprimés sur 7B, AlpacaEval passe de 43.85 à 10.61, GSM8K de 46.70 à 0.37 et HumanEval de 21.34 à 3.05. Selon les auteurs, amplifier uniquement les grands survivants déséquilibre les sorties.
Quand éviter DARE
DARE suppose de petits deltas. Les auteurs construisent un échec en calculant ceux de WizardCoder-Python-13B par rapport à Llama-2-13b plutôt qu'à sa véritable base CodeLlama-13b-Python. CodeLlama a reçu 500 milliards de tokens supplémentaires liés au code et s'est beaucoup éloigné de Llama 2. Les deltas dépassent alors souvent 0.01, contre une amplitude ne dépassant pas 0.0002 par rapport à CodeLlama-13b-Python.
Supprimer seulement 10 % fait tomber les pass@1 HumanEval et MBPP de 63.41 et 55.4 à 0. Après préentraînement continu, les deltas peuvent atteindre environ 0.03, hors du cadre favorable à DARE.
Les 0.002 sont une observation sur ces modèles, avec des échelles variables selon architecture et couche. Les entrées amplifient aussi les perturbations de sortie. Le bon contrôle consiste à calculer la distribution des différences avec la base réelle, puis les courbes de rétention selon . La même étiquette « 13B » ou les mêmes formes de tenseurs laissent encore à vérifier l'identité de la base.
Les auteurs signalent aussi que supprimer 10 % des poids ajustés complets, plutôt que des deltas, ramène la performance près de zéro. Ils interprètent cela comme un SFT qui active surtout des capacités déjà présentes dans le préentraînement.
Il faut enfin distinguer delta clairsemé et petit modèle. Les poids reconstruits sont ; la base reste dense et complète. Supprimer 90 % des différences laisse donc le nombre de paramètres et les multiplications matricielles d'inférence inchangés. Stocker une base commune avec des deltas clairsemés peut économiser plusieurs versions, avec un format et un chargement adaptés. L'article étudie surtout conservation et fusion des capacités, sans réduire le réseau 70B à un réseau 0.7B.
En tête du classement
Les auteurs fusionnent enfin plusieurs modèles Mistral-7B pour créer supermario v1 et v2. Au 28 janvier 2024, v2 occupe la première place des 7B de l'Open LLM Leaderboard avec une moyenne de 75.49.
Les fiches de Beagle14-7B et NeuralBeagle14-7B, à ses côtés, mentionnent aussi mergekit. À cette époque, le haut du classement 7B est rempli de fusions et leurs scores commencent à susciter des doutes sur la contamination des données.
Conclusion
La découverte de DARE est plus intéressante encore que sa recette. Les changements SFT sont très petits : en supprimer aléatoirement la majorité et amplifier le reste peut préserver le modèle. Les plus grands modèles tolèrent davantage de suppression.
En prétraitement de fusion, DARE réduit souvent l'interférence, notamment avec TIES. Mais le gain peut se limiter à quelques dixièmes de point, voire s'inverser.
Avant de l'utiliser, vérifiez donc que chaque delta est calculé par rapport à sa véritable base. Une mauvaise base suffit à tout perdre avec seulement un dixième supprimé.