Article original
Assembly of Experts: Linear-time construction of the Chimera LLM variants with emergent and adaptable behaviors
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2506.14794
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingassemblyofexperts2025,
  title = {{Assembly of Experts: Linear-time construction of the Chimera LLM variants with emergent and adaptable behaviors}},
  author = {Henrik Klagges and Robert Dahlke and Fabian Klemm and Benjamin Merkel and Daniel Klingmann and David A. Reiss and Dan Zecha},
  year = {2025},
  eprint = {2506.14794},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2506.14794}
}
DeepSeek a eu un temps deux modèles très semblables, mais de caractères très différents.
L'un est DeepSeek-R1, un modèle de raisonnement : avant de répondre, il écrit un long raisonnement entre <think> et </think> ; il excelle en mathématiques, mais il est très bavard. L'autre est DeepSeek-V3-0324, mis à jour en mars 2025, un modèle de conversation ordinaire : il n'écrit pas de raisonnement, répond directement et vite.
Les deux ont exactement la même architecture et partent tous deux de la base DeepSeek-V3, avec 671 milliards de paramètres au total. Si l'on pouvait réunir la capacité de raisonnement de R1 et la concision de V3-0324 sans réentraîner, ce serait une excellente affaire.
La société allemande de conseil en logiciel TNG Technology Consulting l'a bel et bien fait. En avril 2025, elle a mis en ligne sur Hugging Face le modèle fusionné DeepSeek-R1T-Chimera, puis, plus d'un mois après, cet article, qui explique comment elle a procédé et ce qu'elle a observé en chemin.
Définir le problème
Rappelons d'abord l'architecture de DeepSeek-V3, la clé pour comprendre tout l'article.
C'est un Transformer à mélange d'experts (MoE) de 61 couches de décodeur. Les 3 premières sont des couches denses ordinaires ; dans les 58 suivantes, le réseau feed-forward est remplacé par des experts : chaque couche a un expert partagé, que traverse chaque token, et 256 experts routés, parmi lesquels un routeur en choisit 8 pour chaque token. D'où 671B paramètres au total, dont environ 37B seulement réellement utilisés par chaque token.
Démonté, un modèle n'est qu'un ensemble de fichiers de tenseurs. Les fichiers de poids safetensors de la famille DeepSeek-V3 contiennent 91 991 tenseurs, répartis en plusieurs catégories : les 3 premières couches denses, l'attention de chaque couche, les experts partagés, les experts routés et les portes du routeur.
Pour fusionner deux modèles, chaque catégorie de tenseurs peut être traitée séparément. C'est ce que les auteurs appellent « assemblage » : on ne décide pas seulement du poids donné à chaque modèle, mais aussi de quelles pièces fusionner et lesquelles reprendre telles quelles de l'un des deux.
La fusion a déjà servi à raccourcir les réponses de modèles de raisonnement, par exemple chez Wu et al., avec de bons résultats sur des modèles de 7B à 14B ; mais au-delà de 32B, ils ont eu du mal à raccourcir fortement les réponses tout en préservant la qualité du raisonnement. Cet article cherche à savoir si un modèle de 671B peut être assemblé ainsi, et comment évolue le comportement du modèle obtenu.
Résoudre le problème
Règle de fusion
Soit le modèle de base (ici V3-0324) et les autres modèles (ici seulement R1). Pour chaque tenseur , le tenseur fusionné est
Il y a trois éléments réglables :
- : le poids de chaque modèle, généralement une combinaison convexe, avec et une somme égale à 1. Avec deux modèles, est la proportion de R1.
- : l'ensemble des tenseurs à fusionner. Les auteurs en comparent deux : tous les tenseurs (full merging), ou seulement les experts routés, sans les portes (expert merging).
- : le seuil. Seuls les tenseurs suffisamment différents de la base sont fusionnés ; la différence est mesurée par la norme de Frobenius normalisée, c'est-à-dire la norme divisée par la racine carrée du nombre d'éléments du tenseur.
Le seuil emprunte l'idée d'élagage de TIES-Merging, mais TIES élague paramètre par paramètre, alors qu'ici on décide pour un tenseur entier s'il est fusionné ou non.
En pratique, il suffit de lire un à un les 91 991 tenseurs, de calculer le résultat de la fusion et de l'écrire dans des fichiers au même format, que vLLM charge directement. Le calcul est proportionnel à la taille du modèle, d'où le « temps linéaire » du titre, sans aucun calcul de gradient.
Voir d'abord où diffèrent les deux modèles
Les auteurs mesurent d'abord la différence entre R1 et V3-0324 pour chaque tenseur. Le résultat est très régulier. Les experts routés diffèrent de façon assez uniforme dans tout le modèle, avec des motifs nets seulement dans les toutes premières et toutes dernières couches ; les projections de porte des experts partagés sont presque identiques dans les premières couches, mais très différentes dans les dernières ; les couches d'attention suivent une tendance semblable.
Cette distribution des différences sert ensuite de base au choix du seuil .
Comment évaluer
Chaque modèle fusionné est exécuté avec vLLM sur 8 H100 ou 8 MI325X et testé principalement sur deux benchmarks : MT-Bench (qualité de la conversation multi-tours) et AIME-2024 (problèmes de concours de mathématiques). Leur moyenne est ce que les auteurs appellent le « score d'intelligence ».
Le coût est mesuré par le nombre moyen de tokens de sortie, rapporté à la production de R1, fixée à 100 %.
Il y a aussi un indicateur de comportement. Les auteurs forcent chaque réponse à commencer par <think>, puis regardent si la balise fermante </think> apparaît dans la réponse. Elle apparaît toujours chez R1 et jamais chez V3-0324 ; cette proportion indique à quel point le modèle « ressemble à un modèle de raisonnement ».
Discussion
Presque toutes les combinaisons sont utilisables
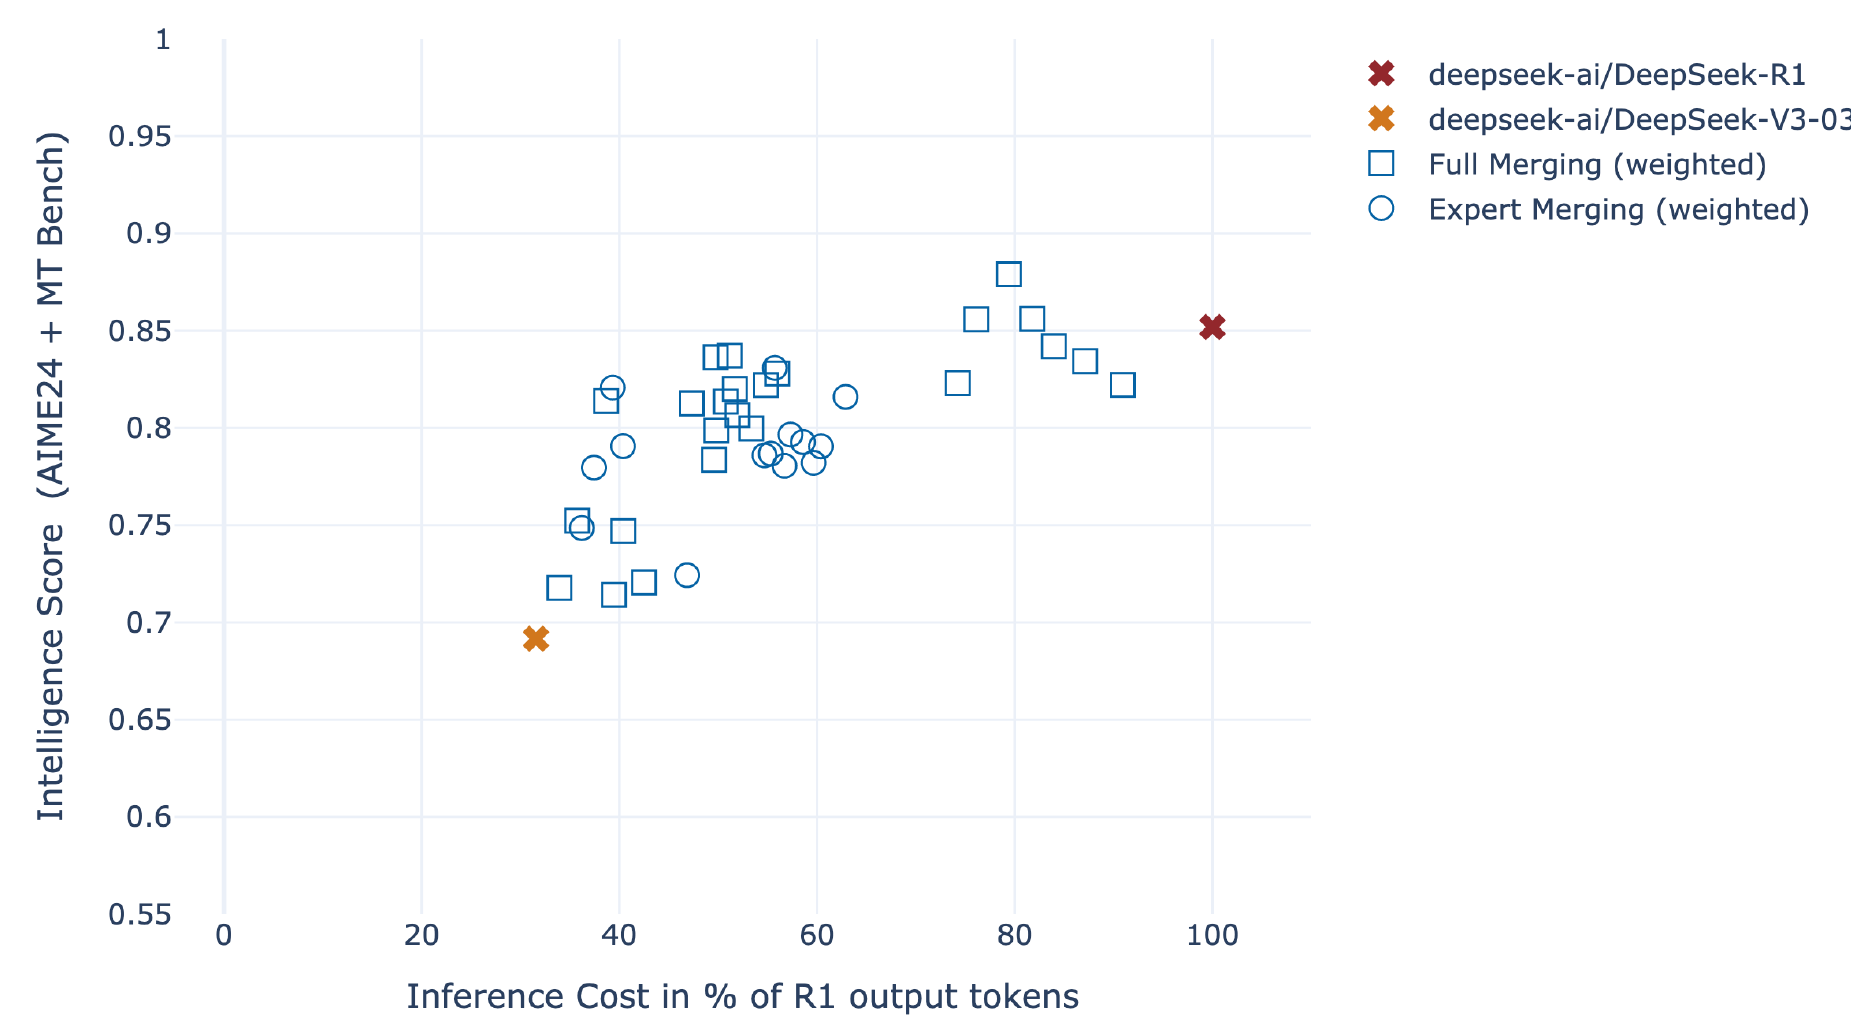
La position idéale sur ce graphique est en haut à gauche : score élevé, coût faible.
R1 est à droite, avec un score d'environ 0.85 pour un coût de 100 % ; V3-0324 est en bas à gauche, avec un score d'environ 0.69 pour un coût d'environ 31 %. Les modèles fusionnés se répartissent entre les deux, et aucun ne tombe tout en bas. Les auteurs insistent sur le fait que, dans tout l'espace de paramètres qu'ils ont exploré, aucun modèle cassé n'est apparu.
Plusieurs points se trouvent vers 50 % de coût avec un score supérieur à 0.82 : avec la moitié des tokens, ils approchent le score de R1. Un point de fusion de tous les tenseurs atteint même près de 0.88 pour un coût d'environ 80 %, plus que R1 lui-même.
Les auteurs l'expliquent par le fait que V3, V3-0324 et R1 se trouvent tous dans la même vallée de faible perte, dont les combinaisons convexes ne sortent pas. C'est cohérent avec les observations de Model Soups, à une échelle supérieure de plusieurs ordres de grandeur.
Le comportement de raisonnement apparaît brusquement
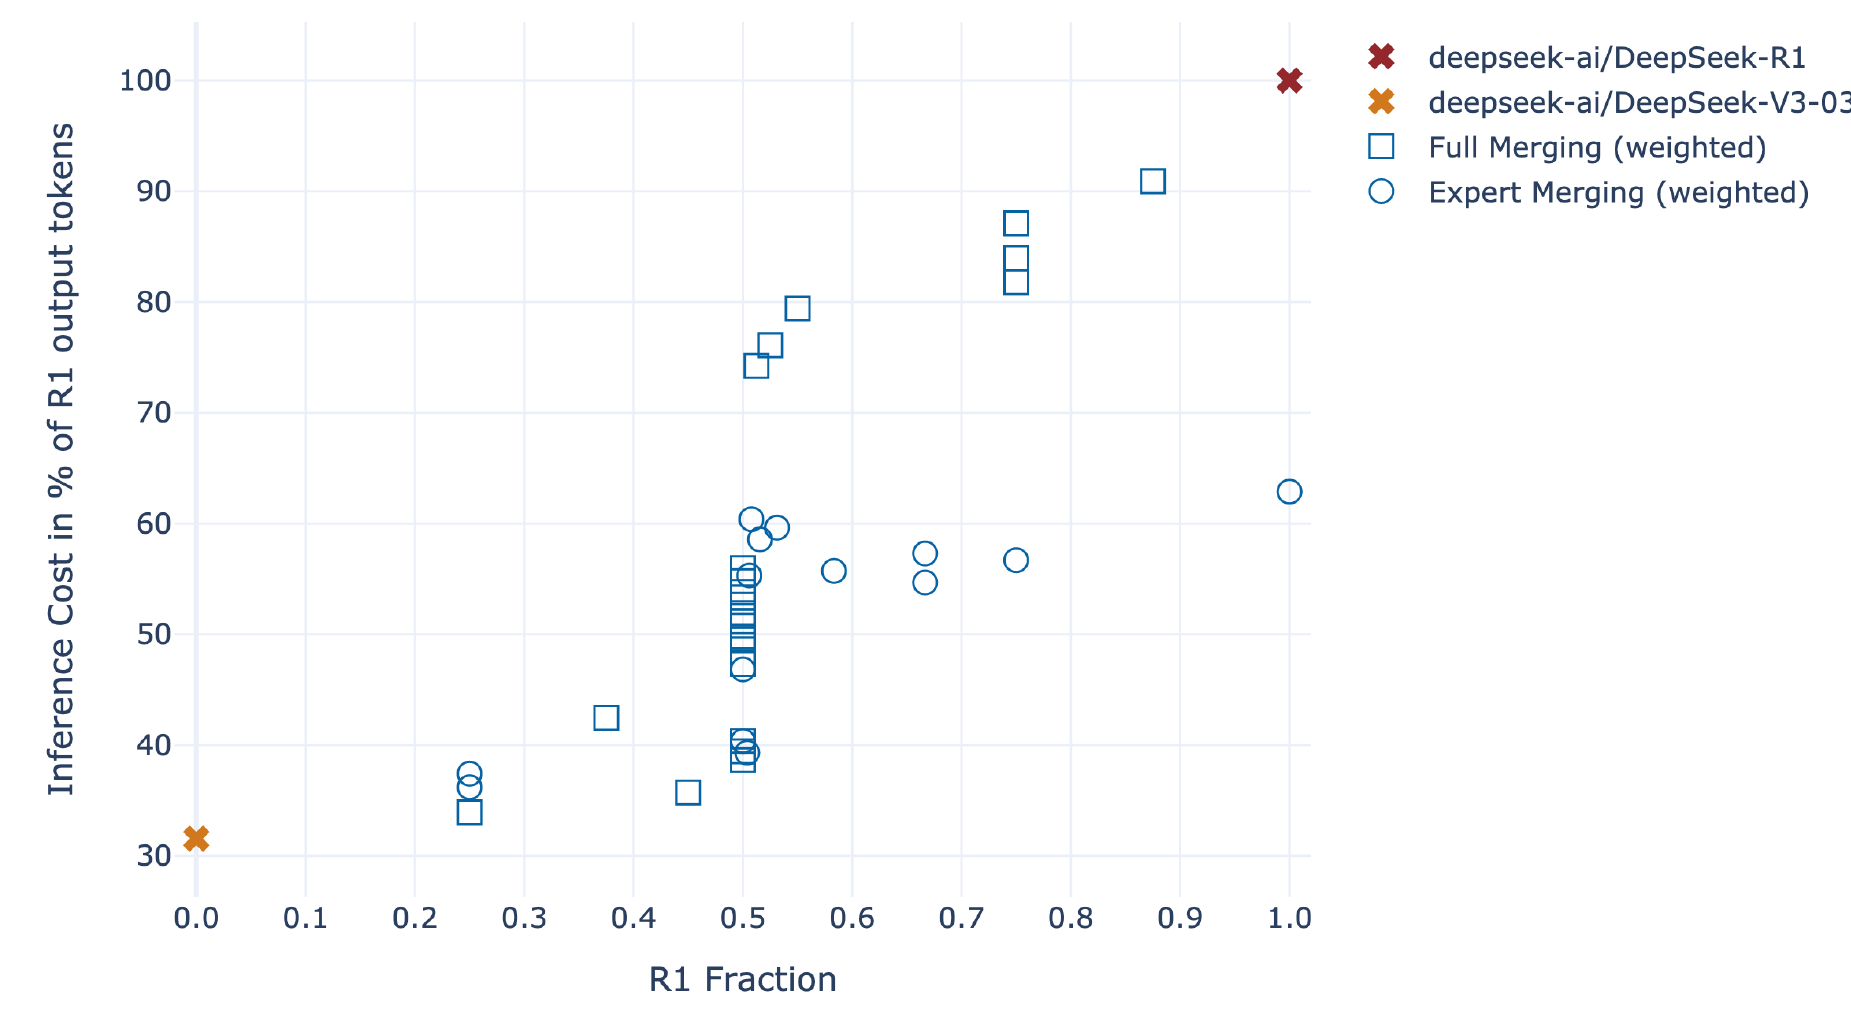
L'abscisse est la proportion de R1, . La longueur de sortie bondit brutalement vers 0.5 ; avant et après, elle est plutôt plate, et la forme rappelle une courbe en S.
La balise </think> est encore plus nette. Les modèles fusionnés dont la proportion de R1 est de 0.504 ou plus écrivent généralement un raisonnement complet terminé par </think> ; un tout petit peu en dessous, ils ne le font généralement pas. Ce point de bascule se limite à une plage très étroite autour de 0.5.
Les différentes propriétés d'un modèle fusionné ne varient donc pas de la même façon. La capacité de raisonnement générale varie en douceur avec la proportion, tandis qu'un trait de comportement comme « écrire ou non un raisonnement » se comporte comme un interrupteur : il n'apparaît qu'une fois le seuil franchi.
L'autre point important de la figure est l'écart entre les deux symboles. Fusionner seulement les experts routés (cercles) coûte globalement bien moins que fusionner tous les tenseurs (carrés). Même avec tous les experts routés remplacés par ceux de R1, le coût n'atteint qu'environ 60 % de celui de R1.
Seuil : quelles pièces comptent
Avec une fusion de tous les tenseurs à fixé, les auteurs relèvent progressivement le seuil . Avec un seuil bas, la plupart des tenseurs d'attention et d'experts routés sont fusionnés ; au-delà d'un certain niveau, la plupart des tenseurs d'experts partagés sont exclus et gardent les valeurs de V3-0324 ; plus haut encore, les tenseurs d'attention sont exclus à leur tour, et seuls les experts routés les plus différents restent fusionnés.
Le coût baisse alors continûment à mesure que le seuil monte, tandis que le score d'intelligence reste stable, jusqu'à ce que le seuil devienne assez haut pour exclure un grand nombre d'experts routés de R1 ; c'est seulement alors que le score commence à baisser.
R1T-Chimera
En rassemblant ces observations, les auteurs formulent deux hypothèses. Premièrement, la capacité de raisonnement de R1 réside principalement dans les experts routés. Deuxièmement, le reste de V3-0324, attention, experts partagés et couches denses compris, suffit à collaborer avec ces experts sans dégrader nettement les performances.
Ils essaient donc la configuration la plus extrême : fusionner seulement les experts routés, avec , c'est-à-dire des experts routés entièrement pris de R1 et tout le reste repris de V3-0324. C'est DeepSeek-R1T-Chimera.
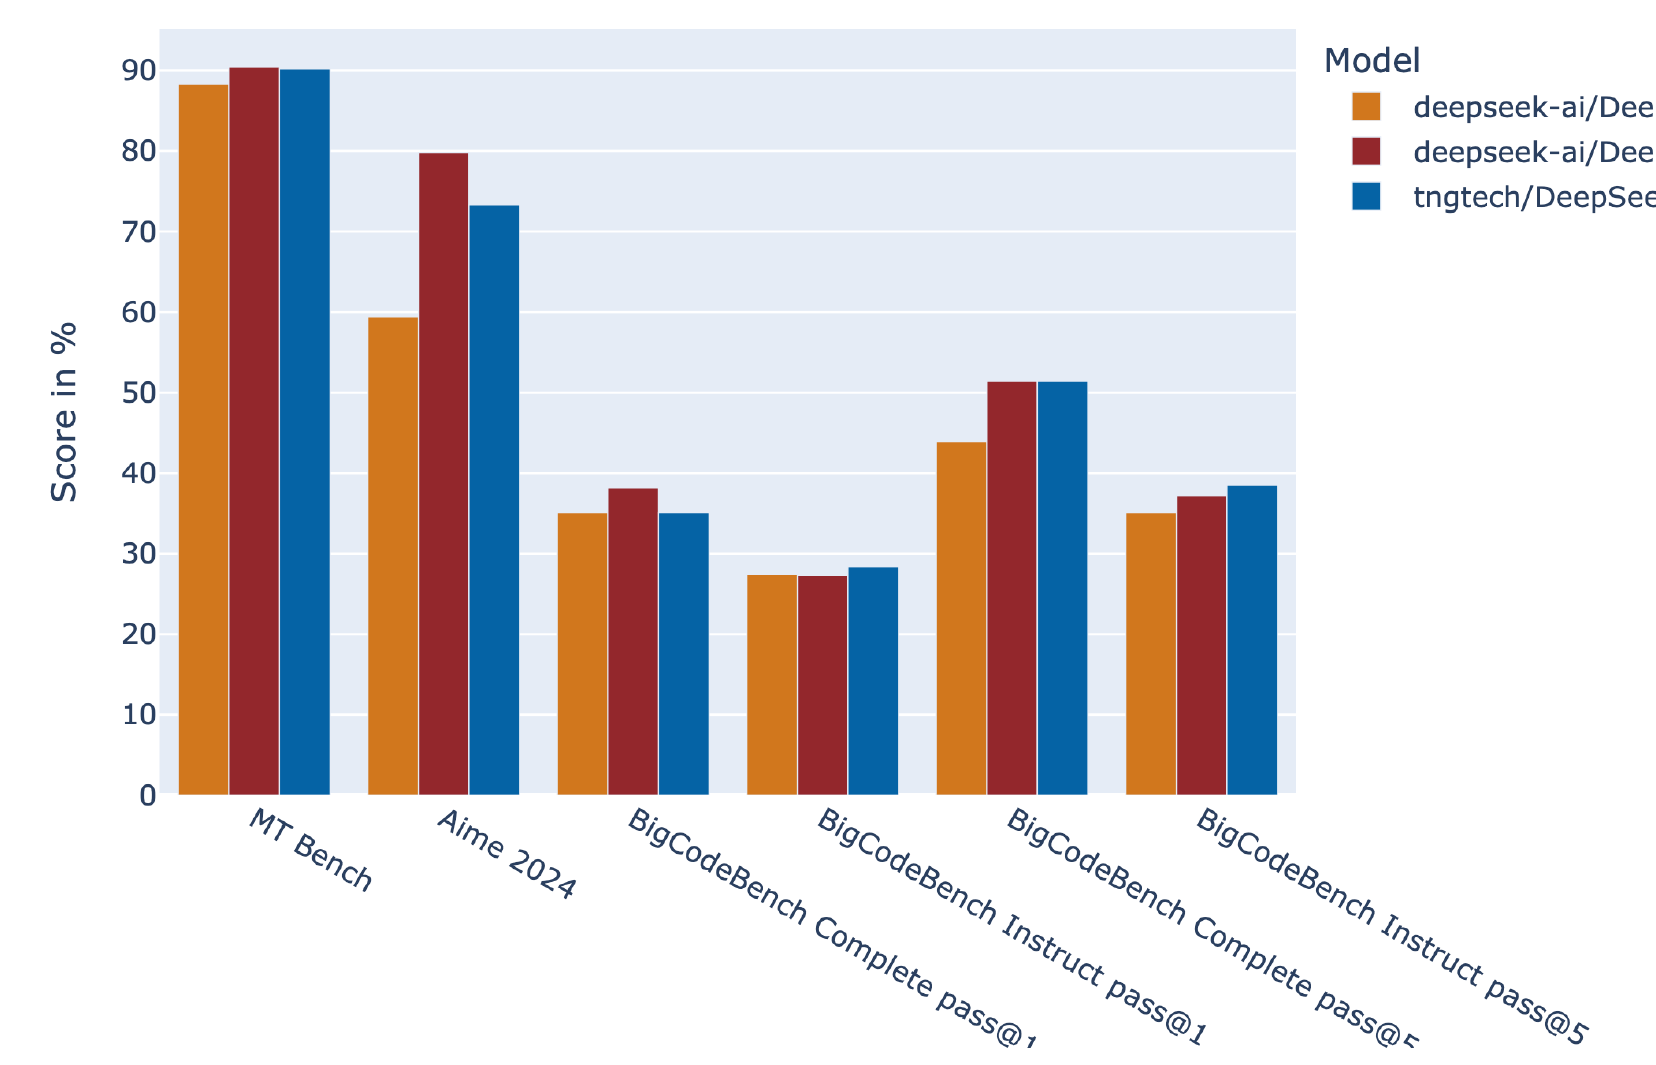
Sur MT-Bench, les trois sont presque identiques. Sur AIME 2024, Chimera obtient environ 73, bien plus que les quelque 59 de V3-0324, mais reste derrière les quelque 80 de R1. Sur les quatre sous-tâches de BigCodeBench, Chimera fait globalement jeu égal avec R1. Et les tokens de sortie diminuent d'environ 40 %.
Les auteurs jugent le raisonnement de Chimera plus concis et mieux organisé que celui de ses deux parents ; c'est une observation qualitative, que l'article ne quantifie pas.
TNG a d'abord remplacé R1 par Chimera sur son cluster GPU interne, avant de publier les poids. Selon l'article, fin mai 2025, le modèle traitait chaque jour près de 5 milliards de tokens via Chutes, une plateforme d'inférence serverless.
La portée des preuves
Le protocole expérimental de cet article est assez sommaire ; il faut garder quelques points en tête.
- Trop peu d'évaluations : toute la recherche de paramètres n'utilise que deux benchmarks, MT-Bench et AIME-2024 ; AIME-2024 ne compte que 30 problèmes, et une ou deux questions d'écart représentent plusieurs points de pourcentage ; l'article ne rapporte ni nombre de répétitions ni variance.
- Le « score d'intelligence » est un indicateur maison : moyenner directement un score de conversation noté par un modèle juge et un score de concours de mathématiques convient pour classer des modèles, mais c'est trop grossier comme mesure absolue des capacités.
- Une seule paire de parents : toutes les observations viennent de V3-0324 et R1 ; l'hypothèse « la capacité de raisonnement réside dans les experts routés » n'a pas encore été vérifiée sur d'autres familles de modèles.
Dans les travaux connexes, les auteurs mentionnent aussi que l'équipe de Kimi k1.5 a comparé les deux approches : un ajustement avec une perte pénalisant la longueur produit des modèles plus économes en tokens que la fusion de modèles de raisonnement long et court. L'avantage de la fusion est d'être bon marché, pas forcément d'être la meilleure.
En juillet 2025, TNG a publié R1T2 Chimera, avec cette fois trois parents (R1-0528, R1, V3-0324), en reprenant toujours l'attention et les couches partagées de V3-0324.
Conclusion
Cet article porte la fusion de modèles à l'échelle de 671B et, en exploitant la structure MoE, décompose la « fusion » en « choix de pièces ». En greffant les experts routés de R1 dans le corps de V3-0324, il obtient un modèle au raisonnement proche de R1, avec des sorties plus courtes de 40 %, sans aucun calcul de gradient.
Le plus intéressant reste la transition de phase observée en chemin. La capacité de raisonnement varie en douceur, mais l'habitude d'écrire un raisonnement apparaît d'un coup, dès que la proportion de R1 dépasse la moitié.
On peut démonter et échanger ainsi les pièces d'un modèle MoE, à condition que les deux modèles partent de la même base. Cousez ensemble deux MoE de familles différentes, et vous n'obtiendrez vraiment qu'un monstre recousu.