Article original
WSM: Decay-Free Learning Rate Schedule via Checkpoint Merging for LLM Pre-training
- Publication
- ICLR 2026Conférence
- Premier dépôt sur arXiv
- arXiv:2507.17634
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingwsm2025,
  title = {{WSM: Decay-Free Learning Rate Schedule via Checkpoint Merging for LLM Pre-training}},
  author = {Changxin Tian and Jiapeng Wang and Qian Zhao and Kunlong Chen and Jia Liu and Ziqi Liu and Jiaxin Mao and Wayne Xin Zhao and Zhiqiang Zhang and Jun Zhou},
  year = {2025},
  eprint = {2507.17634},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2507.17634}
}
Quand on entraîne un grand modèle de langage, le calendrier du taux d'apprentissage a toujours été un réglage pénible.
Le calendrier cosinus classique exige de savoir dès le départ combien d'étapes durera l'entraînement, sans quoi la courbe ne peut pas être tracée ; pour entraîner sur davantage de données, il faut tout recommencer. WSD (Warmup-Stable-Decay) insère au milieu une phase stable à taux constant, d'où l'on peut à tout moment bifurquer vers un recuit ; DeepSeek-V3 et ERNIE 4.5 l'ont adopté.
Mais WSD exige encore de décider bien des choses à l'avance : quand commencer le recuit, combien de tokens lui consacrer, quelle courbe de décroissance utiliser. Si l'on veut continuer l'entraînement une fois le recuit terminé, il faut revenir à l'état d'avant le recuit et tout replanifier.
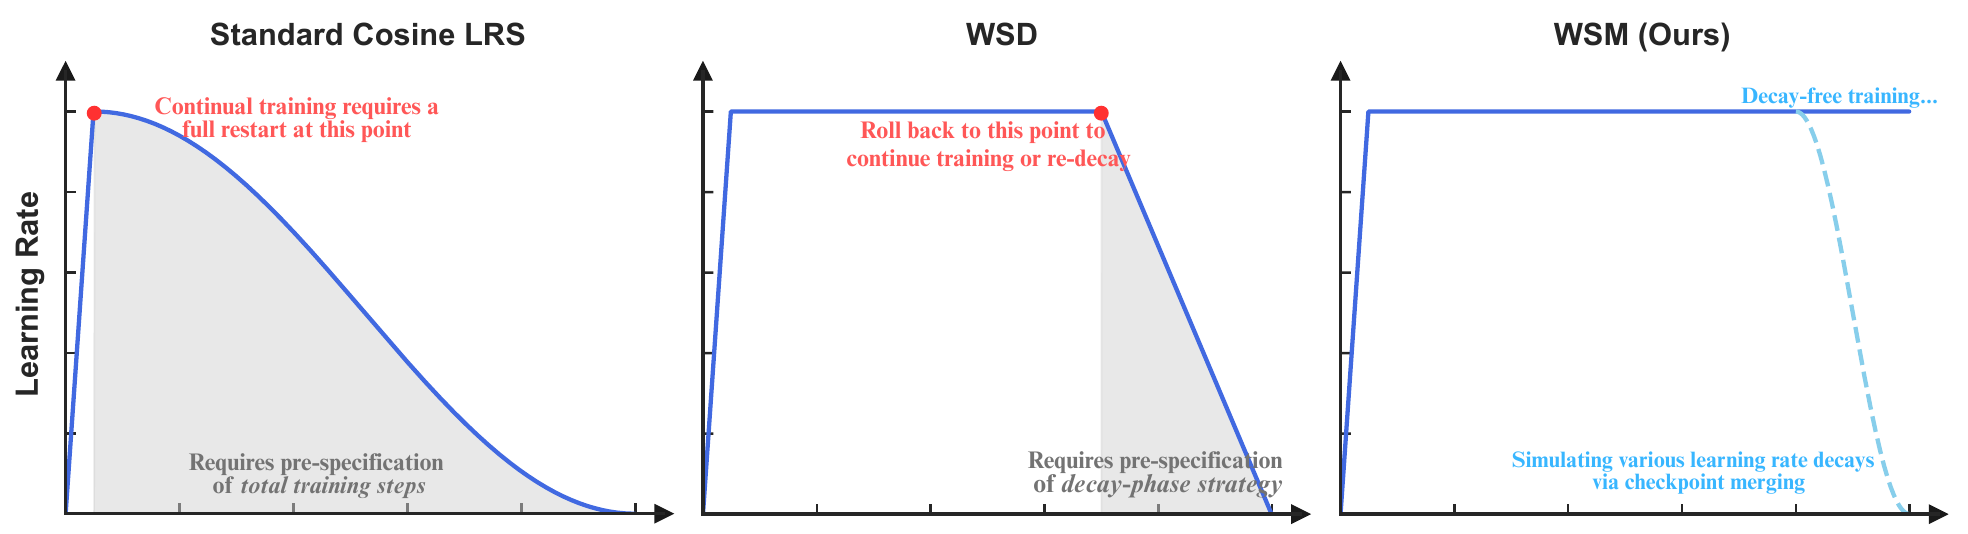
Cet article de l'équipe Ling d'Ant Group et de l'Université Renmin de Chine veut supprimer entièrement cette phase de décroissance. Après l'échauffement, le taux d'apprentissage reste constant, et l'effet du recuit est obtenu en fusionnant des checkpoints. Les auteurs appellent ce calendrier WSM (Warmup-Stable and Merge).
Définir le problème
À la même époque, PMA, de ByteDance Seed, avait déjà constaté que moyenner des checkpoints pendant la phase à taux constant donnait des scores proches de ceux du modèle après recuit, voire équivalents.
Mais le lien entre « moyenne » et « recuit » n'avait jamais été clairement établi. Quel poids donner à chaque checkpoint dans la moyenne ? À quel recuit correspondent la moyenne à poids égaux et la moyenne mobile exponentielle ? Si l'on pouvait écrire cette relation sous forme de formule, on pourrait simuler par fusion n'importe quelle courbe de décroissance réputée efficace.
Résoudre le problème
Écrire la fusion comme une décroissance
Soient checkpoints enregistrés successivement, ; le modèle fusionné est
Cette expression ne laisse voir aucun lien avec le taux d'apprentissage. Les auteurs la réécrivent en exprimant chaque checkpoint comme « point de départ plus mises à jour ultérieures ». Soit la mise à jour de l'étape (déjà multipliée par le taux d'apprentissage), avec ; alors
On substitue dans l'expression de la fusion et l'on inverse l'ordre des deux sommes. La -ème mise à jour apparaît dans tous les checkpoints , donc
où .
Le résultat est très intuitif. Fusionner des checkpoints revient à partir de et à rajouter chaque mise à jour suivante multipliée par un coefficient . Comme est la somme cumulée de la queue des , il décroît forcément avec : c'est exactement une courbe de décroissance du taux d'apprentissage.
L'inverse fonctionne aussi. Pour une courbe de décroissance voulue , les poids de checkpoint correspondants sont déterminés de façon unique :
C'est le théorème 3.1 de l'article.
Faisons le calcul
Parcourons les deux sens sur un petit exemple. D'abord, à quelle décroissance correspond la moyenne à poids égaux de 5 checkpoints ; puis, à l'inverse, quels poids il faut pour une décroissance 1-sqrt ; enfin, vérifions que les deux côtés donnent bien le même résultat.
import numpy as np

def merge_weights_from_decay(w):
    """Théorème 3.1 : déduire les poids de checkpoint c_0..c_k des coefficients de décroissance w_1..w_k."""
    k = len(w)
    c = np.zeros(k + 1)
    c[k] = w[-1]
    for j in range(1, k):
        c[j] = w[j - 1] - w[j]
    c[0] = 1 - w[0]
    return c

rng = np.random.default_rng(0)
k = 4
theta_n = rng.normal(size=3)
g = rng.normal(size=(k, 3)) * 0.1            # k mises à jour à taux d'apprentissage constant
ckpts = [theta_n - g[:j].sum(0) for j in range(k + 1)]   # θ_n, θ_{n+1}, ..., θ_{n+k}

# 1) À quelle décroissance correspond la moyenne des 5 derniers checkpoints ?
c_mean = np.full(k + 1, 1 / (k + 1))
w_equiv = [c_mean[i:].sum() for i in range(1, k + 1)]
print("Moyenne de 5 checkpoints → facteur effectif de chaque mise à jour :", np.round(w_equiv, 2))

# 2) Pour une décroissance 1-sqrt, quels poids donner aux checkpoints ?
t = np.arange(1, k + 1) / (k + 1)
w_sqrt = 1 - np.sqrt(t)
c_sqrt = merge_weights_from_decay(w_sqrt)
print("Facteurs de la décroissance 1-sqrt :", np.round(w_sqrt, 3))
print("Poids de checkpoint correspondants :", np.round(c_sqrt, 3), " somme", round(c_sqrt.sum(), 6))

merged = sum(cj * th for cj, th in zip(c_sqrt, ckpts))
decayed = theta_n - (w_sqrt[:, None] * g).sum(0)
print("Écart maximal entre fusion et décroissance :", np.abs(merged - decayed).max())
Moyenne de 5 checkpoints → facteur effectif de chaque mise à jour : [0.8 0.6 0.4 0.2]
Facteurs de la décroissance 1-sqrt : [0.553 0.368 0.225 0.106]
Poids de checkpoint correspondants : [0.447 0.185 0.142 0.12  0.106]  somme 1.0
Écart maximal entre fusion et décroissance : 1.3877787807814457e-17
La première ligne montre que la moyenne à poids égaux de 5 checkpoints revient à multiplier les 4 mises à jour suivantes par 0.8, 0.6, 0.4 et 0.2 respectivement, soit une décroissance linéaire. La troisième ligne donne le résultat du calcul inverse. Pour simuler une décroissance 1-sqrt, le plus ancien checkpoint doit recevoir le plus grand poids, 0.447, puis les poids décroissent. L'écart de la dernière ligne reste dans l'erreur des nombres à virgule flottante : les deux calculs donnent les mêmes paramètres.
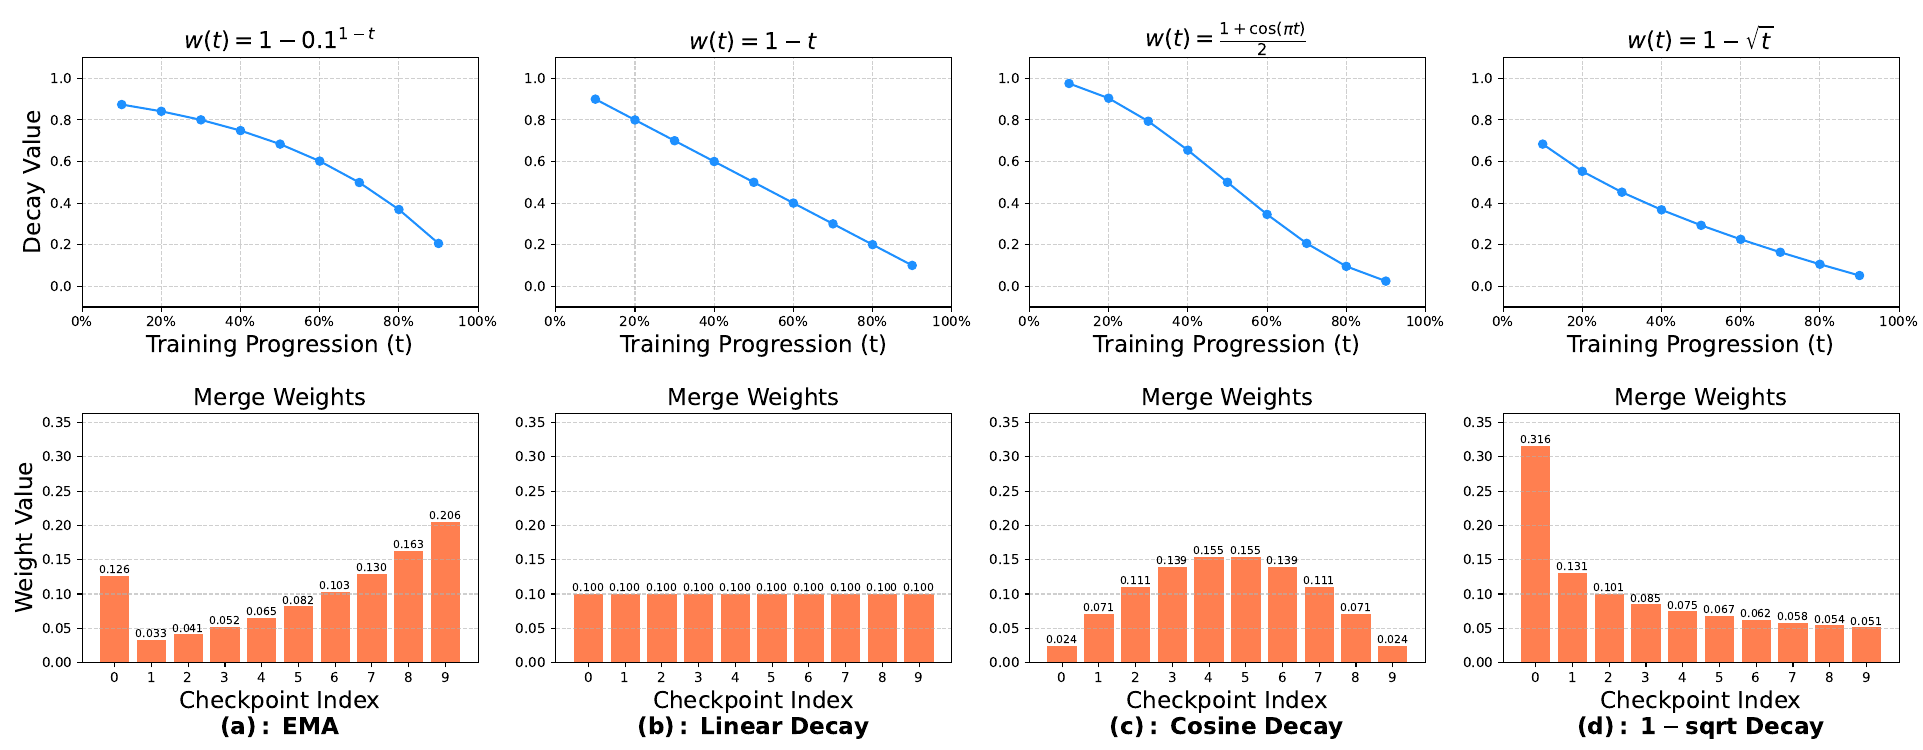
L'article convertit en courbes de décroissance quatre manières courantes de fusionner. La plus intéressante est l'EMA. L'EMA donne plus de poids aux checkpoints récents, ce qui paraît raisonnable ; pourtant, une fois convertie, elle donne une courbe de décroissance convexe, presque plate au début et qui ne plonge qu'à la toute fin.
Le déroulement de WSM
Grâce à cette correspondance, WSM se déroule en trois étapes.
- Échauffement jusqu'au taux d'apprentissage maximal, puis maintien constant.
- À un moment donné de l'entraînement, on peut passer à des données de haute qualité soigneusement sélectionnées, comme les « données de recuit » habituelles.
- Un checkpoint est enregistré à intervalle fixe de tokens ; un autre processus, asynchrone, prend en continu les derniers checkpoints, calcule les poids selon la courbe de décroissance à simuler et les fusionne.
L'entraînement lui-même n'est jamais interrompu, et le modèle fusionné peut à tout moment être évalué ou livré.
Les auteurs comparent aussi fusion hors ligne et fusion en ligne. La fusion hors ligne, qui conserve tous les checkpoints, permet d'essayer après coup différentes courbes de décroissance et tailles de fenêtre ; une fois le meilleur réglage trouvé, on peut passer à la version en ligne, qui ne garde que les derniers checkpoints. Le coût principal est l'espace de stockage ; dans les expériences des auteurs, suffit déjà.
Discussion
Dispositif expérimental
Le modèle est Ling-mini, un MoE de 16.3B paramètres au total et 1.4B paramètres actifs. L'architecture compte 1 couche dense et 19 couches MoE ; chaque couche choisit 8 experts parmi 256, plus 1 expert partagé. L'optimiseur est AdamW, avec un taux d'apprentissage maximal de 4.78e-4 et une taille de lot de 2048.
Le point de départ est un checkpoint entraîné à taux constant sur 10.2T tokens, dont 10T de longueur ordinaire et 200B de données de long contexte. À partir de là, on passe à des données de recuit de haute qualité, sur deux branches entraînées chacune sur 400B tokens :
- WSD : décroissance habituelle du taux d'apprentissage.
- WSM : taux maintenu constant, un checkpoint tous les 25B tokens, et fusion à poids égaux des plus récents.
Mieux que WSD
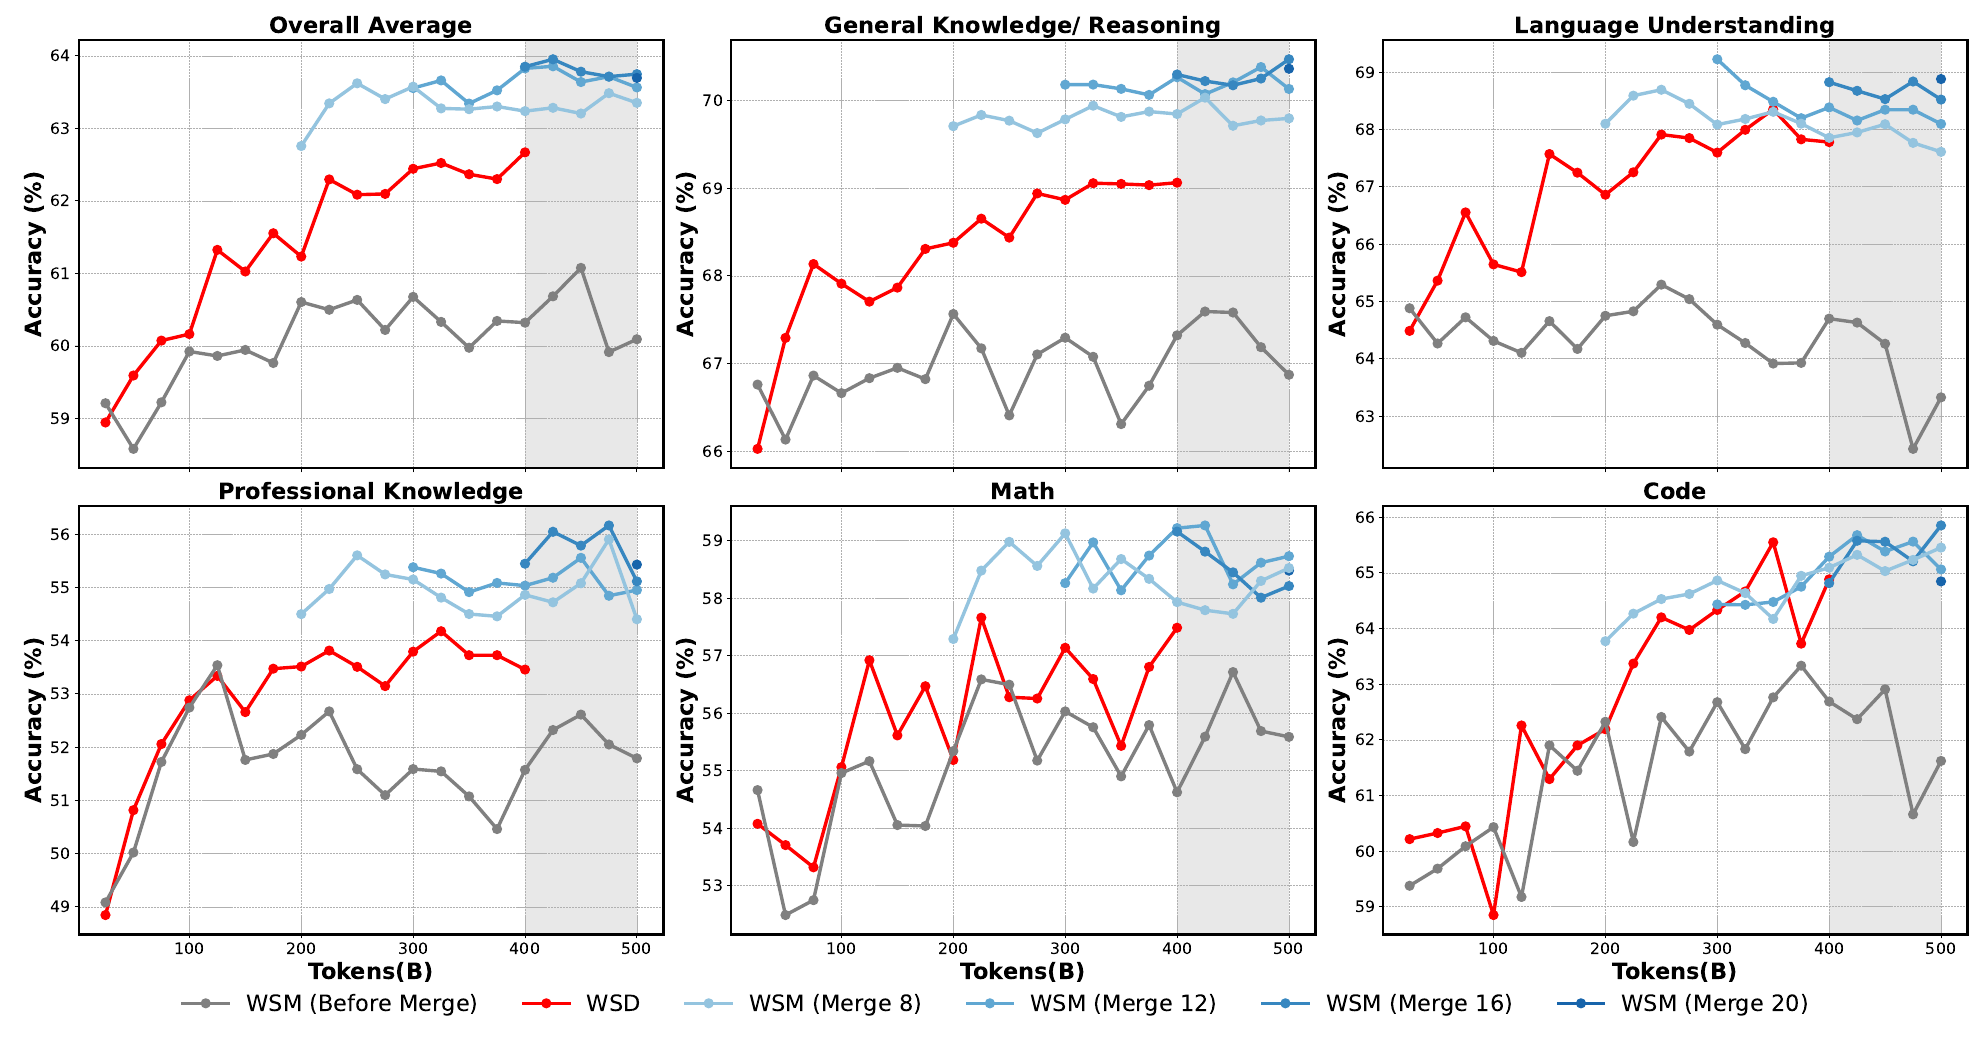
Regardons d'abord les lignes grises et bleues. La ligne grise, ce sont les checkpoints à taux constant non fusionnés, dont le score reste bloqué en bas ; après fusion, la ligne bleue passe d'un coup au-dessus de la rouge. Dans le graphique de la moyenne globale, le WSD rouge atteint environ 62.7 à 400B, et les lignes bleues se situent le plus souvent entre 63 et 64.
La zone grise au-delà de 400B montre un autre avantage de WSM. La décroissance de WSD se termine à 400B, et poursuivre l'entraînement demande de tout replanifier ; le taux de WSM n'ayant jamais baissé, on peut continuer directement.
En comparant les meilleurs checkpoints de chaque côté, WSM a 1.3 point d'avance en moyenne. Mathématiques, code et connaissances spécialisées progressent ; parmi les benchmarks individuels, MATH gagne 2.7 points, HumanEval 2.4 et MMLU-Pro 2.1.
L'avantage persiste après SFT. Les deux modèles de base passent par 5 époques de SFT dans les mêmes conditions ; la moyenne globale de WSM est de 64.07, contre 62.90 pour WSD, mais le code fait exception, WSM y étant même 0.28 point en dessous.
Prédire le recuit à tout moment
Les auteurs comparent aussi, tout au long du préentraînement, à 2T, 4T, 6T, 8T et 10T tokens. D'un côté, un vrai recuit sur 100B tokens ; de l'autre, la moyenne de 4 checkpoints pris au cours de ces mêmes 100B tokens.
Cette fois, les données sont celles du préentraînement ordinaire, et non des données de recuit de haute qualité ; l'avantage de WSM est moins marqué, mais les deux scores restent très proches tout du long. WSM peut donc aussi servir à estimer « ce que donnerait le recuit », sans ouvrir chaque fois une branche de recuit.
Quel facteur compte le plus
Méthode de fusion. En comparant les poids qui simulent une décroissance 1-sqrt, la moyenne à poids égaux et l'EMA, on obtient des moyennes globales de 64.06, 63.95 et 63.01, toutes au-dessus des 62.67 de WSD. 1-sqrt devance légèrement la moyenne à poids égaux, et l'EMA est nettement la moins bonne.
Cela concorde avec l'expérience du recuit. Dans leurs expériences WSD, les auteurs constatent aussi que la courbe concave 1-sqrt et la courbe linéaire font mieux que les courbes convexes. Or l'EMA correspond justement à une décroissance convexe.
Durée de fusion. Plus la fenêtre de fusion couvre de tokens, meilleurs sont les résultats, mais les gains s'amenuisent. C'est là encore comme pour le recuit : passé un certain point, ajouter des données de recuit n'apporte plus grand-chose. Pour l'EMA, en revanche, aucun effet de la taille de fenêtre n'est visible.
Granularité de fusion. À durée de fusion fixée à 80B tokens, on compare les intervalles de sauvegarde : un checkpoint tous les 5B avec 16 fusionnés, tous les 10B avec 8, tous les 20B avec 4, tous les 40B avec 2 ; les moyennes globales sont respectivement de 63.63, 63.78, 63.36 et 62.77, contre 60.33 avec un seul checkpoint. Plus la granularité est fine, plus on approche une courbe de décroissance continue, mais les écarts sont bien plus faibles que ceux dus à la durée.
Les auteurs en concluent que la durée de fusion est le facteur le plus important, plus influent que l'intervalle de sauvegarde ou le nombre de checkpoints fusionnés.
Fusion plus décroissance : pas de bonus
Puisque la fusion simule la décroissance, peut-on cumuler les deux ? Les auteurs ont essayé d'appliquer la décroissance puis de fusionner, et l'inverse, sans gain supplémentaire. Le modèle fusionné avant la décroissance est meilleur au début, mais les deux finissent à égalité.
Selon les auteurs, fusion et décroissance sont deux chemins vers le même but : elles peuvent se remplacer l'une l'autre, mais ne se cumulent pas.
Un effet secondaire sur les MoE
Une dernière observation concerne l'équilibrage de charge des MoE. Dans le modèle WSM, les écarts de charge entre experts sont nettement plus faibles : l'écart maximal passe de 0.601 à 0.545 et l'écart minimal de 0.322 à 0.201 ; mais la perte de modèle de langage est un peu plus élevée, 0.697 contre 0.675. La fusion répartit plus uniformément l'utilisation des experts, au prix d'une perte un peu moins bonne ; l'article ne démêle pas davantage l'effet de ces deux facteurs sur les scores en aval.
La portée des preuves
Les expériences principales portent sur un seul MoE de 16B, partant d'un checkpoint déjà entraîné sur 10.2T tokens. Le WSD de référence utilise la décroissance 1-sqrt, la meilleure de celles que les auteurs comparent en annexe, ce qui rend la comparaison plus équitable ; mais il n'y a qu'une seule longueur de recuit, 400B tokens, et l'article ne dit pas si l'écart resterait aussi grand avec d'autres longueurs. Les +3.5 % sur MATH et +5.5 % sur MMLU-Pro du résumé relèvent d'un autre mode de calcul relatif ; en points de pourcentage, ce sont les 2.7 et 2.1 du texte principal.
Le rapport technique de Ling 2.0, publié ensuite par l'équipe Ling, adopte lui aussi le calendrier WSM.
Conclusion
Par une dérivation qui inverse l'ordre de deux sommes, WSM relie la fusion de checkpoints et la décroissance du taux d'apprentissage. La somme cumulée de la queue des poids de fusion donne les coefficients de décroissance ; inversement, toute courbe de décroissance monotone permet de calculer des poids de fusion.
En pratique, le taux d'apprentissage n'est plus touché après l'échauffement, et le recuit est confié à la fusion. L'entraînement peut se prolonger sans fin, on peut obtenir à tout moment un modèle « après recuit », et dans les expériences des auteurs, ce modèle fait même un peu mieux que WSD.
Ne vous précipitez pas sur l'EMA. Elle semble la plus commode, mais une fois convertie, c'est la courbe convexe qui donne les moins bons résultats.