Article original
Command A: An Enterprise-Ready Large Language Model
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2504.00698
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformerscommanda2025,
  title = {{Command A: An Enterprise-Ready Large Language Model}},
  author = {Team Cohere and Aakanksha and Arash Ahmadian and Marwan Ahmed and Jay Alammar and Milad Alizadeh and Yazeed Alnumay and Sophia Althammer and Arkady Arkhangorodsky and Viraat Aryabumi and Dennis Aumiller and Raphaël Avalos and Zahara Aviv and Sammie Bae and Saurabh Baji and Alexandre Barbet and Max Bartolo and Björn Bebensee and Neeral Beladia and Walter Beller-Morales and Alexandre Bérard and Andrew Berneshawi and Anna Bialas and Phil Blunsom and Matt Bobkin and Adi Bongale and Sam Braun and Maxime Brunet and Samuel Cahyawijaya and David Cairuz and Jon Ander Campos and Cassie Cao and Kris Cao and Roman Castagné and Julián Cendrero and Leila Chan Currie and Yash Chandak and Diane Chang and Giannis Chatziveroglou and Hongyu Chen and Claire Cheng and Alexis Chevalier and Justin T. Chiu and Eugene Cho and Eugene Choi and Eujeong Choi and Tim Chung and Volkan Cirik and Ana Cismaru and Pierre Clavier and Henry Conklin and Lucas Crawhall-Stein and Devon Crouse and Andres Felipe Cruz-Salinas and Ben Cyrus and Daniel D'souza and Hugo Dalla-Torre and John Dang and William Darling and Omar Darwiche Domingues and Saurabh Dash and Antoine Debugne and Théo Dehaze and Shaan Desai and Joan Devassy and Rishit Dholakia and Kyle Duffy and Ali Edalati and Ace Eldeib and Abdullah Elkady and Sarah Elsharkawy and Irem Ergün and Beyza Ermis and Marzieh Fadaee and Boyu Fan and Lucas Fayoux and Yannis Flet-Berliac and Nick Frosst and Matthias Gallé and Wojciech Galuba and Utsav Garg and Matthieu Geist and Mohammad Gheshlaghi Azar and Ellen Gilsenan-McMahon and Seraphina Goldfarb-Tarrant and Tomas Goldsack and Aidan Gomez and Victor Machado Gonzaga and Nithya Govindarajan and Manoj Govindassamy and Nathan Grinsztajn and Nikolas Gritsch and Patrick Gu and Shangmin Guo and Kilian Haefeli and Rod Hajjar and Tim Hawes and Jingyi He and Sebastian Hofstätter and Sungjin Hong and Sara Hooker and Tom Hosking and Stephanie Howe and Eric Hu and Renjie Huang and Hemant Jain and Ritika Jain and Nick Jakobi and Madeline Jenkins and JJ Jordan and Dhruti Joshi and Jason Jung and Trushant Kalyanpur and Siddhartha Rao Kamalakara and Julia Kedrzycki and Gokce Keskin and Edward Kim and Joon Kim and Wei-Yin Ko and Tom Kocmi and Michael Kozakov and Wojciech Kryściński and Arnav Kumar Jain and Komal Kumar Teru and Sander Land and Michael Lasby and Olivia Lasche and Justin Lee and Patrick Lewis and Jeffrey Li and Jonathan Li and Hangyu Lin and Acyr Locatelli and Kevin Luong and Raymond Ma and Lukáš Mach and Marina Machado and Joanne Magbitang and Brenda Malacara Lopez and Aryan Mann and Kelly Marchisio and Olivia Markham and Alexandre Matton and Alex McKinney and Dominic McLoughlin and Jozef Mokry and Adrien Morisot and Autumn Moulder and Harry Moynehan and Maximilian Mozes and Vivek Muppalla and Lidiya Murakhovska and Hemangani Nagarajan and Alekhya Nandula and Hisham Nasir and Shauna Nehra and Josh Netto-Rosen and Daniel Ohashi and James Owers-Bardsley and Jason Ozuzu and Dennis Padilla and Gloria Park and Sam Passaglia and Jeremy Pekmez and Laura Penstone and Aleksandra Piktus and Case Ploeg and Andrew Poulton and Youran Qi and Shubha Raghvendra and Miguel Ramos and Ekagra Ranjan and Pierre Richemond and Cécile Robert-Michon and Aurélien Rodriguez and Sudip Roy and Sebastian Ruder and Laura Ruis and Louise Rust and Anubhav Sachan and Alejandro Salamanca and Kailash Karthik Saravanakumar and Isha Satyakam and Alice Schoenauer Sebag and Priyanka Sen and Sholeh Sepehri and Preethi Seshadri and Ye Shen and Tom Sherborne and Sylvie Shang Shi and Sanal Shivaprasad and Vladyslav Shmyhlo and Anirudh Shrinivason and Inna Shteinbuk and Amir Shukayev and Mathieu Simard and Ella Snyder and Ava Spataru and Victoria Spooner and Trisha Starostina and Florian Strub and Yixuan Su and Jimin Sun and Dwarak Talupuru and Eugene Tarassov and Elena Tommasone and Jennifer Tracey and Billy Trend and Evren Tumer and Ahmet Üstün and Bharat Venkitesh and David Venuto and Pat Verga and Maxime Voisin and Alex Wang and Donglu Wang and Shijian Wang and Edmond Wen and Naomi White and Jesse Willman and Marysia Winkels and Chen Xia and Jessica Xie and Minjie Xu and Bowen Yang and Tan Yi-Chern and Ivan Zhang and Zhenyu Zhao and Zhoujie Zhao},
  year = {2025},
  eprint = {2504.00698},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2504.00698}
}
Cohere est une entreprise canadienne de modèles de langage tournée surtout vers les clients professionnels ; l'un de ses cofondateurs, Aidan Gomez, est coauteur de « Attention Is All You Need ». Ses modèles misent sur la génération augmentée par la recherche (RAG), l'utilisation d'outils et le multilinguisme. Ils ne visent généralement pas la première place des classements de conversation, et mettent plutôt en avant leur utilité et leur facilité de déploiement dans les situations réelles des entreprises.
En mars 2025, Cohere publie Command A, un modèle de 111 milliards de paramètres qui prend en charge 23 langues commerciales et se déploie sur seulement deux A100 ou H100. Les poids sont publiés sous licence non commerciale (CC-BY-NC), pour la recherche.
Ce rapport technique se concentre sur le pipeline de post-entraînement. La pratique habituelle consiste à faire passer un modèle successivement par SFT, apprentissage des préférences et apprentissage par renforcement ; avec Command A, plusieurs équipes entraînent chacune de leur côté des modèles experts spécialisés dans différentes capacités, qui sont ensuite réunis en un seul par fusion de modèles. Selon le rapport, c'est la première fois que la fusion de modèles est placée au cœur du post-entraînement à cette échelle.
Définir le problème
Un modèle de langage pour l'entreprise doit faire beaucoup de choses à la fois : répondre à des questions à partir de documents, appeler des outils, écrire du code, faire des mathématiques, parler plusieurs langues, respecter des règles de sécurité, et gérer en plus des contextes très longs.
Ces capacités s'entraînent de façons très différentes. Le code et les mathématiques se vérifient facilement : on peut synthétiser beaucoup de données et faire de l'apprentissage par renforcement à récompenses vérifiables. La sécurité et le RAG dépendent plutôt d'annotations humaines, avec bien moins de données, et se prêtent mieux à un entraînement par comparaison de préférences. Mélanger toutes ces données et entraîner un seul modèle avec un seul jeu d'hyperparamètres permet difficilement d'atteindre le meilleur niveau sur chaque point.
L'organisation pose le même problème. Quand plusieurs équipes améliorent en parallèle des capacités différentes, si elles travaillent toutes sur le même modèle, leurs expériences interfèrent et chacune doit attendre les autres.
Peut-on entraîner chaque capacité au mieux de son côté, puis les réunir à peu de frais ? C'est la question à laquelle tout le rapport veut répondre.
Résoudre le problème
Architecture et préentraînement
Jetons d'abord un coup d'œil rapide à la base. Command A est un Transformer décodeur seul, avec trois choix de conception principaux.
- Couches d'attention entrelacées : sur 4 couches, 3 utilisent une attention à fenêtre glissante et 1 une attention complète, soit un rapport de 3:1. Les couches à fenêtre glissante utilisent RoPE ; les couches d'attention complète n'ont aucun encodage de position (NoPE).
- Blocs Transformer parallèles : l'attention et le réseau feed-forward sont calculés en parallèle plutôt qu'en série. Selon les auteurs, les performances sont équivalentes et le débit nettement meilleur.
- Autres : GQA, SwiGLU, pas de termes de biais, matrice d'embedding partagée entre entrée et sortie. Le vocabulaire compte 255 000 tokens ; partager l'embedding économise beaucoup de mémoire.
Les hyperparamètres sont réglés sur de petits modèles avec µP, puis transférés directement au grand modèle. Les principales multiplications matricielles sont calculées en FP8 ; les auteurs n'observent pas d'instabilité, mais un entraînement entièrement en FP8 dégrade légèrement les performances en aval, d'où une première période en BF16 avant de passer au FP8. Le préentraînement se termine par une phase de refroidissement, où le taux d'apprentissage descend de à en 50 000 étapes ; le contexte reste d'abord à 8K, puis passe progressivement à 32K, 128K et 256K.
Post-entraînement : deux fusions
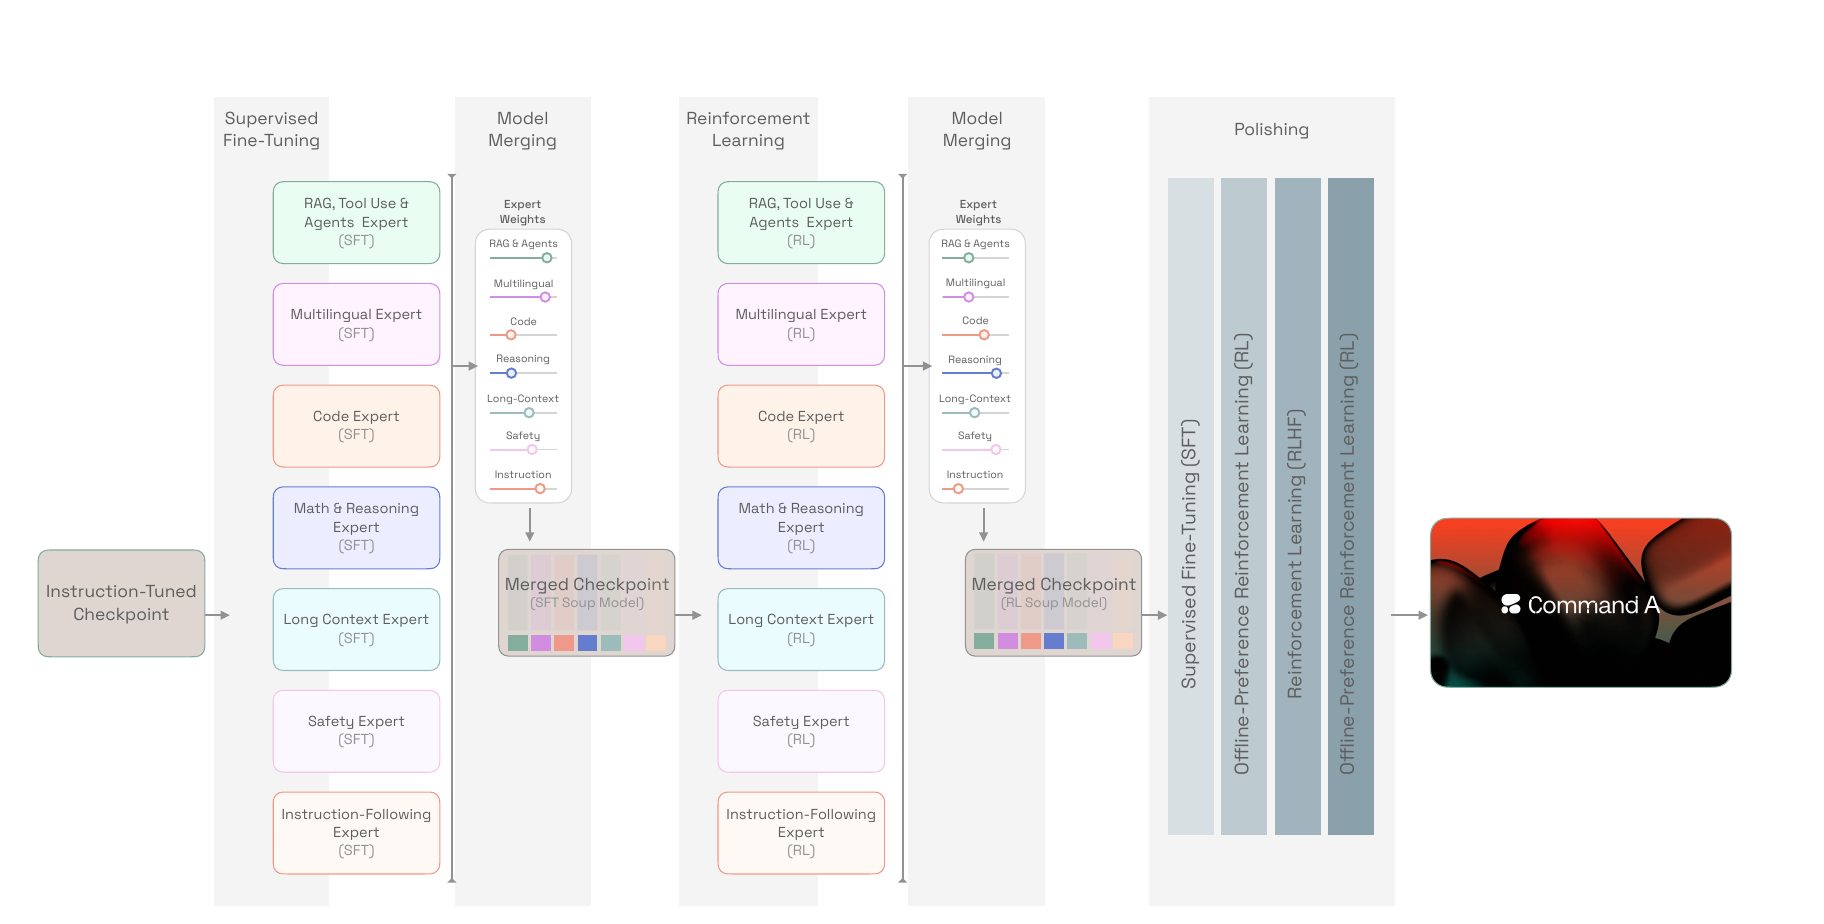
Ce schéma se lit de gauche à droite.
- Modèle d'instructions : un premier SFT sur le modèle préentraîné donne un modèle d'instructions doté des capacités de base.
- Experts SFT : à partir de ce même modèle d'instructions, plusieurs experts sont entraînés en parallèle, chacun avec son propre mélange de données et ses propres hyperparamètres. Le texte du rapport en liste six : code, sécurité, RAG, mathématiques, multilingue, et capacités générales avec long contexte.
- SFT Soup : ces experts sont fusionnés en un seul modèle.
- Experts RL : à partir de la SFT Soup, on entraîne en parallèle un groupe d'experts par apprentissage par renforcement, chaque domaine avec la méthode qui lui convient : récompenses vérifiables pour les mathématiques et le code, comparaison de préférences pour la sécurité et le multilingue.
- RL Soup : on fusionne une nouvelle fois.
- Polissage : un dernier tour d'alignement global corrige les problèmes laissés par la fusion et rapproche le style d'ensemble des préférences humaines.
Les deux cases « Model Merging » du schéma montrent une rangée de curseurs : le poids de chaque expert dans la fusion est réglable. C'est la clé de tout le pipeline. Si une capacité se révèle insuffisante après la fusion, inutile de réentraîner ; il suffit d'ajuster les curseurs et de refusionner.
Quatre usages de la fusion
Le rapport distingue quatre usages de la fusion de modèles, et Command A les emploie tous :
- Fusion d'experts : réunir en un seul des modèles forts dans des capacités différentes. C'est l'usage principal.
- Moyenne de Polyak : moyenner plusieurs checkpoints d'un même entraînement pour réduire le bruit du gradient stochastique.
- Fusion de graines : moyenner des modèles entraînés avec différentes graines aléatoires, pour réduire la part de hasard.
- Interpolation pour récupérer des capacités : les experts ne sont entraînés qu'en contexte court, et leur capacité de long contexte se dégrade. Interpoler entre l'expert et le modèle de base d'origine permet de récupérer l'essentiel de la capacité de long contexte tout en gardant les nouvelles capacités de l'expert. Les auteurs notent que c'est très proche de WARP, de Google DeepMind.
Une fusion linéaire suffit
La fusion d'experts utilise une moyenne linéaire :
Les auteurs ont essayé SLERP et l'arithmétique des tâches, sans progrès net, mais avec une complexité accrue. La fusion linéaire a en outre une propriété pratique : elle est associative. Une fusion de fusions peut toujours s'écrire comme une seule fusion, ce qui rend tout le pipeline plus facile à suivre.
Les poids sont cherchés manuellement. Augmenter le poids d'un expert améliore en gros les performances de son domaine ; la relation est intuitive. Mais comme la somme des poids doit valoir 1, les autres domaines perdent mécaniquement du poids, et l'ampleur de leur baisse est difficile à prévoir. La recherche des auteurs combine deux approches : augmenter le poids de l'expert d'un domaine insuffisant ; puis, autour du candidat courant, perturber légèrement le poids de chaque expert et chercher par force brute.
Tout le processus suit 500 indicateurs d'évaluation. Selon les auteurs, avec un développement centralisé classique, il serait bien plus difficile de veiller à autant d'indicateurs en même temps.
La cohérence compte plus que l'optimum
La réussite de la fusion dépend en grande partie de la « compatibilité » entre experts. Les auteurs résument quelques leçons d'expérience :
Tous les experts partent du même modèle d'instructions. Une première raison tient aux tokens spéciaux. Certains experts utilisent des tokens spéciaux, par exemple pour les appels d'outils, que d'autres n'utilisent pas ; chez ces derniers, l'embedding de ces tokens n'a pas été entraîné. Les auteurs ont essayé de prendre ces embeddings uniquement chez les experts qui les avaient entraînés, mais le résultat est moins bon que de partir tous du même point et de moyenner normalement. Une autre raison est le long contexte : le post-entraînement affaiblit généralement la capacité de long contexte, et il est difficile de la récupérer ; partir d'un modèle d'instructions qui gère déjà le long contexte aide à la préserver.
Faire des fusions « moins un ». Pendant la recherche, comparer délibérément les fusions privées d'un expert permet de repérer l'expert qui pénalise les autres. Les auteurs appellent ce phénomène une « collision ».
Donner à chaque expert un peu de données des autres domaines. Une petite quantité de données d'autres domaines agit comme une régularisation : elle empêche l'expert de trop s'éloigner et préserve la compatibilité entre experts. Les collisions viennent parfois aussi de petites différences de style ou de format dans des données partagées.
Les auteurs concluent que préserver la cohérence entre experts compte davantage que viser la meilleure performance d'un expert isolé.
La fusion est bon marché, l'évaluation coûteuse
Ce problème n'apparaît que dans un produit réel. La recherche académique fixe généralement un ensemble d'experts, puis cherche la meilleure méthode de fusion, avec quelques indicateurs pour cible. Command A doit veiller à des centaines d'indicateurs à la fois, et chaque jeu de poids essayé exige toute la batterie d'évaluations. La fusion elle-même demande très peu de calcul, mais l'évaluation consomme beaucoup de temps d'inférence.
Et les experts eux-mêmes ne cessent de changer. Selon les auteurs, une grande partie du travail qui a permis la réussite de la fusion a en fait consisté à revenir modifier la manière d'entraîner les experts.
Discussion
Quelle part des capacités des experts la fusion conserve-t-elle ?
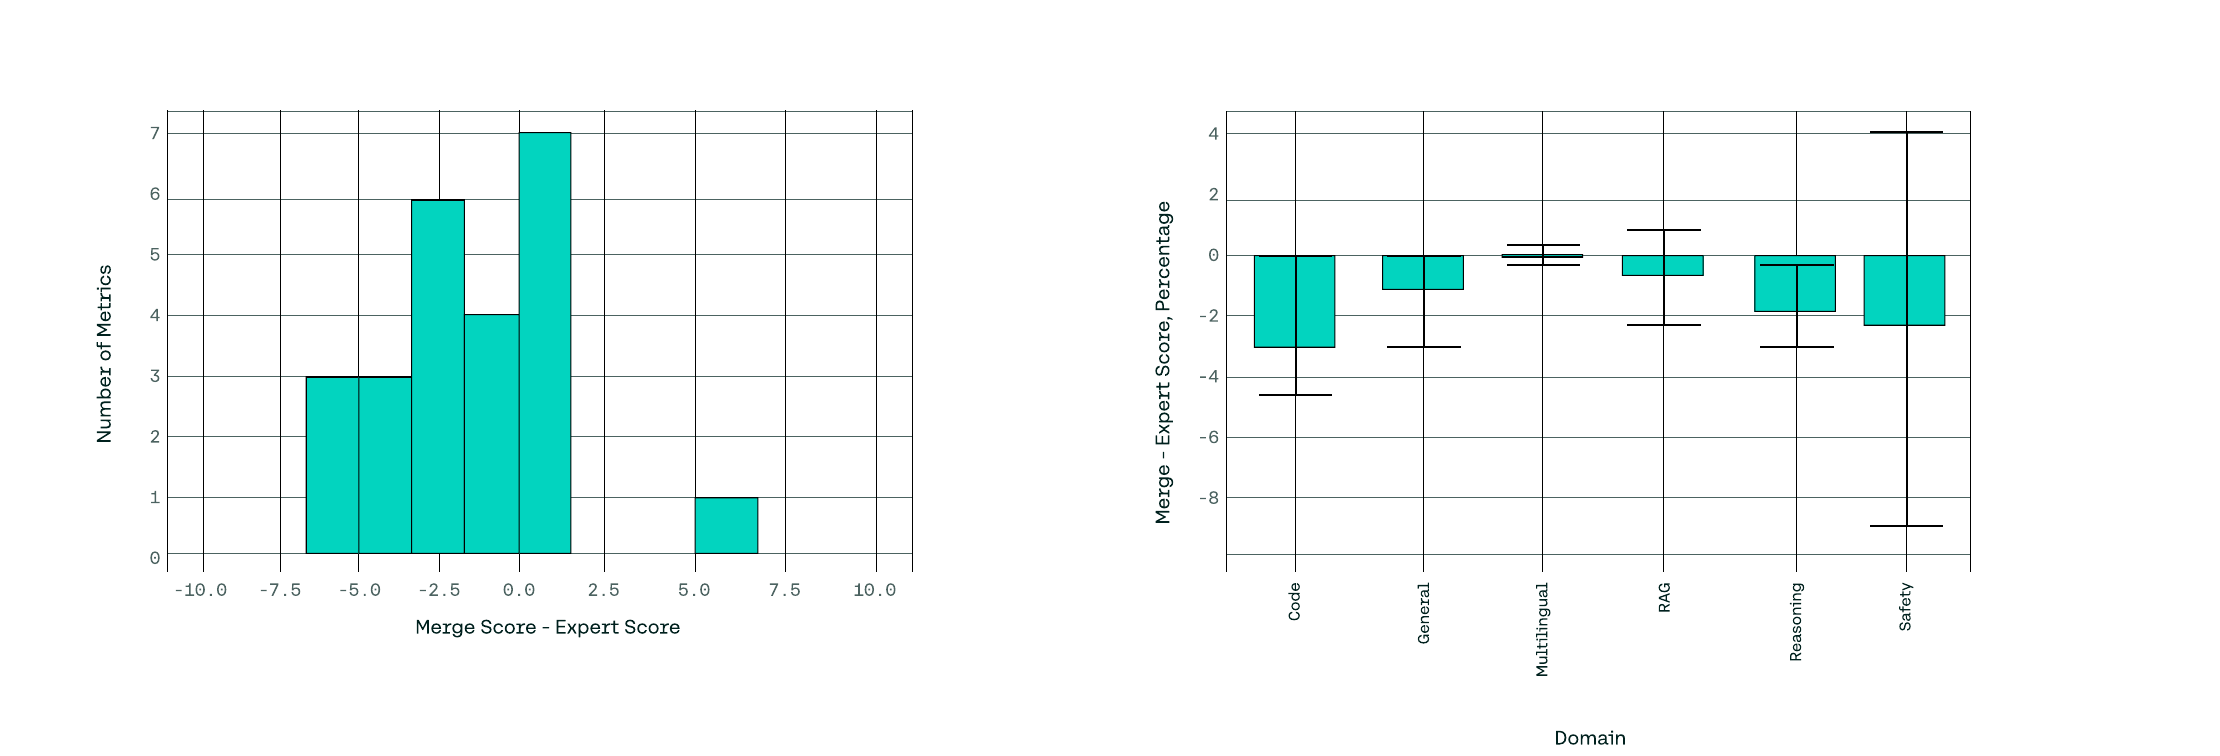
Le graphique de gauche montre, pour tous les indicateurs suivis, l'écart de score entre le modèle fusionné et le meilleur expert. La grande majorité se concentre près de 0, légèrement à gauche ; selon le rapport, la perte moyenne n'est que de 1.8 %, la grande majorité des indicateurs reste à moins de 2.5 % du meilleur expert, et quelques-uns dépassent même l'expert.
Le graphique de droite détaille par domaine. Le multilingue, le RAG et les capacités générales sont les mieux conservés ; le code perd le plus, environ 3 % en moyenne. La barre d'erreur de la sécurité est très longue : après la fusion, les différents indicateurs de sécurité varient de façons très différentes.
Les auteurs observent aussi qu'à l'échelle de 111B, la fusion est plutôt stable. Même de forts ajustements des poids d'experts ne changent généralement les performances d'un domaine que de 2 % à 3 %, et il est rare qu'une capacité s'effondre tout entière.
La fusion est une opération grossière
Rien ne garantit que le modèle fusionné se trouve à un optimum local du paysage de perte. Les auteurs constatent qu'un petit nombre d'étapes de SFT supplémentaires sur le modèle fusionné, avec un taux d'apprentissage 10 à 20 fois plus bas que celui du SFT principal, améliore nettement les performances, beaucoup d'indicateurs atteignant voire dépassant 100 % de l'expert.
L'explication intuitive des auteurs est que la fusion combine les capacités, mais que celles-ci ne sont peut-être pas encore « alignées » dans l'espace des représentations ; quelques mises à jour de gradient suffisent à les ajuster. Cela rejoint le rôle de la phase de polissage, qui sert aussi à rattraper les points perdus à la fusion.
Le polissage lui-même alterne deux méthodes de Cohere : SRPO, hors ligne, et CoPG, en ligne. Les auteurs constatent que leur alternance permet des corrections mutuelles ; une régression apparue à une étape est généralement rattrapée à l'étape suivante.
Résultats globaux
Sur les benchmarks académiques, Command A, DeepSeek-V3, GPT-4o et Llama 3.3 70B se partagent les victoires. Par exemple, Command A obtient 80.0 sur MATH, au-dessus des 70.2 de DeepSeek-V3 et des 68.5 de GPT-4o ; 50.8 sur GPQA, sous les 59.1 de DeepSeek-V3. Sur la tâche d'agent d'entreprise τ-bench, il obtient 51.7, au-dessus des 39.1 de DeepSeek-V3.
En évaluation humaine, les taux de victoire de Command A face à GPT-4o (version de novembre 2024) et à DeepSeek-V3 sont à peu près de 50/50 ; en code, son taux de victoire est de 54.7 % face à DeepSeek-V3 et de 46.8 % face à GPT-4o. Côté vitesse, les auteurs affirment que Command A peut produire jusqu'à 156 tokens par seconde, 1.75 fois plus que GPT-4o et 2.4 fois plus que DeepSeek-V3 ; ce sont des mesures de l'éditeur, et les chiffres changent avec les conditions de déploiement.
Ce qu'il faut garder en tête en lisant ce rapport
L'effet de la fusion n'est présenté que par des distributions et des moyennes, sans scores détaillés par expert et par jeu de poids, et sans groupe témoin « pas de fusion, un seul modèle entraîné sur le mélange des données ». Les poids sont trouvés par recherche manuelle ; le rapport ne vérifie pas si ces leçons tiennent avec d'autres experts ou à une autre échelle.
Conclusion
Command A fait passer la fusion de modèles du statut de technique de recherche à celui de procédé de développement d'un grand modèle. Chaque équipe pousse une capacité à son meilleur niveau, puis la moyenne linéaire la plus simple réunit le tout en un seul modèle ; au besoin, on ajuste les poids et on refusionne, sans réentraîner.
Le plus utile du rapport, ce sont ces quelques leçons d'expérience : faire partir tous les experts du même point, mêler à chaque expert un peu des données des autres, repérer l'expert perturbateur par des fusions « moins un », ajouter après la fusion quelques étapes de SFT à faible taux d'apprentissage.
Les articles académiques cherchent surtout à savoir quelle méthode de fusion est la meilleure ; Cohere a choisi la plus simple et consacré ses efforts à rendre les experts compatibles entre eux. La fusion n'est que le geste final ; tout le travail se fait avant.