Article original
2 OLMo 2 Furious
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2501.00656
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformersolmo22024,
  title = {{2 OLMo 2 Furious}},
  author = {Team OLMo and Pete Walsh and Luca Soldaini and Dirk Groeneveld and Kyle Lo and Shane Arora and Akshita Bhagia and Yuling Gu and Shengyi Huang and Matt Jordan and Nathan Lambert and Dustin Schwenk and Oyvind Tafjord and Taira Anderson and David Atkinson and Faeze Brahman and Christopher Clark and Pradeep Dasigi and Nouha Dziri and Allyson Ettinger and Michal Guerquin and David Heineman and Hamish Ivison and Pang Wei Koh and Jiacheng Liu and Saumya Malik and William Merrill and Lester James V. Miranda and Jacob Morrison and Tyler Murray and Crystal Nam and Jake Poznanski and Valentina Pyatkin and Aman Rangapur and Michael Schmitz and Sam Skjonsberg and David Wadden and Christopher Wilhelm and Michael Wilson and Luke Zettlemoyer and Ali Farhadi and Noah A. Smith and Hannaneh Hajishirzi},
  year = {2024},
  eprint = {2501.00656},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2501.00656}
}
Le titre de ce rapport est une plaisanterie, calquée sur le titre anglais du deuxième film de la série Fast and Furious, « 2 Fast 2 Furious ».
Le contenu, lui, est très sérieux. OLMo est la série de modèles de langage « entièrement ouverts » de l'Allen Institute for AI (AI2) : en plus des poids, elle publie les données de préentraînement, le code d'entraînement, les checkpoints intermédiaires et les journaux d'entraînement. Ces modèles sont très importants pour la recherche ; pour étudier la dynamique d'entraînement ou les liens entre données et mémorisation, seuls les modèles entièrement ouverts conviennent. Mais leurs performances sont toujours restées un cran en dessous de celles des modèles dont seuls les poids sont publiés.
OLMo 2 veut réduire cet écart. Il existe en trois tailles, 7B, 13B et 32B, avec jusqu'à 6.6T tokens d'entraînement, et son post-entraînement applique directement la recette Tülu 3 de la même équipe. Le rapport se concentre sur quatre points : la stabilité du préentraînement, la recette de l'entraînement intermédiaire (mid-training), le post-entraînement et l'infrastructure.
Cette note s'intéresse surtout aux deux premiers. Le premier est la condition pour qu'OLMo 2 puisse grandir ; le second fait appel à la fusion de modèles.
Définir le problème
La version précédente, OLMo-0424, avait des performances conformes aux attentes, mais son entraînement était très instable.
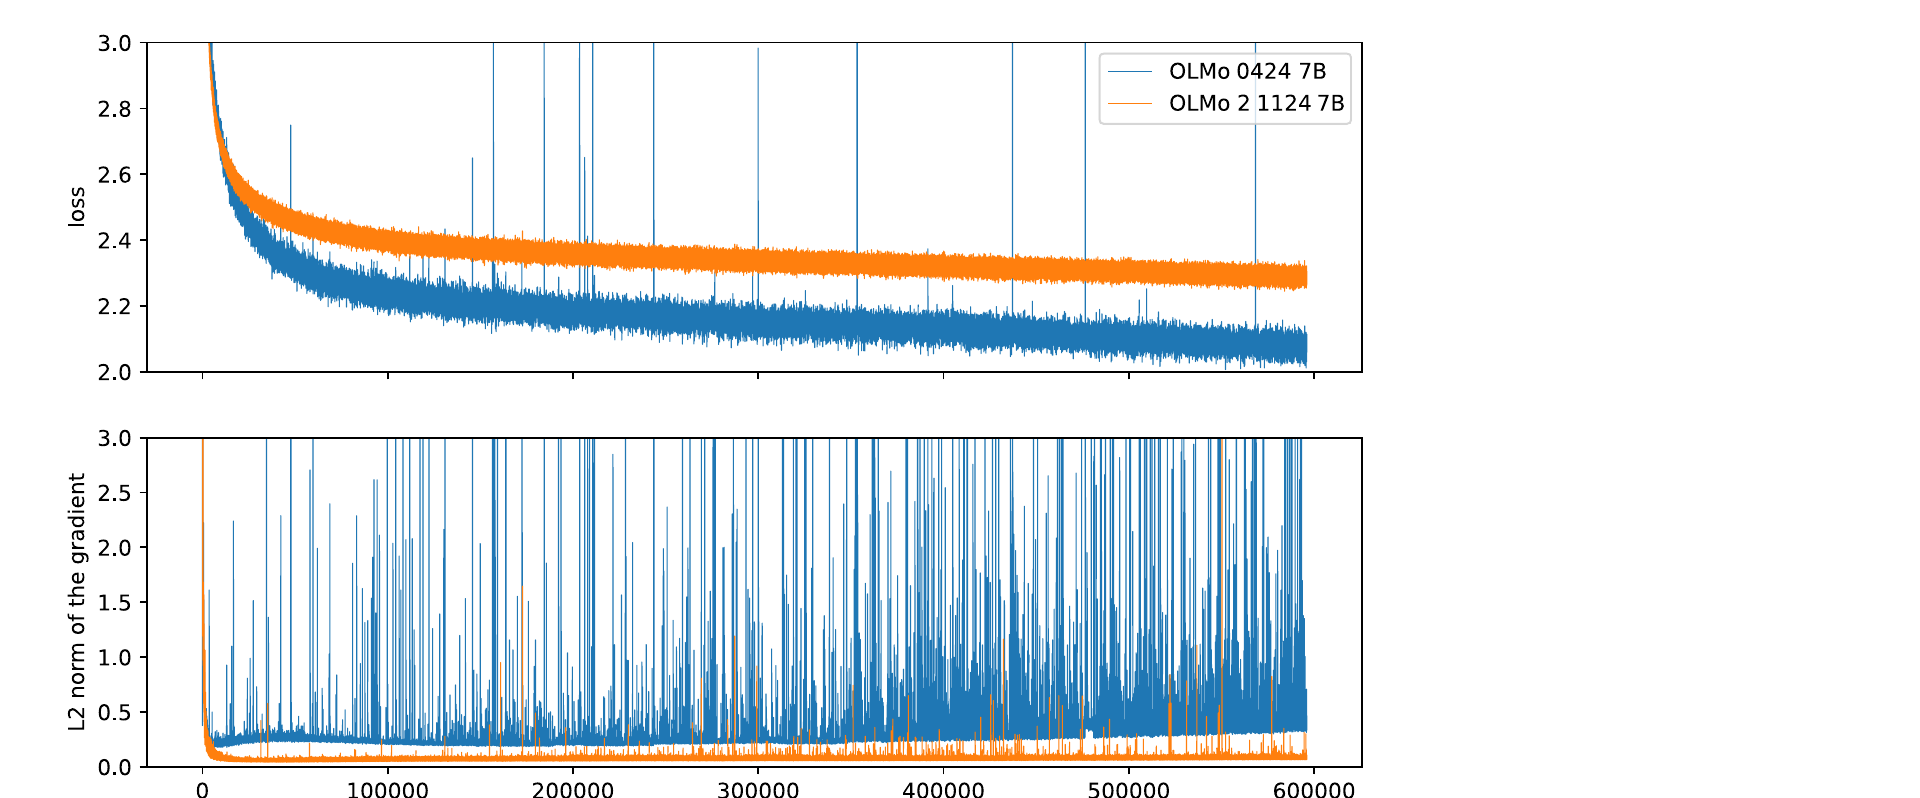
En bleu, OLMo-0424 présente deux problèmes. D'abord, des pics soudains de la perte et de la norme du gradient, ceux du gradient précédant souvent ceux de la perte. Ensuite, la ligne de base de la norme du gradient augmente lentement pendant tout l'entraînement, et les pics deviennent de plus en plus fréquents. Les auteurs constatent que plus le modèle est grand, plus il y a de pics ; ensemble, ces deux problèmes finissent par faire diverger l'entraînement, ce qui empêche tout passage à l'échelle.
En orange, OLMo 2 garde un gradient presque collé en bas. Si sa perte paraît plus élevée sur le graphique du haut, c'est que les deux entraînements n'utilisent pas les mêmes données ; on ne peut pas les comparer directement.
Quelles modifications ont donc transformé la courbe bleue en courbe orange ?
Résoudre le problème
Sept modifications pour la stabilité
Les auteurs apportent sept modifications au total : certaines touchent les données, d'autres l'architecture, d'autres encore un simple hyperparamètre.
1. Filtrer les n-grammes répétés. En examinant les lots où surviennent les pics, les auteurs trouvent souvent des fragments répétitifs comme g400g400g400g400... ou une longue suite 255, 255, 255, .... Le lien n'est pas établi : les mêmes fragments provoquent des pics sur un grand modèle mais pas sur un petit, et changer l'ordre des données peut suffire à les faire disparaître. Mais globalement, retirer ce type de données réduit la fréquence des pics.
Concrètement, lors de la préparation des données, on supprime les documents contenant 32 répétitions ou plus d'un même n-gramme (n allant de 1 à 13 tokens) ; le code d'entraînement vérifie de nouveau au chargement des données et masque la perte des cas passés entre les mailles du filet. Cela réduit nettement les pics de gradient, mais n'aide pas contre la lente montée de la norme du gradient.
2. Initialisation. OLMo-0424 utilisait une initialisation mise à l'échelle, avec des valeurs initiales plus petites pour les couches plus profondes. OLMo 2 revient à la méthode la plus simple : tous les paramètres sont tirés d'une loi normale de moyenne 0 et d'écart-type 0.02. Les auteurs mesurent, dans un modèle initialisé aléatoirement, de combien les activations et les gradients s'amplifient ou se réduisent de la première à la dernière couche ; la nouvelle initialisation conserve mieux l'échelle, quelles que soient la profondeur et la largeur.
3. RMSNorm. La LayerNorm sans paramètres est remplacée par RMSNorm.
4. Position de la normalisation. C'est un choix plutôt rare. Le Pre-LN habituel normalise d'abord l'entrée avant de l'envoyer à l'attention ou à la couche feed-forward ; OLMo 2 normalise plutôt la sortie de la sous-couche :
Cette méthode vient de Swin Transformer V2. Le tronc résiduel lui-même n'est pas normalisé, mais l'incrément ajouté par chaque couche est d'abord ramené à une échelle fixe ; aucune couche ne peut soudain injecter une très grande valeur.
5. QK-norm. Avant de calculer l'attention, on applique RMSNorm aux requêtes et aux clés, pour éviter que les logits d'attention deviennent trop grands.
6. Z-loss. On ajoute à la perte , où est le dénominateur du softmax de la couche de sortie. Dès que les logits grossissent globalement, grossit aussi, et ce terme le ramène.
Ce terme a aussi son anecdote. L'implémentation de l'entropie croisée de la bibliothèque FlashAttention intègre la z-loss ; les auteurs en avaient écrit une autre version en PyTorch, en secours. Les deux donnent le même résultat en propagation avant, mais pas en rétropropagation, ce que les auteurs soupçonnent de venir de différences de précision numérique. Bien qu'aucun effet ne soit visible, ni sur la perte d'entraînement ni sur les performances en aval, ils décident d'abandonner la portion d'entraînement faite avec l'autre implémentation et de repartir du point de divergence avec l'implémentation d'origine. En cours d'entraînement, ils évitent autant que possible de changer la moindre implémentation.
7. Deux réglages de l'optimiseur. La couche d'embedding n'a plus de décroissance des poids ; le paramètre d'AdamW passe de à . Ce second changement abaisse et stabilise la norme du gradient au début de l'entraînement.
Aucune de ces sept modifications n'est une invention nouvelle. La contribution des auteurs est d'avoir mené les expériences une par une, mesuré leur effet dans le cadre d'OLMo, puis réuni le tout dans une même recette.
Préentraînement en deux phases
Le préentraînement d'OLMo 2 se déroule en deux phases.
La première phase représente plus de 90 % du calcul d'entraînement. Elle utilise OLMo 2 Mix 1124, environ 3.9T tokens, dont plus de 95 % de données web (surtout issues de DCLM) ; le reste se compose de code (StarCoder), d'articles (peS2o, arXiv), de pages web mathématiques et de Wikipédia. Pour le code, seuls les dépôts GitHub ayant au moins 2 étoiles sont conservés ; les documents dont le mot le plus fréquent dépasse 30 % du texte sont aussi supprimés, pour éliminer les contenus binaires ou presque entièrement numériques.
La seconde phase, que les auteurs appellent mid-training, représente 5 % à 10 % du calcul. Le taux d'apprentissage y descend linéairement à 0 et les données passent au mélange soigneusement sélectionné Dolmino Mix 1124 : les 7 % de pages web les mieux classées par un classifieur de qualité, des données d'instructions FLAN décontaminées, des articles, Wikipédia, des questions-réponses de Stack Exchange, ainsi que des données synthétiques destinées spécifiquement à renforcer les mathématiques.
L'effet est important. Après le mid-training, le modèle 7B gagne 10.6 points de score moyen sur les évaluations de développement et dépasse le 13B qui n'a fait que la première phase. GSM8K passe de 24.1 à 67.5, MMLU de 59.8 à 63.7 et DROP de 40.7 à 60.8.
Trier les données par mini-recuits
Comment choisir les données du mid-training ? Un recuit complet sur 50B tokens coûte trop cher ; les auteurs ont inventé une méthode bon marché, appelée microanneal.
- Choisir la source de données mathématiques à évaluer, ou un petit groupe de sources.
- Prendre la même quantité de tokens dans les données générales, pour former un petit mélange moitié mathématiques, moitié données générales.
- Entraîner sur ce petit mélange comme pour un recuit, avec un taux d'apprentissage qui descend linéairement à 0 sur sa longueur.
Au total, 19 microanneals ont été lancés, pour 130B tokens en tout, moins que trois recuits complets de 50B ; et les différences apparaissent généralement avant 10B tokens d'entraînement. L'idée rappelle beaucoup l'utilisation du recuit par Llama 3 pour évaluer de petits jeux de données, mais menée de façon plus systématique.
Une soupe de modèles au mid-training
Vient ensuite l'étape qui intéresse le plus cette note. À la fin du mid-training, les auteurs ne se contentent pas d'une seule exécution : ils en lancent plusieurs sur les mêmes données, avec chaque fois un ordre des données différent, puis font la moyenne des résultats.
Pour vérifier l'utilité de cette pratique, ils comparent sur le 7B six mélanges de mid-training, chacun entraîné sur 50B tokens avec trois ordres de données différents, en opposant « le meilleur des trois » à « la moyenne des trois » :
| Mélange | Évaluation | Meilleur modèle individuel | Moyenne des trois |
|---|---|---|---|
| A | OLMES | 75.6 | 77.0 |
| B | OLMES | 75.3 | 77.3 |
| C | OLMES | 76.3 | 76.8 |
| A | MMLU | 61.2 | 62.0 |
| B | MMLU | 61.5 | 62.7 |
| C | MMLU | 62.8 | 63.5 |
Sur les six mélanges et les quatre types d'évaluation, soit vingt-quatre comparaisons, vingt-trois donnent un modèle moyenné au moins aussi bon que le meilleur modèle individuel, et le plus souvent meilleur ; par exemple, l'OLMES du mélange B gagne 2 points. L'exception est le GSM* du mélange E, qui tombe de 60.5 à 43.0 après la moyenne.
Les OLMo 2 finaux sont donc tous des « soupes ». Le 7B moyenne trois modèles entraînés chacun sur 50B tokens ; les 13B et 32B en moyennent quatre, trois entraînés chacun sur 100B tokens et un sur 300B tokens, ce qui, d'après les auteurs, fait mieux que la moyenne des trois modèles à 100B seuls.
Il vaut la peine de comparer avec Tülu 3. La même équipe, en moyennant au stade SFT des modèles de graines différentes, ne fait pas mieux que le meilleur modèle individuel ; en moyennant au mid-training des modèles d'ordres de données différents, elle obtient un gain dans presque toutes les comparaisons. La différence tient à ce que chaque modèle du mid-training a vu plus de 50B tokens, part du même checkpoint préentraîné et termine avec un taux d'apprentissage ramené à 0, des conditions très proches des situations étudiées par Model Soups et PMA. L'article ne compare pas directement ces deux résultats ; c'est seulement une hypothèse de cette note.
Post-entraînement
Le post-entraînement reprend pour l'essentiel celui de Tülu 3 : SFT, DPO normalisé par la longueur, RLVR. Deux choses changent. Les réponses des données de préférences sont générées par des modèles sous licence permissive, et RLVR se fait en plusieurs étapes, pour obtenir les meilleures performances.
Discussion
Le front de Pareto entre calcul et performance
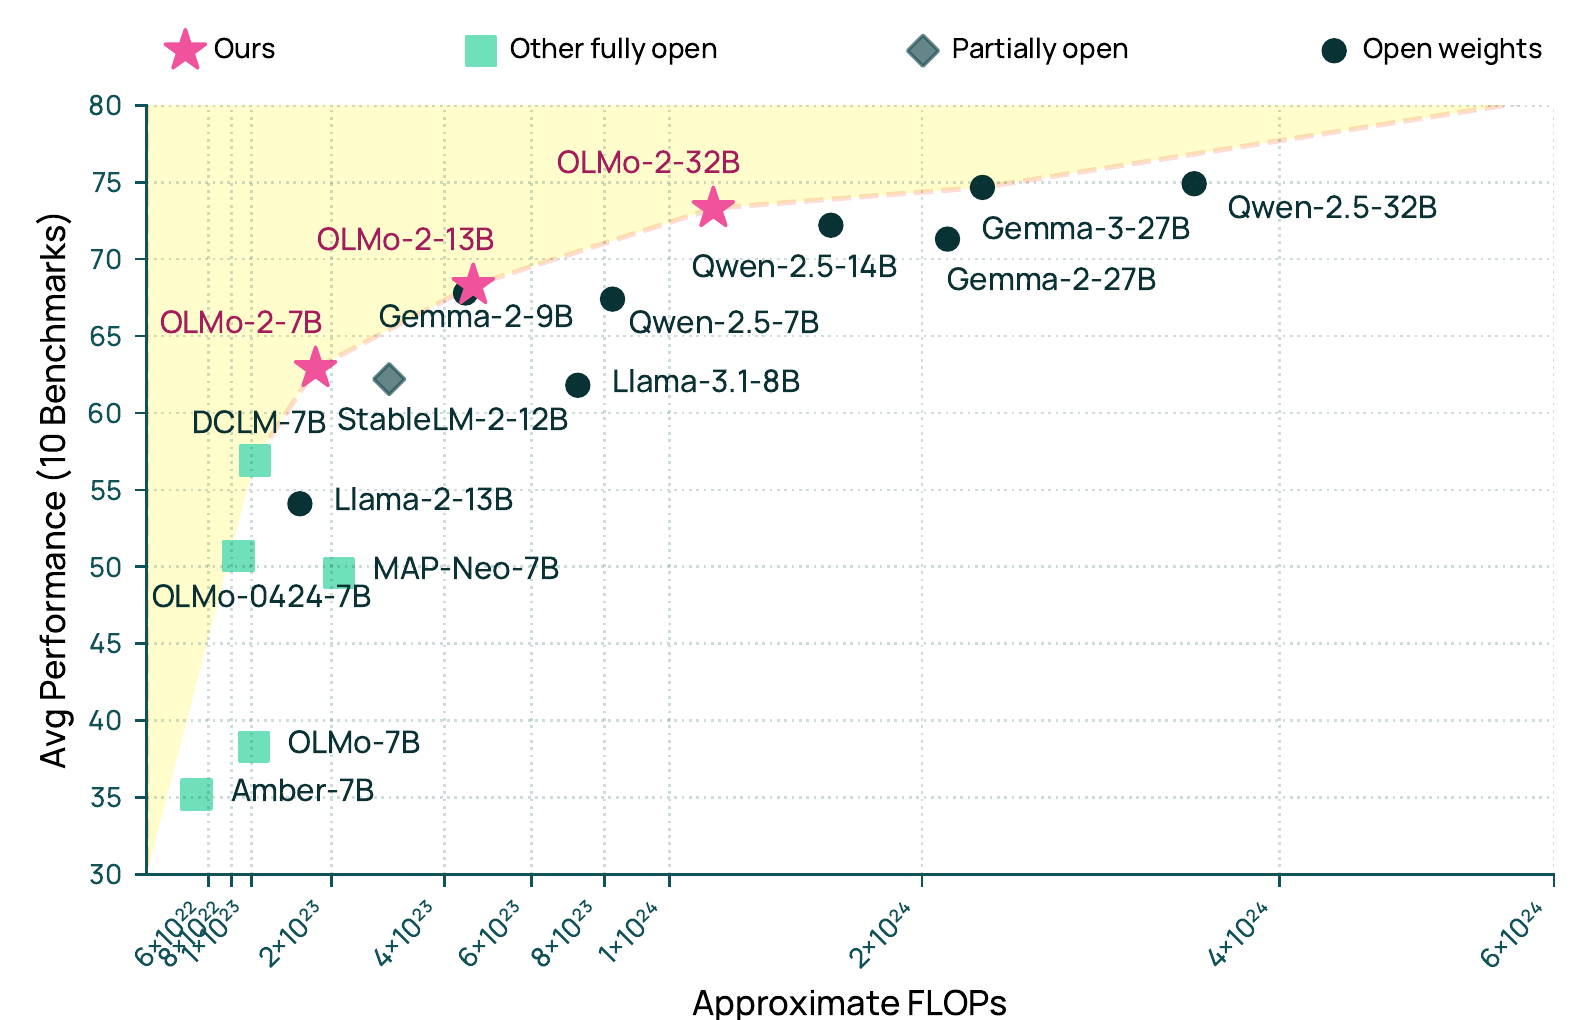
L'abscisse donne le calcul de préentraînement, l'ordonnée la moyenne du modèle de base sur 10 benchmarks. Les étoiles roses se trouvent sur la ligne pointillée en haut à gauche : à calcul égal, OLMo 2 fait mieux ; ou, à performance égale, il utilise moins de calcul. Par exemple, OLMo 2 13B et Gemma 2 9B ont des scores proches, tandis que Qwen 2.5 7B a eu besoin de plus de calcul pour atteindre une position semblable.
Les carrés verts sont d'autres modèles entièrement ouverts, presque tous en bas à gauche ; OLMo 2 creuse un large écart avec eux.
Pour les versions post-entraînées, voici les scores moyens tirés de la Table 7 du rapport :
| Modèle | Moyenne | FLOPs de préentraînement () |
|---|---|---|
| OLMo 2 7B Instruct | 56.5 | 1.8 |
| Llama 3.1 8B Instruct | 59.1 | 7.2 |
| Qwen 2.5 7B Instruct | 61.6 | 8.2 |
| OLMo 2 13B Instruct | 63.5 | 4.6 |
| OLMo 2 32B Instruct | 68.8 | 13.0 |
| Qwen 2.5 32B Instruct | 68.1 | 35.0 |
| GPT-4o mini | 65.7 | — |
Le 7B reste derrière Llama 3.1 8B et Qwen 2.5 7B, mais avec environ un quart de leur calcul de préentraînement. Le 32B, avec moins de 40 % du calcul de Qwen 2.5 32B, obtient une moyenne légèrement supérieure et dépasse aussi GPT-4o mini.
Ce qu'il faut garder en tête en lisant ce rapport
- Les preuves de stabilité reposent surtout sur des comparaisons de courbes d'entraînement dans un seul cadre ; les sept modifications ont été introduites ensemble, et leurs contributions individuelles ne font l'objet que d'ablations partielles.
- Le traitement de GSM8K. Constatant que les capacités mathématiques étaient très faibles après le préentraînement, les auteurs ont tiré 200 des 1 319 questions de GSM8K pour en faire un jeu de développement du mid-training ; GSM8K n'est donc pas une évaluation entièrement inédite. Les résultats finaux du rapport n'utilisent que les 1 119 questions restantes, ce que les auteurs signalent explicitement en note de bas de page.
- Les preuves sur la soupe de modèles viennent du mid-training sur 50B tokens du 7B ; pour la combinaison de quatre modèles des 13B et 32B, le rapport dit seulement qu'elle est « empiriquement meilleure », sans tableau complet.
Conclusion
OLMo 2 est un rapport d'ingénierie très solide. Il n'apporte pas de nouvelle architecture ; il consolide un à un la stabilité, le mélange des données et la méthode d'évaluation, et place pour la première fois un modèle entièrement ouvert sur le front de l'efficacité de calcul.
Pour la fusion de modèles, il fournit un cas positif bien propre : même point de départ, mêmes données, ordres de données différents, et après le recuit, la moyenne n'est presque jamais moins bonne que le meilleur des modèles.
Si vous avez du calcul en trop, inutile de tout miser sur un seul ordre de données. Lancez deux mid-trainings de plus et faites la moyenne ; cela vaut mieux que de retenir la meilleure des exécutions.