Article original
A Systematic Study of In-the-Wild Model Merging for Large Language Models
- Publication
- Transactions on Machine Learning Research 2026Revue
- Premier dépôt sur arXiv
- arXiv:2511.21437
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmerginginthewildmerging2025,
  title = {{A Systematic Study of In-the-Wild Model Merging for Large Language Models}},
  author = {Oğuz Kağan Hitit and Leander Girrbach and Zeynep Akata},
  year = {2025},
  eprint = {2511.21437},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2511.21437}
}
Les expériences de fusion sont souvent très propres : chaque expert apprend une tâche séparée, comme huit jeux de classification visuelle ou sept tâches NLP, puis on évalue chacune après fusion.
Sur Hugging Face, un même Llama ou Qwen possède plutôt des centaines ou milliers d'ajustements communautaires : mathématiques, jeu de rôle ou simple changement de données d'instructions. Leurs objectifs se recouvrent ou se contredisent. Les ajustements accumulés dans une entreprise ressemblent probablement à ce paysage.
Oğuz Kağan Hitit, Leander Girrbach et Zeynep Akata, de l'Université Koç, de l'Université technique de Munich, de Helmholtz Munich et du MCML, posent une question pratique : réunir ces ajustements sauvages peut-il dépasser la base, voire chacun des candidats ?
Définir le problème
La cible est précise : fusionner des ajustements hétérogènes, potentiellement conflictuels, et mesurer les capacités générales du modèle de langage, dont les tâches d'entraînement des sources ne couvrent qu'une partie.
Trois questions :
- Une fusion simple peut-elle dépasser la base ?
- Quelles méthodes fondées sur l'interpolation des poids y parviennent ?
- Les méthodes de sous-espaces récemment efficaces en vision le restent-elles dans ce cadre linguistique sauvage ?
Dépasser base et ajustements individuels peut révéler l'interférence constructive décrite par l'article. L'évaluation a deux références : la base et l'ajustement ayant le meilleur score moyen de tout le groupe. Cette seconde référence est fixe et peut être absente d'un sous-ensemble fusionné.
Résoudre le problème
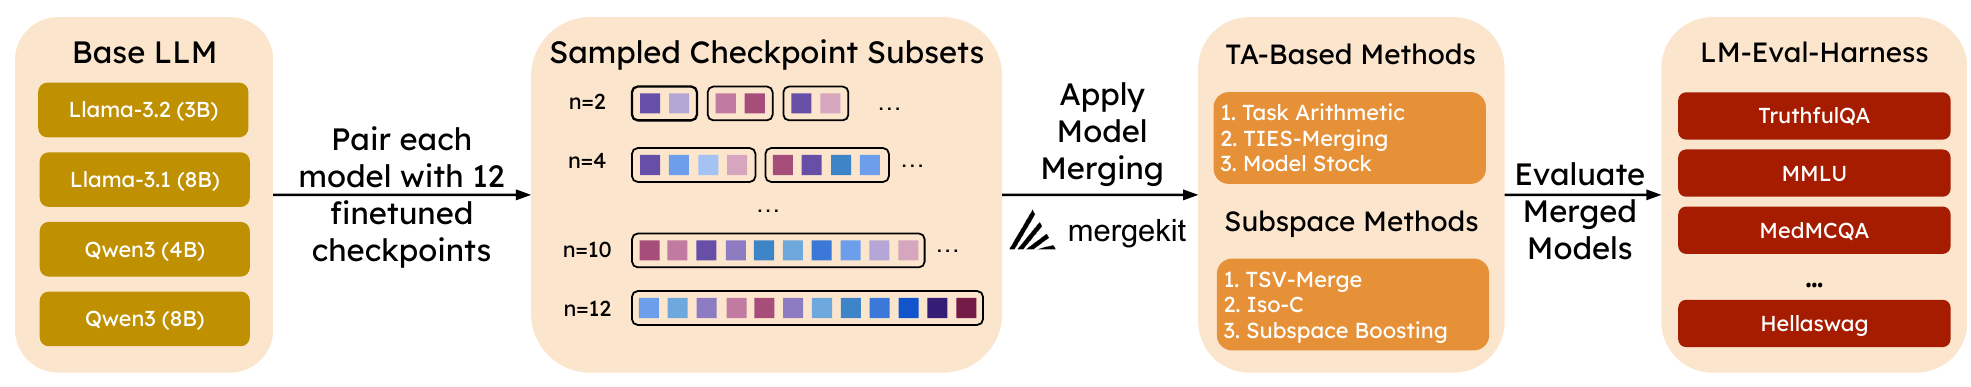
L'article ne propose pas non plus de nouvelle méthode ; sa contribution est un protocole reproductible.
Bases et ajustements : Llama-3.2-3B-Instruct, Llama-3.1-8B-Instruct, Qwen3 4B et Qwen3 8B, avec douze ajustements Hugging Face chacun, aux domaines et objectifs variés. Les Llama partent d'Instruct. Chaque famille partage sa base et les quatre familles ne sont pas mélangées.
Méthodes : trois approches apparentées à l'arithmétique, arithmétique des tâches à , TIES à avec les 10 % de changements de plus forte amplitude par couche, et Model Stock ; trois de sous-espaces, TSV-Merge, Iso-C et Subspace Boosting. Toutes utilisent mergekit avec les hyperparamètres sélectionnés en annexe puis fixés.
Échantillonnage : vaut 2, 4, 6, 8, 10 ou 12. On tire uniformément 15 sous-ensembles par , sauf à , où il n'en existe qu'un. Les mêmes sous-ensembles sont partagés entre méthodes pour isoler l'algorithme.
Évaluation : lm-evaluation-harness mesure la précision sur 16 benchmarks standards de l'Open LLM Leaderboard, dont ARC, HellaSwag, Winogrande, MMLU, GPQA, BBH, MMLU-Pro et TruthfulQA, sans gabarit de conversation.
La plupart sont en 0-shot ; BBH utilise 3-shot et MMLU-Pro 5-shot. Le calcul est en float16 avec taille de lot choisie automatiquement par le harness. Les prompts de connaissances et de choix multiples sont ainsi fixés, mais conversation complète, outils et usages de jeu de rôle restent hors évaluation. Un ajustement plus faible en moyenne peut toujours mieux remplir son objectif d'origine.
Vérifier l'échelle de l'arithmétique
Un réglage est facile à manquer : la normalization de mergekit est active. Avec le delta de la source et son poids de recette , le changement appliqué est :
Avec et , c'est la moyenne des deltas. Les additionner directement pour douze modèles donnerait un changement douze fois plus grand. Reproduire « TA, » exige donc aussi ce réglage.
L'annexe le mesure : normalization active, les scores restent assez plats quand passe de 0.1 à 1.9 et baissent nettement à 10. Sans elle, augmenter dans la plage ordinaire suffit à dégrader rapidement. La stabilité de l'arithmétique simple concerne donc cette recette de moyenne et de mise à l'échelle.
Les deux figures utilisent en abscisse et la précision moyenne en ordonnée, avec une couleur par base. En haut, normalization est active et est ajouté tout à droite ; en bas, elle est désactivée. Les positions correspondent aux coefficients listés : leurs espacements réels, surtout pour les deux derniers points, diffèrent.
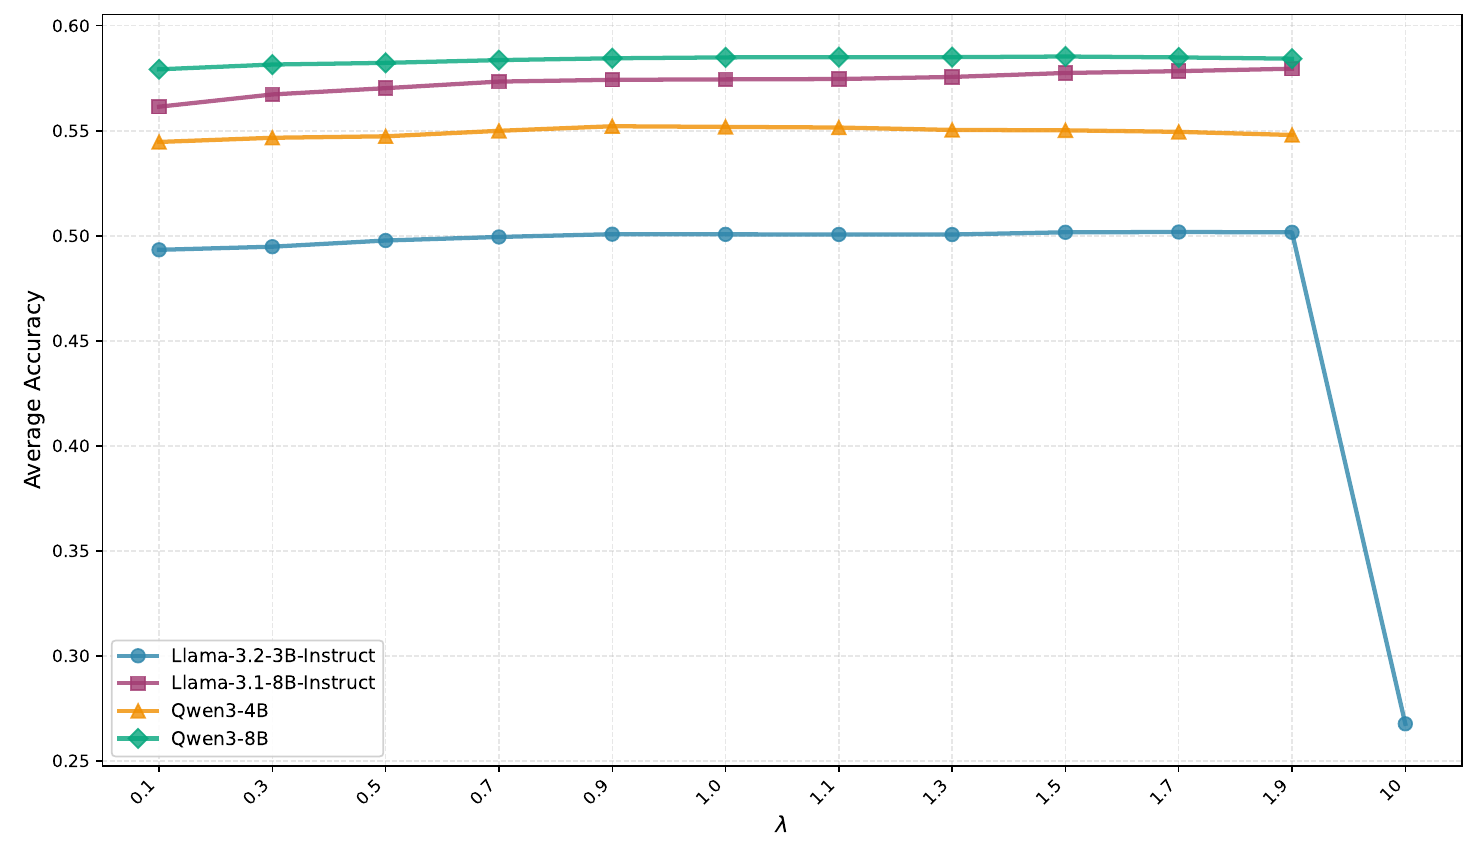
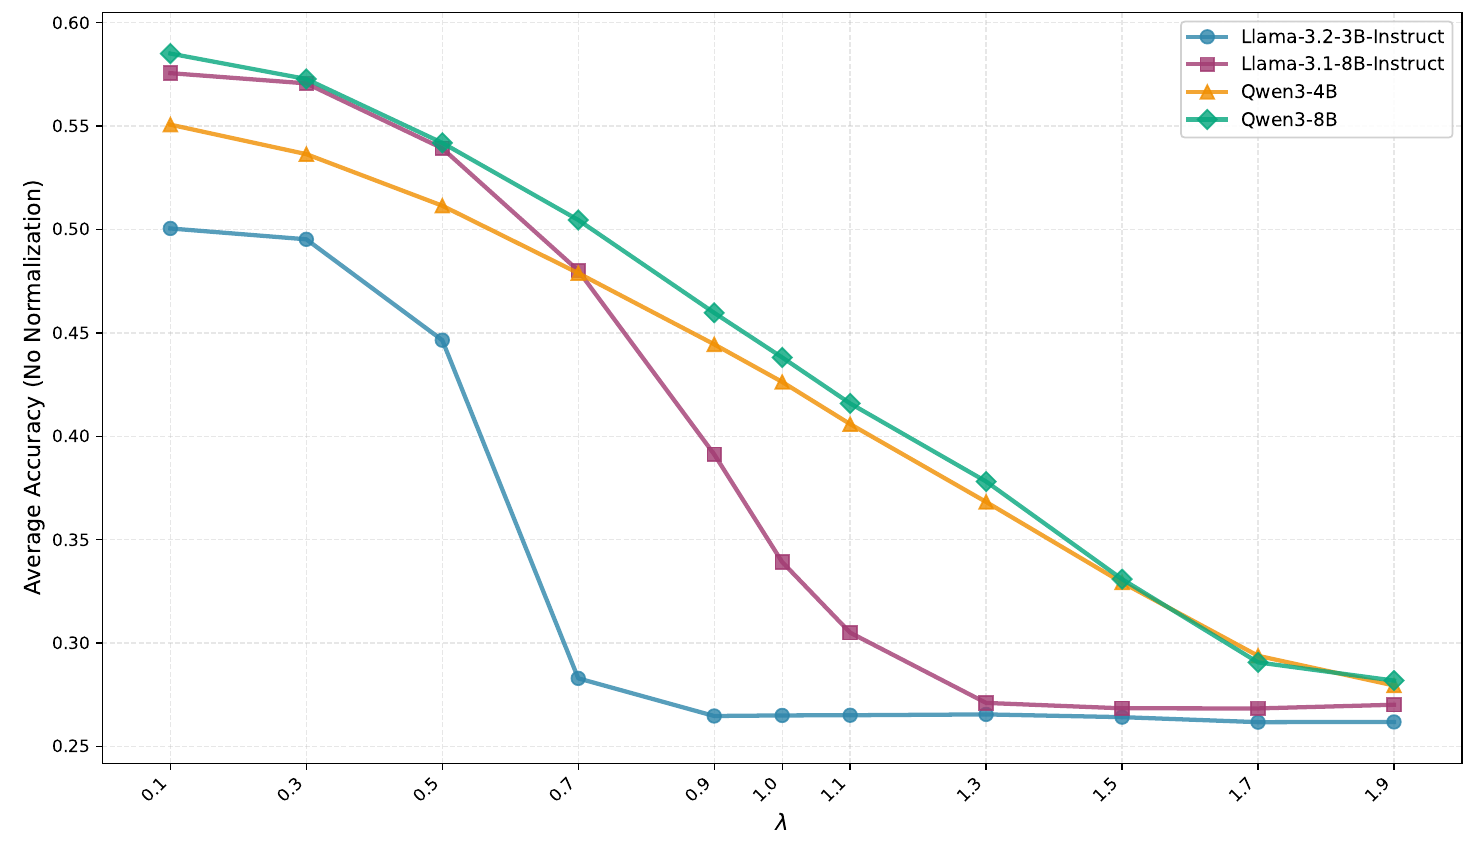
La baisse du bas vient d'une somme de plusieurs changements ensuite amplifiée, très différente de la moyenne du haut. Oublier un booléen peut ainsi inverser toute la courbe.
Discussion
Seule l'arithmétique progresse régulièrement
| Méthode | |||||||
|---|---|---|---|---|---|---|---|
| Arithmétique des tâches | 25 / −1.11 | 49 / −0.02 | 88 / +0.50 | 100 / +0.74 | 100 / +0.87 | 100 / +0.93 | 100 / +1.02 |
| Model Stock | 25 / −1.11 | 53 / +0.02 | 77 / +0.06 | 82 / +0.09 | 82 / +0.10 | 80 / +0.11 | 100 / +0.13 |
| TIES-Merging | 25 / −1.11 | 78 / +0.11 | 85 / +0.14 | 87 / +0.18 | 85 / +0.17 | 80 / +0.17 | 75 / +0.13 |
Moyenne des quatre bases, d'après la Table 1. Chaque case donne la proportion de combinaisons dépassant la base (%), puis l'amélioration relative moyenne (%) telle que rapportée par l'article. désigne les ajustements individuels.
À , seul un quart des ajustements dépasse sa base et la moyenne baisse de 1.11 %. Les gains suivants ne viennent donc pas simplement d'un candidat exceptionnel tiré par chance.
L'arithmétique montre la tendance la plus nette : avec deux versions, environ la moitié dépasse la base ; dès , toutes les combinaisons testées des quatre bases la dépassent. Le gain croît avec jusqu'à environ 1 % à .
Les 100 % concernent les tirages étudiés : quinze sous-ensembles par famille à , un seul à . L'étude ne couvre pas tous les ajustements Hugging Face possibles. Les deux nombres répondent aussi à deux questions : fréquence du succès et amplitude du gain. Un succès fréquent peut rester très modeste.
L'amplitude l'est effectivement : les auteurs résument les gains moyens sur toutes les tâches comme généralement inférieurs à 1 %.
TIES dépasse souvent la base, mais plafonne rapidement vers 0.1 à 0.2 %. Sur Qwen3 8B, il passe même de +0.16 à à −0.08 à . Les auteurs invoquent sa sensibilité aux amplitudes des vecteurs hétérogènes. Model Stock reste presque collé à la base, ses poids s'en éloignant peu.
Dépasser aussi le meilleur candidat
L'arithmétique dépasse le meilleur ajustement de tout le groupe dans trois des quatre familles. À , les deux Qwen et Llama 3.2 3B donnent globalement des résultats plus favorables.
L'exception est Llama 3.1 8B, dont le groupe contient un ajustement particulièrement fort. La fusion dépasse la base, mais reste sous cette référence fixe. En pratique, choisir directement un modèle existant doit rester un concurrent : fusion et évaluations peuvent seulement rapprocher d'une option déjà disponible.
Les sous-espaces se dégradent avec les ajouts
TSV-Merge et Iso-C ont récemment obtenu de bons résultats sur les fusions visuelles. Ils décomposent les vecteurs de tâche de chaque couche par SVD et traitent l'interférence dans un sous-espace de faible rang. TSV-Merge conserve les directions singulières importantes de chaque tâche puis les orthogonalise ; Iso-C aplatit la distribution des valeurs singulières.
Dans ce cadre linguistique, leurs précisions moyennes baissent quand le nombre de versions augmente. Les auteurs l'expliquent par une perte progressive d'informations utiles au cours des troncatures et orthogonalisations.
Ils mesurent aussi la distance à la base, . Arithmétique, TIES et Model Stock restent surtout sous 50 ; Iso-C et TSV-Merge atteignent souvent 100 à 300, voire plus de 300 pour les deux 8B. Les plus grandes distances accompagnent les plus fortes baisses. Les auteurs supposent une sortie du bassin de la base et un oubli catastrophique.
Pour une mise à jour de taille , la SVD donne . TSV-Merge conserve environ des directions de chaque source avant leur orthogonalisation commune : davantage de sources signifie moins de directions conservées pour chacune. Iso-C décompose la somme puis remplace toutes les valeurs singulières par leur moyenne, renforçant relativement les directions faibles. Ces opérations modifient directions ou amplitudes autrement qu'une moyenne des deltas.
Subspace Boosting résiste
Le troisième procédé mérite d'être séparé. Subspace Boosting part d'une mise à jour déjà fusionnée, choisit un seuil selon la proportion cumulée des valeurs singulières, puis remonte les plus faibles à la valeur de coupure. Il s'ajoute à TA ou TIES, d'où les variantes TA+SB et TIES+SB ; il ne constitue pas une sélection indépendante des modèles.
Avec un seuil fixé à 0.2, TA+SB est très variable à petit nombre : seulement 23 % des combinaisons dépassent la base à , contre 100 % à , avec +1.07 d'amélioration moyenne rapportée. TIES+SB est plus stable et atteint +0.36 à douze, contre −2.36 pour TSV-Merge et −5.36 pour Iso-C. Les sous-espaces ont donc des résultats différents. TA+SB suit toutefois de près TA, sans avantage supplémentaire net et stable de cette opération sur le spectre des valeurs singulières.
Un groupe de sources plus homogène
L'annexe choisit trois experts mathématiques et trois médicaux pour Qwen3 4B et 8B, puis compare chaque trio à leur fusion à six, sur des tests correspondants. En 8B, le mélange des deux domaines approche les fusions séparées. En 4B, TA et TIES préservent aussi les résultats, mais certaines variantes de sous-espaces présentent des écarts plus grands.
Cela précise le résultat principal : un groupe aléatoire peut mêler changements redondants et directions diverses. Vérifier les spécialités et composer avec un objectif peut changer l'issue. Le protocole principal omet volontairement alignement, regroupement et sélection ; ses résultats portent sur ce cadre et laissent à évaluer les recettes soigneusement choisies.
La distance doit aussi rester dans son cadre : à famille identique, norme croissante et baisse de score constituent un bon signal d'anomalie. Entre tailles et normalisations différentes, les valeurs absolues de ne peuvent partager un seuil de 50 ou 300. Les auteurs y voient un appui à l'hypothèse de sortie d'une bonne région, sans mesurer directement les barrières de perte de tous les candidats.
Conclusion
Deux constats se dégagent.
Même des ajustements communautaires hétérogènes et parfois conflictuels peuvent ensemble dépasser leur base. L'arithmétique des tâches, l'une des méthodes les plus anciennes et simples, le fait avec une stabilité croissante quand les versions s'ajoutent.
Le gain reste limité. TIES et Model Stock restent près de la base, certaines recettes de sous-espaces régressent et TA+SB suit largement TA. Groupe de sources, normalization et prompts fixés comptent tous pour interpréter les résultats.
Avec des ajustements d'une même base mais d'origines variées, commencez par l'arithmétique. Avant de passer à une méthode plus élaborée, mesurez déjà la distance des poids fusionnés à leur base.