Article original
TIES-Merging: Resolving Interference When Merging Models
- Publication
- NeurIPS 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2306.01708
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingtiesmerging2023,
  title = {{TIES-Merging: Resolving Interference When Merging Models}},
  author = {Prateek Yadav and Derek Tam and Leshem Choshen and Colin Raffel and Mohit Bansal},
  year = {2023},
  eprint = {2306.01708},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2306.01708}
}
L'arithmétique des tâches représente chaque ajustement par . Additionner ces vecteurs et appliquer un coefficient fournit un modèle multitâche. Avec deux tâches, le résultat est bon ; en en ajoutant davantage, l'écart avec les experts s'élargit.
Prateek Yadav, Derek Tam, Colin Raffel et Mohit Bansal de l'Université de Caroline du Nord à Chapel Hill, et Leshem Choshen d'IBM Research et du MIT, cherchent l'origine de cette perte.
Leur réponse : à l'addition, les paramètres se contrarient.
Définir le problème
Les auteurs distinguent deux interférences.
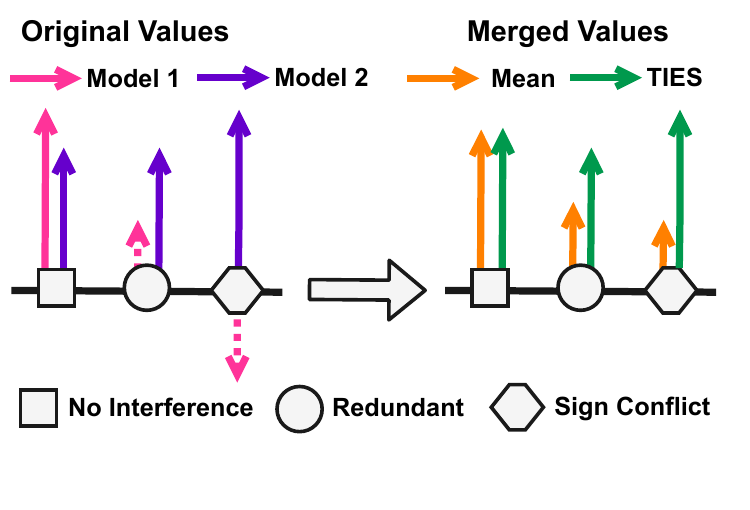
Paramètres redondants, le cercle : beaucoup de paramètres bougent très peu et ces changements influencent peu la tâche. À la fusion, un changement important pour A peut être dilué par le petit bruit de B.
Conflits de signe, le losange : A augmente un paramètre, B le diminue, et la moyenne les annule en partie.
Dans les deux cas, le changement fusionné diminue et les différences acquises s'effacent.
Les auteurs vérifient ces deux phénomènes. Garder seulement les 20 % de changements de plus forte amplitude conserve presque la performance moyenne sur onze tâches. Après cet élagage, environ 2 % des paramètres sont en conflit de signe pour deux modèles, contre environ 30 % pour onze.
Ces onze tâches utilisent l'ajustement (IA) de T0-3B, qui n'entraîne que de petits vecteurs redimensionnant les activations, avec le modèle principal fixe. Les 20 % portent donc sur les changements des paramètres ajustés. L'article vérifie ensuite T5 et CLIP en ajustement complet ; cette figure seule ne permet pas de fixer une suppression universelle de 80 % des changements.
Résoudre le problème
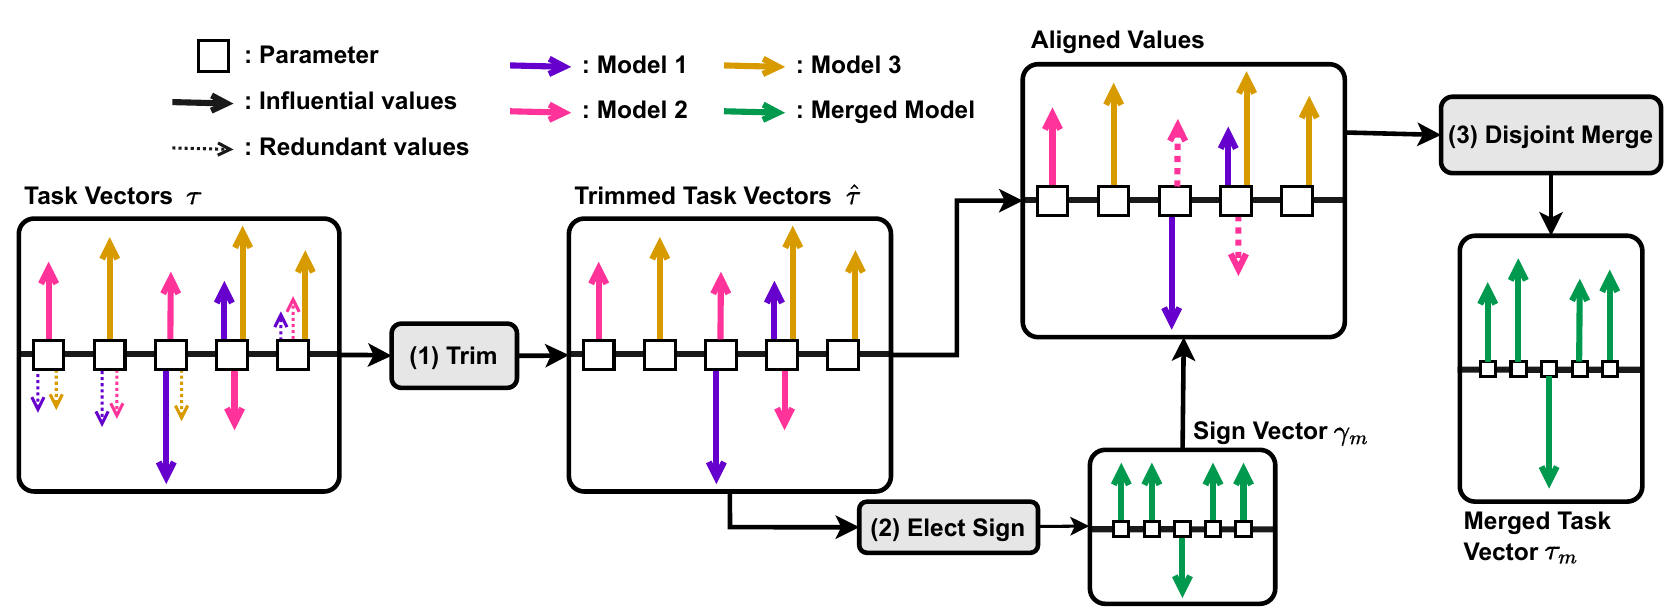
TIES tire son nom de Trim, Elect Sign et Disjoint Merge. Chaque vecteur est décomposé en signe et amplitude , avec .
- Élaguer, Trim : conserver les de plus forte amplitude de chaque vecteur, mettre le reste à 0 et obtenir .
- Élire le signe, Elect : pour chaque paramètre , sommer les changements et retenir le signe du total :
On compare donc les amplitudes totales des deux directions ; la plus forte l'emporte.
- Moyenne disjointe, Disjoint Merge : moyenner seulement les valeurs de même signe que la direction choisie, sans compter les zéros élagués :
Enfin, .
Trim annule les différences : le poids ajusté correspondant revient à sa valeur initiale, le paramètre de base reste présent. Le dénominateur de Disjoint Merge compte les membres non nuls de même signe à cette position. Si une seule tâche conserve et dix autres sont à zéro, le résultat reste . Diviser par onze réintroduirait la dilution que l'élagage cherche à supprimer. Chaque position peut avoir son propre dénominateur.
Un calcul à la main
Voici trois tâches et six paramètres inventés pour l'exemple, avec conservation de la moitié de plus forte amplitude :
import numpy as np

tau = np.array([[ 0.8, -0.1,  0.5,   0.02, -0.6, 0.3 ],   # 任務 A
                [-0.7,  0.4,  0.6,  -0.03,  0.1, 0.05],   # 任務 B
                [ 0.9, -0.2, -0.05,  0.01, -0.5, 0.4 ]])  # 任務 C

print("直接平均:", tau.mean(0).round(3))

# 1. Trim:每個任務只留絕對值最大的一半
k = tau.shape[1] // 2
cut = np.sort(np.abs(tau), axis=1)[:, -k][:, None]
trimmed = np.where(np.abs(tau) >= cut, tau, 0.0)
print(trimmed)

# 2. Elect:每個參數用剩下數值的總和投票,決定正負號
sign = np.sign(trimmed.sum(0))

# 3. Merge:只平均和投票結果同號的值
agree = (np.sign(trimmed) == sign) & (trimmed != 0)
ties = (trimmed * agree).sum(0) / np.maximum(agree.sum(0), 1)
print("TIES    :", ties.round(3))
直接平均: [ 0.333  0.033  0.35   0.    -0.333  0.25 ]
[[ 0.8  0.   0.5  0.  -0.6  0. ]
 [-0.7  0.4  0.6  0.   0.   0. ]
 [ 0.9  0.   0.   0.  -0.5  0.4]]
TIES    : [ 0.85  0.4   0.55  0.   -0.55  0.4 ]
Le paramètre 0 illustre le conflit : A et C veulent l'augmenter, B le diminuer. La moyenne directe vaut seulement 0.333 ; le vote positif retient A et C et donne 0.85.
Le paramètre 1 illustre la redondance : seul B le modifie fortement. Les petits −0.1 et −0.2 de A et C ramènent la moyenne à 0.033. Après élagage, le 0.4 de B reste entier.
Le paramètre 3 ne bouge que de quelques centièmes dans les trois tâches ; l'élagage l'annule.
L'étape 2 somme les valeurs plutôt que de compter les voix. Deux valeurs positives contre une négative donnent ici le même choix, mais un +0.9 contre deux −0.1 reste aussi positif : l'amplitude décide.
Si toutes les valeurs sont élaguées, le code garde 0. Cet exemple garde aussi 0 lorsque les sommes positives et négatives s'annulent, pour éviter de diviser par un ensemble vide. Un seuil top-k peut conserver plusieurs valeurs ex æquo : l'implémentation doit préciser ce cas. Rares ou non, ces choix conditionnent la reproduction exacte des poids.
Le de TIES n'est pas interchangeable avec le de l'arithmétique : TIES calcule une moyenne par position, l'autre une somme. Même sans élagage ni signes, une somme de tâches vaut fois leur moyenne. Les recommandations fixes de 1 pour TIES et 0.4 pour l'arithmétique correspondent à leurs recettes respectives, pas à une comparaison à échelle égale.
Discussion
Les configurations
Trois cadres sont évalués :
- Ajustement efficace en paramètres : onze tâches (IA) sur T0-3B, dont complétion, inférence en langue naturelle, coréférence et désambiguïsation lexicale.
- Ajustement complet en langage : T5-base et T5-large sur sept tâches.
- Ajustement complet en vision : CLIP ViT-B/32 et ViT-L/14 sur huit tâches de classification.
Les comparaisons incluent moyenne simple, Fisher Merging, RegMean et arithmétique des tâches.
Fisher et RegMean demandent des statistiques issues des données : importance des paramètres pour le premier, produits scalaires des entrées de couches linéaires pour le second. Les trois étapes TIES ne lisent que les poids. Choisir et exige toutefois des évaluations de validation ; l'article sépare donc les résultats avec et sans validation.
Les résultats principaux
Avec une validation permettant de régler les hyperparamètres, dont et pour TIES et pour l'arithmétique :
| Méthode | (IA) | T5-base | T5-large | ViT-B/32 | ViT-L/14 |
|---|---|---|---|---|---|
| Experts ajustés séparément | 71.4 | 82.8 | 88.8 | 90.5 | 94.2 |
| Entraînement multitâche conjoint | 73.1 | 83.6 | 88.1 | 88.9 | 93.5 |
| Fisher Merging | 62.2 | 68.9 | 64.6 | 68.3 | 82.2 |
| RegMean | 58.0 | 71.2 | 73.2 | 71.8 | 83.7 |
| Arithmétique des tâches | 63.9 | 73.2 | 73.3 | 70.1 | 84.5 |
| TIES-Merging | 66.4 | 73.9 | 76.9 | 73.6 | 86.0 |
Performance moyenne sur les tâches, d'après la Table 1 de l'article.
TIES est la meilleure fusion dans les cinq cadres, avec 0.7 à 3.6 points d'avance sur la suivante. L'écart aux deux premières lignes reste grand : ViT-B/32 donne 90.5 pour les experts et 73.6 pour TIES.
La recette fixe sans validation utilise et , choisis sur l'ajustement efficace en paramètres puis transférés aux modèles complets. Face à l'arithmétique recommandée à , TIES obtient 72.4 contre 60.4 sur ViT-B/32, 86.0 contre 83.3 sur ViT-L/14 et 74.4 contre 73.5 sur T5-large. Sur T5-base, le classement s'inverse : 69.7 contre 73.2.
Quand le nombre de tâches augmente depuis 2, l'avance de TIES sur l'arithmétique s'élargit, ce qui rejoint la hausse des conflits de signe.
Cette analyse utilise les sept tâches T5-large, avec au plus dix sous-ensembles tirés pour chaque taille. On divise chaque score par celui de l'expert, puis on moyenne uniquement sur les tâches fusionnées dans le sous-ensemble. À deux tâches, les deux méthodes approchent 1 ; ensuite, elles baissent, plus lentement pour TIES. La figure de Task Arithmetic évalue toujours les huit tâches : cette différence d'agrégation explique les directions opposées des courbes.
Et les tâches inédites ?
Les T5 fusionnés sur sept tâches sont évalués sur six jeux non ajustés : Cosmos QA, Social IQA et QuAIL en questions-réponses, WiC pour le sens des mots, COPA et H-SWAG pour la complétion. Sur T5-base, RegMean, meilleur concurrent, obtient 34.3 contre 35.3 pour TIES ; sur T5-large, 36.0 contre 40.4. Ce sont six tâches réservées, distinctes de celles à plus de soixante-dix points du tableau principal.
Plusieurs checkpoints d'une même tâche peuvent aussi interférer. Avec dix BERT Hugging Face par tâche, TIES obtient 72.2 contre 71.8 pour l'arithmétique sur RTE, 86.8 contre 86.0 sur MRPC, mais 58.8 contre 59.2 sur WNLI. Le plus souvent favorable à TIES, le classement connaît donc aussi des inversions.
Chaque étape sert-elle ?
Les auteurs retirent les composants un à un. Sans réglage du coefficient, donc avec , T5-base perd 2.5 points et (IA) 5.2. Sans moyenne disjointe, ils perdent 1.9 et 3.2 points. Retirer l'élagage ou l'élection du signe dégrade aussi les résultats, plus modestement.
Ces ablations portent sur la validation : la méthode complète vaut 74.5 pour T5-base et 70.7 pour (IA), à distinguer des tests du tableau. Sans Elect, les zéros élagués restent exclus, mais les deux signes sont moyennés ensemble. Sans Disjoint Mean, le filtrage des signes reste actif, mais les zéros entrent au dénominateur. Cela sépare annulation des directions et dilution par zéro.
Une autre expérience retourne avec probabilité les signes des 20 % ou 30 % de changements les plus grands : la performance décroît avec . Retourner les 70 % à 80 % de petits changements agit peu. Pour les grandes valeurs, la mauvaise direction détruit la tâche.
Si tous les signes étaient corrects
Les auteurs demandent enfin jusqu'où irait une fusion avec des signes parfaits.
Ils entraînent un modèle multitâche sur les onze tâches (IA) et utilisent ses signes comme oracle, sans vote. La fusion atteint 72.0 %, contre 73.1 % pour le multitâche, soit 1.1 point d'écart. Le vote TIES ordinaire donnait 66.4 %.
Ils concluent qu'une direction correcte permet presque de rejoindre l'entraînement multitâche et essaient aussi d'estimer les signes avec peu de données en annexe.
L'oracle exploite déjà le résultat multitâche : il mesure une marge d'amélioration. Avec 32 exemples par tâche, l'estimation des signes atteint seulement 66.5 en partant de zéro, ou 67.7 depuis le modèle moyen, contre 72.0 pour l'oracle complet. Obtenir les bonnes directions de façon fiable avec peu de données reste à résoudre.
Conclusion
TIES-Merging traite l'interférence par trois étapes peu coûteuses : supprimer les petits changements, choisir la direction selon l'amplitude totale, puis moyenner seulement les valeurs du même côté. La recette fixe demande des poids ajustés compatibles et leur base commune ; une recette mieux adaptée demande aussi le coût de validation.
Les expériences montrent nettement la limite : les méthodes de fusion diffèrent de quelques points, tandis que leur écart aux experts dépasse souvent dix points.
Un peu plus d'un an plus tard, Yadav et ses collaborateurs de Google réévalueront la fusion jusqu'à 64 milliards de paramètres et constateront que les différences entre méthodes se réduisent à grande taille.