Article original
Averaging Weights Leads to Wider Optima and Better Generalization
- Publication
- UAI 2018Conférence
- Premier dépôt sur arXiv
- arXiv:1803.05407
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingswa2018,
  title = {{Averaging Weights Leads to Wider Optima and Better Generalization}},
  author = {Pavel Izmailov and Dmitrii Podoprikhin and Timur Garipov and Dmitry Vetrov and Andrew Gordon Wilson},
  year = {2018},
  eprint = {1803.05407},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1803.05407}
}
Fin février 2018, Garipov, Izmailov et leurs collègues publient leur article sur la connectivité des modes, avec une méthode d'ensemble appelée FGE. En fin d'entraînement, ils passent à des cycles très courts du taux d'apprentissage, sauvegardent les poids à chaque minimum, puis moyennent les sorties des modèles sauvegardés.
FGE fournit un bon ensemble pour le temps d'entraînement d'un seul modèle. Mais à l'inférence, tous les modèles doivent être exécutés.
Deux semaines plus tard, les mêmes auteurs publient cet article. En examinant la position des instantanés FGE dans l'espace des paramètres, ils remarquent qu'ils bordent une bonne région dont le centre reste vide.
Autant moyenner directement les poids pour se placer au milieu.
Définir le problème
Moyenner les poids le long d'une trajectoire SGD est une idée ancienne. En optimisation convexe, Ruppert en 1988, puis Polyak et Juditsky en 1992 ont étudié l'accélération de la convergence par la moyenne des itérés. Pour les réseaux neuronaux, on utilise aussi une moyenne mobile exponentielle (EMA) avec un taux d'apprentissage décroissant. Selon les essais des auteurs, cette EMA donne à peu près le même résultat que SGD après convergence.
Le problème tient au taux d'apprentissage. S'il décroît continuellement, la trajectoire SGD converge vers un point ; la moyenne lisse alors surtout cette trajectoire, pour un résultat proche de celui sans moyenne.
Les auteurs veulent laisser SGD explorer davantage une bonne région avant de calculer sa moyenne. Ils cherchent aussi pourquoi ce point moyen généralise mieux.
Résoudre le problème
L'algorithme
SWA tient en quelques étapes :
- Entraîner avec le calendrier habituel, pendant environ 75 % du budget dans l'article.
- Poursuivre avec un taux constant, ou un calendrier cyclique décroissant linéairement de à .
- Toutes les itérations, incorporer les poids courants à la moyenne. Avec un taux cyclique, correspond à un cycle et l'échantillonnage intervient au taux minimal :
- Utiliser comme modèle final.
L'étape 3 est une moyenne arithmétique incrémentale. compte les points déjà incorporés, en partant de 0. Le premier devient directement la moyenne ; avec le deuxième, chacun compte pour moitié. Au troisième, l'ancienne moyenne est pondérée par et le nouveau point par : chacun des trois compte finalement pour . On évite de sauvegarder tous les poids, et tous les points ont le même poids, contrairement à l'EMA qui privilégie les plus récents.
Il faut distinguer les calendriers cycliques. SWA effectue uniquement une descente linéaire dans chaque cycle, puis revient immédiatement à la borne haute :
Le triangle de FGE comporte aussi une remontée progressive. SWA l'omet : seule la qualité de la moyenne finale compte, les instantanés intermédiaires peuvent être un peu moins précis. Un taux constant permet des déplacements plus grands et peut dégrader chaque point pris séparément tout en donnant une bonne moyenne.
Sur CIFAR, VGG et WRN utilisent un taux constant de 0.01 pendant SWA. Preactivation ResNet utilise 0.01 sur CIFAR-10 et 0.05 sur CIFAR-100, avec un prélèvement à chaque époque. PyramidNet utilise des cycles de 3 époques, de 0.05 à 0.001. Ces réglages sont associés aux architectures étudiées ; en pratique, le début de la moyenne et le taux doivent être choisis sur ses propres données de validation.
Recalculer BatchNorm
Un détail se laisse facilement oublier. Les moyennes et variances accumulées par BatchNorm pendant l'entraînement correspondent aux différents , pas à . Après l'entraînement, les auteurs font une passe avant supplémentaire sur les données d'entraînement avec pour les réestimer.
PyTorch a ensuite intégré moyenne incrémentale et réestimation dans torch.optim.swa_utils. Regardons la différence avec un petit réseau composé d'une couche linéaire et de BatchNorm. Les poids linéaires de deux instantanés valent respectivement une et trois fois la matrice identité :
import torch
from torch import nn
from torch.utils.data import DataLoader
from torch.optim.swa_utils import AveragedModel, update_bn

model = nn.Sequential(nn.Linear(2, 2, bias=False), nn.BatchNorm1d(2))
swa_model = AveragedModel(model)
with torch.no_grad():
    for scale in [1.0, 3.0]:
        model[0].weight.copy_(scale * torch.eye(2))
        swa_model.update_parameters(model)

print("平均權重:", swa_model.module[0].weight.tolist())
print("重算前的均值:", swa_model.module[1].running_mean.tolist())
loader = DataLoader(torch.tensor([[1., 2.], [3., 4.]]), batch_size=2)
update_bn(loader, swa_model)
print("重算後的均值:", swa_model.module[1].running_mean.tolist())
平均權重: [[2.0, 0.0], [0.0, 2.0]]
重算前的均值: [0.0, 0.0]
重算後的均值: [4.0, 6.0]
La couche linéaire du modèle moyen vaut . Les deux entrées deviennent donc et avant BatchNorm, d'où une moyenne attendue de . Moyenner les paramètres apprenables laisse la running mean à ; update_bn l'ajuste aux nouveaux poids. Cet exemple illustre seulement la mise à jour des statistiques, sans entraîner de classificateur.
En entraînement réel, on continue à mettre à jour le modèle d'origine par gradient pendant la phase SWA, et on appelle update_parameters à la fréquence choisie. Une fois la moyenne terminée, on exécute update_bn, puis on passe en eval() pour l'évaluation. Cette réestimation utilise les données d'entraînement, sans étiquettes ni rétropropagation.
Pourquoi la moyenne des poids ressemble à un ensemble
FGE moyenne les sorties, SWA les poids. Quand les deux donnent-ils des résultats proches ? Les auteurs répondent par un développement au premier ordre.
Soient les instantanés FGE, leur moyenne et leurs écarts à cette moyenne. Ainsi, . Développons la sortie au voisinage de :
En moyennant sur , les termes du premier ordre s'annulent : . Il reste un terme du second ordre :
Si les points sont assez proches, l'écart entre la sortie de l'ensemble et celle des poids moyens est donc une petite quantité quadratique. FGE recherche justement ses points par petits déplacements : SWA peut ainsi approcher l'ensemble FGE avec un seul modèle.
Il faut aussi que soit suffisamment lisse localement et que le reste du second ordre soit petit. Avec des modèles éloignés, voire issus d'initialisations indépendantes, les deviennent grands et ce développement ne justifie plus la proximité des deux sorties. SWA collecte des points dans la dernière partie d'une même trajectoire d'entraînement.
Les auteurs exécutent 20 époques de FGE sur ResNet-164 et CIFAR-100. La norme moyenne de la différence entre les vecteurs de probabilités de deux instantanés voisins vaut 0.126, contre 0.079 entre SWA et l'ensemble FGE. Les prédictions de classe d'instantanés voisins coïncident au plus à 87.33 %, contre 95.26 % entre SWA et l'ensemble. Ces mesures donnent un pendant expérimental à l'annulation du premier ordre : les sorties sont proches, avec un écart résiduel.
Discussion
SGD reste au bord
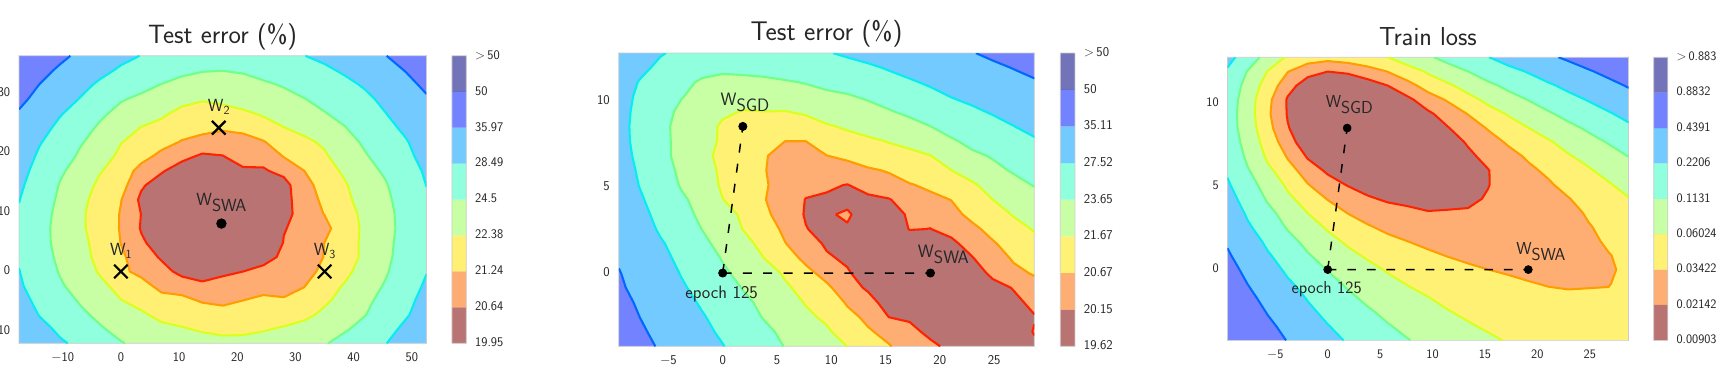
Cette figure porte sur Preactivation ResNet-164 et CIFAR-100. À gauche, la motivation apparaît directement : les trois points FGE entourent la région rouge et leur moyenne tombe au milieu.
Il faut lire ensemble les panneaux du centre et de droite. Les deux procédures partent des mêmes poids à l'époque 125, puis poursuivent avec SGD ou SWA. Dans la perte d'entraînement à droite, est déjà dans la bonne région, mais à son bord. Dans l'erreur de test au centre, est plus près de la zone d'erreur minimale.
Les paysages de perte d'entraînement et d'erreur de test sont légèrement décalés. Au bord de la bonne région, ce décalage suffit à augmenter l'erreur de test ; au milieu, il reste davantage de marge.
Deux expériences étayent cette interprétation. La première déplace chaque solution dans 10 directions aléatoires. Dans la figure suivante, l'abscisse est la distance parcourue ; à gauche, on mesure l'erreur de test, à droite la perte d'entraînement. Le bleu représente SWA, le vert SGD, et chaque ligne une direction.
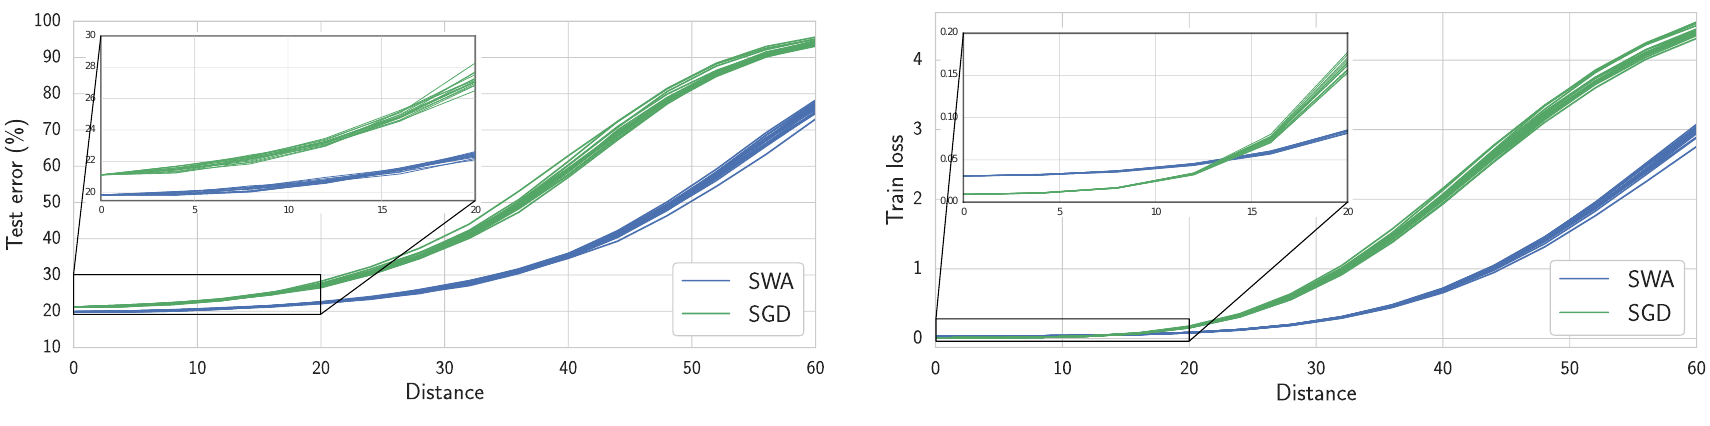
À distance 0, les pertes d'entraînement sont proches, celle de SGD étant même légèrement inférieure. Mais les courbes SWA sont bien plus larges : il faut aller plus loin pour obtenir la même hausse d'erreur. Cette coupe examine la sensibilité aux déplacements autour de chaque solution.
La seconde expérience examine le segment de à . Perte d'entraînement et erreur de test y sont nettement décalées ; se situe au bord d'une région plate, près d'une pente raide. Les auteurs concluent que SWA et SGD occupent le même bassin, mais que SWA trouve une position plus plate à l'intérieur. Sa perte d'entraînement est souvent un peu supérieure ; au sens strict, ce point n'est pas un minimum local de la perte.
CIFAR et ImageNet
Sur CIFAR, l'entraînement habituel occupe environ 75 % du budget, puis SWA utilise le reste. Sur CIFAR-100 avec Preactivation ResNet-164, SGD atteint 78.49 %, contre 79.77 % pour SWA à budget total identique, presque autant que les 79.84 % de l'ensemble FGE, avec un seul modèle à l'inférence. À 1.5 fois le budget, SWA atteint 80.35 %. VGG-16 passe de 72.55 % à 73.91 %, WRN-28-10 de 80.82 % à 81.46 %. SWA Table 1
Sur ImageNet, les auteurs reprennent directement les modèles préentraînés de torchvision et ajoutent 5 ou 10 époques avec un taux cyclique :
| Modèle | SGD | SWA 5 époques | SWA 10 époques |
|---|---|---|---|
| ResNet-50 | 76.15 | 76.83 ± 0.01 | 76.97 ± 0.05 |
| ResNet-152 | 78.31 | 78.82 ± 0.01 | 78.94 ± 0.07 |
| DenseNet-161 | 77.65 | 78.26 ± 0.09 | 78.44 ± 0.06 |
Précision top-1 (%), d'après la Table 2 de l'article.
Les trois architectures gagnent de 0.6 à 0.9 point, pour une petite fraction de l'entraînement initial.
Lire séparément budget et platitude
Le budget identique concerne VGG, ResNet et WRN. Pour PyramidNet et Shake-Shake, les auteurs terminent d'abord tout le budget standard, puis ajoutent 0.25 ou 0.5 budget avec SWA : l'article ne donne donc pas de résultat à pour ces modèles. Sur CIFAR-100, PyramidNet-272 passe de 83.41 % pour SGD à 84.16 % à . Sur CIFAR-10, Shake-Shake passe de 96.93 % à 97.16 % à , puis à 97.12 % à . Prolonger l'entraînement et la moyenne finit aussi par apporter moins de bénéfices.
Les coûts supplémentaires sont un jeu de poids moyens en mémoire pendant l'entraînement, une mise à jour paramètre par paramètre à chaque prélèvement, puis une passe avant pour réestimer BatchNorm. Au déploiement, seul le modèle moyen reste : le nombre de paramètres et le calcul par inférence reviennent à ceux du modèle initial. Les auteurs mesurent un faible surcoût mémoire en vision, où les activations occupent beaucoup de place ; si les poids dominent la mémoire, il faut évaluer séparément le coût de leur copie.
Revenons à la platitude. L'article mesure 10 directions aléatoires dans une représentation donnée des paramètres, ainsi que la direction particulière de SGD vers SWA. Cette dernière révèle notamment un côté raide et un côté plus plat près de . Un changement d'échelle des paramètres peut modifier la largeur visuelle du paysage ; les auteurs discutent donc aussi les limites d'une explication de la généralisation par la seule platitude. Ces expériences soutiennent l'interprétation géométrique pour les architectures et réglages étudiés ; la précision de validation reste à mesurer directement pour son propre usage.
Conclusion
SWA est simple : maintenir un taux assez élevé en fin d'entraînement, moyenner les poids visités, puis recalculer BatchNorm. L'idée l'est aussi : SGD s'arrête au bord d'une bonne région et la moyenne ramène le modèle vers son centre.
En pratique, l'oubli le plus facile concerne la dernière étape. Si le réseau utilise BatchNorm, pensez à exécuter update_bn après la moyenne pour ajuster les statistiques aux nouveaux poids.
Cette moyenne fera du chemin. Dans le rapport technique de Llama 3 en 2024, c'est la première référence citée pour la moyenne de modèles pendant le post-entraînement.