Article original
Model Merging in Pre-training of Large Language Models
- Publication
- NeurIPS 2025Conférence
- Premier dépôt sur arXiv
- arXiv:2505.12082
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingpretrainingmerging2025,
  title = {{Model Merging in Pre-training of Large Language Models}},
  author = {Yunshui Li and Yiyuan Ma and Shen Yan and Chaoyi Zhang and Jing Liu and Jianqiao Lu and Ziwen Xu and Mengzhao Chen and Minrui Wang and Shiyi Zhan and Jin Ma and Xunhao Lai and Deyi Liu and Yao Luo and Xingyan Bin and Hongbin Ren and Mingji Han and Wenhao Hao and Bairen Yi and LingJun Liu and Bole Ma and Xiaoying Jia and Xun Zhou and Siyuan Qiao and Liang Xiang and Yonghui Wu},
  year = {2025},
  eprint = {2505.12082},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2505.12082}
}
Quand on préentraîne un grand modèle de langage, le plus pénible est de ne pas savoir à quel point il sera bon au bout du compte.
Le calendrier de taux d'apprentissage le plus courant aujourd'hui s'appelle WSD (Warmup-Stable-Decay). Un bref échauffement, puis un long entraînement à taux constant, et enfin une baisse du taux pour le « recuit ». Le problème, c'est que les checkpoints de la phase à taux constant ont toujours des scores un peu bas ; il faut attendre la fin du recuit pour voir le niveau final du modèle. Pour savoir si l'entraînement va dans la bonne direction, il faut lancer une branche séparée et la recuire, ce qui coûte chaque fois de quelques dizaines à plus d'une centaine de milliards de tokens supplémentaires.
La plupart des recherches sur la fusion de modèles interviennent après l'ajustement fin et réunissent des modèles de tâches différentes. La fusion pendant le préentraînement est une autre affaire : elle porte sur les checkpoints d'une même trajectoire d'entraînement. Les rapports techniques de Llama 3 et de DeepSeek-V3 mentionnent tous deux ce genre de technique, sans en donner les détails ; et la plupart des chercheurs n'ont pas accès aux checkpoints intermédiaires d'un préentraînement à grande échelle, ce qui rend l'étude difficile.
Cet article de ByteDance Seed entraîne depuis zéro une série de modèles denses et MoE, jusqu'à 200B paramètres au total, pour mesurer en détail la fusion de checkpoints pendant le préentraînement. Les auteurs appellent cette approche PMA (Pre-trained Model Average).
Définir le problème
La fusion porte sur checkpoints sauvegardés successivement le long d'une même trajectoire d'entraînement ; le modèle fusionné est leur somme pondérée :
Deux checkpoints voisins sont séparés par une quantité d'entraînement fixe , comptée en tokens. Par exemple, et désignent les 10 checkpoints sauvegardés tous les 8B tokens sur les 80B derniers tokens.
Pour les poids , l'article compare trois approches courantes :
- SMA (moyenne mobile simple) : tous les checkpoints pèsent autant, .
- EMA (moyenne mobile exponentielle) : calcul récursif ; plus un checkpoint est récent, plus il pèse, et plus est grand, plus les plus récents dominent.
- WMA (moyenne mobile pondérée) : les poids croissent linéairement, par exemple , puis sont normalisés par leur somme.
Pour , les poids de SMA sont et ceux de WMA .
Les auteurs découpent l'étude en six questions : l'effet de la fusion sur les performances, la meilleure méthode de fusion, le choix de l'intervalle et du nombre de checkpoints, l'intérêt du modèle fusionné comme point de départ de l'étape suivante, l'amélioration de la stabilité de l'entraînement, et les raisons de l'efficacité de la fusion.
Les expériences utilisent un corpus et des architectures internes. Les modèles MoE vont de 0.7B/7B (paramètres activés / paramètres totaux) à 20B/200B, les modèles denses de 411M à 70B. L'évaluation couvre seize benchmarks publics, dont MMLU, BBH, GSM8K et HumanEval ; la plupart des graphiques rapportent leur moyenne pondérée.
Résoudre le problème
Phase à taux constant : une simple moyenne fait mieux
La première expérience est la plus simple. Après une période d'entraînement à taux constant, on moyenne les checkpoints et on compare le résultat au checkpoint le plus récent.
Les modèles MoE des quatre tailles progressent nettement. Le HumanEval de Seed-MoE-1.3B/13B passe de 31.1 à 36.6, celui de Seed-MoE-10B/100B de 54.3 à 61.6. Les grands modèles progressent moins sur des benchmarks proches de la saturation comme BBH. Les modèles denses de l'annexe se comportent de même : Seed-Dense-70B passe de 50.6 à 57.9 sur HumanEval et de 85.9 à 91.3 sur GSM8K, et les gains ne diminuent pas avec la taille du modèle.
C'est la même intuition que SWA en 2018. Avec un taux d'apprentissage constant et plutôt élevé, le modèle oscille autour du fond de la vallée, et chaque checkpoint s'arrête à un endroit différent de ses parois ; leur moyenne se rapproche du centre du fond.
Phase de recuit : une moyenne précoce rattrape l'arrivée
La deuxième expérience fusionne pendant la phase de recuit. Le taux d'apprentissage descend selon une courbe cosinus, et les scores du modèle montent continûment.
Fait intéressant, fusionner les checkpoints dès le début du recuit donne déjà des scores proches de ceux de la fin du recuit ; pour les plus grands modèles, cela dépasse même parfois le résultat d'un recuit mené naturellement à son terme.
D'où une question plus audacieuse. Si la fusion peut produire l'effet du recuit, peut-on se passer complètement du recuit ?
Pas de recuit, seulement la fusion
Les auteurs font bifurquer Seed-MoE-1.3B/13B à 1.4T tokens en deux entraînements, l'un à taux constant, l'autre avec recuit, chacun poursuivi sur 250B tokens. Ils fusionnent ensuite les checkpoints de la branche à taux constant.
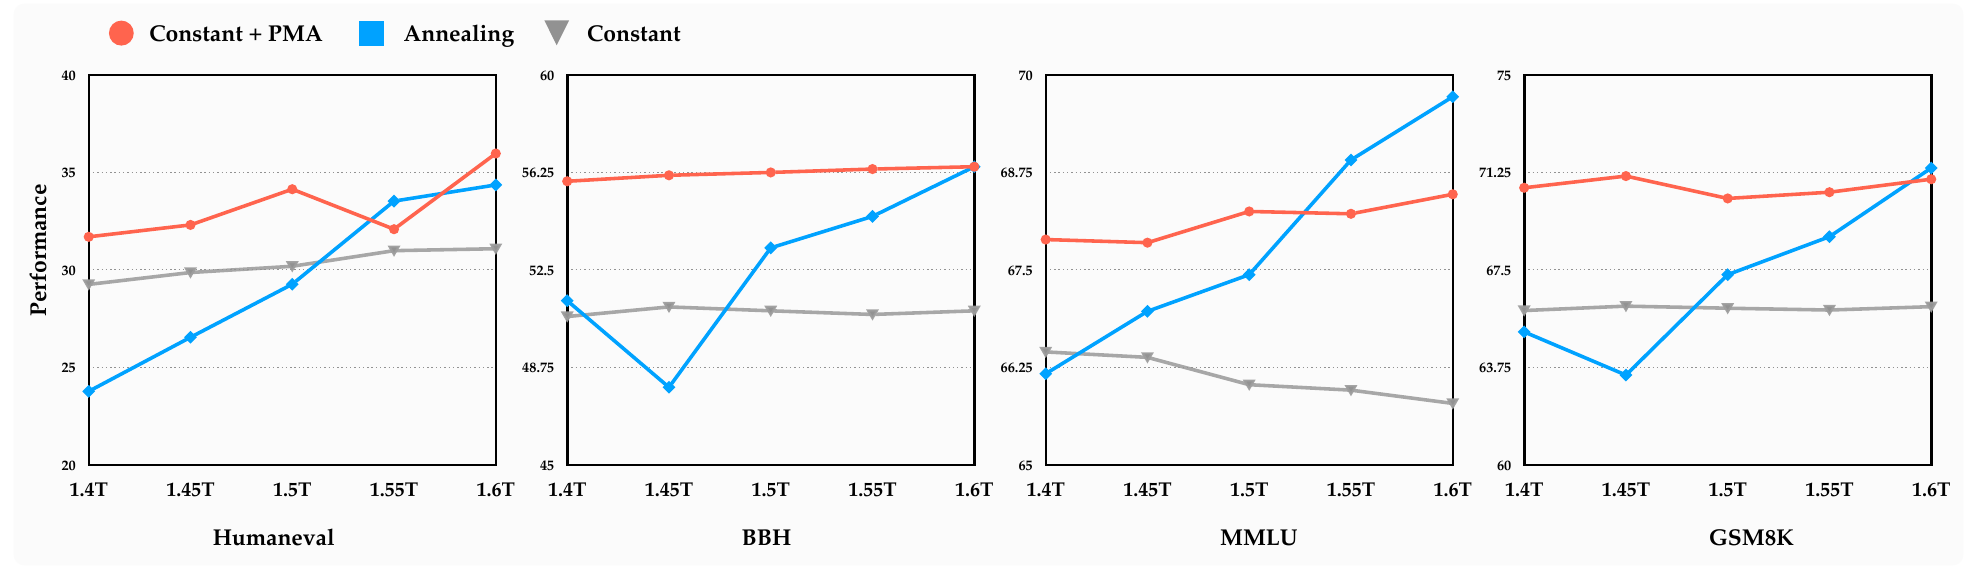
Regardons d'abord les lignes grise et rouge. Toutes deux à taux constant, la grise, sans fusion, ne progresse presque pas, et baisse même continûment sur MMLU ; la rouge, fusionnée, part d'un cran plus haut.
Puis la ligne bleue. Au début du recuit, les scores sont généralement plus bas ; sur BBH et MMLU, ils chutent même d'abord avant de remonter continûment. À 1.6T, rouge et bleu sont à peu près au même niveau sur HumanEval, BBH et GSM8K, alors que sur MMLU le recuit est nettement devant, d'environ deux points.
Les auteurs concluent qu'un taux constant avec fusion permet, à tout moment de l'entraînement, de prédire approximativement les performances après recuit, ce qui en fait une vérification rapide très rentable. Cette conclusion tient sur trois benchmarks ; MMLU fait exception, ce qu'il faut garder en tête en lisant la figure.
Comment fusionner : méthode, intervalle, nombre
Méthode. Sur Seed-MoE-1.3B/13B, à 204B tokens d'entraînement, les trois méthodes font mieux qu'avant la fusion ; WMA est la meilleure, et EMA avec bat aussi . Au début de l'entraînement, les poids changent beaucoup, et les checkpoints les plus récents méritent un coefficient plus élevé. Plus tard, l'écart entre les trois méthodes disparaît presque. Les auteurs utilisent ensuite la plus simple, SMA.
Intervalle . Avec fixé, vaut 4B, 8B, 16B ou 32B tokens. Tôt dans l'entraînement (204B tokens), les intervalles de 16B et 32B font même moins bien que l'absence de fusion : en remontant trop loin, on mêle des poids encore très instables du début de l'entraînement. Plus l'entraînement avance, plus les écarts entre intervalles se réduisent.
Les auteurs en tirent une valeur empirique qui croît avec la taille du modèle : environ 4B tokens pour 0.7B/7B, 8B pour 1.3B/13B, 80B pour 10B/100B. Les grands modèles utilisent généralement des lots plus grands, ce qui allonge aussi l'intervalle entre checkpoints.
Nombre . Avec fixé, on compare 3, 6, 10 et 15 checkpoints. Tôt dans l'entraînement, en prendre trop mêle là encore des poids instables ; plus tard, plus il y en a, mieux c'est, dépassant de près d'un point. Les auteurs retiennent comme compromis.
Le modèle fusionné comme point de départ de l'étape suivante
Après le préentraînement viennent généralement l'entraînement continu (continued training, CT), le SFT et l'apprentissage par renforcement. Les auteurs utilisent les poids fusionnés comme point de départ de l'étape suivante, et appellent cela PMA-init.
Phase CT. Sur Seed-MoE-0.7B/7B, on fusionne après environ 1T tokens d'entraînement, puis on enchaîne le CT. PMA-init part d'une perte légèrement plus basse et fait un peu mieux sur MMLU au début ; mais plus tard, les deux pertes convergent à peu près au même niveau, et les scores globaux s'égalisent. Avec plusieurs calendriers de taux d'apprentissage, la conclusion reste la même.
Phase SFT. Sur Seed-MoE-15B/150B, on effectue un SFT de 220M tokens à partir des poids fusionnés. À taux d'apprentissage égal, PMA-init fait passer MMLU de 86.8 à 87.1, LiveBench de 50.5 à 52.0 et AMC-2023 de 61.0 à 64.0 ; les évaluations internes OOD et de suivi d'instructions gagnent chacune plus de deux points.
Mais les auteurs écrivent honnêtement que des gains de cet ordre n'ont pas pu être reproduits sur d'autres tailles de modèles. PMA-init ne nuit pas aux performances en aval et aide parfois, sans garantie que ce soit à chaque fois.
Rattraper les explosions de perte
PMA-init a un autre usage, plus inattendu.
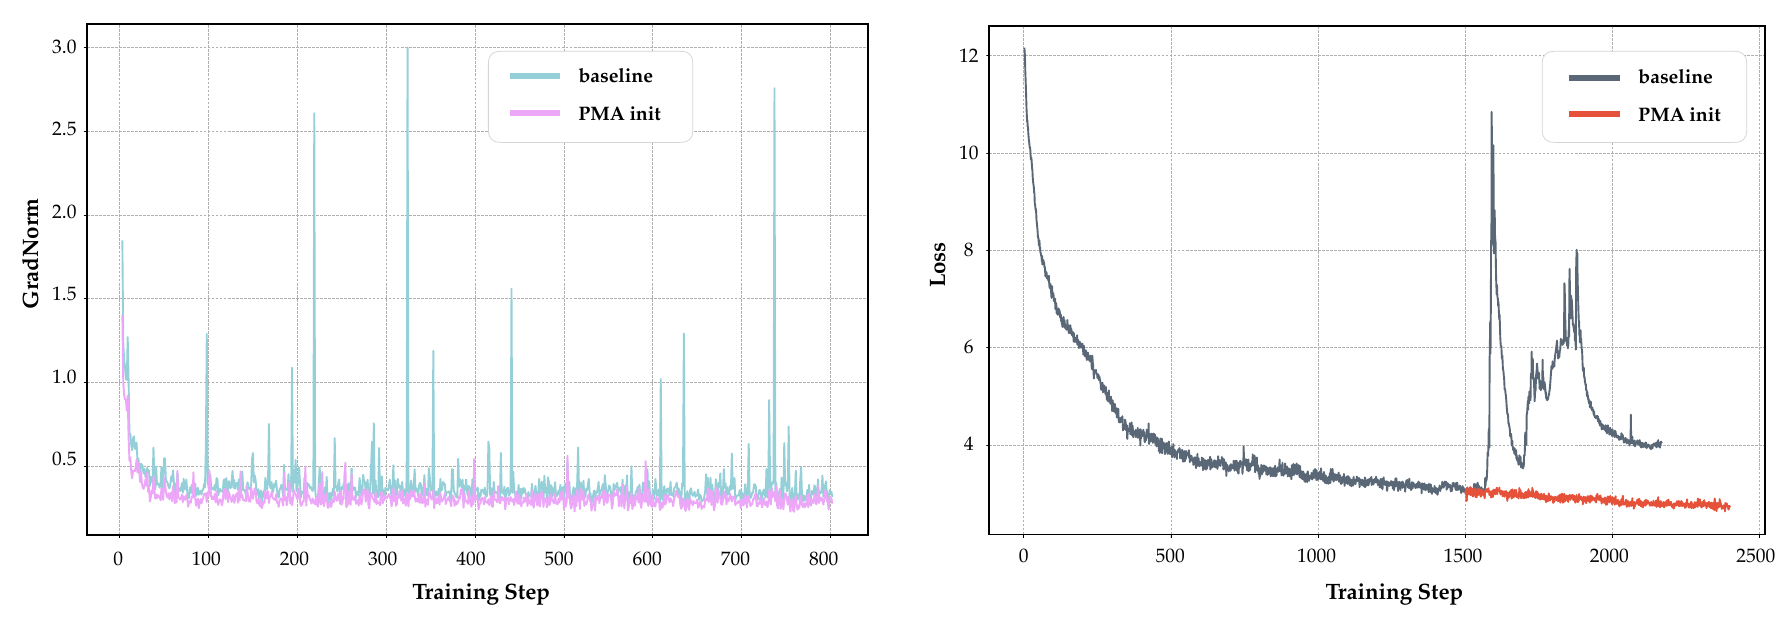
La figure de gauche montre la norme du gradient pendant le SFT ; la courbe PMA-init est nettement plus stable et présente aussi moins de pics de perte.
La figure de droite montre un entraînement rendu instable à dessein par les auteurs. Étudier directement les explosions de perte sur un grand modèle coûterait trop cher ; ils utilisent donc un petit modèle MoE 330M/3.3B, avec un taux d'apprentissage particulièrement élevé de 6e-3, pour reproduire les explosions fréquentes dans les grands modèles. Après l'explosion, l'entraînement d'origine ne retrouve plus jamais sa trajectoire. Les auteurs fusionnent les trois checkpoints sauvegardés avant l'explosion et repartent de là ; l'entraînement franchit alors sans encombre l'endroit où il avait déraillé.
Cela offre une option pratique pour l'entraînement à grande échelle. Face à une explosion de perte dont on ne se remet pas, inutile de revenir à un checkpoint très ancien ou de tout recommencer ; on peut d'abord moyenner les quelques checkpoints qui précèdent l'explosion, puis reprendre l'entraînement.
Discussion
Pourquoi la moyenne fait mieux
Les auteurs s'appuient sur un développement au second ordre de la perte autour de l'optimum . Notons l'écart de chaque checkpoint à l'optimum et la matrice hessienne ; le gradient étant nul à l'optimum,
L'écart du modèle moyen vaut . En développant et en comparant les deux côtés, la perte du modèle fusionné est inférieure à la moyenne des pertes individuelles si
Le membre de droite est forcément positif quand est définie positive. Si les termes croisés du membre de gauche sont surtout négatifs, c'est-à-dire si les checkpoints s'écartent de l'optimum dans des directions « complémentaires », la condition est facilement remplie.
Essayons le cas le plus extrême avec deux checkpoints. Si , les deux points sont de part et d'autre de l'optimum, leur moyenne tombe exactement sur , et la perte atteint son minimum . Si , les deux points coïncident et la moyenne n'apporte rien.
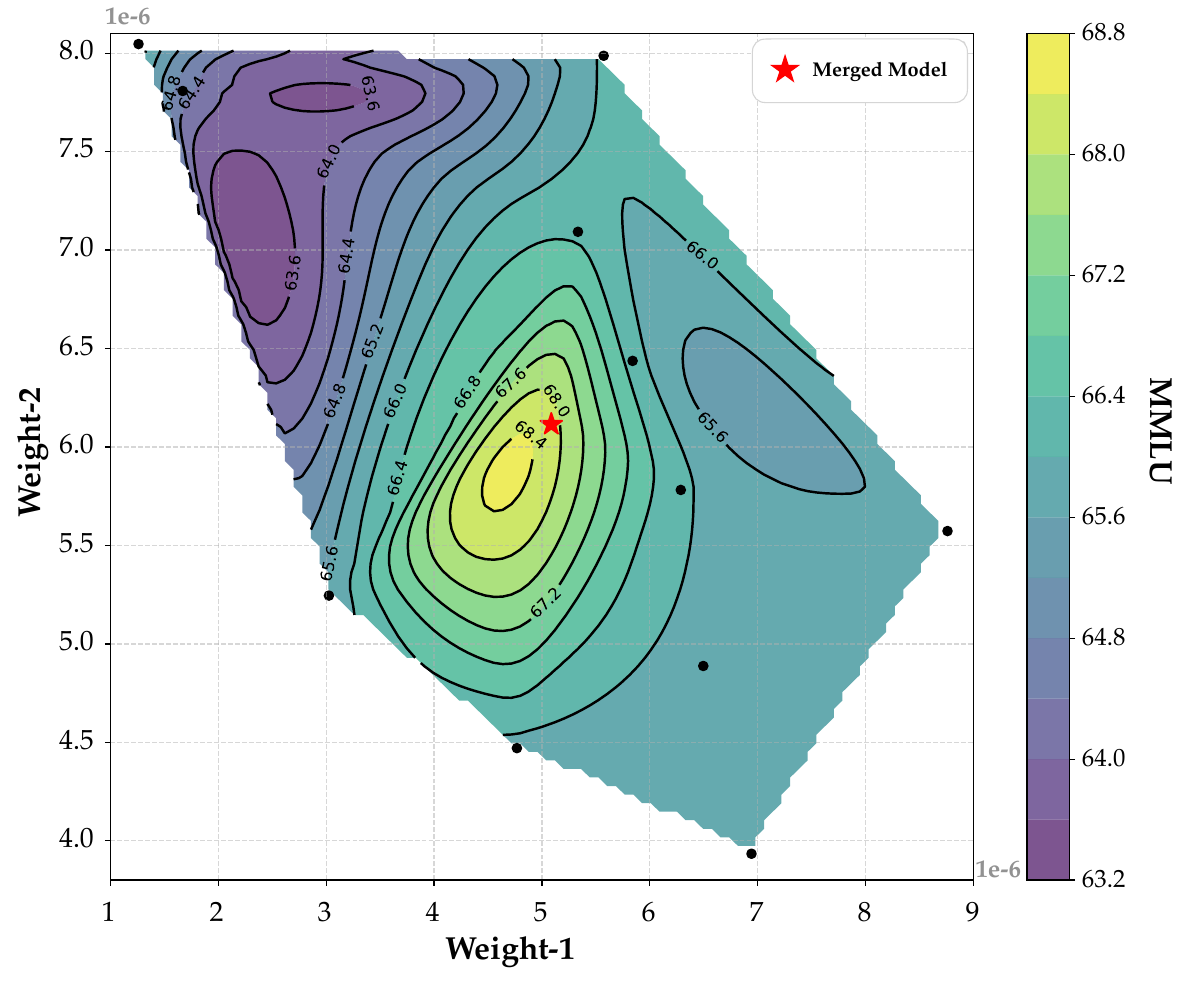
Les auteurs tracent aussi deux paramètres choisis dans une couche de Seed-MoE-1.3B/13B. Les checkpoints sont dispersés autour de la zone de score élevé, et l'étoile rouge de la moyenne se rapproche du centre.
Cela explique aussi l'effet limité de la fusion des checkpoints après recuit. Quand le taux d'apprentissage est très bas, les checkpoints sont déjà tous serrés dans le même petit fond de vallée ; leurs écarts ne sont plus complémentaires, et la moyenne ne peut plus en sortir.
Cette analyse repose toutefois sur bien des hypothèses. Elle suppose que les checkpoints sont tous proches d'un même optimum, que l'approximation au second ordre tient et que la hessienne est définie positive ; dans un préentraînement non convexe, tout cela n'est qu'approximatif. La carte de contours à deux paramètres n'est qu'une petite coupe d'un espace de très grande dimension, et les auteurs eux-mêmes ne s'en servent que comme illustration intuitive.
Points d'attention à la lecture
Modèles, architectures et corpus sont tous internes, donc impossibles à reproduire. L'indicateur principal est une moyenne pondérée de seize benchmarks, dont les poids ne sont pas publiés. Les valeurs empiriques d'intervalle proviennent de trois tailles de modèles MoE ; avec une autre taille de lot ou un autre mélange de données, elles ne s'appliquent pas forcément.
En revanche, l'échelle expérimentale de cet article est rare dans la littérature publique. Des ablations allant de quelques centaines de millions de paramètres à deux cents milliards de paramètres au total en font une référence très concrète pour les équipes qui veulent ajouter la moyenne de checkpoints à leur propre préentraînement.
Quelques mois plus tard, WSM va plus loin dans la même direction, en remplaçant entièrement la décroissance du taux d'apprentissage par la fusion de checkpoints.
Conclusion
Cet article fait passer « moyenner des checkpoints pendant le préentraînement » d'une phrase de rapport technique à des résultats expérimentaux assortis d'ablations systématiques.
En phase à taux constant, moyenner les checkpoints récents améliore nettement les scores et prédit à peu près les performances après recuit. SMA suffit, l'intervalle s'agrandit avec la taille du modèle, et en fin d'entraînement, un peu plus de checkpoints vaut mieux. PMA-init ne nuit pas aux performances en CT ni en SFT, et peut même remettre sur les rails un entraînement après une explosion de perte dont il ne se serait pas remis.
Si vous voulez jeter un œil aux résultats à mi-chemin du préentraînement, moyennez d'abord les dix derniers checkpoints. Les centaines de milliards de tokens du recuit peuvent bien attendre un peu.