Article original
What Matters for Model Merging at Scale?
- Publication
- Transactions on Machine Learning Research 2025Revue
- Premier dépôt sur arXiv
- arXiv:2410.03617
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingmergingatscale2024,
  title = {{What Matters for Model Merging at Scale?}},
  author = {Prateek Yadav and Tu Vu and Jonathan Lai and Alexandra Chronopoulou and Manaal Faruqui and Mohit Bansal and Tsendsuren Munkhdalai},
  year = {2024},
  eprint = {2410.03617},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2410.03617}
}
Les premiers travaux de fusion portent souvent sur CLIP, ViT, T5 ou BERT, avec parfois des modèles visuels ou linguistiques plus grands ; DARE a déjà fusionné des experts 7B et 13B. Mais qualité de la base, taille, nombre d'experts et méthode sont rarement comparés dans une même grille. Les astuces utiles dans les petits cadres le restent-elles à grande échelle ?
En 2024, la fusion figure pourtant déjà dans les entraînements de grands modèles. L'article cite les rapports de Llama 3 et de Gemma 2. Il faut donc vérifier ce qui se transpose.
Pendant son stage chez Google, Prateek Yadav, premier auteur de TIES-Merging à UNC, mène cette étude avec Tu Vu, Jonathan Lai, Alexandra Chronopoulou, Manaal Faruqui, Tsendsuren Munkhdalai, de Google et de Virginia Tech, et Mohit Bansal d'UNC. PaLM-2 permet de tester jusqu'à 64 milliards de paramètres.
Définir le problème
Quatre questions guident l'étude :
- Vaut-il mieux construire les experts depuis un modèle seulement préentraîné ou déjà ajusté aux instructions ?
- La taille facilite-t-elle la fusion ?
- Quel effet sur les capacités zéro-shot de tâches non apprises ?
- Combien d'experts peut-on réunir sans forte perte, et comment cela dépend-il de la taille ?
Résoudre le problème
Le plan expérimental
L'article propose une étude, sans nouvelle méthode.
Bases : PaLM-2 et sa version ajustée aux instructions PaLM-2-IT, en 1B, 8B, 24B et 64B.
Experts : huit familles de tâches T0, dites held-in, donnent chacune un expert par ajustement complet. D'autres tâches, held-out, sont réservées pour mesurer la généralisation zéro-shot.
Fusions : 2, 4, 6 ou 8 experts ; trois graines tirent les sous-ensembles pour chaque configuration et les résultats sont moyennés.
Méthodes : quatre approches sans information supplémentaire, applicables à des dizaines de milliards de paramètres : moyenne simple, arithmétique des tâches, TIES-Merging et DARE avec TIES, appelé Dare-TIES. Les approches exigeant matrice de Fisher, rétropropagation ou activations sont exclues.
Références : les experts et un modèle multitâche entraîné sur le mélange des huit familles.
La grille comporte experts, puis configurations de fusion, et environ neuf mille évaluations avec les références. Les trois graines choisissent quels experts fusionner ; elles ne réentraînent pas chaque expert trois fois. Les mêmes sous-ensembles sont partagés entre tailles, bases et méthodes pour éviter un avantage dû au hasard des tâches tirées.
Ce que savent les experts
Les huit familles held-in comportent 16 jeux, deux chacune : questions à choix multiples, questions-réponses extractives et à livre fermé, sentiment, thèmes, données structurées vers texte, résumé et paraphrase. Le résumé utilise par exemple CNN/DailyMail et XSum ; la paraphrase MRPC et QQP. Fusionner questions-réponses et résumé conduit à évaluer held-in seulement sur leurs quatre jeux.
Held-out comporte quatre familles et sept jeux : complétion COPA et HellaSwag, inférence ANLI et RTE, coréférence WSC et Winogrande, sens des mots WiC. Toutes les fusions passent les mêmes tâches réservées pour vérifier le transfert après spécialisation.
PaLM-2-IT est construit par un ajustement FLAN-v2 allant jusqu'à 60 000 étapes, après retrait des tâches du mélange T0. Chaque expert est ensuite ajusté intégralement, par défaut pendant 2 000 étapes avec un taux de et un dropout de 0.05, avec des durées adaptées à la convergence de certaines tâches. Cette version IT est donc propre à la comparaison ; les données d'experts relativement limitées comptent dans l'interprétation de l'effet d'échelle.
Lire les scores
Tout est normalisé. Held-in divise le score par celui de l'expert correspondant : 1 signifie l'égaler. Held-out divise par le score de la base : 1 signifie conserver son niveau et plus de 1 l'améliorer sur des tâches inédites.
Un expert à 80 et une fusion à 72 donnent 0.9 en held-in. Une base à 40 et une fusion à 44 donnent 1.1 en held-out : 10 % de mieux relativement, mais 4 points bruts. Avec des mesures comme celles du résumé, un écart normalisé de 0.1 n'est pas convertible uniformément en dix points de précision.
On moyenne d'abord les scores normalisés des jeux au sein d'une famille, puis les familles et les trois graines. Chaque famille a ainsi le même poids. Une moyenne directe de tous les jeux sous-pondérerait notamment la famille de WiC, qui n'en contient qu'un.
Discussion
Partir d'une base ajustée aux instructions
Pour toutes les méthodes, tailles et nombres d'experts, les experts PaLM-2-IT fusionnés font mieux en held-in que ceux de PaLM-2. L'écart augmente avec le nombre d'experts.
Les auteurs reprennent l'hypothèse d'Ortiz-Jimenez et al. : un ajustement d'instructions à grande échelle pourrait mieux découpler les poids et réduire les conflits entre tâches. Ils conseillent la meilleure base disponible, dont les capacités zéro-shot peuvent servir d'indicateur.
La taille facilite la fusion
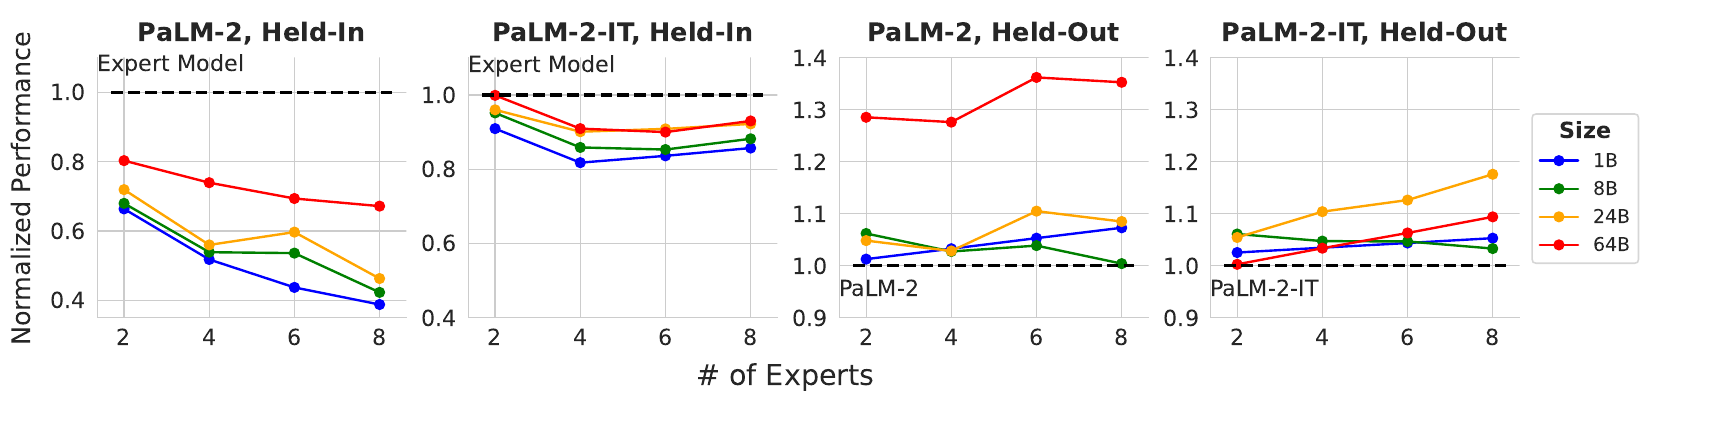
Dans les deux panneaux held-in, du bleu 1B au rouge 64B, les grandes tailles sont généralement meilleures. Les grandes bases IT se fusionnent le mieux : PaLM-2-IT 64B rejoint presque les experts.
L'annexe chiffre aussi la capacité à ajouter des experts. Avec l'arithmétique, PaLM-2 8B passe de 0.68 à 0.42 entre 2 et 8 experts ; PaLM-2-IT 8B de 0.95 à 0.88. En IT 64B, les valeurs sont 1.00 et 0.93. Taille et qualité de base réduisent la perte, mais huit experts coûtent encore environ 7 % de rétention moyenne.
La fusion améliore aussi le transfert
À droite, la plupart des valeurs held-out dépassent 1 : la fusion généralise mieux que la base sur des tâches non apprises.
Les tendances diffèrent. Pour PaLM-2, le nombre d'experts agit peu, mais 64B gagne environ 30 % ; les auteurs l'attribuent surtout à sa faible base zéro-shot, avec beaucoup de marge. Pour PaLM-2-IT, plus d'experts aide, surtout en 24B et 64B ; ils supposent une annulation accrue de leurs bruits respectifs.
Face au multitâche, PaLM-2-IT 64B fusionné avec huit experts par arithmétique obtient 1.09 en held-out, contre 1.05 pour le multitâche. Mais son held-in vaut 0.93, contre 0.99 : le meilleur transfert moyen s'accompagne d'un compromis sur les tâches apprises. À 24B et huit experts, held-out vaut 1.18 pour l’arithmétique et 1.18 pour le multitâche. Ces deux cas doivent rester distincts.
La méthode compte moins
Avec PaLM-2-IT 64B, les quatre fusions ont presque les mêmes held-in et held-out, quel que soit le nombre d'experts.
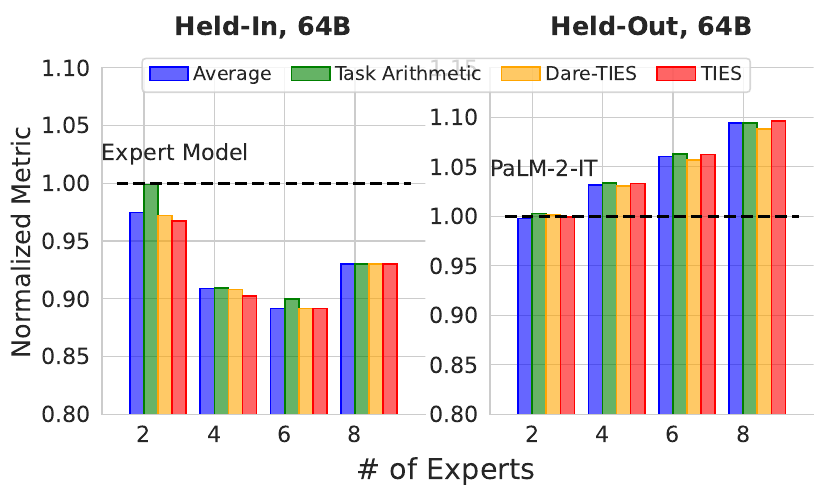
Chaque groupe de 2, 4, 6 ou 8 experts comporte quatre barres. À gauche, la référence est l'expert ; à droite, la base IT. Le même 1 change donc de référence. Le held-in reste un peu sous les experts et le held-out monte au-dessus de la base, avec très peu d'écart entre méthodes.
Selon les auteurs, de grands modèles spécialisés avec relativement peu de données sont fortement surparamétrés. Les traitements d'interférence TIES ou la suppression DARE, utiles à petite échelle, deviennent moins décisifs. Une moyenne simple peut suffire pour ces grands experts IT.
Les quatre méthodes côte à côte
Comparons huit experts IT à deux tailles, avec les normalisations précédentes :
| Méthode | 24B held-in | 24B held-out | 64B held-in | 64B held-out |
|---|---|---|---|---|
| Moyenne des poids | 0.77 | 1.16 | 0.93 | 1.09 |
| Arithmétique des tâches | 0.92 | 1.18 | 0.93 | 1.09 |
| DARE-TIES | 0.88 | 1.17 | 0.93 | 1.09 |
| TIES | 0.86 | 1.16 | 0.93 | 1.10 |
| Entraînement multitâche | 0.98 | 1.18 | 0.99 | 1.05 |
D'après les tables PaLM-2-IT de l'annexe C, toujours pour huit experts.
En 64B, les fusions coïncident presque ; en 24B, held-in présente encore 0.15 d'écart. Le résultat dépend donc de la combinaison base, tâches et taille, sans seuil universel de paramètres. Même en 64B, revenir à PaLM-2 sans IT redonne 0.67 pour l'arithmétique et 0.56 pour TIES sur huit experts.
Les opérations ont aussi des échelles différentes. La moyenne est , l'arithmétique , avec une amplitude totale réglable. Moyenne par position de TIES et parcimonie aléatoire de DARE modifient encore les mises à jour. Des résultats proches peuvent donc venir d'opérations distinctes.
Ce qu'on peut en retenir
Premièrement, le gain normalisé held-out dépend de la base. En 64B sans IT, l'arithmétique de huit experts atteint 1.35, mais reste sous le multitâche à 1.72. Base, experts et multitâche doivent accompagner le gain de plus de 30 % pour juger de son intérêt.
Deuxièmement, des exceptions subsistent. Sans IT en 24B, huit experts donnent 0.83 en held-out par moyenne et 0.90 par TIES, sous la base. La tendance favorise les fortes bases et grandes tailles ; une régression exige encore les détails par tâche. Découplage par les instructions et annulation des bruits sont des hypothèses explicatives, sans chaîne causale directement établie.
Troisièmement, le cadre se limite à une famille, huit experts au plus, des tâches T0 précises et ce budget d'ajustement. Il ne mélange ni tokenizers différents, ni préentraînements indépendants, ni dizaines d'experts spécialisés longtemps, et n'évalue pas latence, sécurité et coût d'un produit complet. Au-delà de ce cadre, la meilleure inspiration est la grille expérimentale : contrôler qualité de base et nombre d'experts avant de comparer les recettes.
Conclusion
Jusqu'à 64 milliards de paramètres, PaLM-2 donne une tendance cohérente : construire les experts sur une base forte, de préférence IT ; augmenter la taille facilite la fusion et l'ajout d'experts ; le zéro-shot progresse généralement, parfois au-dessus du multitâche pour les grands modèles ; les écarts entre méthodes se réduisent.
Les auteurs rappellent aussi que les experts restent généralement meilleurs sur leurs propres tâches. Ils estiment cette perte potentiellement moins préoccupante dans la comparaison au modèle multitâche.
Retenons enfin ce détail : c'est l'auteur de TIES-Merging qui mène l'expérience et constate qu'en 64B, TIES et la moyenne simple se valent presque.