Article original
Evolutionary Optimization of Model Merging Recipes
- Publication
- Nature Machine Intelligence 2025Revue
- Premier dépôt sur arXiv
- arXiv:2403.13187
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingevolutionarymodelmerge2024,
  title = {{Evolutionary Optimization of Model Merging Recipes}},
  author = {Takuya Akiba and Makoto Shing and Yujin Tang and Qi Sun and David Ha},
  year = {2024},
  eprint = {2403.13187},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.13187}
}
Début 2024, la fusion de modèles est partout dans la communauté ouverte. L'Open LLM Leaderboard de Hugging Face est dominé par des assemblages d'ajustements ; mergekit permet d'en créer sur CPU.
La communauté Stable Diffusion a connu une trajectoire semblable. L'article rappelle que les mélanges de modèles de styles ont un temps compté parmi ses choix les plus populaires.
Chez Sakana AI à Tokyo, Takuya Akiba, Makoto Shing, Yujin Tang, Qi Sun et David Ha remarquent une difficulté : cette fusion est souvent perçue comme de la magie ou de l'alchimie. Choix des sources, proportions par couche et méthode reposent sur l'intuition, généralement réglée sur les mêmes benchmarks de classement.
Ils proposent de confier la recette à un algorithme évolutionnaire.
Définir le problème
La fusion est décomposée en deux espaces indépendants.
Espace des paramètres, PS : comment mélanger les poids de chaque couche. C'est la fusion habituelle, qui exige des sources de même architecture.
Espace du flux de données, DFS : conserver les poids, mais modifier les couches parcourues. Après la couche de A, un token peut passer à la couche de B. Cela rappelle l'empilement frankenmerge, avec une recherche portant sur tout le chemin d'inférence.
Ces deux espaces sont immenses. Les auteurs cherchent si l'évolution peut dépasser des recettes manuelles, notamment entre domaines, comme le japonais et les mathématiques en anglais, où le réglage humain est peu évident.
Résoudre le problème
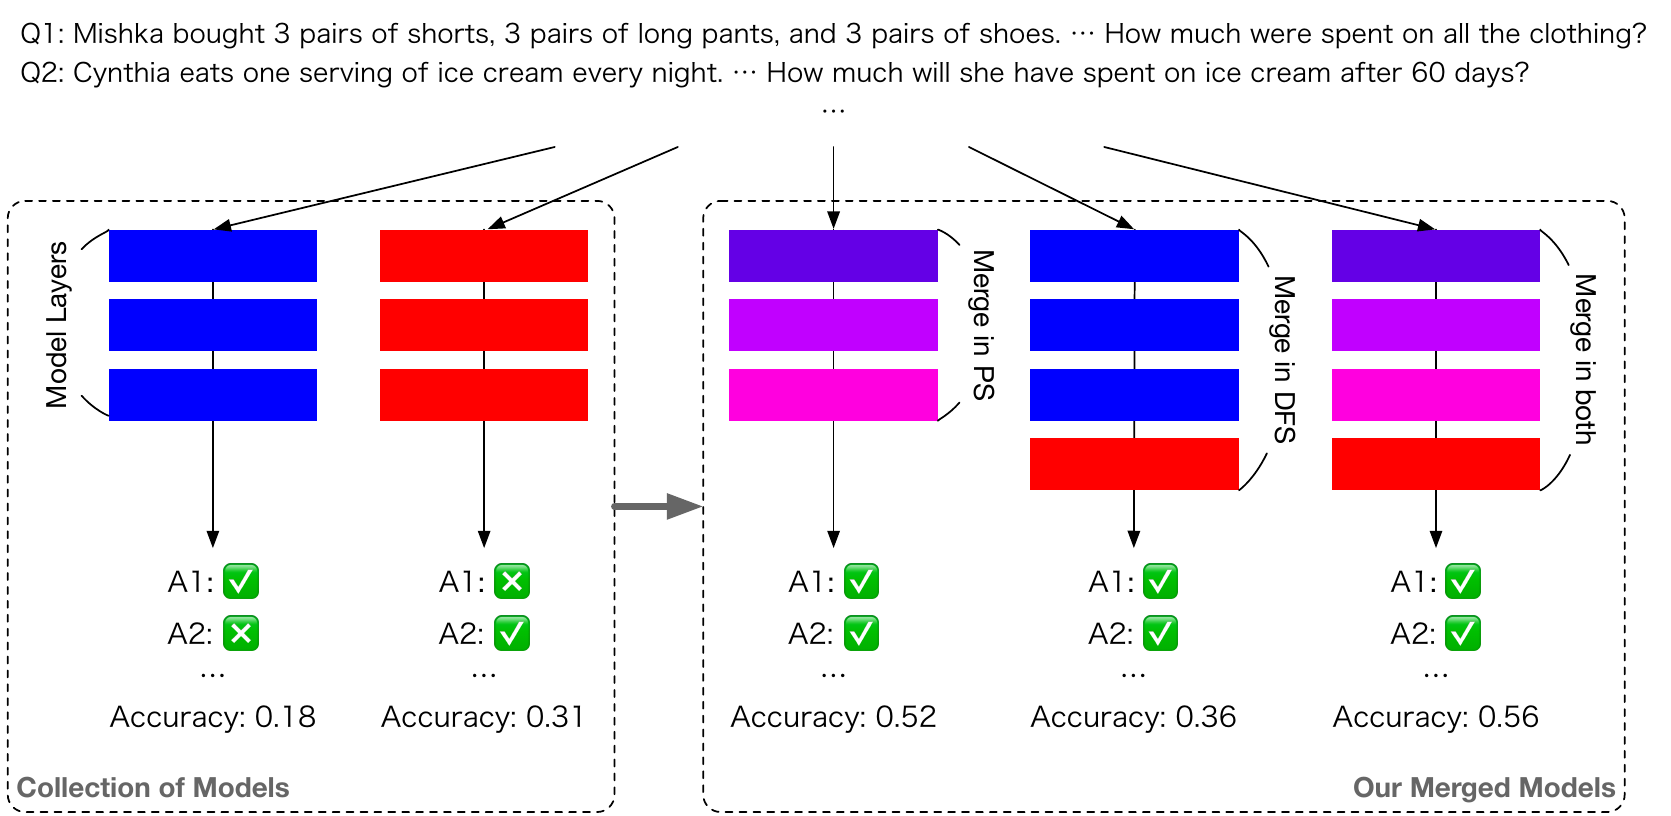
Les couleurs donnent une bonne image : PS mélange des peintures, bleu et rouge devenant violet ; DFS réordonne des briques qui gardent leur couleur.
Paramètres : choisir les coefficients par évolution
Le cadre PS utilise TIES-Merging avec DARE et peut attribuer à chaque couche, embeddings d'entrée et de sortie et blocs Transformer, son taux de parcimonie et son poids de mélange. CMA-ES règle ces hyperparamètres en prenant le score cible, par exemple la précision mathématique, comme aptitude.
Cette granularité appartient au cadre général. La recette des résultats principaux est plus simple : une density et un weight par modèle source, soit 6 variables pour trois modèles. Découper plus finement les couches n'apporte pas d'amélioration nette avec la quantité de données de recherche disponible ; les auteurs n'en font donc pas leur résultat principal.
La density contrôle la fraction de différences conservée après DARE ; le weight contrôle sa contribution à la fusion. Les trois weights trouvés sont proches et leur somme approche 2 : la solution amplifie aussi les changements de tâche. Les coefficients ne sont pas contraints à sommer à 1, ce qui dépasse une combinaison convexe ordinaire.
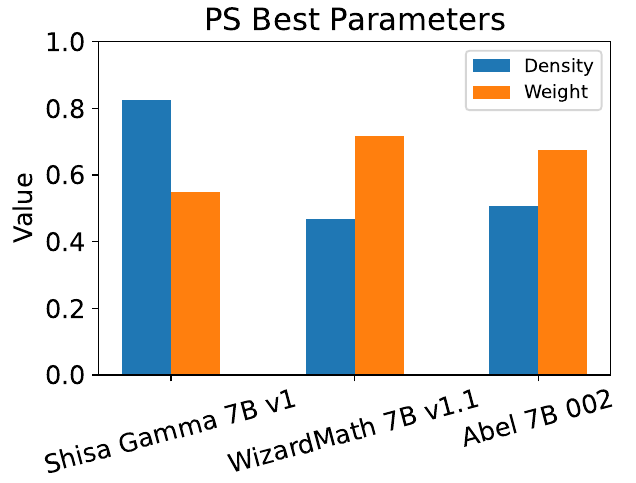
Les trois sources sont en abscisse ; le bleu montre la rétention et l'orange le poids. Le japonais conserve plus de différences, tandis qu'aucune contribution orange ne tombe près de zéro. Les deux spécialisations sont utilisées.
CMA-ES maintient une distribution de recherche, tire un lot de recettes, les classe selon le score puis adapte centre, échelle et directions. Pour chaque candidat, les poids sont fusionnés, les réponses générées et le score calculé, sans mise à jour par gradient. Un critère discret tel que « nombre final correct et raisonnement en japonais » peut donc être optimisé directement.
Flux de données : choisir le chemin
DFS est plus difficile. Pour deux modèles de 32 couches, soit couches, un chemin de longueur choisissant à chaque étape n'importe quelle couche ou un saut possède possibilités.
Les essais préliminaires montrent que répéter ou désordonner les premières couches dégrade souvent le résultat. Les auteurs ordonnent donc toutes les couches selon leur ordre original et répètent cette séquence fois, pour positions. Un tableau indicateur sélectionne ou saute chaque position. L'espace devient , toujours vaste mais accessible à leur recherche.
Une couche peut aussi recevoir une représentation d'une autre source, différente de celle de son entraînement. Même échanger deux couches voisines dégrade les essais préliminaires. Les auteurs multiplient donc l'entrée de chaque transition de vers par un coefficient , dont la matrice est aussi optimisée.
Concaténer les 32 couches de A et les 32 de B, puis répéter trois fois, donne 192 positions candidates. Les indicateurs positifs conservent les couches, les autres les sautent ; une même couche peut revenir dans plusieurs répétitions. Le chemin final est fixe pour tous les tokens, sans routeur qui choisit des experts selon l'entrée.
La recherche conserve le tokenizer et les embeddings d'entrée et de sortie de A, et commence et termine par les premier et dernier blocs Transformer de A pour rester compatible avec cet espace. Deux couches initialement voisines d'une même source gardent un facteur 1 ; les transitions entre sources ou les sauts laissent le facteur libre. Les interfaces, dont la dimension cachée, doivent toujours être compatibles. DFS assouplit profondeur et chemin sans permettre de connecter arbitrairement tous les modèles.
La figure suivante juxtapose les chemins au début, au milieu et à la fin de la recherche. L'abscisse est l'étape d'exécution, l'ordonnée la couche source ; bleu et rouge identifient les modèles et leur intensité le facteur d'échelle.
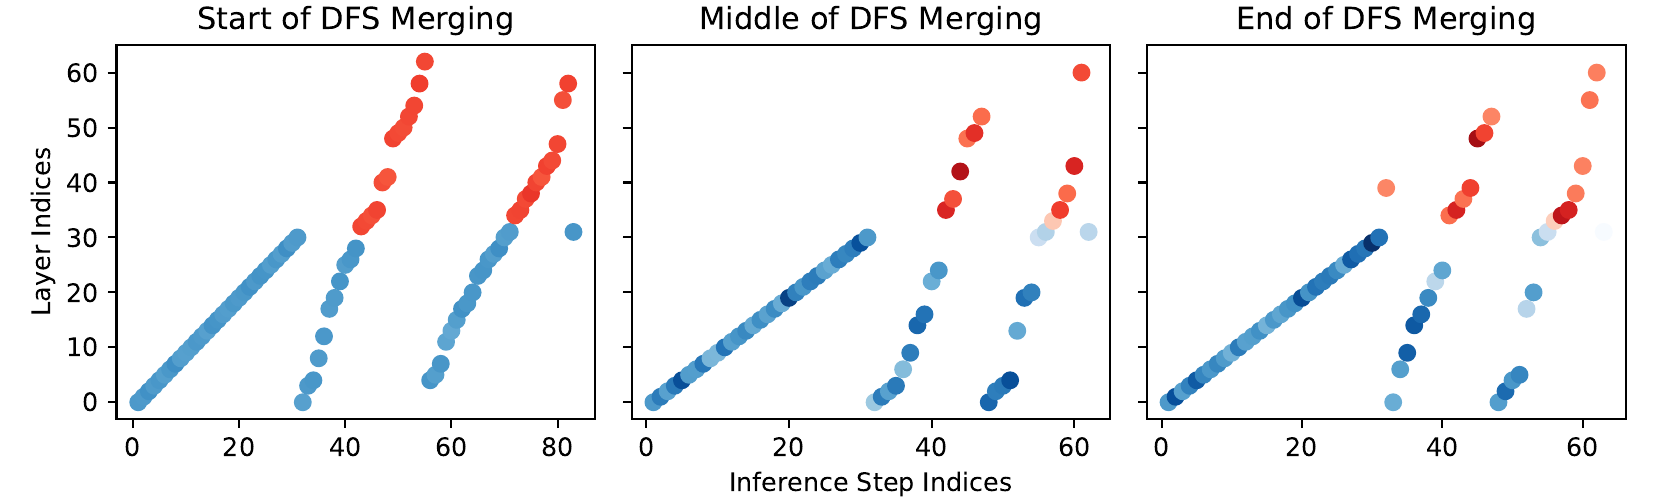
À droite, le début suit presque continûment la source bleue, puis introduit rouge et sauts. Les sources sont ici le modèle fusionné PS et le japonais. Le réseau final, plus long, compte 10B : l'architecture à déployer a changé.
Combiner les deux
On peut d'abord fusionner dans PS, réintroduire ce modèle dans le groupe de candidats, puis lancer DFS.
Discussion
Des mathématiques en japonais
L'expérience principale construit un modèle résolvant des problèmes en japonais. Les trois sources ajustées de Mistral-7B-v0.1 sont Shisa Gamma 7B v1, pour le japonais, WizardMath 7B v1.1 et Abel 7B 002, pour les mathématiques en anglais.
Le test MGSM japonais comporte les traductions des 250 premiers problèmes du test GSM8K, soit 250 questions. Il faut à la fois le bon nombre final et un raisonnement japonais. La recherche utilise une traduction séparée des 1 069 problèmes du test GSM8K dont les identifiants vont de 250 à 1318, avec une numérotation à partir de 0, sans recouvrement avec le test final. Les auteurs ne traduisent pas le jeu d'entraînement GSM8K, déjà utilisé par les modèles mathématiques sources, pour ne pas biaiser l'évaluation.
| Modèle | Taille | MGSM-JA | JP-LMEH |
|---|---|---|---|
| Shisa Gamma 7B v1, japonais | 7B | 9.6 | 66.1 |
| WizardMath 7B v1.1, mathématiques en anglais | 7B | 18.4 | 60.1 |
| Abel 7B 002, mathématiques en anglais | 7B | 30.0 | 56.5 |
| Fusion PS | 7B | 52.0 | 70.5 |
| Fusion DFS | 10B | 36.4 | 53.2 |
| Fusion PS et DFS | 10B | 55.2 | 66.2 |
| Llama 2 70B | 70B | 18.0 | 64.5 |
| Japanese StableLM 70B | 70B | 17.2 | 68.3 |
| Swallow 70B | 70B | 13.6 | 71.5 |
| GPT-3.5 | – | 50.4 | – |
| GPT-4 | – | 78.8 | – |
D'après la Table 1. MGSM-JA mesure la précision mathématique en japonais ; JP-LMEH est une moyenne d'évaluations de langue japonaise.
Les trois sources sont insuffisantes : le japonais calcule mal, les modèles mathématiques maîtrisent mal le japonais, et tous restent à 30 ou moins sur MGSM-JA.
PS atteint directement 52.0 en restant à 7B. DFS progresse à 36.4 mais passe à 10B. La combinaison est meilleure à 55.2, un peu devant les 50.4 de GPT-3.5, encore loin des 78.8 de GPT-4.
Sur la compétence japonaise générale JP-LMEH, PS obtient 70.5, au-dessus de Japanese StableLM 70B à 68.3 et de Llama 2 70B à 64.5, mais sous Swallow 70B à 71.5. C'est cette colonne qui soutient la comparaison favorable à certains modèles japonais 70B antérieurs.
Une analyse par question montre que la fusion conserve des réponses correctes des sources et en ajoute que toutes les trois rataient. L'annexe fournit aussi des problèmes mêlant culture japonaise et mathématiques : même traduits en anglais, leur contexte peut manquer aux modèles mathématiques anglophones.
Face aux recettes manuelles et à l'ajustement
Pour isoler le gain de l'évolution, les auteurs utilisent trois recettes mergekit sans optimisation, avec les mêmes sources et les réglages du tutoriel de Maxime Labonne sur le blog Hugging Face :
| Méthode | MGSM-JA | JP-LMEH |
|---|---|---|
| TIES-Merging, réglages du tutoriel | 4.4 | 63.7 |
| DARE-TIES, réglages du tutoriel | 35.2 | 66.3 |
| Empilement frankenmerge, réglages du tutoriel | 0.0 | 16.1 |
| Fusion évolutionnaire PS | 52.0 | 70.5 |
| Fusion évolutionnaire PS et DFS | 55.2 | 66.2 |
| Meilleur ajustement LoRA ou complet sur les mêmes 1 069 problèmes | 43.2 | 55.9 |
D'après la Table 3 de l'article.
Les réglages par défaut de TIES détruisent presque les mathématiques, et l'empilement n'a aucune bonne réponse. DARE-TIES dépasse légèrement les sources. Avec les mêmes modèles et méthodes, la recette peut donc changer le score de plusieurs dizaines de points.
Les ajustements LoRA et complets de chaque source, sur les mêmes 1 069 problèmes que la recherche, atteignent au mieux 43.2. La compétence japonaise générale baisse souvent nettement ; les auteurs y voient un besoin de davantage de données et un risque d'oubli.
Ils ajoutent aussi des modèles non pertinents au groupe. Avec 8 intrus, MGSM-JA de PS descend de 50.0 à 40.8, toujours au-dessus des sources.
Ce test utilise une normalisation des weights, d'où son départ à 50.0, distinct des 52.0 principaux. Jusqu'à onze modèles augmentent aussi la difficulté de sélection. La recherche tolère quelques mauvaises sources, tout en laissant une valeur au choix humain du groupe.
Les comparaisons LoRA et complètes fixent les données, explorent trois taux et entraînent 3 époques. Elles indiquent la meilleure utilisation de ces seuls 1 069 problèmes. Réunir toutes les données d'origine et réentraîner serait une autre comparaison, souvent impossible car ces données sont privées. La recherche évolutionnaire ajoute aussi de nombreuses évaluations, à compter séparément d'un ajustement unique.
Pourquoi la fusion fonctionne
Les trois sources partagent Mistral-7B-v0.1, une condition facile à oublier. PS reste une combinaison de vecteurs de tâche ; l'évolution cherche les coefficients de la recette.
Une difficulté subsiste : la base de Shisa Gamma 7B v1 a reçu 100 milliards de tokens japonais en préentraînement continu. Elle s'est bien plus éloignée de Mistral qu'un ajustement habituel et se prête moins à la parcimonie. Cela rejoint DARE : de grands deltas rendent la suppression plus difficile.
Un modèle vision-langage japonais
La méthode s'étend aux VLM. L'image passe par un encodeur visuel, puis un projecteur vers l'espace du langage, avant la réponse du modèle de langage. Les auteurs fixent les deux premiers composants et fusionnent seulement la partie langage de LLaVA-1.6-Mistral-7B avec Shisa Gamma pour produire EvoVLM-JP. La base Mistral reste commune ; l'encodeur visuel n'est pas moyenné.
La recherche utilise un sous-ensemble distinct de Japanese Visual Genome. Le test sépare 500 questions VQA générales et des scènes culturelles japonaises filtrées manuellement, avec 42 images et 50 questions. Le score est le ROUGE-L japonais ; une réponse détectée dans une autre langue reçoit en principe 0, avec des exceptions pour des abréviations étrangères courantes comme UFO déjà présentes dans la référence.
| Modèle | Taille | JA-VG-VQA-500 | Scènes culturelles japonaises |
|---|---|---|---|
| LLaVA-1.6-Mistral-7B | 8B | 14.3 | 41.1 |
| Japanese Stable VLM | 8B | – | 40.5 |
| EvoVLM, PS | 8B | 19.7 | 51.2 |
| EvoVLM, DFS | 12B | 16.8 | 46.5 |
| EvoVLM, PS+DFS | 11B | 20.4 | 47.6 |
ROUGE-L, plus élevé est meilleur, d'après la Table 5. Japanese Stable VLM ayant été entraîné sur Japanese Visual Genome, cette colonne n'est pas évaluée.
PS+DFS gagne en VQA générale, PS dans les scènes culturelles : profondeur et complexité supplémentaires ne gagnent pas partout. ROUGE-L mesure le recouvrement textuel avec une référence, assorti ici d'une contrainte de langue ; d'autres évaluations seraient nécessaires pour couvrir la compréhension culturelle. L'annexe illustre notamment les réponses sur les manches à air en forme de carpes et les noms japonais des couleurs des feux routiers.
Le rôle du chemin et des échelles
Sur des experts japonais et mathématiques Llama-2-13B, les sources valent 13.2 % et 8.0 % sur MGSM-JA, PS 31.2 %, PS+DFS 34.0 %, avec 21B pour ce dernier. Ces résultats restent sous les fusions Mistral 7B/10B malgré les sources plus grandes : leur qualité compte.
L'ordre initial de DFS joue aussi. Dans l'expérience 13B, inverser les deux sources fait passer le test de 23.2 % à 12.8 %. L'initialisation favorise le chemin original de A, ce qui réduit les candidats produisant immédiatement du texte incohérent, mais introduit une préférence d'ordre en contrepartie d'un espace réduit.
Sans facteurs d'échelle entre couches, PS+DFS vaut 26.4 % sur MGSM-JA contre 34.0 % pour la version complète. Les tailles trouvées diffèrent aussi : 19B et 21B. L'ablation soutient l'utilité de l'alignement des échelles, avec un effet mêlé au changement d'architecture. Si les sources ont été ajustées trop longtemps et leurs représentations trop séparées, un simple facteur ne suffit plus à les raccorder.
Coût et limites
La fusion réutilise des capacités entraînées et évite de les réapprendre par gradient. Le modèle de comparaison japanese-stablelm-base-gamma-7b a reçu 100 milliards de tokens japonais, pour plus de dix mille heures GPU estimées. Cette estimation n'est toutefois pas comparée à une recherche mesurée sur le même matériel.
PS évalue 1 000 recettes, chacune sur les 1 069 questions complètes. DFS utilise 128 candidats sur 100 générations ; les 200 dernières questions du sous-ensemble servent de validation, et chaque lot de recherche en évalue 200. PS fusionne avant d'évaluer ; DFS conserve les couches sources et exécute un chemin allongé, avec davantage de mémoire GPU. Cette contrainte empêche même le test DFS avec sources non pertinentes. Le poste coûteux reste la génération et la notation de nombreux candidats.
Les auteurs reconnaissent aussi que la fusion hérite des défauts des sources et peut manquer de cohérence logique. L'étude n'effectue ni ajustement d'instructions ni alignement supplémentaires ; les réponses peuvent contenir des erreurs factuelles.
Conclusion
L'article confie à l'évolution les recettes jusque-là réglées à l'intuition. PS associe TIES et DARE ; les résultats principaux recherchent seulement la density et le weight de chaque source. DFS réorganise le chemin d'inférence. Pour les mathématiques en japonais, trois sources 7B insuffisantes prises séparément dépassent GPT-3.5 une fois fusionnées.
Le coût mérite autant d'attention. La fusion ne demande pas d'entraînement, mais PS teste 1 000 recettes, chacune notée sur plus de mille problèmes. Une nouvelle tâche exige une nouvelle recherche.
Pour essayer, limitez d'abord le groupe à quelques sources, cherchez une density et un weight par modèle entier et réservez un test totalement exclu de la recherche. Si ce premier cadre apporte un gain, augmentez ensuite la granularité par couche ou ajoutez DFS : vous verrez plus facilement ce qu'apportent les évaluations supplémentaires.