Article original
DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2606.19348
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{deepseekdeepseekv42026,
  title = {{DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence}},
  author = {DeepSeek-AI and Anyi Xu and Bangcai Lin and Bing Xue and Bingxuan Wang and Bingzheng Xu and Bochao Wu and Bowei Zhang and Chaofan Lin and Chen Dong and Chenchen Ling and Chengda Lu and Chenggang Zhao and Chengqi Deng and Chengyu Hou and Chenhao Xu and Chenze Shao and Chong Ruan and Conner Sun and Damai Dai and Daya Guo and Dejian Yang and Deli Chen and Donghao Li and Dongjie Ji and Erhang Li and Fang Wei and Fangyun Lin and Fangzhou Yuan and Feiyu Xia and Fucong Dai and Guangbo Hao and Guanting Chen and Guoai Cao and Guolai Meng and Guowei Li and Han Yu and Han Zhang and Hanwei Xu and Hao Li and Haofen Liang and Haoling Zhang and Haoming Luo and Haoran Wei and Haotian Yuan and Haowei Zhang and Haowen Luo and Haoyu Chen and Haozhe Ji and Hengqing Zhang and Honghui Ding and Hongxuan Tang and Huanqi Cao and Huazuo Gao and Hui Qu and Hui Zeng and J Yang and JQ Zhu and Jia Luo and Jia Song and Jia Yu and Jialiang Huang and Jialu Cai and Jian Liang and Jiangting Zhou and Jiasheng Ye and Jiashi Li and Jiaxin Xu and Jiewen Hu and Jieyu Yang and Jin Chen and Jin Yan and Jingchang Chen and Jingli Zhou and Jingting Xiang and Jingyang Yuan and Jingyuan Cheng and Jingzi Zhou and Jinhua Zhu and Jiping Yu and Joseph Sun and Jun Ran and Junguang Jiang and Junjie Qiu and Junlong Li and Junmin Zheng and Junxiao Song and Kai Dong and Kaige Gao and Kang Guan and Kexing Zhou and Kezhao Huang and Kuai Yu and Lean Wang and Lecong Zhang and Lei Wang and Leyi Xia and Li Zhang and Liang Zhao and Lihua Guo and Lingxiao Luo and Linwang Ma and Linyan Zhu and Litong Wang and Liyu Cai and Liyue Zhang and Longhao Chen and MS Di and MY Xu and Max Mei and Miaojun Wang and Mingchuan Zhang and Minghua Zhang and Minghui Tang and Mingming Li and Mingxu Zhou and Minmin Han and Ning Wang and Panpan Huang and Panpan Wang and Peixin Cong and Peiyi Wang and Peng Zhang and Qiancheng Wang and Qihao Zhu and Qingyang Li and Qinyu Chen and Qiushi Du and Qiwei Jiang and Rui Tian and Ruifan Xu and Ruijie Lu and Ruiling Xu and Ruiqi Ge and Ruisong Zhang and Ruizhe Pan and Runji Wang and Runqian Chen and Runqiu Yin and Runxin Xu and Ruomeng Shen and Ruoyu Zhang and Ruyi Chen and SH Liu and Shanghao Lu and Shangmian Sun and Shangyan Zhou and Shanhuang Chen and Shaofei Cai and Shaoheng Nie and Shaoqing Wu and Shaoyuan Chen and Shengding Hu and Shengyu Liu and Shiqiang Hu and Shirong Ma and Shiyu Wang and Shuiping Yu and Shunfeng Zhou and Shuting Pan and Shuying Yu and Songyang Zhou and Tao Ni and Tao Yun and Tian Jin and Tian Pei and Tian Ye and Tianle Lin and Tianran Ji and Tianyi Cui and Tianyuan Yue and Tingting Yu and Tun Wang and W Zhang and WL Xiao and Wangding Zeng and Wei An and Weilin Zhao and Wen Liu and Wenfeng Liang and Wenjie Pang and Wenjing Luo and Wenjing Yao and Wenjun Gao and Wenkai Yang and Wenlve Huang and Wenqing Hou and Wentao Zhang and Wenting Ma and Xi Gao and Xiang He and Xiangwen Wang and Xianzu Wang and Xiao Bi and Xiaodong Liu and Xiaohan Wang and Xiaokang Chen and Xiaokang Zhang and Xiaotao Nie and Xiaowen Sun and Xiaoxiang Wang and Xin Cheng and Xin Liu and Xin Xie and Xingchao Liu and Xingchen Liu and Xingkai Yu and Xingyou Li and Xinyu Yang and Xinyu Zhang and Xu Chen and Xuanyu Wang and Xuecheng Su and Xueyin Chen and Xuheng Lin and Xuwei Fu and YC Yan and YQ Wang and YW Ma and Yanfeng Luo and Yang Zhang and Yanhong Xu and Yanru Ma and Yanwen Huang and Yao Li and Yao Li and Yao Xu and Yao Zhao and Yaofeng Sun and Yaohui Wang and Yi Qian and Yi Shao and Yi Yu and Yichao Zhang and Yifan Ding and Yifan Shi and Yijia Wu and Yiliang Xiong and Yiling Ma and Ying He and Ying Tang and Ying Zhou and Yingjia Luo and Yinmin Zhong and Yishi Piao and Yisong Wang and Yixiang Zhang and Yixiao Chen and Yixuan Tan and Yixuan Wei and Yiyang Ma and Yiyuan Liu and Yonglun Yang and Yongqiang Guo and Yongtong Wu and Yu Wu and YuKun Li and Yuan Cheng and Yuan Ou and Yuanfan Xu and Yuanhao Li and Yuduan Wang and Yuehan Yang and Yuer Xu and Yuhan Wu and Yuhao Meng and Yuheng Zou and Yukun Zha and Yunfan Xiong and Yupeng Chen and Yuping Lin and Yuqian Cao and Yuqian Wang and Yushun Zhang and Yuting Yan and Yutong Lin and Yuxian Gu and Yuxiang Luo and Yuxiang You and Yuxuan Liu and Yuxuan Zhou and Yuyang Zhou and Yuzhen Huang and ZF Wu and Zehao Wang and Zehua Zhao and Zehui Ren and Zekai Zhang and Zhangli Sha and Zhe Fu and Zhe Ju and Zhean Xu and Zhenda Xie and Zhengyan Zhang and Zheren Gao and Zhewen Hao and Zhibin Gou and Zhicheng Ma and Zhigang Yan and Zhihong Shao and Zhixian Huang and Zhixuan Chen and Zhiyu Wu and Zhizhou Ren and Zhongyu Wu and Zhuoshu Li and Zhuping Zhang and Zian Xu and Zihao Wang and Zihua Qu and Zihui Gu and Zijia Zhu and Zilin Li and Zipeng Zhang and Ziwei Xie and Ziyi Gao and Ziyi Wan and Zizheng Pan and Zongqing Yao},
  year = {2026},
  eprint = {2606.19348},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2606.19348}
}
De DeepSeek-V3 à DeepSeek-R1, cette série poursuit toujours le même but : obtenir des modèles plus forts avec moins de calcul.
L'arrivée des modèles de raisonnement a ajouté une nouvelle difficulté. Le modèle doit d'abord écrire un long raisonnement avant de répondre, et les tâches d'agent l'obligent en plus à travailler dans de très longs historiques d'appels d'outils ; le contexte atteint facilement plusieurs centaines de milliers de tokens. Le calcul de l'attention standard croît avec le carré de la longueur, et le cache KV grandit linéairement avec elle. Dès que le contexte s'allonge, le coût d'inférence est entièrement dévoré par l'attention.
DeepSeek-V4 est la réponse à ce problème. Le rapport publie une préversion, avec deux modèles : DeepSeek-V4-Pro, 1.6T paramètres au total et 49B actifs par token ; DeepSeek-V4-Flash, 284B au total et 13B actifs. Tous deux prennent en charge nativement un contexte d'un million de tokens, et leurs poids sont publiés.
Le rapport apporte trois nouveautés d'architecture : CSA et HCA, deux attentions compressées utilisées en combinaison ; mHC, qui remplace les connexions résiduelles classiques ; et l'optimiseur Muon. Le post-entraînement comporte en outre un changement décisif du point de vue de la fusion de modèles. DeepSeek n'intègre plus les capacités des modèles experts par fusion des poids ni par apprentissage par renforcement mixte, mais par distillation on-policy à plusieurs enseignants.
Définir le problème
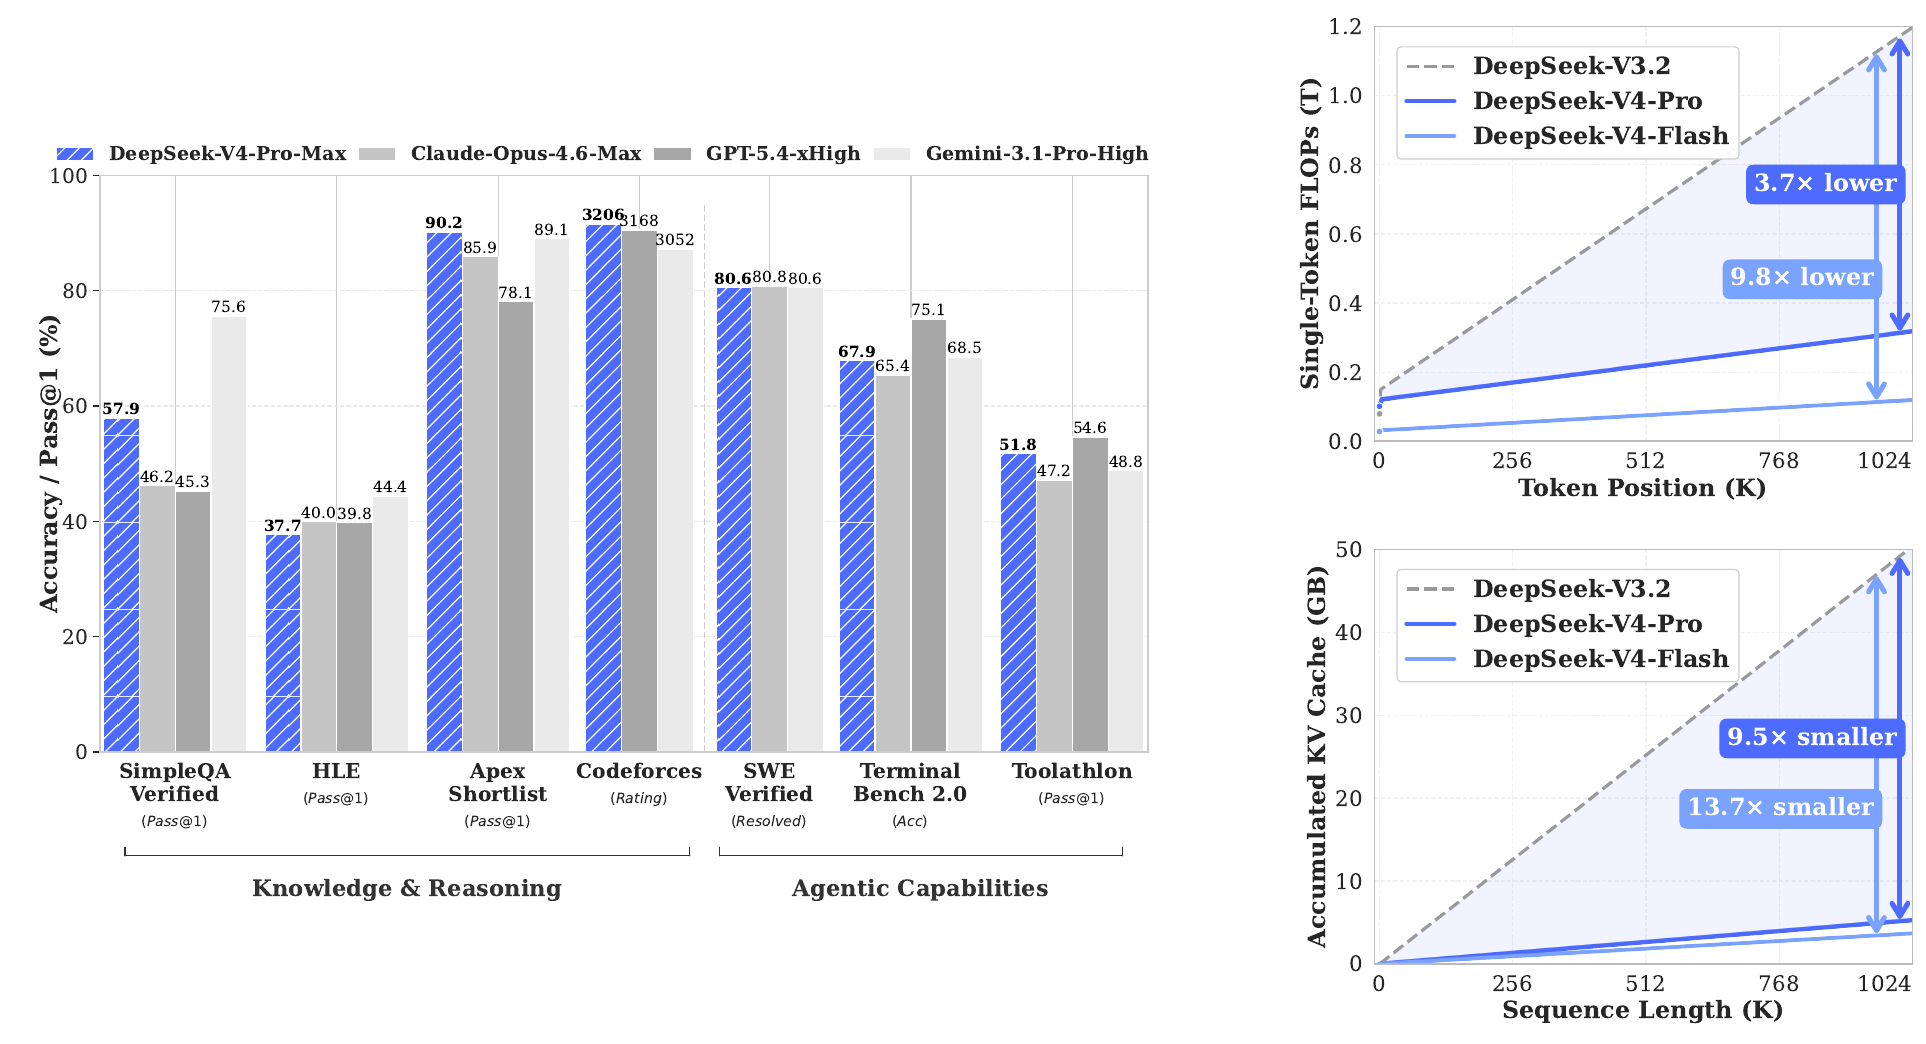
Regardons d'abord les deux graphiques de droite, qui résument l'objectif de tout le rapport.
En haut à droite, le calcul nécessaire pour générer un token, avec en abscisse la position de ce token dans le contexte. La courbe pointillée de la génération précédente, DeepSeek-V3.2, monte presque en ligne droite : plus la position est tardive, plus chaque token coûte cher. À un million de tokens, V4-Pro n'a besoin que de 27 % du calcul de V3.2, et V4-Flash de 10 %.
En bas à droite, le cache KV. Toujours à un million de tokens, V4-Pro n'a besoin que de 10 % de celui de V3.2, et V4-Flash de 7 %.
Précisons que V3.2 utilise déjà une attention clairsemée et n'a donc rien d'une référence dispendieuse ; de plus, V4-Pro active même plus de paramètres par token que V3.2. L'écart sur ces deux graphiques vient donc surtout de la refonte de l'attention.
À gauche, la configuration la plus forte, DeepSeek-V4-Pro-Max, est comparée à trois modèles fermés ; nous y reviendrons dans la discussion.
Résoudre le problème
Architecture d'ensemble
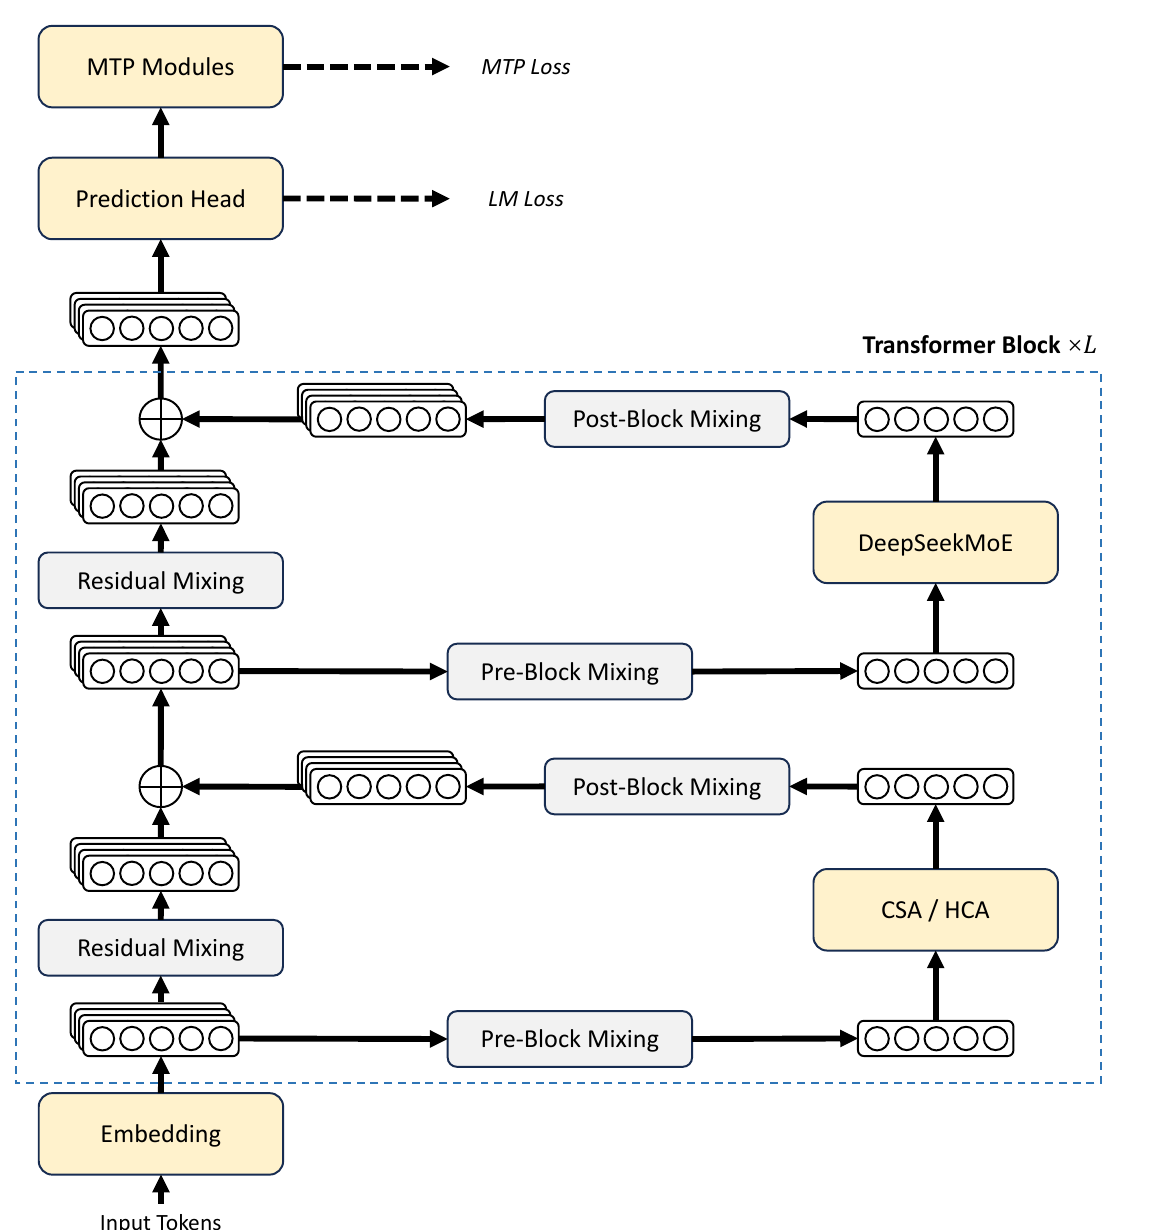
L'essentiel reprend DeepSeek-V3 : la couche feed-forward est DeepSeekMoE, avec experts partagés et experts routés à grain fin ; l'équilibrage de charge passe par un ajustement de biais sans perte auxiliaire, et la prédiction multi-token (MTP) est conservée. Il y a deux petits changements. La fonction qui calcule l'affinité de routage passe de Sigmoid à ; et les toutes premières couches, autrefois des couches feed-forward denses, deviennent elles aussi des MoE, mais avec un routage par hachage, qui choisit directement l'expert d'après l'ID du token.
Le plus visible sur la figure, c'est le flux résiduel dessiné comme quatre vecteurs empilés : c'est mHC.
mHC : élargir le flux résiduel, puis le contraindre
Une connexion résiduelle ordinaire s'écrit : il n'y a qu'un seul flux résiduel, de largeur égale à la dimension cachée .
Hyper-Connections (HC) élargit le flux résiduel en copies ; l'état devient , et trois petites matrices décident de la lecture et de l'écriture :
mélange les copies résiduelles en une seule, qui sert d'entrée à la couche ; répartit la sortie de la couche sur les différentes copies ; mélange les copies entre elles. L'entrée et la sortie de la couche restent de dimension , donc sa conception interne n'a pas à changer ; et comme est bien plus petit que , le calcul supplémentaire est minime.
Le problème de HC est qu'après empilement de nombreuses couches, les valeurs deviennent facilement instables. La raison se devine sans peine. Chaque couche multiplie par une , et si sa norme spectrale dépasse 1, le signal explose au bout de quelques dizaines de couches.
mHC (Manifold-Constrained HC) contraint à être une matrice doublement stochastique : tous ses éléments sont positifs ou nuls, et la somme de chaque ligne comme de chaque colonne vaut 1. La norme spectrale d'une matrice doublement stochastique vaut exactement 1, elle n'amplifie donc pas le signal ; le produit de deux matrices doublement stochastiques est encore doublement stochastique, si bien que cela reste vrai quel que soit le nombre de couches empilées. et sont quant à elles rendues non négatives et bornées par une Sigmoid, pour éviter que les signaux s'annulent entre eux.
Pour projeter une matrice quelconque sur les matrices doublement stochastiques, on utilise l'algorithme de Sinkhorn-Knopp : on prend d'abord l'exponentielle pour rendre tous les éléments positifs, puis on alterne normalisation des colonnes et normalisation des lignes. V4 fait 20 itérations. Essayons avec :
import numpy as np

rng = np.random.default_rng(0)
B_raw = rng.normal(scale=2.0, size=(4, 4))          # matrice de mélange résiduel sans contrainte (n_hc = 4)
print("Norme spectrale avant contrainte :", round(np.linalg.norm(B_raw, 2), 3))

M = np.exp(B_raw)                                     # exponentielle d'abord : chaque élément devient positif
for _ in range(20):                                   # t_max = 20
    M = M / M.sum(axis=0, keepdims=True)              # somme de chaque colonne = 1
    M = M / M.sum(axis=1, keepdims=True)              # somme de chaque ligne = 1

print("Sommes des lignes :", np.round(M.sum(axis=1), 4))
print("Sommes des colonnes :", np.round(M.sum(axis=0), 4))
print("Norme spectrale après contrainte :", round(np.linalg.norm(M, 2), 4))

x = rng.normal(size=4)
y = x.copy()
for _ in range(60):                                   # le même mélange résiduel appliqué sur 60 couches
    y = M @ y
print("Norme de l'entrée :", round(np.linalg.norm(x), 3), " après 60 couches :", round(np.linalg.norm(y), 3))
Norme spectrale avant contrainte : 6.07
Sommes des lignes : [1. 1. 1. 1.]
Sommes des colonnes : [1. 1. 1. 1.]
Norme spectrale après contrainte : 1.0
Norme de l'entrée : 1.286  après 60 couches : 0.297
Avant contrainte, la norme spectrale de la matrice est de 6.07 : multipliée sur 60 couches, elle donnerait un nombre astronomique. Après projection, elle vaut 1.0, et sur 60 couches le signal ne fait que converger, sans exploser. Pour rendre l'effet bien visible, cet exemple utilise la même matrice pour les 60 couches ; dans un vrai modèle, chaque couche a sa propre , mais chacune est doublement stochastique, et la conclusion est la même.
Les , et réelles sont générées dynamiquement à partir de l'entrée. On aplatit , on applique RMSNorm, puis une petite couche linéaire ; on ajoute un biais statique, on multiplie par un coefficient de porte initialement très petit, et l'on applique enfin les contraintes ci-dessus. Les deux modèles V4 utilisent .
CSA et HCA : deux attentions compressées
L'attention est le goulot d'étranglement du long contexte. V4 conçoit deux types d'attention, utilisés en alternance.
CSA (Compressed Sparse Attention) compresse d'abord, puis sélectionne de façon clairsemée.
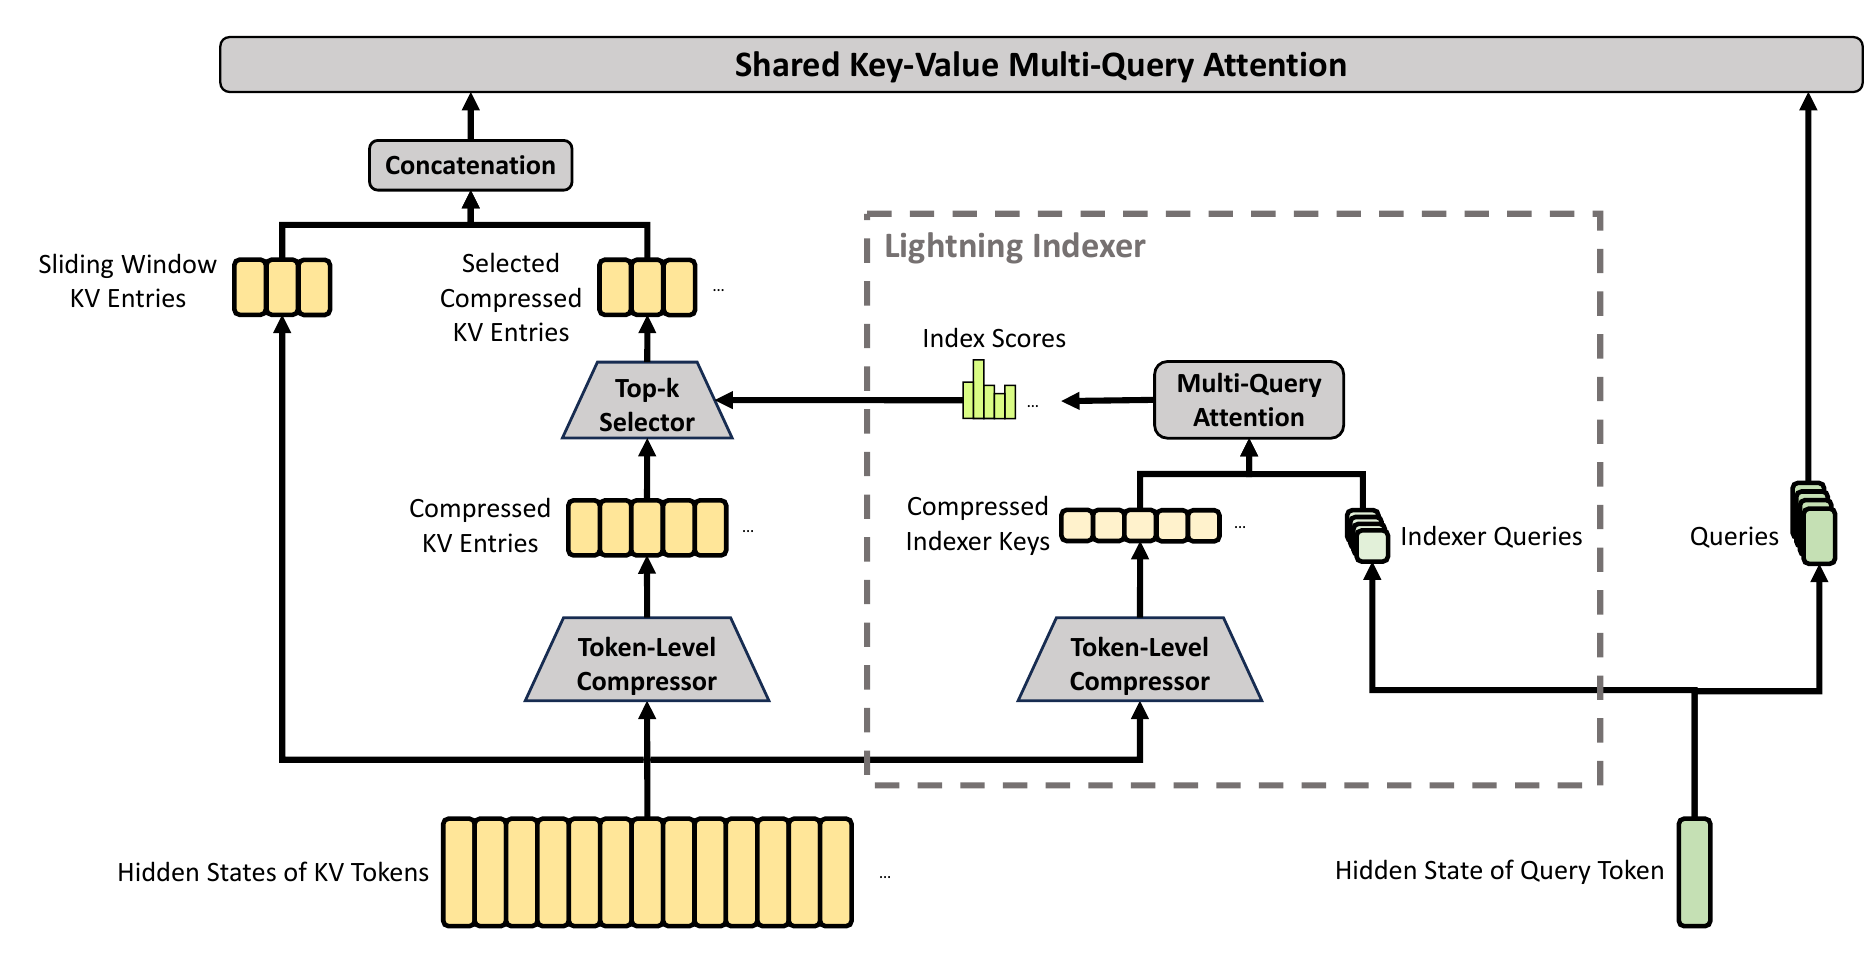
Lisons de bas en haut.
Première étape, la compression. Les KV de chaque groupe de tokens sont compressés en une seule entrée ; les poids de compression sont donnés par une projection apprise plus un biais de position, passés dans un softmax, ce qui revient à une moyenne pondérée de ces tokens. V4 fixe .
Deuxième étape, la sélection. Elle reprend la DeepSeek Sparse Attention (DSA) de V3.2 : un lightning indexer léger note toutes les entrées compressées et ne garde que les les mieux notées. Pour V4-Pro, ; pour V4-Flash, 512. L'indexeur lui-même calcule en précision FP4.
Troisième étape, compléter le voisinage. Une entrée compressée ne voit que « les blocs entiers précédents », et pas les autres tokens de son propre bloc ; de plus, un modèle de langage a généralement surtout besoin du contexte le plus récent. On ajoute donc une branche à fenêtre glissante, qui garde non compressés les 128 KV les plus récents.
Enfin, chaque entrée KV sert à la fois de clé et de valeur et est partagée par toutes les têtes de requête : c'est la forme de l'attention multi-requêtes (MQA).
HCA (Heavily Compressed Attention) compresse beaucoup plus fort : chaque groupe de tokens donne une seule entrée, mais sans sélection clairsemée ; toutes les entrées compressées sont prises en compte, avec là aussi une fenêtre glissante de 128 tokens.
Faisons le calcul pour un million de tokens. Combien d'entrées KV chaque requête doit-elle regarder ?
| Attention | Entrées KV après compression | Entrées réellement vues par requête |
|---|---|---|
| Attention standard | 1 000 000 | 1 000 000 |
| CSA (, pour Pro) | 250 000 | |
| HCA () | environ 7 813 | environ |
CSA mise sur la sélection clairsemée : chaque requête ne regarde qu'un peu plus d'un millier d'entrées, mais triées sur le volet parmi 250 000 entrées compressées. HCA ne trie pas, mais chaque entrée représente 128 tokens et donne les contours grossiers de tout le contexte. En les alternant, l'une se charge de la recherche précise, l'autre de la vue d'ensemble.
La taille du cache KV dépend du nombre d'entrées à stocker après compression. Selon le rapport, par rapport à une référence courante en BF16, avec GQA à 8 groupes et une dimension de tête de 128, le cache KV de V4 à un million de tokens n'en représente qu'environ 2 %. Ce chiffre inclut d'autres économies, par exemple stocker en BF16 les dimensions RoPE des entrées KV et en FP8 les autres dimensions, ce qui économise presque la moitié.
Le rapport liste aussi quelques détails qui rendent cette conception entraînable : RMSNorm sur les requêtes et sur les entrées KV avant l'attention, pour éviter l'explosion des logits d'attention ; RoPE appliqué seulement aux 64 dernières dimensions ; un sink logit appris ajouté à l'attention, qui permet à la somme de l'attention d'une tête d'être inférieure à 1.
L'optimiseur Muon
V4 utilise l'optimiseur Muon pour la plupart de ses paramètres ; l'embedding, la tête de prédiction, les poids de RMSNorm et les biais statiques de mHC restent sous AdamW.
Le cœur de Muon est d'« orthogonaliser » la matrice de momentum, pour que toutes les valeurs singulières de la mise à jour soient proches de 1. La méthode exacte demanderait une décomposition en valeurs singulières, trop coûteuse ; on l'approche donc par des itérations de Newton-Schulz :
V4 procède par 10 itérations « hybrides ». Les 8 premières utilisent , qui poussent rapidement les valeurs singulières vers 1 ; les 2 dernières passent à , qui les stabilisent à 1.
Comme l'architecture d'attention applique déjà RMSNorm aux requêtes et aux KV, les logits d'attention n'explosent pas, et V4 n'a pas besoin du QK-Clip qu'utilisent d'autres implémentations de Muon pour contenir les logits.
Préentraînement
Configuration
| V4-Flash | V4-Pro | |
|---|---|---|
| Couches / dimension cachée | 43 / 4 096 | 61 / 7 168 |
| Experts routés (actifs par token) | 256 (6) | 384 (6) |
| Nombre de sélections CSA | 512 | 1 024 |
| Paramètres totaux / actifs | 284B / 13B | 1.6T / 49B |
| Tokens d'entraînement | 32T | 33T |
Les deux modèles ont un taux de compression de 4 pour CSA et de 128 pour HCA, et leurs 3 premières couches MoE utilisent le routage par hachage. Les deux premières couches de V4-Flash n'utilisent que l'attention à fenêtre glissante, celles de V4-Pro utilisent HCA ; ensuite, CSA et HCA alternent.
L'entraînement commence avec des séquences de 4K, puis passe progressivement à 16K, 64K et 1M. L'attention clairsemée n'est pas utilisée dès le début. V4-Flash s'échauffe d'abord en attention dense sur les 1T premiers tokens (la phase dense de V4-Pro est plus longue) ; l'attention clairsemée n'est ajoutée qu'à la longueur de 64K, après un bref échauffement du lightning indexer. Le taux d'apprentissage reste constant la plupart du temps, puis décroît en cosinus jusqu'au dixième de sa valeur à la fin.
En phase de post-entraînement, les poids des experts routés et le chemin QK de l'indexeur passent aussi par un entraînement conscient de la quantification FP4, qui économise encore de la mémoire et du calcul.
Gérer les pics de perte
Quand on entraîne un MoE à des milliers de milliards de paramètres, les pics de perte sont difficiles à éviter. Les auteurs constatent qu'ils sont toujours liés à des valeurs aberrantes dans les couches MoE, et que le mécanisme de routage lui-même semble amplifier ces valeurs aberrantes, ce qui crée un cercle vicieux. Un simple retour en arrière ne règle le problème que temporairement ; les pics reviennent.
Ils ont trouvé deux remèdes efficaces, tout en reconnaissant franchement ne pas encore en comprendre le principe :
- Routage anticipé (Anticipatory Routing) : à l'étape , les caractéristiques sont calculées avec les paramètres courants , mais la décision de routage l'est avec des paramètres un peu plus anciens, , ce qui casse le cercle vicieux né de la mise à jour simultanée du réseau principal et du routeur. Cela ajoute environ 20 % de temps ; ce mode n'est donc pas activé en temps normal. Quand le système détecte un pic, il revient automatiquement un peu en arrière, active ce mode pendant un moment, puis le désactive.
- Écrêtage de SwiGLU : la branche linéaire de SwiGLU est bornée à et la branche de porte plafonnée à 10, ce qui écrase directement les valeurs aberrantes.
Selon les auteurs, ces deux remèdes ont été efficaces dans l'entraînement de V4-Flash comme de V4-Pro, sans nuire aux performances.
Comparaison des modèles de base
Les auteurs comparent trois modèles de base, V3.2, V4-Flash et V4-Pro. Le plus intéressant est V4-Flash : avec moins de paramètres actifs et moins de paramètres au total que V3.2, il le bat pourtant sur la plupart des benchmarks, en particulier sur les tâches de connaissances et de long contexte.
Post-entraînement : de la fusion des poids à la distillation
Entraîner d'abord une équipe d'experts
La première étape du post-entraînement ressemble à celle de V3.2. Pour chaque domaine, un SFT suivi d'un apprentissage par renforcement avec GRPO produit une équipe de modèles experts.
L'intensité du raisonnement passe aussi par des experts. V4 a trois modes de raisonnement : sans réflexion, Think High et Think Max. Chaque mode est entraîné avec sa propre pénalité de longueur et sa propre longueur de contexte ; Think Max injecte en plus, au début du prompt système, une instruction qui demande au modèle de « fournir l'effort maximal, sans prendre de raccourci » et d'écrire tout son raisonnement.
Pour les tâches difficiles à vérifier, V4 n'entraîne plus de modèle de récompense qui produit un score ; il utilise des grilles d'évaluation avec un modèle de récompense génératif (GRM), et c'est le modèle de politique lui-même qui fait office de GRM, si bien que sa capacité de jugement et sa capacité de génération sont optimisées ensemble par l'apprentissage par renforcement.
Remplacer la fusion par la distillation
L'étape suivante est justement celle que cette note veut souligner.
Avec plus d'une dizaine d'experts, comment intégrer leurs capacités dans un seul modèle ? Command A utilise une fusion linéaire des poids ; V3.2, un apprentissage par renforcement mixte. V4 n'utilise ni l'un ni l'autre, mais une distillation on-policy à plusieurs enseignants (OPD) :
est l'élève à entraîner, le -ème expert et son poids. « On-policy » signifie que les données d'entraînement sont générées par l'élève lui-même, puis que chaque expert donne sa propre distribution de probabilité pour chaque token écrit par l'élève. C'est la KL inverse, : sur un problème de maths, l'élève se rapproche naturellement de l'expert en mathématiques ; sur un problème de code, de l'expert en code.
Les auteurs donnent explicitement la raison de ce choix : aligner les connaissances au niveau des logits évite en pratique la dégradation des performances fréquente avec la fusion des poids classique ou l'apprentissage par renforcement mixte. Cette étape utilise plus d'une dizaine de modèles enseignants pour distiller un seul élève.
Dans le détail, les implémentations courantes d'OPD simplifient la KL sur tout le vocabulaire en ne regardant, à chaque position, que le token échantillonné, utilisé comme avantage pour l'apprentissage par renforcement. C'est économe en ressources, mais la variance du gradient est grande et l'entraînement instable. V4 s'en tient à une distillation des logits sur le vocabulaire complet, ce qui l'oblige à résoudre le problème d'ordonnancement posé par plus d'une dizaine d'enseignants fournissant en même temps des logits complets.
De Model Soups à Command A, l'argument de la fusion de modèles a toujours été son faible coût : pas de données, pas d'entraînement, une moyenne suffit. Le choix de V4 montre que, lorsqu'on dispose de données et de calcul, et que les experts à intégrer sont plus d'une dizaine, aux capacités très différentes, consentir le coût d'une distillation pour éviter les pertes de la fusion en vaut la peine pour DeepSeek.
La gestion du contexte pendant le raisonnement
Un contexte d'un million de tokens change aussi la façon de conserver le contenu du raisonnement. V3.2 conservait la réflexion entre les appels d'outils, mais dès que l'utilisateur envoyait un nouveau message, toute la réflexion précédente était abandonnée. Dans les scénarios avec appels d'outils, V4 conserve toute la réflexion de la conversation, y compris par-delà les messages de l'utilisateur ; pour la conversation ordinaire, il garde l'ancienne pratique. Le format des appels d'outils passe aussi à un style XML, qui, selon les auteurs, réduit les erreurs d'échappement et les échecs d'appels d'outils.
Discussion
Résultats
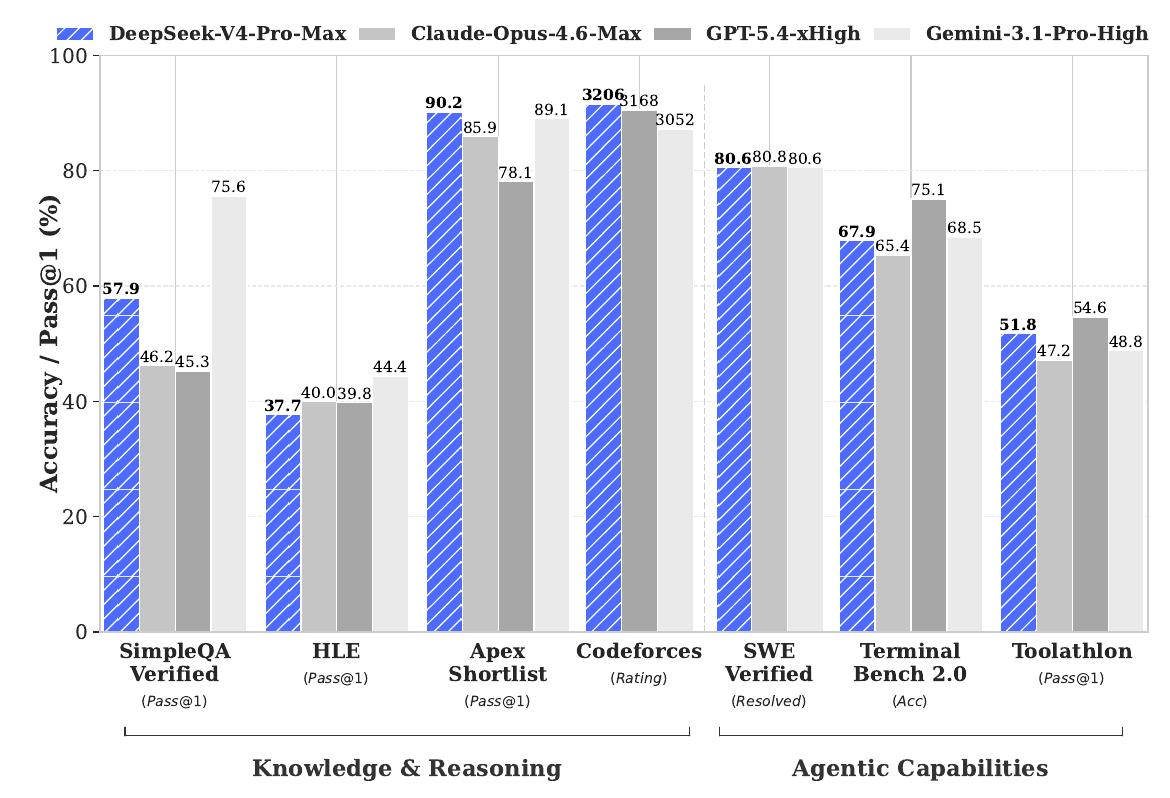
Les barres hachurées sont V4-Pro-Max ; les trois autres sont les réglages de raisonnement les plus forts des modèles fermés.
En connaissances, V4-Pro-Max obtient 57.9 sur SimpleQA Verified, au-dessus des 46.2 de Claude-Opus-4.6-Max et des 45.3 de GPT-5.4-xHigh, mais nettement sous les 75.6 de Gemini-3.1-Pro-High ; sur HLE, il obtient 37.7, un peu sous les trois autres (40.0, 39.8, 44.4). En tâches d'agent, ses 80.6 sur SWE Verified sont presque identiques aux scores des autres modèles ; sur Terminal Bench 2.0, il obtient 67.9, derrière les 75.1 de GPT-5.4-xHigh.
Cela concorde avec la synthèse des auteurs eux-mêmes : les meilleurs résultats parmi les modèles ouverts, un raisonnement proche des modèles fermés de pointe, et des tâches d'agent au niveau des meilleurs modèles ouverts, un peu en retrait des modèles fermés de pointe.
V4-Flash-Max fait moins bien sur les connaissances, faute de paramètres, mais avec un budget de réflexion plus grand, il égale V4-Pro sur les tâches de raisonnement.
Les limites reconnues par les auteurs
La conclusion contient un passage très franc. Pour pousser à l'extrême l'efficacité en long contexte, l'architecture de V4 est assez audacieuse ; pour réduire les risques, elle conserve aussi de nombreux composants et petites astuces déjà validés, si bien que l'ensemble est devenu assez complexe. Les auteurs annoncent comme prochaine étape une étude plus complète et plus méthodique, pour réduire l'architecture à l'essentiel. Le routage anticipé et l'écrêtage de SwiGLU fonctionnent, mais leur principe reste obscur.
Par ailleurs, le titre du rapport indique qu'il s'agit d'une « préversion » ; la plupart des comparaisons sont faites dans le cadre d'évaluation des auteurs, et une partie des comparaisons sur les tâches d'agent vient d'évaluations internes.
Conclusion
DeepSeek-V4 rend abordable un contexte d'un million de tokens grâce à deux attentions compressées : CSA compresse par 4 puis sélectionne avec soin un peu plus d'un millier d'entrées, HCA compresse par 128 pour saisir les contours globaux. mHC élargit le flux résiduel et verrouille la stabilité avec des matrices doublement stochastiques, et Muon accélère la convergence. Au final, à un million de tokens, le calcul par token de V4-Pro n'est plus qu'environ le quart de celui de la génération précédente, et son cache KV le dixième.
Pour qui suit la fusion de modèles, ce rapport fournit un contre-exemple intéressant. Pour un même objectif, réunir une équipe d'experts en un seul modèle, Command A choisit de moyenner les poids, DeepSeek de laisser l'élève écrire lui-même et les enseignants le guider token par token.
L'atout de la fusion, c'est son faible coût ; celui de la distillation, sa précision. La puissance de calcul de DeepSeek peut visiblement se payer la seconde.