Article original
What is being transferred in transfer learning?
- Publication
- NeurIPS 2020Conférence
- Premier dépôt sur arXiv
- arXiv:2008.11687
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modeltuningwhatistransferred2020,
  title = {{What is being transferred in transfer learning?}},
  author = {Behnam Neyshabur and Hanie Sedghi and Chiyuan Zhang},
  year = {2020},
  eprint = {2008.11687},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2008.11687}
}
Partir de poids préentraînés sur ImageNet puis les ajuster est presque l'ouverture standard en vision par ordinateur.
On s'en sert pour classer des photos, pour l'imagerie médicale, et même pour des gribouillis dessinés à la main. Tout le monde sait que ça marche ; l'explication habituelle est la « réutilisation des caractéristiques » : le préentraînement apprend des bords, des textures et des formes, que la tâche en aval réutilise directement.
Cette explication a pourtant une faille évidente. Les radiographies thoraciques ne ressemblent en rien aux photos d'ImageNet, et les gribouillis se réduisent à quelques traits. Pourquoi le préentraînement aide-t-il encore ?
Neyshabur, Sedghi et Zhang, de Google, conçoivent une série d'expériences qui décomposent « ce que le préentraînement transporte réellement » en plusieurs questions mesurables. L'une des réponses deviendra un fondement important de la fusion de modèles.
Définir le problème
Les auteurs distinguent quatre sortes de modèles, dont les abréviations reviendront tout au long de la note :
- P : le modèle préentraîné sur ImageNet.
- RI : le modèle initialisé aléatoirement.
- P-T : le modèle obtenu à partir de P après ajustement fin (fine-tune) sur les données cibles.
- RI-T : le modèle entraîné directement sur les données cibles à partir de RI.
Les tâches cibles sont quatre jeux de données plus ou moins éloignés d'ImageNet : real (photos réelles), clipart (dessins de type clipart) et quickdraw (gribouillis des joueurs du jeu « Quick, Draw! » de Google) de DomainNet, ainsi que les radiographies thoraciques de CheXpert. Plus on avance dans la liste, moins les images ressemblent à des photos naturelles.
Chaque domaine de DomainNet compte 345 catégories d'objets ; les auteurs y tirent 50 000 images d'entraînement et 50 000 de test. Pour CheXpert, ils tirent de l'ensemble d'entraînement deux échantillons de 50 000 images, l'un pour l'entraînement et l'autre pour le test ; la tâche consiste à détecter cinq pathologies thoraciques.
Le modèle est toujours un ResNet-50 avec initialisation Fixup, privé de toutes ses couches BatchNorm.
Trois questions sont posées. Quelle part du bénéfice du préentraînement vient de la réutilisation des caractéristiques ? En quoi P-T et RI-T diffèrent-ils dans l'espace des paramètres ? Quelles parties du réseau sont réellement transférées ?
Résoudre le problème
D'abord les courbes d'apprentissage
Sur les quatre tâches cibles, P-T fait mieux que RI-T et converge beaucoup plus vite. L'écart est le plus grand sur real, ce qui cadre avec l'intuition de la réutilisation des caractéristiques, puisque les photos réelles sont les plus proches d'ImageNet.
Mais on observe aussi un gain sur CheXpert et quickdraw. Au moins pour ces deux tâches, « réutiliser des caractéristiques visuelles » ne semble pas tout expliquer.
Mélanger les images
Pour isoler la réutilisation des caractéristiques, les auteurs mènent une expérience très directe. Les images des données cibles sont découpées en blocs de même taille, dont les positions sont mélangées au hasard.
Des blocs de 224×224 reviennent à ne rien mélanger ; plus les blocs sont petits, plus la forme et la structure des objets sont détruites. À 1×1, chaque pixel est déplacé, mais les trois valeurs RGB d'un pixel restent solidaires ; les auteurs ajoutent donc un réglage « * », où les pixels de chaque canal se déplacent indépendamment, jusqu'à passer dans d'autres canaux.
Avec « * », l'image se réduit à une distribution de valeurs de pixels ; toute structure visuelle a disparu, et les bords et textures appris au préentraînement ne peuvent plus servir.
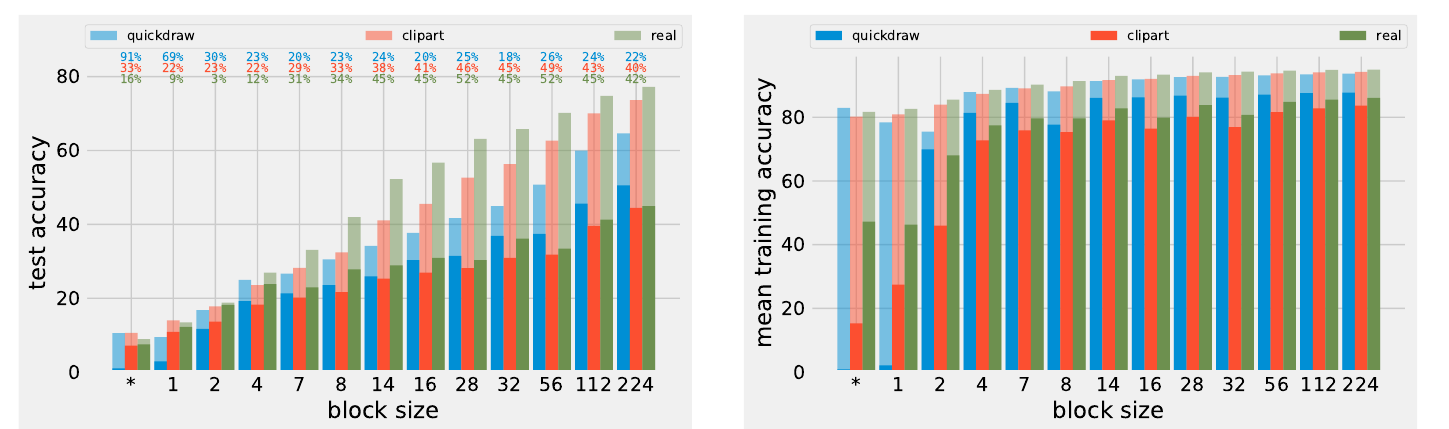
Les trois rangées de petits nombres au-dessus du graphique de gauche sont les plus intéressantes. Ce sont des écarts relatifs de précision, , autrement dit la proportion que représente le bénéfice du préentraînement.
Pour real (vert), l'écart est de 42 % sans mélange et tombe à 3 % avec des blocs de 2. Celui de clipart (rouge) passe aussi d'environ 40 % à un peu plus de 20 %. Plus les blocs sont petits, plus le bénéfice du préentraînement diminue, ce qui atteste la réutilisation des caractéristiques.
Le cas de quickdraw (bleu) est différent. Pour la plupart des tailles de blocs, il reste autour de 20 à 25 %, sans baisser quand les blocs rapetissent ; à 1×1 et à « * », les chiffres bondissent même à 69 % et 91 %. Dans ces deux cas, RI-T n'apprend presque rien, d'où un écart relatif aussi grand.
Le graphique de droite porte sur la vitesse d'entraînement. La précision d'entraînement de P-T reste stable quelle que soit la taille des blocs, tandis que celle de RI-T chute fortement pour les petits blocs. Avec « * », la précision d'entraînement moyenne de RI-T sur quickdraw est proche de zéro, alors que P-T reste au-dessus de 80 %.
Cette figure décompose le bénéfice du préentraînement en deux parts :
- Réutilisation des caractéristiques : plus les données ressemblent à celles du préentraînement, plus elle contribue ; elle disparaît quand la structure de l'image est détruite.
- Statistiques de bas niveau : même quand il ne reste que la distribution des valeurs de pixels, les poids préentraînés accélèrent nettement l'entraînement, et améliorent parfois la précision finale.
Les auteurs nomment ce second effet « statistiques de bas niveau » pour souligner qu'il ne porte aucune structure visuelle ou sémantique. Quant à savoir quelle propriété des poids préentraînés aide l'optimisation, l'échelle des poids par exemple, l'article ne pousse pas la décomposition plus loin.
Ouvrir les modèles
Les auteurs comparent ensuite les modèles entraînés eux-mêmes.
Recouvrement des erreurs. Deux P-T (ajustés avec des graines aléatoires différentes) commettent des erreurs très semblables ; entre P-T et RI-T, les erreurs divergentes sont bien plus nombreuses. En examinant des exemples de DomainNet, les auteurs constatent que les images où P-T se trompe et RI-T a raison sont surtout ambiguës, tandis que celles où P-T a raison et RI-T se trompe comprennent beaucoup d'images simples.
Similarité des caractéristiques. Les auteurs comparent avec CKA (centered kernel alignment) les caractéristiques produites par deux modèles à une même couche. Voici la Table 1, sur CheXpert :
| Comparaison | conv1 | layer 1 | layer 2 | layer 3 | layer 4 |
|---|---|---|---|---|---|
| P-T & P | 0.6225 | 0.4592 | 0.2896 | 0.1877 | 0.0453 |
| P-T & P-T | 0.6710 | 0.8230 | 0.6052 | 0.4089 | 0.1628 |
| P-T & RI-T | 0.0036 | 0.0011 | 0.0022 | 0.0003 | 0.0808 |
| RI-T & RI-T | 0.0016 | 0.0088 | 0.0004 | 0.0004 | 0.0424 |
Les deux P-T se ressemblent à chaque couche ; deux RI-T ont aussi une précision correcte, mais des caractéristiques presque sans ressemblance. Plus on se rapproche de la sortie, plus la similarité entre P-T et P baisse, ce qui indique que l'ajustement fin modifie surtout les couches hautes.
Distance entre paramètres. Deux P-T sont aussi proches dans l'espace des paramètres. Sur CheXpert, la distance entre deux P-T est d'environ 200, contre environ 255 pour deux RI-T ; sur les trois domaines de DomainNet, l'écart est plus net, avec 178 à 219 pour deux P-T et 777 à 822 pour deux RI-T.
Un même bassin
C'est la section la plus liée à la fusion de modèles. Les auteurs interpolent linéairement entre deux solutions et et observent les performances des modèles le long du chemin :
Si les deux solutions se trouvent dans un même bassin plat, le chemin d'interpolation reste dans le bassin et les performances ne s'effondrent pas.
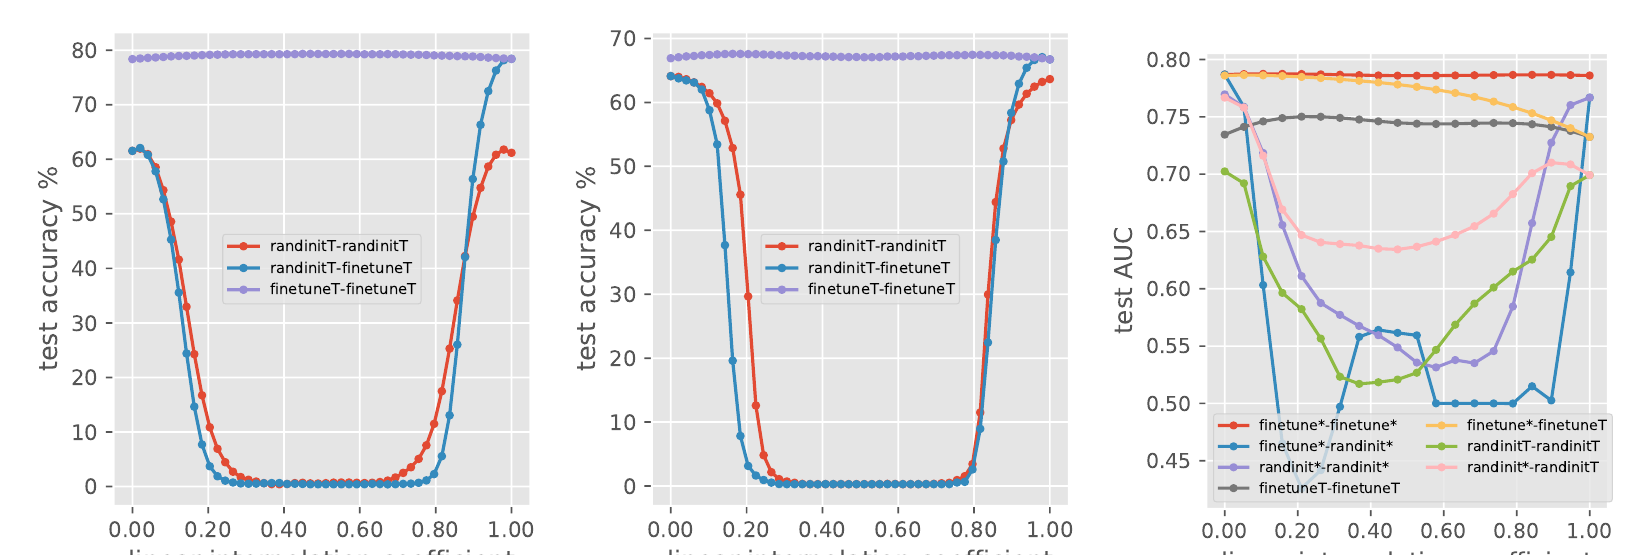
Les deux graphiques de gauche se lisent facilement. Sur real, la ligne violette entre deux P-T reste autour de 80 % d'un bout à l'autre, tandis que la ligne rouge entre deux RI-T tombe près de zéro au milieu. Même chose pour quickdraw.
Plus intéressant encore, les auteurs donnent aux deux RI-T exactement la même initialisation aléatoire, seul l'aléa de l'entraînement différant, et la barrière subsiste. Un point de départ commun ne suffit pas ; il doit avoir été préentraîné. Sur CheXpert, RI-T présente même une petite barrière entre le meilleur checkpoint et le checkpoint final d'une même trajectoire d'entraînement ; P-T n'en présente aucune.
Les auteurs tentent aussi de donner une définition formelle du « bassin », appelée -basin. Pour qu'un ensemble convexe compte comme bassin, la perte de la plupart de ses points doit être proche de la moyenne ; à sa frontière, ajouter un bruit gaussien ou s'étendre vers l'extérieur doit faire nettement monter la perte. Avec l'erreur de test comme perte, les paramètres du bassin des deux P-T valent pour real, pour clipart et pour quickdraw ; pour deux RI-T, aucun raisonnable ne les place dans un même bassin.
Le modèle au milieu du chemin d'interpolation fait parfois même un peu mieux que les deux extrémités. C'est l'observation de l'article la plus utile pour les recherches suivantes. Des modèles ajustés à partir d'un même point de départ préentraîné peuvent être moyennés directement.
Quelles couches sont transférées ?
Les auteurs reprennent la méthode de Zhang et al. Dans un réseau entraîné, ils ramènent un module à ses valeurs initiales en laissant les autres à leurs valeurs entraînées, et mesurent la baisse de performance. Les modules dont la performance chute beaucoup sont dits « critiques ».
Sur CheXpert, la répartition des modules critiques de P-T ressemble à celle d'un entraînement supervisé ordinaire ; seule différence, la couche entièrement connectée devient critique pour P-T, ce qui est logique puisque la tête de classification n'est entraînée que pour la nouvelle tâche.
Les auteurs étendent ensuite la définition de la criticité des modules de Chatterji et al. et mesurent le niveau de bruit que supportent les paramètres d'un module le long du chemin qui va des valeurs initiales aux valeurs optimales. Plus un module est proche de la sortie, plus sa vallée est étroite et moins on peut y toucher ; les modules proches de l'entrée sont plus tolérants. Cela rejoint la vieille observation selon laquelle « les couches basses apprennent des caractéristiques générales, les couches hautes des caractéristiques propres à la tâche », et indique que la réutilisation des caractéristiques se produit surtout dans les couches proches de l'entrée.
Pour RI-T, les modules présentent en outre un point d'inflexion sur le chemin, où la vallée s'élargit et se rétrécit tour à tour. Les auteurs supposent un lien avec un changement de bassin en cours d'entraînement, sans pouvoir l'expliquer clairement.
Combien de temps préentraîner ?
La dernière expérience est très pratique. Les auteurs ajustent les checkpoints de chaque époque du préentraînement ImageNet ; le préentraînement fait décroître le taux d'apprentissage aux époques 30 et 60.
La tendance générale est que les checkpoints plus tardifs donnent de meilleurs résultats, avec quelques nuances :
- Les checkpoints juste avant et après une décroissance du taux d'apprentissage (par exemple 29, 30, 31) donnent des résultats d'ajustement semblables. La précision du préentraînement fait un grand bond au moment de la décroissance, sans bond correspondant de l'aide apportée en aval.
- Le bénéfice en vitesse d'entraînement sature vers le checkpoint 10 ; la précision finale continue de progresser jusque vers le checkpoint 60 sur real et clipart. Sur quickdraw, la précision finale plafonne très tôt, dès le checkpoint 10.
- La précision du modèle préentraîné lui-même n'est donc pas forcément un indicateur fiable de l'efficacité du transfert.
Les auteurs relient ces résultats à l'observation des bassins. Les premiers checkpoints du préentraînement sont encore hors du bassin final ; une fois dans le bassin, le checkpoint de départ importe peu, et l'on peut donc commencer l'ajustement fin à partir d'un checkpoint plus précoce.
Discussion
C'est un article d'analyse, sans méthode nouvelle ; sa valeur tient à quelques observations directement exploitables.
Il faut garder en tête la portée des preuves. Toutes les expériences utilisent une seule architecture (ResNet-50 sans BatchNorm), une seule source de préentraînement (ImageNet), et quatre jeux de données d'images comme tâches cibles. Dans les travaux connexes, les auteurs précisent que le transfert en NLP diffère par la nature des données, le mode de préentraînement et l'écart de distribution ; cet article n'étudie que la vision.
L'expression « statistiques de bas niveau » n'est elle aussi qu'une description. Elle nous dit qu'un certain bénéfice subsiste après mélange des images ; quant à savoir si c'est la distribution des pixels, l'échelle des poids ou une autre propriété liée à l'optimisation qui agit, l'article ne le vérifie pas séparément. Pour le point d'inflexion de la criticité des modules, les auteurs s'en tiennent aussi à une hypothèse.
L'observation du « même bassin » est celle qui a eu le plus d'influence. Dans leur conclusion, les auteurs ne la mentionnent qu'en une phrase : moyenner des modèles d'un même bassin ne dégrade pas les performances. Deux ans plus tard, Model Soups en fait une pratique concrète, en moyennant directement de nombreux modèles ajustés avec des hyperparamètres différents, et cite cet article pour justifier que la moyenne fonctionne.
Conclusion
Le préentraînement transporte deux choses. D'une part des caractéristiques visuelles, d'autant plus utiles que les données en aval ressemblent à ImageNet ; d'autre part des statistiques de bas niveau, qui subsistent même quand les pixels sont mélangés, et qui accélèrent surtout l'entraînement.
Des modèles ajustés à partir des mêmes poids préentraînés ont des caractéristiques proches, des paramètres proches, et aucune barrière sur l'interpolation linéaire. Des modèles entraînés depuis zéro n'y parviennent pas, même avec une même initialisation aléatoire.
La prochaine fois que vous aurez deux jeux de poids ajustés à partir du même modèle préentraîné, ne vous pressez pas d'en choisir un. Essayez de les moyenner ; il se pourrait bien qu'aucun des deux ne vaille celui du milieu.