Article original
Gemma 2: Improving Open Language Models at a Practical Size
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2408.00118
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformersgemma22024,
  title = {{Gemma 2: Improving Open Language Models at a Practical Size}},
  author = {Gemma Team and Morgane Riviere and Shreya Pathak and Pier Giuseppe Sessa and Cassidy Hardin and Surya Bhupatiraju and Léonard Hussenot and Thomas Mesnard and Bobak Shahriari and Alexandre Ramé and Johan Ferret and Peter Liu and Pouya Tafti and Abe Friesen and Michelle Casbon and Sabela Ramos and Ravin Kumar and Charline Le Lan and Sammy Jerome and Anton Tsitsulin and Nino Vieillard and Piotr Stanczyk and Sertan Girgin and Nikola Momchev and Matt Hoffman and Shantanu Thakoor and Jean-Bastien Grill and Behnam Neyshabur and Olivier Bachem and Alanna Walton and Aliaksei Severyn and Alicia Parrish and Aliya Ahmad and Allen Hutchison and Alvin Abdagic and Amanda Carl and Amy Shen and Andy Brock and Andy Coenen and Anthony Laforge and Antonia Paterson and Ben Bastian and Bilal Piot and Bo Wu and Brandon Royal and Charlie Chen and Chintu Kumar and Chris Perry and Chris Welty and Christopher A. Choquette-Choo and Danila Sinopalnikov and David Weinberger and Dimple Vijaykumar and Dominika Rogozińska and Dustin Herbison and Elisa Bandy and Emma Wang and Eric Noland and Erica Moreira and Evan Senter and Evgenii Eltyshev and Francesco Visin and Gabriel Rasskin and Gary Wei and Glenn Cameron and Gus Martins and Hadi Hashemi and Hanna Klimczak-Plucińska and Harleen Batra and Harsh Dhand and Ivan Nardini and Jacinda Mein and Jack Zhou and James Svensson and Jeff Stanway and Jetha Chan and Jin Peng Zhou and Joana Carrasqueira and Joana Iljazi and Jocelyn Becker and Joe Fernandez and Joost van Amersfoort and Josh Gordon and Josh Lipschultz and Josh Newlan and Ju-yeong Ji and Kareem Mohamed and Kartikeya Badola and Kat Black and Katie Millican and Keelin McDonell and Kelvin Nguyen and Kiranbir Sodhia and Kish Greene and Lars Lowe Sjoesund and Lauren Usui and Laurent Sifre and Lena Heuermann and Leticia Lago and Lilly McNealus and Livio Baldini Soares and Logan Kilpatrick and Lucas Dixon and Luciano Martins and Machel Reid and Manvinder Singh and Mark Iverson and Martin Görner and Mat Velloso and Mateo Wirth and Matt Davidow and Matt Miller and Matthew Rahtz and Matthew Watson and Meg Risdal and Mehran Kazemi and Michael Moynihan and Ming Zhang and Minsuk Kahng and Minwoo Park and Mofi Rahman and Mohit Khatwani and Natalie Dao and Nenshad Bardoliwalla and Nesh Devanathan and Neta Dumai and Nilay Chauhan and Oscar Wahltinez and Pankil Botarda and Parker Barnes and Paul Barham and Paul Michel and Pengchong Jin and Petko Georgiev and Phil Culliton and Pradeep Kuppala and Ramona Comanescu and Ramona Merhej and Reena Jana and Reza Ardeshir Rokni and Rishabh Agarwal and Ryan Mullins and Samaneh Saadat and Sara Mc Carthy and Sarah Cogan and Sarah Perrin and Sébastien M. R. Arnold and Sebastian Krause and Shengyang Dai and Shruti Garg and Shruti Sheth and Sue Ronstrom and Susan Chan and Timothy Jordan and Ting Yu and Tom Eccles and Tom Hennigan and Tomas Kocisky and Tulsee Doshi and Vihan Jain and Vikas Yadav and Vilobh Meshram and Vishal Dharmadhikari and Warren Barkley and Wei Wei and Wenming Ye and Woohyun Han and Woosuk Kwon and Xiang Xu and Zhe Shen and Zhitao Gong and Zichuan Wei and Victor Cotruta and Phoebe Kirk and Anand Rao and Minh Giang and Ludovic Peran and Tris Warkentin and Eli Collins and Joelle Barral and Zoubin Ghahramani and Raia Hadsell and D. Sculley and Jeanine Banks and Anca Dragan and Slav Petrov and Oriol Vinyals and Jeff Dean and Demis Hassabis and Koray Kavukcuoglu and Clement Farabet and Elena Buchatskaya and Sebastian Borgeaud and Noah Fiedel and Armand Joulin and Kathleen Kenealy and Robert Dadashi and Alek Andreev},
  year = {2024},
  eprint = {2408.00118},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2408.00118}
}
Pour rendre un petit modèle plus fort, le moyen le plus courant est de lui donner davantage de données.
Le modèle 8B de Llama 3 a vu 15T tokens, bien au-delà de ce que recommandent les lois d'échelle. La recette marche, mais avec des rendements de plus en plus faibles. Le rapport le souligne dès l'introduction : selon les lois d'échelle de Chinchilla, les performances ne croissent à peu près qu'avec le logarithme de la quantité de données ; les petits modèles les plus récents consomment énormément de données supplémentaires pour ne gagner que 1 à 2 points de pourcentage sur la plupart des benchmarks.
Cela montre aussi que les petits modèles ne sont pas encore assez entraînés. Le problème est que les données finiront par s'épuiser, et que chaque doublement des données double aussi le coût d'entraînement.
En juin 2024, l'équipe Gemma de Google DeepMind publie Gemma 2 et prend une autre direction. Plutôt que de faire voir davantage de tokens à un petit modèle, autant lui faire apprendre davantage sur chaque token. La méthode est la distillation de connaissances : la distribution prédite par un grand modèle remplace la réponse de référence d'origine.
Gemma 2 existe en trois tailles, 2B, 9B et 27B. Les 2B et 9B sont entraînés par distillation, le 27B à partir de zéro.
Définir le problème
Dans l'entraînement ordinaire d'un modèle de langage, chaque position n'apprend au modèle qu'une seule chose : quel est le token suivant.
Prenons un exemple. Pour « Aujourd'hui, j'ai envie de boire __ », le mot suivant dans les données d'entraînement est « café » ; la cible est alors un vecteur one-hot qui vaut 1 pour « café » et 0 partout ailleurs. Pourtant « thé » et « eau » seraient tout aussi raisonnables, et la cible one-hot ne les mentionne pas du tout.
Un grand modèle déjà entraîné dirait peut-être « café 0.6, thé 0.3, eau 0.1 ». En prenant toute cette distribution comme cible, le petit modèle apprend en plus, à la même position, que « thé convient aussi ». Les auteurs disent très clairement à quoi sert la distillation : « simuler un entraînement au-delà du nombre de tokens disponibles ».
La perte de distillation est l'entropie croisée entre la distribution de l'enseignant et celle de l'élève :
est le contexte, et la somme porte sur tout le vocabulaire. Si l'on remplace la distribution de l'enseignant par un one-hot, l'expression redevient la prédiction ordinaire du token suivant.
L'idée n'est pas nouvelle ; Gemini 1.5 a aussi utilisé la distillation. Ce rapport cherche à répondre à une autre question. Appliquée au préentraînement à grande échelle, avec un petit modèle qui voit bien plus de tokens que la quantité optimale, que donne la distillation ?
Résoudre le problème
Architecture
Comme la première génération, Gemma 2 est un Transformer décodeur seul, avec une longueur de contexte de 8 192, RoPE et une GeGLU approchée. Il apporte quatre nouveautés :
- Alternance d'attention locale et globale. Le type change une couche sur deux ; les couches locales utilisent une fenêtre glissante de 4 096 tokens, les couches globales voient les 8 192 tokens en entier.
- Logit soft-capping. Dans les couches d'attention et dans la couche de sortie finale, les logits passent par , avec un plafond de 50 pour les couches d'attention et de 30 pour la couche de sortie.
- Normalisation avant et après. L'entrée et la sortie de chaque sous-couche passent par RMSNorm, dans le but de stabiliser l'entraînement.
- Attention à requêtes groupées (GQA), avec 2 groupes.
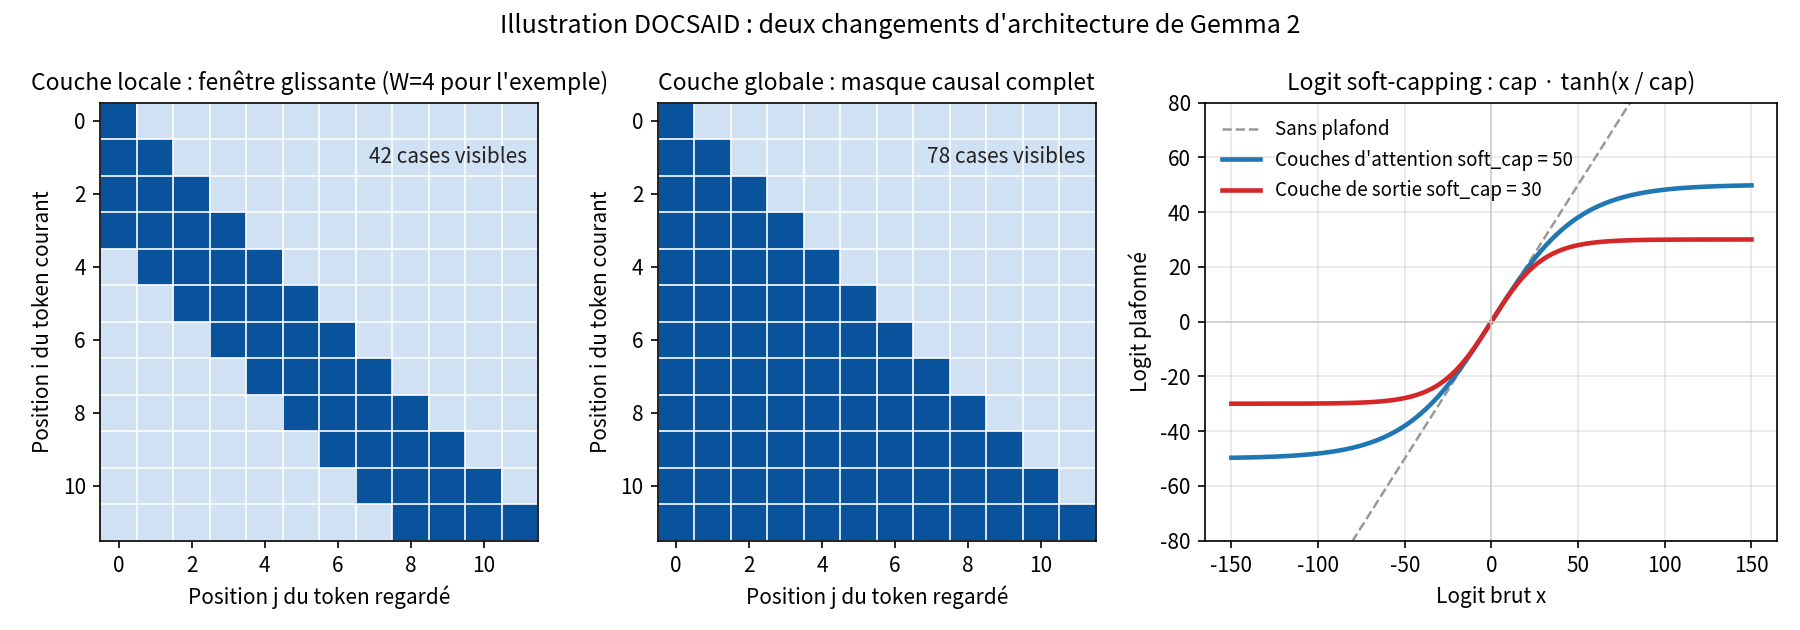
Les deux masques de gauche montrent ce que les couches locales économisent. Dans une couche globale, chaque token voit tous les tokens précédents, et le calcul croît avec le carré de la longueur ; dans une couche locale, chaque token ne voit au plus que les tokens de la fenêtre, et le coût reste borné. L'alternance permet à la moitié des couches d'économiser du calcul, tout en conservant une vue d'ensemble une couche sur deux.
Le graphique de droite montre le soft-capping. Quand les logits sont petits, ils ne sont presque pas modifiés, car tanh est presque linéaire autour de 0 ; quand ils sont très grands, ils sont écrasés près du plafond, ce qui évite qu'une valeur devienne si grande que le softmax ne regarde presque plus qu'une seule position. Ce choix aide à stabiliser l'entraînement, mais, comme on le verra plus loin, il a aussi causé quelques ennuis côté inférence.
Voici la configuration des trois modèles (d'après la Table 1 du rapport) :
| 2B | 9B | 27B | |
|---|---|---|---|
| Dimension cachée | 2 304 | 3 584 | 4 608 |
| Couches | 26 | 42 | 46 |
| Dimension feed-forward | 18 432 | 28 672 | 73 728 |
| Têtes d'attention / têtes KV | 8 / 4 | 16 / 8 | 32 / 16 |
| Vocabulaire | 256 128 | 256 128 | 256 128 |
Le vocabulaire reprend les 256K tokens de Gemini, conçus à l'origine pour couvrir un grand nombre de langues ; la couche d'embedding compte donc beaucoup de paramètres. Le modèle 2B en a environ 590 millions dans l'embedding, pour environ 2 milliards de paramètres hors embedding.
Données de préentraînement et matériel
Le 27B est entraîné sur 13T tokens, le 9B sur 8T et le 2B sur 2T. Les données sont majoritairement en anglais : pages web, code et articles scientifiques. Gemma 2 n'est pas un modèle multimodal et n'a pas été entraîné spécialement pour le multilingue.
Pour les 2B et 9B, la quantité de données dépasse de loin celle que recommandent les lois d'échelle. Avec l'estimation courante d'« environ 20 tokens par paramètre », la quantité optimale du 2B serait d'environ 40B tokens, pour 2T réellement utilisés, soit 50 fois plus ; celle du 9B d'environ 180B tokens, pour 8T utilisés, soit encore plus de quarante fois l'optimum.
L'entraînement utilise les TPU maison de Google : 512 TPUv5e pour le 2B, 4 096 TPUv4 pour le 9B et 6 144 TPUv5p pour le 27B. Le rapport estime les émissions de carbone de l'ensemble du préentraînement de Gemma 2 à environ 1 248 tonnes équivalent CO₂.
Post-entraînement : la dernière étape est une moyenne
Le post-entraînement comporte trois étapes :
- SFT : des prompts synthétiques et réels, avec des réponses générées surtout par un modèle enseignant plus grand ; une distillation est aussi effectuée sur la propre distribution de sortie de l'élève.
- RLHF : le modèle de récompense est d'un ordre de grandeur plus grand que le modèle de politique et accorde plus de poids aux dialogues multi-tours. Une partie des prompts provient de LMSYS-Chat-1M, dont seuls les prompts sont repris, sans les réponses.
- Fusion de modèles : on fait la moyenne des modèles obtenus en exécutant tout le pipeline avec différents hyperparamètres.
Pour cette troisième étape, le rapport cite WARP, de Ramé et al., de la même équipe. Il n'y consacre qu'une phrase, sans comparaison avant et après la fusion.
Discussion
Quelle aide apporte vraiment la distillation ?
Le rapport contient peu d'ablations, mais chacune vise une décision de conception. La plus importante concerne la distillation :
| Modèle 2B, entraîné sur 500B tokens | Entraînement à partir de zéro | Distillation depuis un enseignant 7B |
|---|---|---|
| Moyenne de trois benchmarks | 60.3 | 67.7 |
500B tokens, c'est déjà 10 fois la quantité optimale pour un modèle 2B ; la distillation garde pourtant 7.4 points d'avance. L'enseignant 7B sert ici à reproduire le rapport de taille « 27B enseigne à 9B ».
Le bénéfice de la distillation disparaît-il quand le modèle grandit ? Les auteurs fixent l'enseignant 7B et entraînent trois élèves, de 200M, 400M et 1B :
| Perplexité de validation | 200M | 400M | 1B |
|---|---|---|---|
| Entraînement à partir de zéro | 23 | 19 | 17 |
| Distillation | 21 | 17 | 15 |
Pour les trois tailles, la perplexité est systématiquement inférieure de 2 ; l'écart ne se réduit pas.
La comparaison des modèles finaux va dans le même sens. Le 2B de Gemma 2 utilise 2T tokens, celui de la première génération 3T ; avec moins de données, le nouveau modèle est pourtant nettement meilleur sur les benchmarks, et le 9B dépasse d'environ 10 % le 7B de la première génération sur certains benchmarks. Les auteurs attribuent ce progrès à la distillation.
Toutefois, entre la première et la deuxième génération, l'architecture, les données et le post-entraînement ont aussi changé, en plus de la distillation ; cette comparaison ne permet pas d'attribuer le mérite à la seule distillation. Les preuves vraiment propres sont les deux tableaux d'ablation ci-dessus, et tous deux portent sur des configurations bien plus petites que les modèles finaux.
Autres ablations d'architecture
- GQA et attention multi-têtes : sur le 9B, la moyenne de quatre benchmarks est de 50.3 avec l'attention multi-têtes et de 50.8 avec GQA, un écart très faible. Les auteurs choisissent GQA pour ses paramètres moins nombreux et son inférence plus rapide.
- Profondeur contre largeur : pour un 9B à nombre de paramètres égal, la version plus profonde obtient 52.0 en moyenne, la plus large 50.8. L'écart est faible mais constant ; Gemma 2 est donc plus profond que la première génération.
- Réduire la fenêtre glissante à l'inférence : quand la fenêtre du 9B passe de 4 096 à 2 048 puis 1 024, la perplexité passe seulement de 1.63 à 1.63 et 1.64. Au besoin, on peut réduire la fenêtre pour gagner un peu de vitesse d'inférence.
- Robustesse au format : sur 12 combinaisons de formats de prompt et d'évaluation, l'écart-type des scores MMLU est de 0.9 pour Gemma 2 9B et de 1.0 pour le 27B, contre 6.9 pour Mistral 7B.
Résultats
La version préentraînée du 27B a été comparée à Llama 3 70B sur la suite d'évaluation de Hugging Face : MMLU 75.2 contre 79.2, GSM8K 74.0 contre 76.9, HellaSwag 86.4 contre 88.0. Avec un modèle 2.5 fois plus petit, entraîné sur 13T tokens, moins que les 15T de Llama 3, le retard n'est que de quelques points. Les auteurs reconnaissent aussi franchement que les performances d'un modèle entraîné à partir de zéro ne croissent à peu près qu'avec le logarithme de sa taille ; le 27B se trouve sans doute sur la même courbe de Pareto que Llama 3.
Ce sont les résultats de la version post-entraînée sur LMSYS Chatbot Arena qui ont le plus retenu l'attention. Le 27B obtient un Elo de 1218, au-dessus des 1206 de Llama 3 70B ; le 9B obtient 1187, au niveau des 1186 de GPT-4-0314 ; le 2B (2.6B pour être exact) obtient 1126, au-dessus des 1116 de GPT-3.5-Turbo-0613.
Toutes ces comparaisons se font en nombre total de paramètres. Les auteurs précisent que c'est parce que, lorsqu'on utilise un modèle ouvert sur un appareil ordinaire, la contrainte est généralement la mémoire totale plutôt que les paramètres actifs.
Évaluations humaines et mémorisation
En plus de l'Arena, les auteurs mènent deux séries d'évaluations humaines. Sur des prompts à un seul tour, ils comparent sécurité et suivi d'instructions avec GPT-4o ; pour le multi-tour, des évaluateurs notent de 1 à 5 la satisfaction globale et l'atteinte des objectifs dans 500 scénarios de dialogue multi-tours. Face à Gemma 1.1 7B, de la première génération, les trois tailles de Gemma 2 font mieux sur les deux indicateurs ; par exemple, la satisfaction des utilisateurs du 27B passe de 3.32 à 4.20.
Le rapport mesure aussi la mémorisation mot pour mot des données d'entraînement. On donne au modèle les 50 premiers tokens d'un extrait des données d'entraînement et l'on regarde s'il restitue mot pour mot les 50 tokens suivants. Le taux de mémorisation exacte de Gemma 2 est inférieur à 0.1 %, nettement plus bas que celui des autres modèles de même catégorie ; le taux de mémorisation approximative, avec un seuil de distance d'édition de 10 %, est plus élevé, mais reste inférieur à la mémorisation exacte de la première génération de Gemma. Par source de données, le code, Wikipédia et les articles scientifiques sont davantage mémorisés.
Le coût réel du soft-capping
Le soft-capping n'occupe que deux lignes dans l'article, mais il a causé pas mal d'ennuis dans la communauté.
À la sortie de Gemma 2, aucune des implémentations courantes de FlashAttention ne prenait en charge le soft-capping sur les scores d'attention. Hugging Face prévenait dans ses notes de publication qu'il fallait soit renoncer à l'accélération de FlashAttention, soit sacrifier des performances. Lorsque llama.cpp a ajouté le correctif du soft-capping, le chargement de Gemma 2 désactivait d'office FlashAttention, et les fichiers GGUF déjà convertis devaient être régénérés. Dans les premiers temps, des utilisateurs de Hugging Face ont aussi signalé des fautes de frappe et des hallucinations dans les sorties du 27B ; le correctif désigné dans la discussion consistait justement à ajouter cette étape côté inférence.
Une astuce de stabilité d'apparence anodine a coûté plusieurs semaines de rattrapage à tout l'écosystème d'inférence.
Ce que le rapport ne dit pas
Le rapport ne précise ni la composition exacte des données de préentraînement, ni le modèle qui a servi d'enseignant au 2B et au 9B ; d'après la formulation des ablations, les auteurs visent un rapport de taille « 27B enseigne à 9B », mais l'identité officielle des enseignants n'est pas précisée. Les données, les hyperparamètres et les détails de la fusion de modèles du post-entraînement se résument eux aussi à quelques phrases.
Conclusion
Le message de Gemma 2 est simple. Plutôt que de faire voir plus de données à un petit modèle, mieux vaut que chaque token porte plus d'information. En prenant comme cible d'entraînement la distribution de probabilité d'un grand modèle, les 2B et 9B sont distillés sur bien plus de données que la quantité optimale et obtiennent les meilleurs résultats de leur catégorie.
Les quelques changements d'architecture (alternance locale-globale, soft-capping, normalisation avant et après) n'ont rien d'inédit, mais leur combinaison est très pratique.
Avant de déployer Gemma 2, vérifiez que votre framework d'inférence implémente le soft-capping. Sans ce tanh-là, le modèle se met à faire des fautes de frappe.