Article original
Linear Mode Connectivity and the Lottery Ticket Hypothesis
- Publication
- ICML 2020Conférence
- Premier dépôt sur arXiv
- arXiv:1912.05671
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmerginglinearmodeconnectivity2019,
  title = {{Linear Mode Connectivity and the Lottery Ticket Hypothesis}},
  author = {Jonathan Frankle and Gintare Karolina Dziugaite and Daniel M. Roy and Michael Carbin},
  year = {2019},
  eprint = {1912.05671},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1912.05671}
}
Fixer les poids initiaux et les hyperparamètres d'un réseau ne suffit pas à reproduire exactement un entraînement. L'ordre des données change à chaque époque, tout comme les recadrages et retournements tirés pour l'augmentation. L'article regroupe ces aléas sous le nom de bruit de SGD.
Jonathan Frankle du MIT, Gintare Karolina Dziugaite d'Element AI, Daniel Roy de l'Université de Toronto et du Vector Institute, et Michael Carbin du MIT cherchent ce que ces aléas modifient réellement. Les deux entraînements donnent-ils deux approximations d'une même solution, ou aboutissent-ils à deux vallées distinctes ?
En 2018, Frankle et Carbin avaient formulé l'hypothèse du ticket de loterie : de petits réseaux contiennent des sous-réseaux très clairsemés qui, entraînés seuls depuis leur initialisation, retrouvent la précision du réseau complet. Ils n'en trouvaient toutefois pas à l'échelle d'ImageNet. La seconde moitié de cet article emploie le même outil pour expliquer cette difficulté.
Définir le problème
L'outil proposé s'appelle l'analyse d'instabilité.
Prenons un état d'un réseau : l'initialisation aléatoire , ou les poids après mises à jour. Dupliquons-le et poursuivons les deux entraînements avec des bruits de SGD différents jusqu'à obtenir et . Il reste à comparer ces deux jeux de poids.
La comparaison consiste à les mélanger linéairement :
désigne le taux d'erreur. La hauteur de la barrière d'erreur est le maximum sur le segment, moins la moyenne des erreurs aux extrémités :
Une barrière proche de 0 caractérise une connectivité linéaire des modes et un état stable face au bruit de SGD. Les auteurs fixent le seuil à 2 %, évaluent 30 valeurs de régulièrement espacées et moyennent neuf configurations : trois initialisations, avec trois ordres de données chacune.
Avec des erreurs de 8 % et 10 % aux extrémités et un maximum de 45 %, la barrière vaut points. Si le maximum vaut seulement 10 %, elle vaut 1 point et satisfait le seuil de stabilité. Cette définition tient compte des erreurs aux extrémités : il faut donc examiner leur qualité autant que la hauteur du milieu.
Les 30 positions constituent une approximation discrète. L'indicateur est l'erreur de classification, liée mais distincte de la barrière de perte en entropie croisée : deux modèles peuvent prédire la même classe avec des confiances différentes. Dans la suite, « stable » renvoie toujours à cette mesure et à ce seuil.
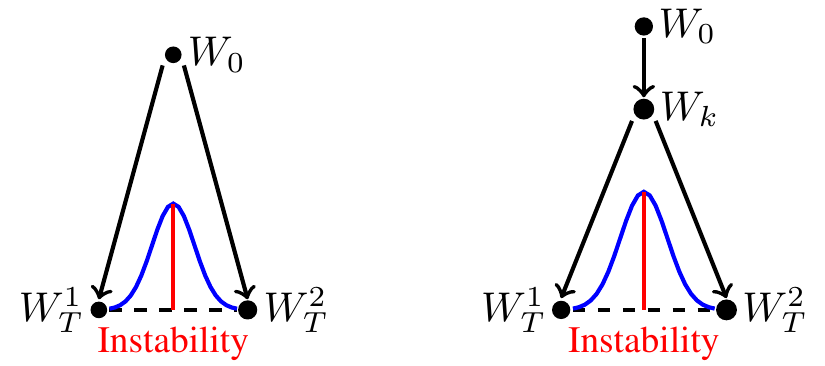
À gauche, les trajectoires divergent dès l'initialisation ; à droite, elles partagent d'abord étapes. Faire varier depuis 0 permet de repérer quand la trajectoire commence à se fixer.
Résoudre le problème
Diverger dès l'initialisation
Les auteurs étudient cinq réseaux : LeNet sur MNIST, ResNet-20 et VGG-16 sur CIFAR-10, ResNet-50 et Inception-v3 sur ImageNet. Pour CIFAR, ils ajoutent des variantes avec un taux plus faible ou une phase de chauffe.
Dupliqués dès , tous les réseaux sauf LeNet sont instables. L'interpolation entre les entraînements fait monter erreurs d'entraînement et de test jusqu'au niveau du hasard. LeNet présente aussi une hausse, mais inférieure à un point.
Avec la même initialisation et seulement un ordre de données et des augmentations différents, les entraînements aboutissent donc à des vallées sans connexion directe. Pour ces réseaux plus grands, partager les poids initiaux ne suffit pas.
Faire varier k
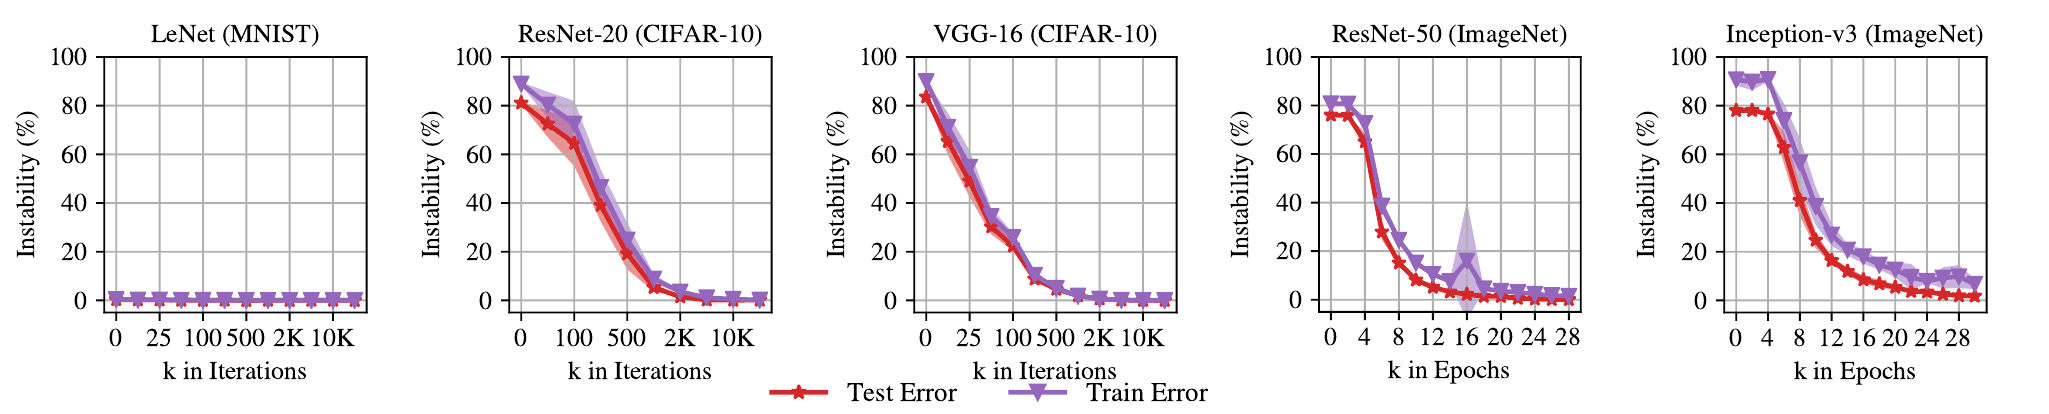
Chaque abscisse indique le nombre de mises à jour avant duplication ; l'ordonnée donne l'instabilité sur le test. Sauf pour LeNet, toutes les courbes partent de haut, descendent puis restent proches de 0.
Le franchissement du seuil arrive tôt. ResNet-20 se stabilise vers l'itération 2 000 et VGG-16 vers l'itération 1 000, soit 3 % et 1.5 % de leur entraînement. Sur ImageNet, il faut attendre l'époque 18 pour ResNet-50, soit 20 %, et l'époque 28 pour Inception-v3, soit 16 %.
Après ce point, les ordres de données et augmentations échantillonnés conduisent à des régions linéairement connectées. C'est une observation sur plusieurs entraînements ; le seuil dépend aussi de l'architecture, du calendrier et des données évaluées.
| Réseau complet | Durée totale | Début de l'instabilité de test inférieure à 2 % |
|---|---|---|
| LeNet / MNIST | 24 000 mises à jour | Dès l'initialisation |
| ResNet-20 / CIFAR-10 | 63 000 mises à jour | Vers la mise à jour 2 000, 3 % |
| VGG-16 / CIFAR-10 | 63 000 mises à jour | Vers la mise à jour 1 000, 1.5 % |
| ResNet-50 / ImageNet | 90 époques | Vers l'époque 18, 20 % |
| Inception-v3 / ImageNet | 171 époques | Vers l'époque 28, 16 % |
Synthèse de la Figure 3 et des réglages d'entraînement de l'article. Il s'agit des configurations standards, sans les variantes à faible taux ni avec warmup.
Une nuance compte sur ImageNet : la barrière de test peut être sous le seuil alors que celle d'entraînement reste plus élevée. ResNet-50 se stabilise plus tard sur l'entraînement ; Inception-v3 ne s'y stabilise même pas dans l'intervalle exploré. « Stable à l'époque 18 » doit donc rester associé à la mesure de l'erreur de test.
Moins de temps, ou une vraie stabilisation ?
Un facteur peut brouiller l'interprétation. Quand augmente, il reste moins d'étapes après la duplication : les trajectoires ont simplement moins de temps pour s'écarter. La baisse d'instabilité vient-elle seulement de là ?
Les auteurs ajoutent un contrôle où chaque copie effectue toujours étapes complètes, avec un calendrier redémarré depuis le début. Pour ResNet-20 et VGG-16, les courbes d'instabilité se superposent presque. La réduction du temps restant n'explique donc pas la stabilisation.
Ils vérifient aussi que l'apprentissage n'est pas déjà terminé au point de bifurcation. À la mise à jour 2 000, ResNet-20 a environ 25 % d'erreur de test, contre 8.3 % à la fin ; VGG-16 passe d'environ 20 % à l'itération 1 000 à 6.3 % finalement. Leurs paramètres restent également plus proches de l'initialisation que des poids finaux. Il reste beaucoup à apprendre : la stabilité décrit la région linéairement connectée où aboutira la suite de l'entraînement, tandis que la précision continue à progresser.
Discussion
Les succès et échecs des sous-réseaux clairsemés
La seconde moitié revient à l'hypothèse du ticket de loterie.
Ses preuves reposent sur l'élagage itératif par amplitude, ou IMP. On entraîne le réseau, supprime les poids de plus faible valeur absolue, remet les survivants à leur valeur initiale, puis recommence jusqu'à la parcimonie visée. Les deux réseaux ImageNet sont élagués en une seule fois pour limiter le calcul. Un sous-réseau qui retrouve la précision du réseau complet est dit « matching ».
Sur LeNet, IMP trouve des sous-réseaux matching. Ce n'est pas le cas avec les réglages standards de ResNet-20 et VGG-16, ni sur ImageNet. Pour ResNet-50 avec 30 % des poids conservés, le réseau complet atteint 76.1 %, contre seulement 73.7 % pour le sous-réseau IMP remis à l'initialisation, à peu près comme un élagage aléatoire.
L'analyse d'instabilité fait apparaître une correspondance nette : les sous-réseaux matching dès l'initialisation sont aussi stables dès l'initialisation ; les autres sont instables.
Puisque le réseau complet doit partager un début d'entraînement pour se stabiliser, pourquoi ne pas rembobiner les poids élagués à l'étape plutôt qu'à l'initialisation ? Les sous-réseaux auparavant non matching le deviennent en revenant à un point un peu plus tardif. Ce moment coïncide presque avec leur stabilisation. Les sous-réseaux IMP de ResNet-50 et d'Inception-v3 se stabilisent aux époques 5 et 6, bien avant les époques 18 et 28 des réseaux complets.
L'observation du ticket de loterie s'étend ainsi à ImageNet, avec des tickets situés au début de l'entraînement plutôt qu'à l'initialisation.
Quels poids rembobiner ?
Écrivons les opérations. On sauvegarde , les poids du réseau complet à l'étape , et on représente les paramètres conservés par un masque binaire . À chaque tour, on entraîne depuis jusqu'à la fin, puis on actualise selon les valeurs absolues des poids finaux : les 20 % les plus petits parmi les survivants sont supprimés. On revient ensuite au même . Après deux tours, il reste des poids ; on ne retire pas 20 % du réseau initial à chaque fois.
Le masque est construit après observation des poids finaux : ces expériences demandent donc plusieurs entraînements. Elles établissent l'existence de bons sous-réseaux dans les poids précoces. Pour économiser réellement du temps d'entraînement, il faut aussi traiter le coût de recherche du masque et vérifier que le matériel accélère les calculs clairsemés.
Les contrôles permettent de séparer le rôle des connexions de celui de leurs poids. L'un élague aléatoirement en conservant les proportions par couche d'IMP ; l'autre garde le masque IMP mais réinitialise aléatoirement les poids survivants. Aux parcimonies extrêmes choisies, la plupart de ces sous-réseaux aléatoires restent instables et moins précis, même avec un retour à une étape plus tardive.
Par exemple, ResNet-20 standard conserve 16.8 % de ses poids et son sous-réseau IMP se stabilise vers la mise à jour 500 ; VGG-16 en conserve 1.5 % et se stabilise vers la mise à jour 1 000. Les deux réseaux ImageNet conservent 30 %, avec les stabilisations aux époques 5 et 6 déjà citées. Un sous-réseau peut donc se stabiliser avant le réseau complet : nombre de paramètres et stabilité ne suivent pas une relation monotone simple.
Stable, mais encore trop petit
Les auteurs poussent ensuite la parcimonie sur CIFAR-10. IMP retrouve la précision du réseau complet lorsque ResNet-20 conserve environ 80.0 % à 13.4 % de ses poids, et VGG-16 environ 16.8 % à 1.2 %. Au-delà, aucun moment de rembobinage exploré ne permet de trouver un sous-réseau matching, même avec IMP.
Dans cette analyse à différentes parcimonies, matching tolère une baisse d'environ 0.2 point de précision. À l'extrême, la stabilisation s'accompagne toujours d'une baisse de l'erreur, mais la capacité ne suffit plus à rejoindre le réseau complet. La stabilité est donc fortement associée à la réussite de l'entraînement ; elle ne suffit pas, à elle seule, à assurer que tout sous-réseau atteindra la cible.
L'annexe compare aussi les extrémités par distance , distance cosinus, désaccord des prédictions et différences de perte par exemple. Pour les réseaux complets, la distance des paramètres décroît progressivement avec le moment de bifurcation, sans s'annuler soudainement à la stabilisation. Deux extrémités d'une même région peuvent rester éloignées. L'interpolation linéaire répond à une question supplémentaire : les paramètres sur tout le segment fonctionnent-ils aussi ? La seule distance entre les extrémités ne permet pas de le savoir.
Le lien avec la fusion de modèles
L'article ne porte pas sur la fusion, mais touche à sa condition la plus élémentaire : quand peut-on moyenner directement deux modèles ?
Ici, les copies utilisent les mêmes données et hyperparamètres, avec pour seule différence le bruit de SGD. Après un début d'entraînement commun, leur interpolation n'a plus de barrière, et leur moyenne évite la région de forte perte.
Le préentraînement suivi d'ajustements fins prolongera cette trajectoire commune et fournira un bon terrain d'étude à la fusion. Mais les données et objectifs des ajustements varient, ce qui dépasse les expériences de cet article où seul le bruit de SGD change. Il faut alors consulter les recherches ultérieures et mesurer les courbes d'interpolation.
Conclusion
Cet article transforme en mesure une question intuitive : deux entraînements arrivent-ils dans la même vallée ? Sauf pour le plus petit réseau, ils n'y arrivent pas en partant seulement d'une initialisation commune. Partager les premiers 1.5 % à 20 % de l'entraînement change le résultat.
Le même outil complète l'hypothèse du ticket de loterie : dans les configurations où les bons sous-réseaux étaient introuvables, revenir aux poids du début de l'entraînement permet de les retrouver.
Avant de moyenner directement les poids de deux modèles, demandez-vous à quel moment ils ont partagé leur trajectoire pour la dernière fois.