Article original
Editing Models with Task Arithmetic
- Publication
- ICLR 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2212.04089
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingtaskarithmetic2022,
  title = {{Editing Models with Task Arithmetic}},
  author = {Gabriel Ilharco and Marco Tulio Ribeiro and Mitchell Wortsman and Suchin Gururangan and Ludwig Schmidt and Hannaneh Hajishirzi and Ali Farhadi},
  year = {2022},
  eprint = {2212.04089},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2212.04089}
}
Un modèle préentraîné demande souvent quelques modifications : améliorer une tâche, réduire les propos toxiques ou suivre de nouvelles données. L'article appelle cela l'édition de modèle.
La méthode courante est l'ajustement fin. Chaque ajustement donne un modèle supplémentaire ; pour réunir deux capacités, on rassemble souvent les données dans un entraînement multitâche. Ajouter une capacité demande alors de revoir les données et l'entraînement.
Ilharco, Ribeiro, Wortsman et leurs collègues de l'Université de Washington, de Microsoft Research et d'AI2 viennent de travailler sur les mélanges linéaires de poids dans WiSE-FT et Model Soups. Ils isolent cette fois ce que l'ajustement a changé, pour le manipuler comme un vecteur.
Définir le problème
Avec les poids préentraînés et les poids ajustés sur la tâche , le vecteur de tâche est :
Aussi grand que le modèle, il consigne pour chaque poids la direction et l'ampleur du changement lié à .
On peut l'ajouter à des poids avec un coefficient :
Pour et , on retrouve exactement le modèle ajusté. est choisi sur des données de validation réservées.
La soustraction poids par poids exige la même architecture et aucun nouveau paramètre pendant l'ajustement. Les auteurs choisissent donc des modèles ouverts : des classificateurs visuels à vocabulaire ouvert comme CLIP, dont la tête peut être construite en encodant les noms des classes, et des modèles de langage text-to-text comme T5 et GPT-2.
Peut-on additionner et soustraire ces vecteurs comme des nombres, avec un effet correspondant sur le comportement ?
Résoudre le problème
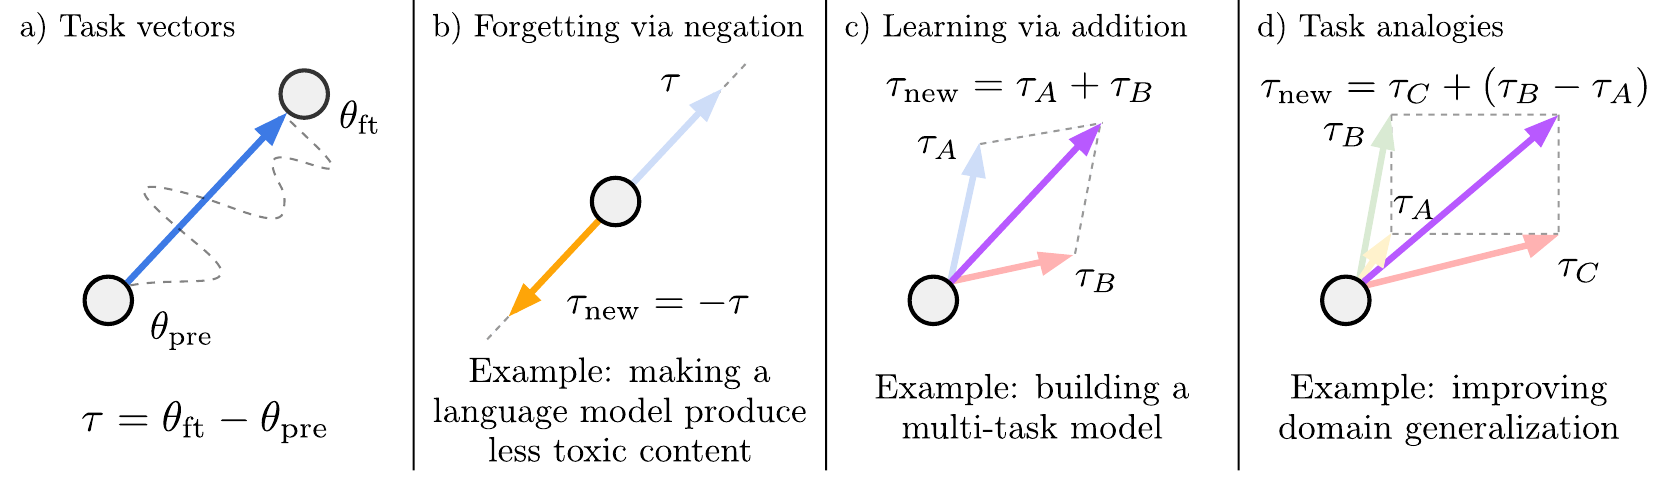
Trois opérations sont étudiées, toujours poids par poids :
- Négation, ou oubli : . Partir du préentraînement à l'opposé de l'ajustement dégrade la tâche visée, en préservant autant que possible les autres.
- Addition, ou apprentissage : . Plusieurs vecteurs produisent un modèle qui traite leurs tâches ensemble.
- Analogie : si A est à B ce que C est à D, utiliser pour améliorer D, même avec très peu de données D.
Dans les trois cas, . L'édition est une opération vectorielle ; mémoire et calcul d'inférence restent ceux du modèle initial.
Addition de tâches et moyenne de deux modèles ajustés se confondent facilement. Avec et :
La moyenne directe correspond à ; conserve intégralement les deux changements. Depuis une base , des ajustements et donnent une moyenne , contre pour l'addition. Dans un grand réseau, un facteur deux peut changer le résultat : le coefficient appartient à la méthode.
L'analogie devient plus concrète avec l'exemple Yelp/Amazon. Pour classer le sentiment sur Yelp, on dispose d'étiquettes Amazon mais seulement de textes non étiquetés Yelp :
vient de la classification de sentiment Amazon. Les deux vecteurs entre parenthèses proviennent de l'apprentissage du langage sur les textes Yelp et Amazon, sans étiquettes. Leur différence estime la direction du changement de domaine d'Amazon vers Yelp.
Discussion
Négation : oublier une tâche
En vision, les huit tâches CLIP sont Cars, modèles de voitures, DTD, textures, EuroSAT et RESISC45, images satellites, GTSRB, panneaux routiers, MNIST, chiffres manuscrits, SUN397, scènes, et SVHN, numéros de rue. ImageNet sert de contrôle pour les autres capacités.
Sur ViT-L/14, soustraire le vecteur fait passer la précision moyenne des huit cibles de 64.8 % à 19.0 %, soit 45.8 points en moins. ImageNet passe de 75.5 % à 72.9 %, un coût de 2.6 points. Une ascension de gradient sur la cible la dégrade aussi, mais fait tomber ImageNet à 16.3 %. Un vecteur aléatoire de même norme agit peu sur la cible.
En génération textuelle, les auteurs ajustent GPT-2 Large sur les commentaires Civil Comments dont le score de toxicité dépasse 0.8, puis soustraient ce vecteur de toxicité. La proportion de textes jugés toxiques passe de 4.8 % à 0.8 %, et la perplexité WikiText-103 de 16.4 à 16.9. L'ascension de gradient réduit aussi la toxicité, mais rend la perplexité inutilisable.
L'expérience produit 1 000 textes à partir de préfixes controversés fixes et les note avec Detoxify. est le maximum qui dégrade la perplexité d'au plus 0.5. Un ajustement direct sur des commentaires non toxiques donne 1.8 % de toxicité et 17.2 de perplexité : le vecteur opposé offre ici un meilleur compromis. L'annexe change aussi les prompts, utilise RealToxicityPrompts et plusieurs tailles de GPT-2 ; les prompts difficiles laissent encore de la marge.
L'oubli désigne ici une dégradation comportementale mesurée sur des tâches et prompts précis. Pour supprimer un exemple d'entraînement ou garantir l'impossibilité d'extraire une information, il faudrait une validation que cet article ne fournit pas.
Addition : plusieurs tâches dans un modèle
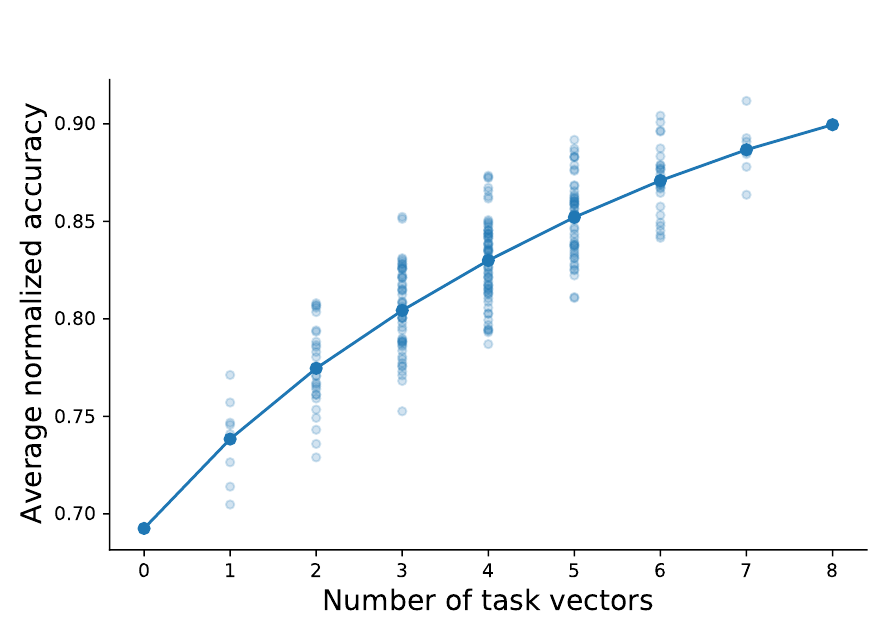
Les difficultés diffèrent : la précision normalisée divise, pour chaque tâche, le résultat fusionné par celui de l'expert ajusté seul. Une valeur de 100 % signifie égaler chaque expert.
Pour une addition par paire, la moyenne sur les deux tâches conserve 98.9 % de la précision des experts. La figure emploie une autre agrégation : chaque point est un sous-ensemble de vecteurs, mais le score porte toujours sur les huit tâches. Les auteurs explorent sous-ensembles. Sans vecteur, le modèle préentraîné zéro-shot vaut environ 69 % ; couvrir davantage de tâches relève la moyenne globale. Avec les huit vecteurs disponibles, le meilleur modèle multitâche trouvé atteint 91.2 % de précision normalisée.
Un seul modèle traite les huit tâches avec moins d'un dixième d'écart par rapport aux experts. Il reste donc une perte de fusion, plus difficile à éviter quand le nombre de tâches augmente.
La normalisation se fait avant la moyenne. Si les experts valent 80 % et 100 %, contre 72 % et 95 % après fusion, la rétention vaut , tandis que la précision brute moyenne vaut 83.5 %. Les 91.2 % de l'article mesurent la rétention des experts.
Le coefficient commun est choisi de 0 à 1 par pas de 0.05 sur la validation, ce qui évite l'explosion combinatoire de coefficients par tâche. L'annexe trouve souvent une bonne zone entre 0.3 et 0.5, mais l'optimum varie entre sous-ensembles. Même avec davantage de vecteurs disponibles, les inclure tous peut être moins bon.
Un concurrent fort mérite aussi sa place : l'ajustement multitâche sur toutes les données atteint 99.4 %, contre 91.2 % pour la meilleure arithmétique. Cette dernière apporte modularité, absence de nouvel accès aux données d'entraînement et fusion sans entraînement. Si l'on peut réunir les données et réentraîner, le multitâche reste une comparaison prioritaire.
En langage, les auteurs ajustent T5-base sur quatre tâches GLUE, puis cherchent parmi 427 modèles publics compatibles sur Hugging Face. Leurs vecteurs sont ajoutés un par un au modèle cible ; la validation sert à choisir le candidat et le coefficient. Le vecteur d'une autre tâche améliore parfois l'ajustement seul.
La moyenne des quatre tâches passe de 78.1 à 78.6, MRPC de 88.5 à 89.3, avec environ 0.2 à 0.7 de gain ailleurs. Le résultat repose sur une recherche parmi de nombreux candidats. L'annexe fusionne aussi des paires de six checkpoints T5 publics pour questions-réponses, résumé, sentiment et génération, avec accuracy, exact match ou ROUGE-2 selon la tâche. Un seul chiffre de précision ne peut résumer ces mesures.
Analogie : apprendre sans étiquettes cibles
L'analogie Yelp/Amazon dépasse l'ajustement sur les seules étiquettes de sentiment Amazon pour plusieurs tailles de T5, et approche l'ajustement direct sur la cible. Le vecteur de sentiment demande un poids plus élevé : les auteurs utilisent donc deux coefficients indépendants.
Avec Amazon comme cible et T5-base, l'ajustement sur les étiquettes Yelp donne 90.8 %, l'analogie 92.7 % et l'ajustement sur les étiquettes Amazon 93.2 %. Les deux vecteurs de langage exigent des textes non étiquetés des domaines cible et auxiliaire. L'absence d'étiquettes cibles conserve donc un accès aux textes cibles : ceux-ci estiment le déplacement de domaine auquel on associe la direction de sentiment déjà apprise.
En vision, 125 classes communes à ImageNet et à des dessins sont divisées en quatre groupes : photo ou dessin, croisés avec deux ensembles de classes. Pour améliorer les « lions dessinés », on utilise :
Le gain moyen est de 3.4 points sur le modèle préentraîné, comparable à l'ajout d'environ cent exemples étiquetés pour le groupe cible.
Pourquoi l'addition fonctionne-t-elle ?
Sur neuf tâches CLIP, les vecteurs ont pour la plupart des similarités cosinus entre 0.01 et 0.03 : ils sont presque orthogonaux. Les valeurs supérieures relient des tâches proches : MNIST/SVHN, reconnaissance de chiffres, vaut 0.18 ; GTSRB, qui contient aussi des chiffres, vaut 0.06 avec ces deux tâches ; les images satellites EuroSAT/RESISC45 valent 0.05.
Les auteurs supposent que cette quasi-orthogonalité réduit l'interférence. C'est une interprétation des observations. Ortiz-Jimenez et al. analyseront ensuite le découplage des poids, acquis par le préentraînement et absent depuis une initialisation aléatoire.
Deux observations servent aussi à la pratique. Avec un taux d'apprentissage plus élevé, l'addition se dégrade plus vite que l'ajustement individuel : les auteurs conseillent des taux prudents. Ensuite, la direction du vecteur se stabilise tôt ; quelques centaines d'étapes et un vecteur intermédiaire suffisent déjà à presque saturer la précision d'addition.
Limites
Les vecteurs exigent une architecture commune et toutes les expériences partent des mêmes poids préentraînés.
Ce cadre laisse néanmoins beaucoup de candidats : à l'époque, Hugging Face héberge plus de trois mille ajustements d'un même BERT-base et plus de huit cents d'un même T5-small.
Conclusion
L'arithmétique des tâches représente l'ajustement par un vecteur, puis montre que son addition, sa soustraction et ses analogies ont des effets globalement correspondants sur le comportement.
L'entraînement reste un ajustement ordinaire ; c'est la manière d'utiliser son résultat qui change. TIES-Merging et DARE repartiront de ce cadre pour traiter l'interférence entre vecteurs.
La prochaine fois que vous trouvez sur Hugging Face un ajustement d'une base familière, soustrayez donc la base pour regarder ce vecteur de plus près.