Article original
REPAIR: REnormalizing Permuted Activations for Interpolation Repair
- Publication
- ICLR 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2211.08403
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingrepair2022,
  title = {{REPAIR: REnormalizing Permuted Activations for Interpolation Repair}},
  author = {Keller Jordan and Hanie Sedghi and Olga Saukh and Rahim Entezari and Behnam Neyshabur},
  year = {2022},
  eprint = {2211.08403},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2211.08403}
}
Fin 2022, deux résultats contradictoires coexistent dans la littérature sur la possibilité de moyenner directement deux réseaux après alignement par permutation.
D'un côté, Singh et Jaggi alignent en 2020 les neurones par transport optimal (optimal transport). Deux ResNet18 qui dépassent 93 % de précision sur CIFAR-10, une fois alignés puis interpolés linéairement, donnent au mieux 77 % au milieu, soit encore 16 points de moins.
De l'autre, Git Re-Basin, en septembre 2022. Sur des ResNet élargis, il obtient une barrière presque nulle entre deux modèles entraînés indépendamment sur CIFAR-10 ; l'une des méthodes d'alignement qu'il compare, « l'appariement des activations », est précisément un cas particulier couvert par la méthode de Singh et Jaggi.
Comment ces deux résultats peuvent-ils être vrais en même temps ?
Cet article, écrit par Keller Jordan, de Hive AI, avec Sedghi, Saukh, Entezari et Neyshabur, de Google et de TU Graz, apporte la réponse. Ces quatre derniers sont précisément les auteurs de la conjecture d'invariance par permutation.
Définir le problème
L'état des lieux d'Entezari et al., dans la note précédente, montrait déjà que la barrière après alignement baisse avec la largeur, mais monte brutalement avec la profondeur. Pour un MLP ou un CNN de plus de quelques couches, l'alignement ne suffit plus à la faire disparaître.
Les auteurs veulent savoir ce que la profondeur abîme au juste.
Au lieu de continuer à améliorer l'algorithme d'alignement, ils ouvrent directement le réseau interpolé pour examiner les activations de chaque couche. La mesure est simple. Pour une couche, on calcule la variance d'activation de chaque neurone sur un lot de données d'entraînement, puis on les somme en . On compare le du modèle interpolé aux et des deux modèles d'extrémité :
Un rapport proche de 1 indique que les activations du modèle interpolé sont aussi actives que celles des extrémités ; proche de 0, que la sortie de la couche ne varie presque plus avec l'entrée.
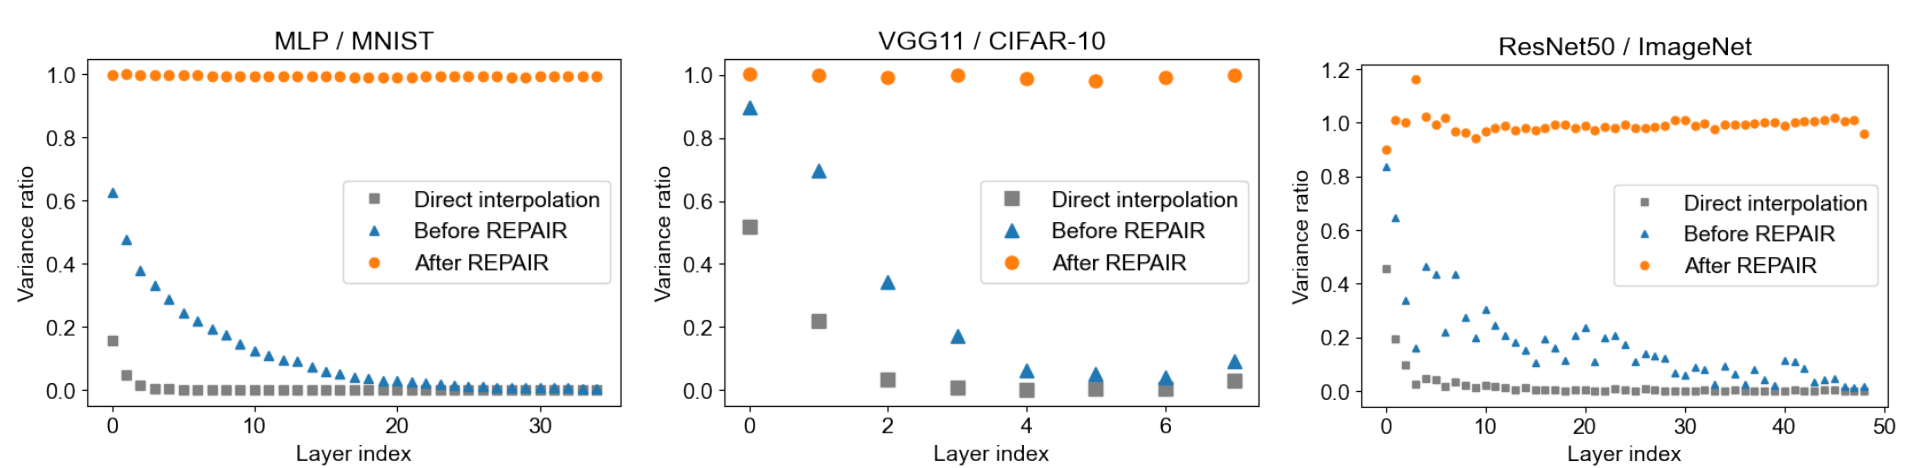
Regardons d'abord les triangles bleus, qui représentent le modèle interpolé après alignement, encore non corrigé. Le rapport de variance de la première couche du MLP vaut environ 0.6, puis baisse couche après couche, jusqu'à être presque nul dans les dernières des 35 couches. Même chose pour VGG11 et ResNet50, dont la variance est divisée par plus de dix dans les dernières couches.
Les auteurs nomment ce phénomène effondrement de la variance (variance collapse). Dans les dernières couches, les activations sont presque constantes ; le réseau ne distingue plus les entrées, et la précision ne peut évidemment pas être bonne.
Les carrés gris, interpolation directe sans alignement, s'effondrent encore plus vite.
Résoudre le problème
Pourquoi la variance rétrécit
Commençons par la première couche du réseau interpolé. Son entrée, ce sont les données brutes ; la préactivation interpolée d'un neurone (la valeur avant ReLU) est donc exactement une combinaison linéaire des neurones correspondants aux deux extrémités :
Considérons et comme des variables aléatoires qui varient avec les données. Au milieu, ,
Le premier terme est la variance attendue, soit le carré de la moyenne des écarts-types aux extrémités ; le second est la part retranchée, toujours présente dès que le coefficient de corrélation des deux neurones est inférieur à 1.
Si les écarts-types aux deux extrémités sont à peu près égaux, l'expression se simplifie en
Si bon que soit l'alignement, deux réseaux entraînés indépendamment n'apprennent jamais des neurones strictement identiques. Les auteurs observent que les neurones appariés après alignement ont généralement un coefficient de corrélation d'environ 0.4 seulement. En substituant,
la variance de la première couche perd 30 %.
Pour les couches plus profondes, un calcul aussi précis est impossible, car leur entrée est déjà l'activation rétrécie de la couche précédente. L'intuition des auteurs est que cette diminution s'accumule de couche en couche. Si l'on suppose grossièrement qu'il ne reste que 70 % à chaque couche, il ne reste plus que après 10 couches.
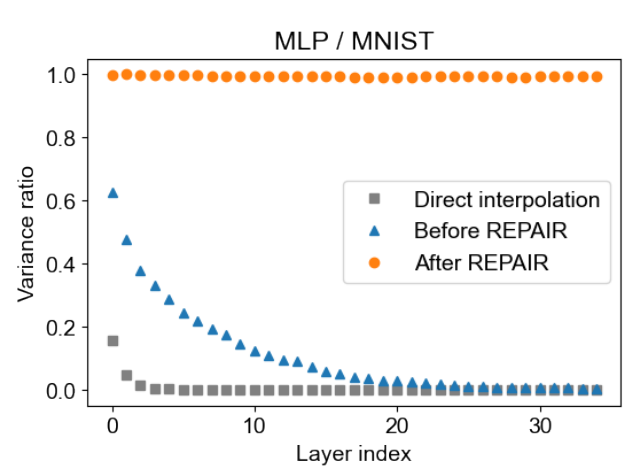
Comparons cette estimation grossière aux mesures sur le MLP. Les triangles bleus partent d'environ 0.62 à la couche 0, valent encore environ 0.12 à la couche 10, et ne descendent vers 0.03 qu'autour de la couche 20. La décroissance réelle est plus lente que 70 % par couche, mais la forme, une chute couche après couche, est la même.
Ce que REPAIR doit obtenir
Puisque le problème vient des statistiques, on remet les statistiques en état. Pour chaque canal à corriger, REPAIR impose deux conditions au modèle interpolé :
L'interpolation de la moyenne est vérifiée d'elle-même ; c'est la seconde condition qui est réellement violée. Avant correction, on a généralement .
Quant aux canaux à corriger, les auteurs retiennent pour VGG la sortie de chaque couche de convolution ; pour ResNet, il faut ajouter aux sorties des convolutions celles de chaque bloc résiduel.
Version approchée : un facteur d'échelle
Si l'on ne considère que la première couche, le facteur de correction se calcule directement. Une fois , et mesurés sur les modèles d'extrémité, la variance du neurone interpolé vaut
Le facteur d'échelle nécessaire est « l'écart-type cible divisé par l'écart-type réel » :
Avec les chiffres précédents, et des écarts-types égaux aux extrémités, : il suffit d'amplifier de 20 % la sortie de chaque neurone.
Ce facteur est exact pour la première couche, approché pour les couches plus profondes. Les auteurs le testent sur des MLP de 2 à 50 couches entraînés sur MNIST. Sans correction, le modèle du milieu passe sous 90 % au-delà de 6 couches ; avec cette correction approchée, il reste au-dessus de 90 % jusqu'à 27 couches.
L'avantage de la version approchée est qu'elle ne demande que des passes avant sur les modèles d'extrémité ; une fois les statistiques calculées, le facteur de correction s'obtient directement pour tout .
Version exacte : mesurer avec BatchNorm
La version approchée ne suffit pas dans les cas difficiles comme ResNet50 sur ImageNet. Les auteurs proposent donc une version exacte, qui effectue les passes avant directement sur le modèle interpolé.
Il s'agit d'ajouter temporairement une couche BatchNorm après chaque module à corriger :
from torch import nn

class RepairWrap(nn.Module):
    def __init__(self, module, channels):
        super().__init__()
        self.module = module
        self.bn = nn.BatchNorm2d(channels)      # couche ajoutée, d'abord en mode train

    def set_goal(self, goal_mean, goal_std):
        self.bn.bias.data = goal_mean            # (1-α)·E[X1] + α·E[X2]
        self.bn.weight.data = goal_std           # (1-α)·std(X1) + α·std(X2)

    def forward(self, x):
        return self.bn(self.module(x))
En mode entraînement, BatchNorm normalise d'abord l'entrée à moyenne 0 et variance 1, puis la multiplie par weight et ajoute bias. En réglant ces deux paramètres sur l'écart-type et la moyenne cibles, on obtient en sortie exactement les statistiques exigées par les conditions.
On fait ensuite passer environ 5 000 exemples d'entraînement dans le réseau, pour que les BatchNorm ajoutées estiment leur running mean et leur running variance ; toutes les BatchNorm d'origine du réseau sont gelées. L'estimation terminée, on passe en mode évaluation : la couche ajoutée devient une mise à l'échelle et une translation fixes, qui peuvent finalement être fusionnées dans les poids de la convolution précédente. L'architecture du modèle reste identique à l'original.
Le parallèle est intéressant. Si le réseau a déjà une BatchNorm après chaque convolution, corriger seulement les sorties des convolutions revient mathématiquement à réestimer les statistiques de BatchNorm. SWA traitait déjà ainsi les modèles moyennés en 2018, mais personne ne l'avait appliqué entre deux réseaux entraînés indépendamment. REPAIR étend cette pratique aux sorties des blocs résiduels et aux réseaux sans BatchNorm.
REPAIR est complémentaire de l'algorithme d'alignement. Dans cet article, les auteurs utilisent partout l'appariement par corrélation des activations de Li et al. (2015), résolu par l'algorithme hongrois ; dans les réseaux à connexions résiduelles, toutes les couches d'un même flux résiduel doivent recevoir la même permutation.
Discussion
ResNet18 sur CIFAR-10
Deux ResNet18 alignés atteignent 95.5 % aux extrémités sur l'ensemble de test de CIFAR-10. L'interpolation directe ne donne que 66.0 % au milieu ; après REPAIR, le milieu monte à 94.1 %, et la barrière n'est plus que de 1.5 point. En comparaison, l'alignement par transport optimal de Singh et Jaggi donne 77.0 % au milieu.
Les couches de normalisation résolvent la contradiction
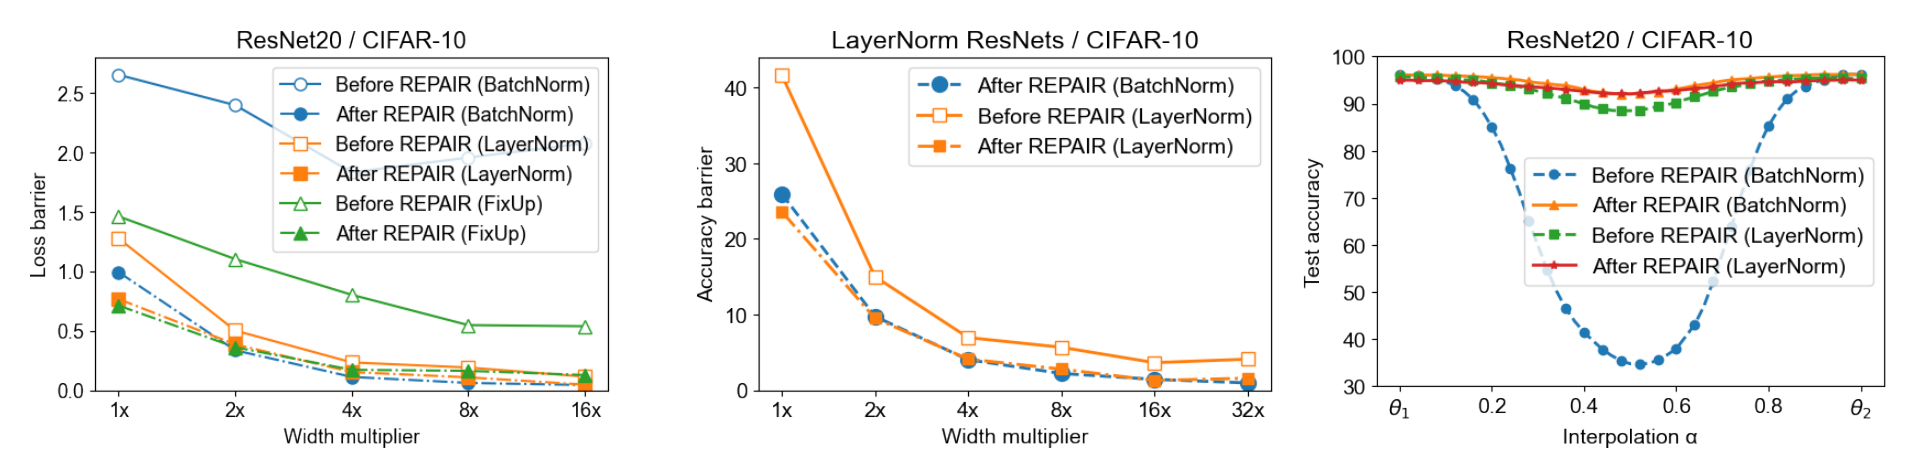
Les auteurs entraînent ResNet20 sur CIFAR-10 avec trois normalisations, BatchNorm, LayerNorm et Fixup sans normalisation, pour des facteurs de largeur de 1× à 16× (de 64 à 1 024 canaux dans le dernier bloc).
La figure de droite est la plus convaincante. Avec la largeur standard, la version BatchNorm tombe à 34.7 % au milieu avant correction ; la version LayerNorm est déjà à 88.4 %. Après correction, les deux atteignent 92.0 %.
Même chose à la largeur 8×. Au milieu, LayerNorm a déjà 90.3 % avant correction et 93.2 % après ; BatchNorm n'a que 32.3 % avant correction, puis 94.4 % après. La figure de gauche montre qu'à la largeur 16×, les barrières de perte de BatchNorm et de LayerNorm après correction sont toutes deux inférieures à 0.05.
Pourquoi LayerNorm fait-il exception ? Selon les auteurs, LayerNorm renormalise aussi à l'inférence selon l'entrée courante ; la variance rétrécie de chaque couche est ramenée à son niveau et ne s'accumule pas. À l'inférence, BatchNorm n'est qu'une transformation affine fixe, et le rétrécissement s'empile couche après couche.
Voilà la réponse à la contradiction du début. En examinant le code de Git Re-Basin, les auteurs découvrent que ses ResNet remplacent BatchNorm par LayerNorm. Singh et Jaggi utilisaient un ResNet18 standard avec BatchNorm ; aussi bon que soit l'alignement, l'effondrement de la variance finit par tout ruiner.
LayerNorm a aussi un coût. Avec les mêmes réglages d'entraînement, le ResNet20 LayerNorm atteint 92.4 % sur CIFAR-10, contre 93.6 % pour la version BatchNorm.
ImageNet
Sur ImageNet, l'interpolation directe après alignement donne moins de 1 % de précision au milieu pour ResNet18, ResNet50 et un ResNet50 deux fois plus large. Après REPAIR, on obtient respectivement 41.1 %, 56.5 % et 64.2 %.
Corriger ou non les sorties des blocs résiduels fait une différence notable. Pour ResNet50, corriger seulement les sorties des convolutions donne 53.2 % au milieu ; y ajouter les sorties des blocs résiduels donne 56.5 %, et la barrière passe de 23.4 à 20.1 points.
Cela reste une barrière considérable. Le ResNet50 standard garde 20.1 points après correction, la version deux fois plus large 12.9. Les auteurs supposent que les jeux de données difficiles exigent des réseaux plus larges pour que la barrière devienne très basse.
Largeur et profondeur
Pour des MLP à 10 couches (largeur de 32 à 2 048) et des ResNet20 (largeur de 1× à 16×), sur MNIST, FashionMNIST, SVHN et CIFAR-10, REPAIR réduit la barrière dans tous les cas, d'autant plus que le réseau est large ; sur MNIST, même les réseaux assez étroits approchent de zéro.
Pour la profondeur, sur CIFAR-10 avec des VGG de 11 à 19 couches, la barrière avant correction augmente avec la profondeur ; après correction, elle n'en dépend presque plus. La « profondeur qui élève la barrière » observée dans l'état des lieux d'Entezari et al. vient au moins en partie de l'effondrement de la variance.
Fusionner des modèles entraînés sur des données différentes
La dernière expérience reprend le cadre de Git Re-Basin. Les 50 000 images d'entraînement de CIFAR-100 sont réparties en deux parts de 25 000 ; le premier prend 80 % des images des 50 premières classes et 20 % des 50 dernières, le second l'inverse. Chaque réseau est ainsi meilleur sur une moitié des classes.
Après alignement et correction par REPAIR, de nombreux modèles du chemin d'interpolation ont une perte sur le test complet inférieure à celle des deux extrémités. Le meilleur apparaît à , avec une perte de test de 1.30 ; la meilleure valeur rapportée par Git Re-Basin est 1.73, également vers . Les auteurs admettent franchement que cet écart vient en partie de REPAIR, et en partie de ce que le ResNet standard est de toute façon plus fort que la version LayerNorm.
Est-ce encore une permutation ?
Dans la discussion, les auteurs soulèvent une question honnête. En obtenant une faible barrière dans davantage de cas, REPAIR semble soutenir la conjecture d'Entezari ; mais il remet à l'échelle les préactivations du modèle interpolé, ce qui n'est plus, à strictement parler, une « interpolation linéaire après permutation ».
Autrement dit, aux largeurs réellement utilisables et sans passer à LayerNorm, la permutation seule ne semble pas suffire ; il faut aussi ce genre de correction des statistiques. La conjecture elle-même n'est toujours pas démontrée.
En pratique, n'oublions pas que REPAIR a besoin de données d'entraînement. Les statistiques des modèles d'extrémité se mesurent sur des données d'entraînement, et la version exacte doit encore faire passer quelques milliers d'exemples dans le modèle interpolé. Avec seulement les poids et aucune donnée, cette étape est impossible.
Conclusion
Cet article remonte un phénomène qui ressemblait à un problème d'alignement jusqu'aux statistiques internes du réseau interpolé. Dès que deux neurones ne sont pas parfaitement corrélés, la variance de leur moyenne rétrécit ; dans un réseau BatchNorm, ce rétrécissement s'empile couche après couche, jusqu'à ce que le réseau entier ne réagisse plus à son entrée.
La correction consiste simplement à ramener la moyenne et l'écart-type de chaque canal à l'interpolation entre les deux extrémités. La barrière de ResNet18 sur CIFAR-10 descend des 16 points laissés par l'alignement par transport optimal de Singh et Jaggi à 1.5, et ResNet50 sur ImageNet remonte de moins de 1 % à 56.5 %.
Si vous moyennez des poids au quotidien, pensez à réestimer les statistiques de BatchNorm après la moyenne. Le code officiel est sur KellerJordan/REPAIR ; la correction ne demande qu'une passe avant sur quelques milliers d'exemples d'entraînement.
SWA le faisait déjà en 2018 ; seulement, les modèles qu'il moyennait venaient tous d'une même trajectoire d'entraînement.