Article original
Robust fine-tuning of zero-shot models
- Publication
- CVPR 2022Conférence
- Premier dépôt sur arXiv
- arXiv:2109.01903
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingwiseft2021,
  title = {{Robust fine-tuning of zero-shot models}},
  author = {Mitchell Wortsman and Gabriel Ilharco and Jong Wook Kim and Mike Li and Simon Kornblith and Rebecca Roelofs and Raphael Gontijo-Lopes and Hannaneh Hajishirzi and Ali Farhadi and Hongseok Namkoong and Ludwig Schmidt},
  year = {2021},
  eprint = {2109.01903},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2109.01903}
}
À sa sortie, CLIP surprenait notamment par sa robustesse.
Sans ajustement sur les étiquettes d'ImageNet, il pouvait déjà classer les images en zéro-shot : les représentations apprises sur des paires image-texte permettaient d'utiliser les vecteurs de « a photo of a {classe} » comme classificateur. Sur les variantes d'ImageNet, comme les nouvelles photos d'ImageNetV2, les dessins d'ImageNet-Sketch ou les représentations artistiques d'ImageNet-R, sa précision baissait bien moins que celle des modèles ImageNet ordinaires.
Cette robustesse disparaissait avec l'ajustement fin. Les expériences de l'article CLIP et de BASIC montraient qu'un ajustement sur ImageNet améliorait nettement ImageNet, tout en faisant descendre plusieurs résultats sous décalage de distribution en dessous du modèle zéro-shot.
Wortsman, Ilharco et leurs collègues de l'Université de Washington, d'OpenAI, de Columbia, de Google et d'AI2 veulent conserver les deux avantages.
Définir le problème
L'article introduit d'abord la robustesse effective.
Plaçons des modèles ImageNet ordinaires dans un nuage de points : précision ImageNet en abscisse, précision moyenne sous décalage de distribution en ordonnée. Après transformation logit des axes, les points suivent approximativement une droite. La robustesse effective est l'écart au-dessus de cette tendance :
est la tendance des modèles ordinaires. CLIP zéro-shot suit une droite plus haute et possède une forte robustesse effective. Après ajustement, le point va vers la droite, car ImageNet progresse, mais redescend vers la droite ordinaire.
Les auteurs observent deux autres difficultés. De petites variations d'hyperparamètres produisent de grands écarts sous décalage : deux modèles entraînés à des taux d'apprentissage différents peuvent ne différer que de 0.3 point sur ImageNet, mais de 8 points sur les distributions décalées, sans que le résultat ImageNet permette de choisir. Ensuite, un ajustement plus agressif, par exemple avec un taux plus élevé, améliore davantage ImageNet mais dégrade davantage la robustesse.
Résoudre le problème
Deux étapes
WiSE-FT, pour weight-space ensembles for fine-tuning, comporte deux étapes :
- Ajuster normalement le modèle zéro-shot.
- Mélanger linéairement les poids zéro-shot et les poids ajustés :
donne le modèle zéro-shot, le modèle ajusté. Les valeurs intermédiaires ne demandent aucun nouvel entraînement et produisent un seul modèle, au même coût d'inférence.
Que faire de la tête de classification ?
Chaque poids doit avoir son correspondant. Le classificateur zéro-shot de CLIP est une couche linéaire : chaque colonne contient le vecteur textuel d'une classe décrite par « a photo of a {classe} ». La sortie est le produit scalaire entre les caractéristiques de l'image et chaque colonne.
Pour l'ajustement de bout en bout, les auteurs initialisent la dernière couche avec ce classificateur zéro-shot, puis l'entraînent avec l'encodeur d'images. Structure, formes des paramètres et point de départ sont identiques, ce qui permet une interpolation poids par poids.
La tête comprend aussi le facteur de température appris par CLIP. Les vecteurs de classes sont moyennés sur plusieurs formulations : ImageNet utilise les 80 modèles de prompt des auteurs de CLIP. La fusion doit conserver l'ordre des classes, la normalisation des caractéristiques et l'échelle. Deux matrices de taille ne suffisent pas : leur colonne doit encore désigner la même classe.
Développons le cas LC, avec une représentation d'image fixe :
Le membre de droite est la moyenne pondérée des logits. Si les scores de deux classes sont et , donne . Moyenner d'abord les têtes produit les mêmes scores. Appliquer séparément softmax puis moyenner les probabilités est une autre opération.
L'ajustement de bout en bout modifie : cette distributivité ne permet plus de décomposer le réseau entier en deux sorties. L'article mesure donc séparément moyenne des poids et ensemble des sorties. Les deux améliorent la robustesse ; dans la comparaison de bout en bout, la moyenne des poids est plus favorable et exécute un seul encodeur, contre deux encodages d'image pour l'ensemble. En LC, les caractéristiques fixes peuvent être partagées ; la différence porte surtout sur les têtes.
Discussion
Une courbe dans le nuage de points
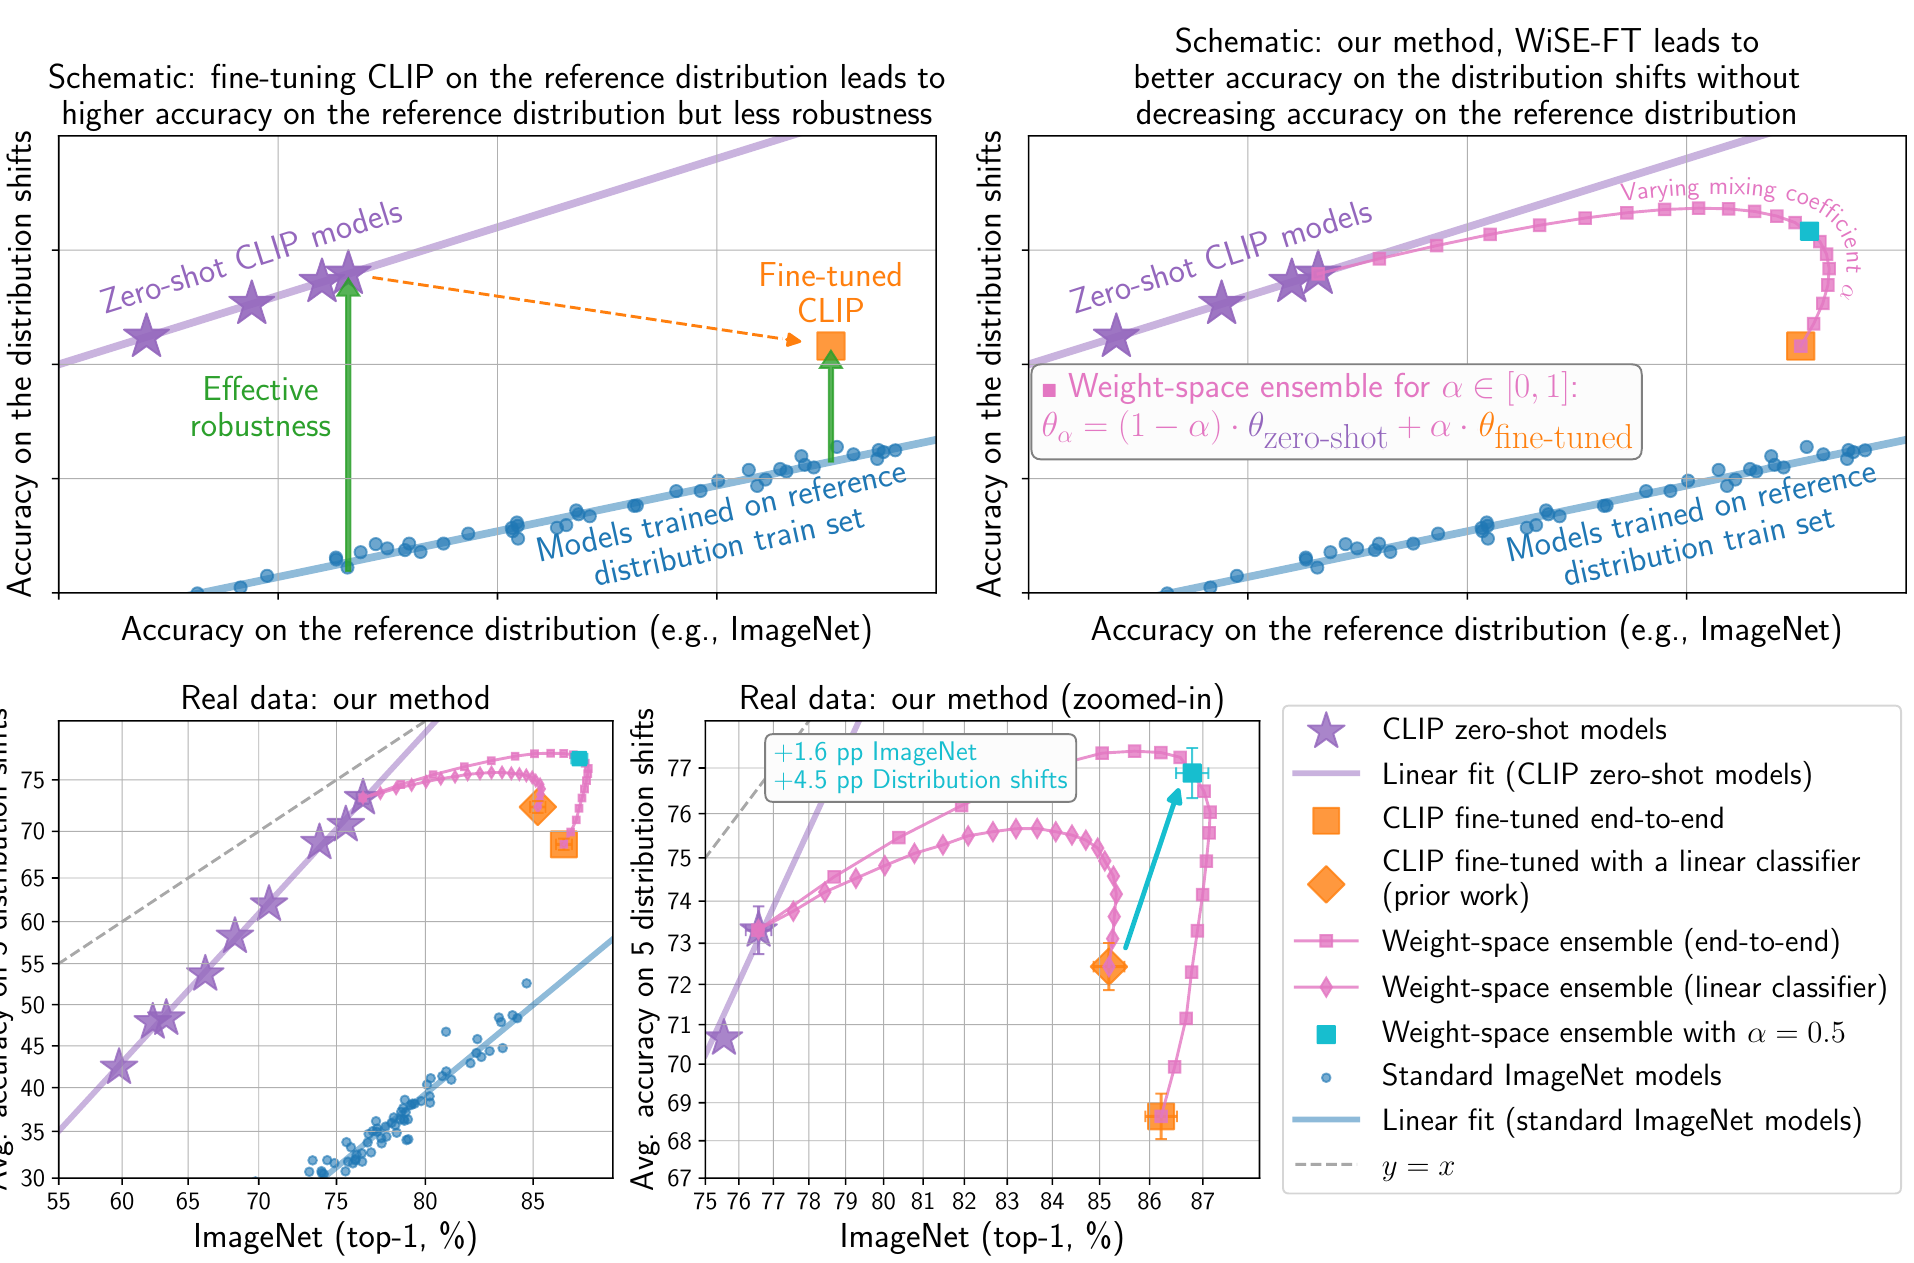
En haut, les schémas résument le principe. À gauche, CLIP zéro-shot, l'étoile violette, dépasse la tendance ordinaire : la flèche verte mesure sa robustesse effective. Le carré orange ajusté se déplace à droite mais descend. À droite, quand passe de 0 à 1, WiSE-FT forme une courbe rose bombée dont une portion dépasse les deux extrémités sur les deux axes.
En bas figurent les mesures de ViT-L/14@336px. Dans le zoom inférieur droit, les carrés roses des mélanges de bout en bout partent de l'étoile zéro-shot, montent à droite, puis rejoignent le carré orange du modèle ajusté.
Les chiffres
Voici le principal modèle CLIP ViT-L/14@336px, sur ImageNet et cinq distributions dérivées :
| Modèle | ImageNet | Moyenne sur cinq distributions décalées |
|---|---|---|
| Zéro-shot, reproduction PyTorch | 76.6 | 73.4 |
| Classificateur linéaire ajusté | 85.2 | 72.6 |
| Ajustement de bout en bout | 86.2 | 68.6 |
| WiSE-FT de bout en bout, | 86.8 | 76.9 |
| WiSE-FT de bout en bout, meilleur par colonne | 87.1 | 77.4 |
Précision (%), d'après la Table 1. La dernière ligne choisit séparément pour chaque colonne.
L'ajustement de bout en bout fait passer ImageNet de 76.6 % à 86.2 %, mais la moyenne sous décalage de 73.4 % à 68.6 %. Avec , WiSE-FT atteint 86.8 % sur ImageNet, légèrement plus que l'ajustement, et 76.9 % sous décalage, davantage que le zéro-shot. Comparé au classificateur linéaire ajusté de l'article CLIP, le gain sous décalage vaut 4 à 6 points.
Les cinq jeux examinent des changements distincts. ImageNetV2 rassemble de nouvelles photos d'une distribution proche. ImageNet-R utilise notamment sculptures et peintures, sur 200 classes. Sketch utilise des dessins. ObjectNet varie fonds et points de vue et partage 113 classes avec ImageNet. ImageNet-A sélectionne des images naturelles mal classées par ResNet-50, sur 200 classes. L'évaluation doit se limiter aux classes correspondantes de chaque jeu.
| Jeu de données | Zéro-shot | Ajustement de bout en bout | WiSE-FT, |
|---|---|---|---|
| ImageNetV2 | 70.5 | 76.8 | 79.5 |
| ImageNet-R | 89.0 | 79.8 | 89.4 |
| ImageNet-Sketch | 60.9 | 57.9 | 64.7 |
| ObjectNet | 69.1 | 63.3 | 71.1 |
| ImageNet-A | 77.7 | 65.4 | 79.9 |
Précision (%), pour le même ViT-L/14@336px, d'après la Table 1.
Sur ImageNetV2, l'ajustement aide déjà, puis le mélange améliore encore le résultat. Sur ImageNet-R et ImageNet-A, le mélange récupère d'abord la précision fortement dégradée par l'ajustement. La moyenne des cinq masque cette différence. La ligne qui choisit le meilleur par colonne regroupe aussi plusieurs choix optimaux pour des objectifs différents, plutôt que les performances d'un modèle unique.
La tendance se retrouve sur ALIGN, BASIC et un ViT préentraîné sur JFT. WiSE-FT aide aussi sur six autres décalages, dont les images satellites et pièges photographiques de WILDS, CIFAR-10.1 et 10.2 et les perturbations d'images vidéo, ainsi que sur sept jeux de transfert ordinaires. Pour ces derniers, la réduction relative de l'erreur va de 4 % à 49 %.
Des hyperparamètres plus simples
Remplaçons le nuage par la précision en fonction de . Les six abscisses vont de 0, zéro-shot, à 1, ajustement complet. Le rose est l'interpolation des poids ; la droite pointillée oblique interpole les précisions des extrémités, et l'horizontale marque la meilleure extrémité.
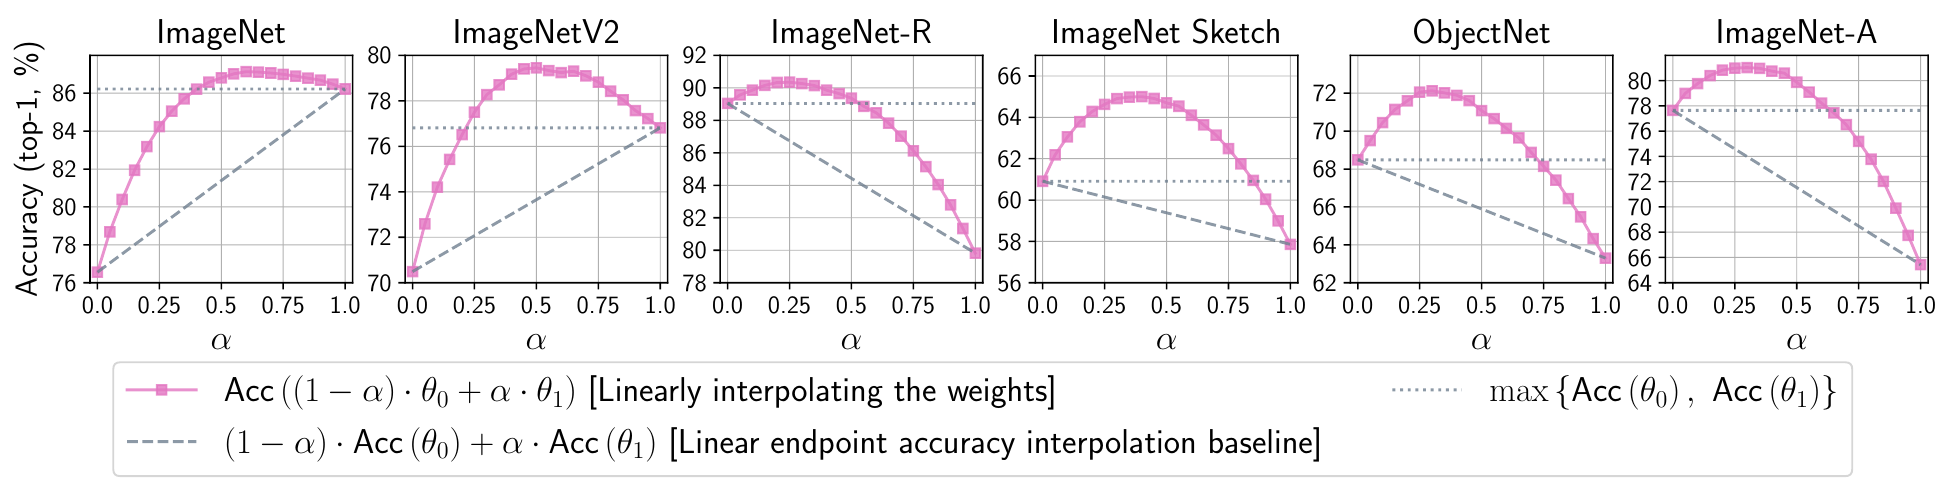
Dans les six jeux, une portion centrale de la courbe rose dépasse les deux extrémités, mais son maximum change de place. Le compromis dépend donc des données à servir.
Revenons à la sensibilité aux hyperparamètres : un petit changement peut fortement modifier le résultat sous décalage sans être visible sur ImageNet.
WiSE-FT ramène ce réglage à un seul . Même avec un taux d'apprentissage qui dégrade fortement la robustesse du modèle ajusté, choisir permet de retrouver un bon compromis, sans réentraîner. Dans les expériences, seules les méthodes de moyenne des poids, WiSE-FT ou EMA sur les itérés, atteignent cette meilleure courbe.
reste un point de départ utile, d'où le « mi-chemin » du sous-titre ; aucune dérivation n'en fait un optimum universel. L'annexe compare cette valeur aux meilleurs de chaque réglage : sur la moyenne combinant ImageNet et les cinq décalages, l'écart est d'environ 0 à 0.4 point. Avec une validation représentative du déploiement, balayez les coefficients sur le segment. Chaque candidat demande encore une évaluation par passe avant ; l'économie porte sur le nouvel ajustement.
Où se trouve la complémentarité ?
Les auteurs analysent d'abord les classificateurs LC à caractéristiques fixes. Ils mesurent leurs désaccords, puis lequel détermine le résultat de l'ensemble dans ces cas. Sur ImageNet, le classificateur ajusté l'emporte plus souvent ; sur la plupart des distributions décalées, c'est le zéro-shot, avec ImageNetV2 pour exception.
L'échelle de confiance intervient. La marge, définie par la différence entre les deux plus grands logits, est plus élevée pour le modèle ajusté sur la distribution de référence, et pour le zéro-shot sous décalage. Si chacun est meilleur sur des exemples différents, la pondération des logits peut conserver cette complémentarité. Cette analyse concerne LC ; pour le bout en bout, les représentations changent aussi et les auteurs s'en tiennent aux observations empiriques du paysage d'erreur.
Les comparaisons incluent un balayage des taux d'apprentissage, durées, arrêts précoces et régularisations vers les poids zéro-shot. En LC s'ajoutent distillation vers les sorties zéro-shot, label smoothing, et weight decay. Certaines méthodes récupèrent une partie de la robustesse, avec un nouvel entraînement ou un réglage de régularisation. WiSE-FT permet de terminer l'ajustement, puis de régler le compromis par une interpolation peu coûteuse.
Son périmètre reste précis : les résultats principaux concernent des décalages naturels, sans couvrir les attaques adversariales ni toute distribution inconnue. Le mélange exige des architectures et des classes compatibles. Si les encodeurs diffèrent, il faut envisager l'ensemble des sorties plutôt que recopier la moyenne des poids.
Conclusion
Une ligne suffit à écrire WiSE-FT : après l'ajustement, revenir à mi-chemin.
Ici, les versions zéro-shot et ajustée de CLIP partagent le préentraînement, et leurs têtes partent du même classificateur zéro-shot. Les mesures confirment une bonne région intermédiaire. Pour vos modèles, conservez d'abord le checkpoint avant ajustement, puis parcourez le segment sur vos données de validation ; c'est souvent plus simple que de deviner à nouveau des coefficients de régularisation.
Six mois plus tard, les mêmes auteurs posent une autre question : pourquoi ne pas ajouter aussi les ajustements obtenus avec d'autres hyperparamètres, ceux qu'on allait supprimer ? Ce sera Model Soups.