Article original
Essentially No Barriers in Neural Network Energy Landscape
- Publication
- ICML 2018Conférence
- Premier dépôt sur arXiv
- arXiv:1803.00885
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingnobarriers2018,
  title = {{Essentially No Barriers in Neural Network Energy Landscape}},
  author = {Felix Draxler and Kambis Veschgini and Manfred Salmhofer and Fred A. Hamprecht},
  year = {2018},
  eprint = {1803.00885},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1803.00885}
}
Quand on parle du paysage de perte d'un réseau de neurones, l'image la plus courante est une succession de vallées.
L'entraînement dévale la pente depuis un point de départ et finit par s'arrêter au fond d'une vallée. Les fonds de vallée sont plus ou moins larges, et les plus larges généraliseraient mieux, dit-on ; des graines aléatoires différentes mènent à des vallées différentes, séparées par des crêtes. Si l'on relie par un segment les poids de deux fonds de vallée, la perte monte puis redescend le long du trajet, comme beaucoup l'ont effectivement mesuré.
Draxler, Veschgini, Salmhofer et Hamprecht, de l'Université de Heidelberg, voient les choses autrement. Les auteurs viennent à la fois d'un laboratoire de traitement d'images et d'un institut de physique théorique ; ils empruntent à la mécanique statistique moléculaire un outil de recherche de chemins de réaction, pour voir si l'on peut relier deux fonds de vallée par un chemin qui contourne les montagnes au lieu de les franchir.
La réponse est inattendue. Pour ResNet et DenseNet sur CIFAR, les chemins trouvés sont presque plats.
Presque au même moment, la connectivité des modes de Garipov et al. aboutit indépendamment à la même observation. Les deux articles trouvent leurs chemins par des méthodes complètement différentes.
Définir le problème
À architecture et données d'entraînement fixées, la perte n'est qu'une fonction des paramètres . Étant donnés deux jeux de paramètres et , chacun entraîné jusqu'à convergence, on cherche un chemin continu de à dont la perte maximale le long du trajet soit aussi basse que possible :
Ce chemin s'appelle le chemin d'énergie minimale (minimum energy path, MEP) ; son point le plus haut est le véritable point selle entre les deux minima.
Les auteurs emploient « perte » et « énergie » comme synonymes, selon l'habitude des physiciens. Dans le paysage de perte, un fond de vallée est un état stable, et un point selle est la barrière à franchir pour passer d'un état à l'autre.
En deux dimensions, on peut tracer une grille et trouver le MEP par programmation dynamique ; mais un réseau compte souvent des millions de paramètres. Il faut alors partir d'un chemin initial et le courber peu à peu vers le bas à l'aide d'informations locales. Le chemin obtenu n'est pas forcément le MEP exact, et son point le plus haut ne fournit qu'une borne supérieure de l'énergie du point selle.
Le raisonnement de l'article est donc le suivant. Il suffit de trouver un chemin dont le point le plus haut est très bas pour prouver que la barrière entre les deux minima ne dépasse pas cette valeur.
Résoudre le problème
Des pivots reliés par des ressorts
On commence par discrétiser le chemin. pivots forment une chaîne dont les extrémités sont fixées aux deux minima : , .
L'approche la plus intuitive relie les pivots par des ressorts et minimise
Le premier terme tire chaque point vers le bas, le second maintient l'espacement entre les points.
Le problème vient de la raideur des ressorts. Si est trop petit, les pivots glissent vers le bas et les régions de forte perte se dépeuplent, alors que c'est justement le point le plus haut que l'on veut mesurer avec précision. Si est trop grand, l'énergie des ressorts croît comme le carré de la longueur totale du chemin : la chaîne se tend, coupe les virages et manque le vrai point selle.
Nudged Elastic Band
NEB (Nudged Elastic Band) résout ce dilemme par une modification simple. Il sépare les deux forces et ne garde de chacune que la direction utile :
Soit la direction tangente locale au pivot ;
La force de perte ne conserve que sa composante perpendiculaire au chemin, qui pousse le chemin vers le bas ; la force de ressort ne conserve que sa composante parallèle au chemin, qui répartit les points régulièrement. Ainsi, les points en hauteur ne glissent pas le long du chemin, et les ressorts ne tendent pas le chemin en ligne droite.
Le choix de la tangente demande aussi du soin. pointe vers celui des deux voisins dont la perte est la plus élevée ; ce choix évite les coudes dans le chemin et donne une meilleure approximation près du point selle.
Les auteurs vont encore plus loin dans leur implémentation. Faute de trouver un qui convienne à des paysages de perte et à des nombres de pivots différents, ils fixent simplement la force de ressort à zéro : à chaque itération, ils redistribuent d'abord les pivots à intervalles égaux le long du chemin, puis appliquent la force de perte perpendiculaire. Dans la littérature, cette variante s'appelle aussi la string method.
Un petit exemple en deux dimensions
Un réseau de neurones a trop de paramètres pour être dessiné. Prenons plutôt un paysage en deux dimensions pour voir ce que fait NEB :
Le premier terme annule la perte sur le cercle unité ; le second incline légèrement le cercle, de sorte que et deviennent deux minima. Le segment entre ces deux points passe par l'origine, où la perte vaut 1 ; en contournant par le cercle, le point le plus haut n'est qu'à environ 0.1.
import numpy as np

def loss(p):
    x, y = p[..., 0], p[..., 1]
    return (x**2 + y**2 - 1) ** 2 + 0.1 * y**2

def grad(p):
    x, y = p[..., 0], p[..., 1]
    r = x**2 + y**2 - 1
    return np.stack([4 * r * x, 4 * r * y + 0.2 * y], axis=-1)

def redistribute(path):
    seg = np.linalg.norm(np.diff(path, axis=0), axis=1)
    s = np.concatenate([[0], np.cumsum(seg)])
    t = np.linspace(0, s[-1], len(path))
    return np.stack([np.interp(t, s, path[:, d]) for d in range(2)], axis=1)

a, b = np.array([-1.0, 0.0]), np.array([1.0, 0.0])
path = np.linspace(a, b, 12)               # départ : 12 pivots sur le segment
path[1:-1, 1] += 0.05                      # petite poussée pour ne pas rester sur le point selle parfaitement symétrique
line_max = loss(np.linspace(a, b, 201)).max()

for step in range(2000):
    path = redistribute(path)              # méthode des auteurs : sans ressorts, pivots réespacés à chaque tour
    for i in range(1, len(path) - 1):
        lo, hi = path[i - 1], path[i + 1]
        tau = (hi - path[i]) if loss(hi) > loss(lo) else (path[i] - lo)
        tau /= np.linalg.norm(tau)
        g = grad(path[i])
        f_perp = -(g - (g @ tau) * tau)    # ne garder que la force de perte perpendiculaire au chemin
        path[i] = path[i] + 0.05 * f_perp

fine = np.concatenate([np.linspace(p, q, 20, endpoint=False) for p, q in zip(path[:-1], path[1:])] + [path[-1:]])
print(f"Perte maximale sur le segment : {line_max:.3f}")
print(f"Perte maximale sur le chemin NEB : {loss(fine).max():.3f}")
x, y = fine[loss(fine).argmax()] + 0.0
print(f"Position du point le plus haut : ({x:.2f}, {y:.2f})")
Perte maximale sur le segment : 1.000
Perte maximale sur le chemin NEB : 0.098
Position du point le plus haut : (-0.00, 0.96)
Sur le segment, la barrière vaut 1.0 ; NEB pousse les pivots intermédiaires vers le haut, près du cercle, et la barrière descend à 0.098. Cette valeur est l'énergie du point selle de ce paysage. En minimisant le long de , on trouve le point selle en , .
La ligne qui calcule la tangente applique la règle vue plus haut : elle pointe vers le voisin dont la perte est la plus élevée. Si l'on remplace f_perp par le -g complet, les points intermédiaires glissent le long du cercle vers les deux extrémités et finissent entassés près des deux fonds de vallée ; plus aucun point ne mesure alors le sommet du chemin.
AutoNEB et arbre couvrant minimal
Dans un espace à des millions de dimensions, on ignore au départ combien de pivots il faut. AutoNEB lance d'abord quelques cycles de NEB avec peu de pivots, puis inspecte le chemin : si la perte entre deux pivots voisins dépasse l'estimation par interpolation linéaire entre eux de plus de 20 % de « l'écart d'énergie sur tout le chemin », un nouveau pivot est inséré à cet endroit. Entre chaque paire de pivots voisins, 9 points supplémentaires sont évalués pour repérer ces pics manqués.
AutoNEB peut tout de même rester bloqué sur un chemin d'énergie minimale local et donner un point selle trop haut. Les auteurs traitent ce problème par une inégalité. Si l'on connaît un chemin de A à B et un autre de B à C, leur concaténation est un chemin de A à C ; donc
C'est une propriété ultramétrique. Grâce à elle, dès que tous les minima sont reliés en un graphe par des chemins connus, la barrière entre chaque paire de minima est bornée ; un chemin trop haut peut aussi être remplacé par un détour via d'autres chemins.
Les auteurs ramènent donc le problème à la recherche d'un arbre couvrant minimal. Ils relient d'abord le premier minimum à tous les autres, puis choisissent à plusieurs reprises l'arête la plus haute de l'arbre et tentent, avec AutoNEB, de trouver un chemin plus bas entre les deux sous-arbres qu'elle sépare. S'ils en trouvent un, ils remplacent l'arête ; sinon, ils la remettent en place, jusqu'à avoir traité toutes les paires ou épuisé le budget de calcul. Chaque chemin AutoNEB coûte à peu près un entraînement complet du réseau.
Discussion
Dispositif expérimental
Pour chaque architecture, 10 minima sont entraînés, tous depuis des initialisations aléatoires différentes. Les auteurs vérifient qu'ils sont réellement distincts : pour ResNet et DenseNet, les exemples de test mal classés de deux minima quelconques se recoupent au plus à 70 %.
Les architectures se répartissent en trois familles :
- CNN de base sans connexions de saut : CNN à une couche de 12 à 96 canaux, et CNN à deux et trois couches de 48 canaux.
- ResNet : ResNet-8, 20, 32, 44 et 56, entraînés 136 époques selon la procédure de l'article d'origine.
- DenseNet : DenseNet-40-12 et DenseNet-100-12-BC, entraînés 266 époques.
Les jeux de données sont CIFAR-10 et CIFAR-100. Pour chaque paire de minima, AutoNEB exécute 14 cycles de NEB avec une SGD à momentum, dont le taux d'apprentissage descend par paliers de 0.1 à 0.001.
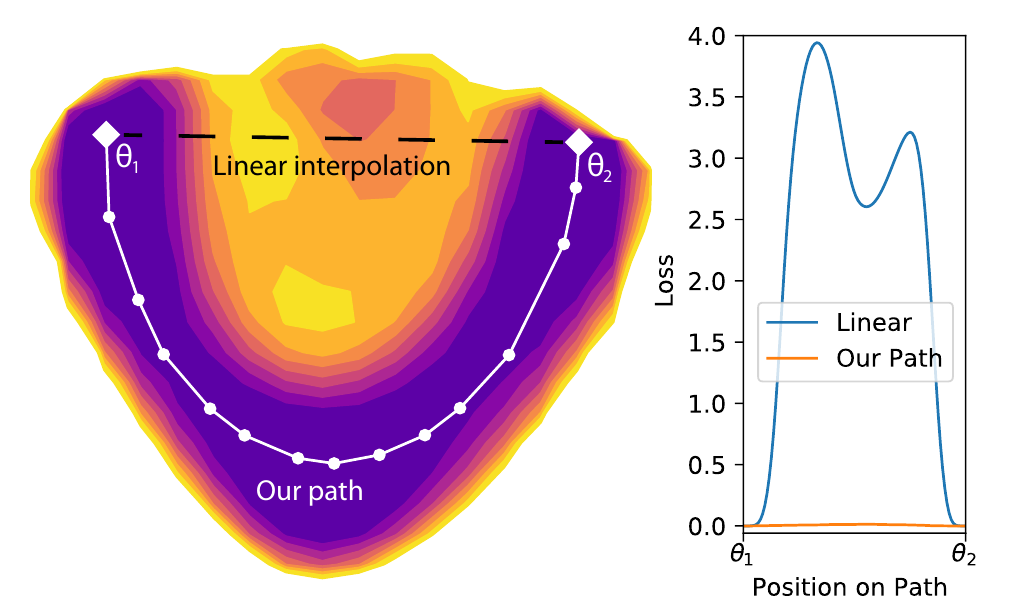
Cette figure est une coupe bidimensionnelle d'une fonction de perte à un million de dimensions. Le segment heurte en son milieu une vaste zone de forte perte, qui culmine près de 4 ; le chemin trouvé par AutoNEB la contourne par le côté, et sa perte ne présente presque aucune ondulation.
Quelle est la hauteur des points selles ?
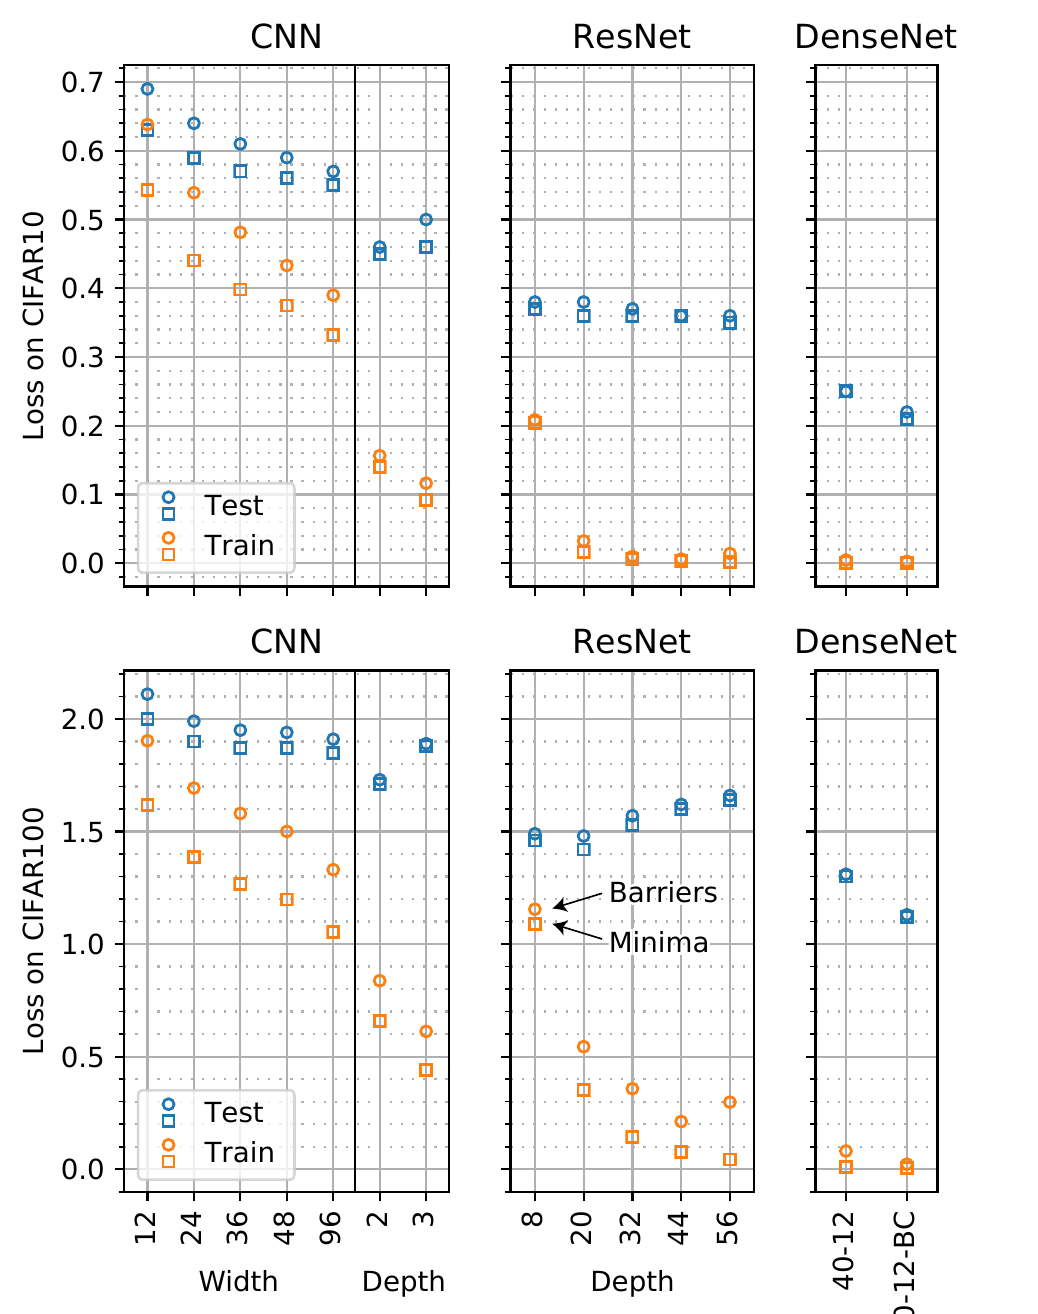
C'est le résultat central de l'article. Il faut comparer carrés et ronds d'une même couleur. Les carrés donnent la perte moyenne des minima, les ronds celle des points selles des chemins ; plus ils sont proches, plus la barrière est basse.
Les CNN de base, à gauche, montrent la tendance. Quand la largeur passe de 12 à 96, le point selle d'entraînement se rapproche progressivement du minimum ; avec deux puis trois couches, l'écart se réduit plus vite. Pour ResNet et DenseNet, les points selles d'entraînement sur CIFAR-10 collent presque aux minima.
La Table B.1 de l'annexe donne les chiffres. Pour ResNet-56 sur CIFAR-10, la perte d'entraînement moyenne vaut 0.0022 aux minima et 0.0141 aux points selles ; pour DenseNet-100-12-BC, 0.0005 et 0.0026. En proportion, l'écart paraît de plusieurs fois, mais tout dépend de la référence. Un réseau non entraîné a une perte de sur CIFAR-10 ; les points selles des réseaux résiduels profonds sont environ deux ordres de grandeur plus bas que cette valeur, et à peu près un ordre de grandeur sous la perte de test du même modèle.
CIFAR-100 est plus difficile, et ses barrières plus hautes. La perte d'entraînement de ResNet-56 passe de 0.0428 à 0.2978, celle de DenseNet-100-12-BC de 0.0050 à 0.0223 ; par rapport à la perte d'environ 4.6 d'un réseau initialisé au hasard, l'écart reste très faible.
Le taux d'erreur de classification varie peu lui aussi. D'après l'annexe, le taux d'erreur maximal le long du chemin dépasse celui des minima d'au plus 0.7 point (CIFAR-10) et 2.9 points (CIFAR-100) pour ResNet, et de 0.4 et 1.5 point pour DenseNet.
Une autre mesure consiste à regarder la courbe d'entraînement : à quel moment la perte passe-t-elle sous celle du point selle ? Très tard. Toutes les architectures doivent attendre la première décroissance du taux d'apprentissage ; la plupart des ResNet et DenseNet attendent même la deuxième, c'est-à-dire la dernière phase de l'entraînement. Autrement dit, ces points selles valent à peu près « un modèle presque arrivé au bout de son entraînement ».
À quoi ressemblent les chemins ?
Les chemins eux-mêmes sont réguliers. Le long du chemin, l'écart de chaque paramètre par rapport à l'interpolation linéaire évolue en douceur pour toutes les coordonnées, et les plus grands écarts se concentrent près du point selle. Le chemin complet est de 50 % à 2.5 fois plus long que le segment entre les deux points.
Dans leur conclusion, les auteurs suggèrent d'utiliser ces chemins comme un vaste ensemble de modèles, puisque la perte de test le long du chemin est même légèrement plus basse. Cette piste sera développée plus complètement par FGE, de Garipov et al.
Pourquoi si plat ?
L'article n'apporte pas de démonstration ; les auteurs proposent deux explications qualitatives.
La première est la résilience. Les réseaux modernes ont des dizaines à des centaines de canaux par couche, plus des connexions de saut. Une petite perturbation d'un paramètre peut être compensée par l'ajustement conjoint d'un grand nombre d'autres paramètres ; le modèle peut ainsi modifier sa structure pas à pas sans hausse nette de la perte. Le dropout et les ensembles de modèles exploitent et renforcent précisément cette résilience ; c'est aussi ce qui permet de compresser fortement un réseau sans hausse nette de la perte.
La seconde est la redondance, que les auteurs illustrent avec XOR.
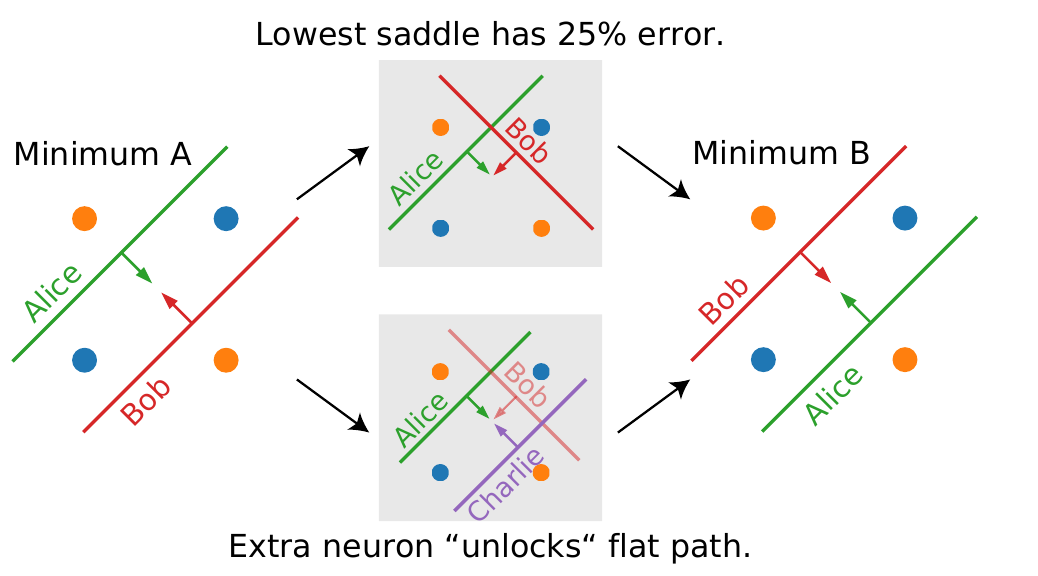
Le perceptron à deux couches qui résout XOR dans les manuels a deux neurones cachés, que les auteurs appellent Alice et Bob. Échanger leurs positions (en échangeant aussi les poids de la couche suivante) donne un autre minimum équivalent. Avec seulement deux neurones, tout chemin continu de A à B classe mal au moins un point en cours de route : le point selle le plus bas a 25 % d'erreur.
Avec un neurone supplémentaire, Charlie, on peut organiser un relais. Charlie remplace d'abord Bob, Bob glisse lentement vers la position d'Alice, Alice reprend ensuite le travail de Charlie, puis Charlie se retire. Tant que la couche suivante ignore temporairement le neurone en mouvement, aucun point n'est mal classé pendant tout le trajet.
Cet exemple relie l'échange de neurones (la symétrie de permutation) à la capacité supplémentaire. Le rôle de la symétrie de permutation dans les barrières est précisément la question que poursuivront ensuite Entezari et al. puis Git Re-Basin.
Limites
AutoNEB ne trouve qu'une borne supérieure, et les auteurs reconnaissent qu'ils ne savent pas encore caractériser les conditions dans lesquelles le phénomène se produit. Les expériences se limitent à la classification d'images sur CIFAR-10/100, avec des modèles allant au plus jusqu'à DenseNet-100 ; chaque chemin coûtant presque un entraînement complet, seuls 10 minima sont retenus par architecture.
Autre source de confusion, la nature de la « connectivité ». Cet article prouve l'existence d'un chemin courbe de faible perte ; l'interpolation linéaire, elle, heurte encore un pic. La moyenne de poids exige l'absence de barrière sur le segment lui-même, une condition plus stricte ; les recherches ultérieures sur la connectivité linéaire des modes et l'alignement par permutation traitent précisément cet écart.
Conclusion
Cet article importe en deep learning un outil de chimie servant à trouver des chemins de réaction, et en tire une observation nette pour ResNet et DenseNet. Entre deux minima entraînés indépendamment, il existe un chemin qui ne monte presque pas ; plus le réseau est large et profond, plus ce chemin est plat.
L'image des vallées mérite donc d'être revue. La région de faible perte ressemble davantage à une vaste plaine d'un seul tenant, et les minima ne sont que des positions différentes sur cette plaine.
L'implémentation PyTorch se trouve dans fdraxler/PyTorch-AutoNEB. Avant de la lancer sur un grand modèle, réfléchissez bien au budget : relier chaque paire de minima prend à peu près le temps d'un nouvel entraînement du réseau.