Article original
Model Merging in LLMs, MLLMs, and Beyond: Methods, Theories, Applications and Opportunities
- Publication
- ACM Computing Surveys 2026Revue
- Premier dépôt sur arXiv
- arXiv:2408.07666
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingmodelmergingsurvey2024,
  title = {{Model Merging in LLMs, MLLMs, and Beyond: Methods, Theories, Applications and Opportunities}},
  author = {Enneng Yang and Li Shen and Guibing Guo and Xingwei Wang and Xiaochun Cao and Jie Zhang and Dacheng Tao},
  year = {2024},
  eprint = {2408.07666},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2408.07666}
}
Ces dernières années, les articles sur la fusion de modèles se sont multipliés, et les noms de méthodes aussi.
Arithmétique des tâches, TIES, DARE, AdaMerging, RegMean, Fisher Merging, Model Breadcrumbs, TSV-M, WEMoE… Chaque article affirme résoudre un certain type d'interférence lors de la fusion, mais rares sont ceux qui les regardent ensemble. Quel problème traite chacune de ces méthodes ? De quelles données a-t-elle besoin ? Tient-elle encore sur les grands modèles de langage ?
Cette revue de Yang, Shen, Guo et leurs collègues, du campus de Shenzhen de l'Université Sun Yat-sen, de la Northeastern University (Chine) et de l'Université technologique de Nanyang, veut répondre à ces questions. Publiée pour la première fois en août 2024 puis régulièrement mise à jour, elle atteint quarante pages dans sa cinquième version, fin 2025. Les auteurs maintiennent aussi une liste d'articles sur GitHub qui recense en continu les nouveaux travaux.
Cette note se concentre sur sa classification, sur les expériences comparatives menées par les auteurs eux-mêmes et sur les problèmes que la revue juge encore ouverts.
Définir le problème
Ce qui distingue la fusion de modèles des autres approches
Les auteurs comparent d'abord la fusion de modèles à quatre modes d'apprentissage voisins.
- Apprentissage monotâche : un modèle expert par tâche ; pas d'interférence, mais aucun partage des connaissances, et le nombre de modèles croît avec celui des tâches.
- Apprentissage multitâche : un seul modèle apprend toutes les tâches à la fois, mais il faut réunir les données de toutes les tâches pour l'entraîner.
- Apprentissage fédéré : les données restent chez chaque client et le serveur agrège les mises à jour du modèle, mais il faut de nombreux tours de communication.
- Apprentissage d'ensemble : on conserve plusieurs modèles experts et on combine leurs sorties, avec des coûts d'inférence et de stockage élevés.
La fusion de modèles combine directement les paramètres de plusieurs modèles experts entraînés pour obtenir un modèle unique ; dans la plupart des cas, elle ne demande ni les données d'origine ni un nouvel entraînement.
Formellement, étant donnés modèles de même architecture , généralement ajustés à partir d'un même modèle préentraîné , on cherche
La version la plus simple est la moyenne directe. Les auteurs notent qu'elle donne souvent de mauvais résultats, pour deux types de raisons : soit les conditions préalables à la fusion manquent, par exemple des modèles qui ne sont pas dans le même bassin ou des architectures différentes ; soit les paramètres des différentes tâches entrent en conflit et interfèrent.
Toute la classification des méthodes de la revue se déploie à partir de ces deux causes.
Résoudre le problème
Classification : avant et pendant la fusion
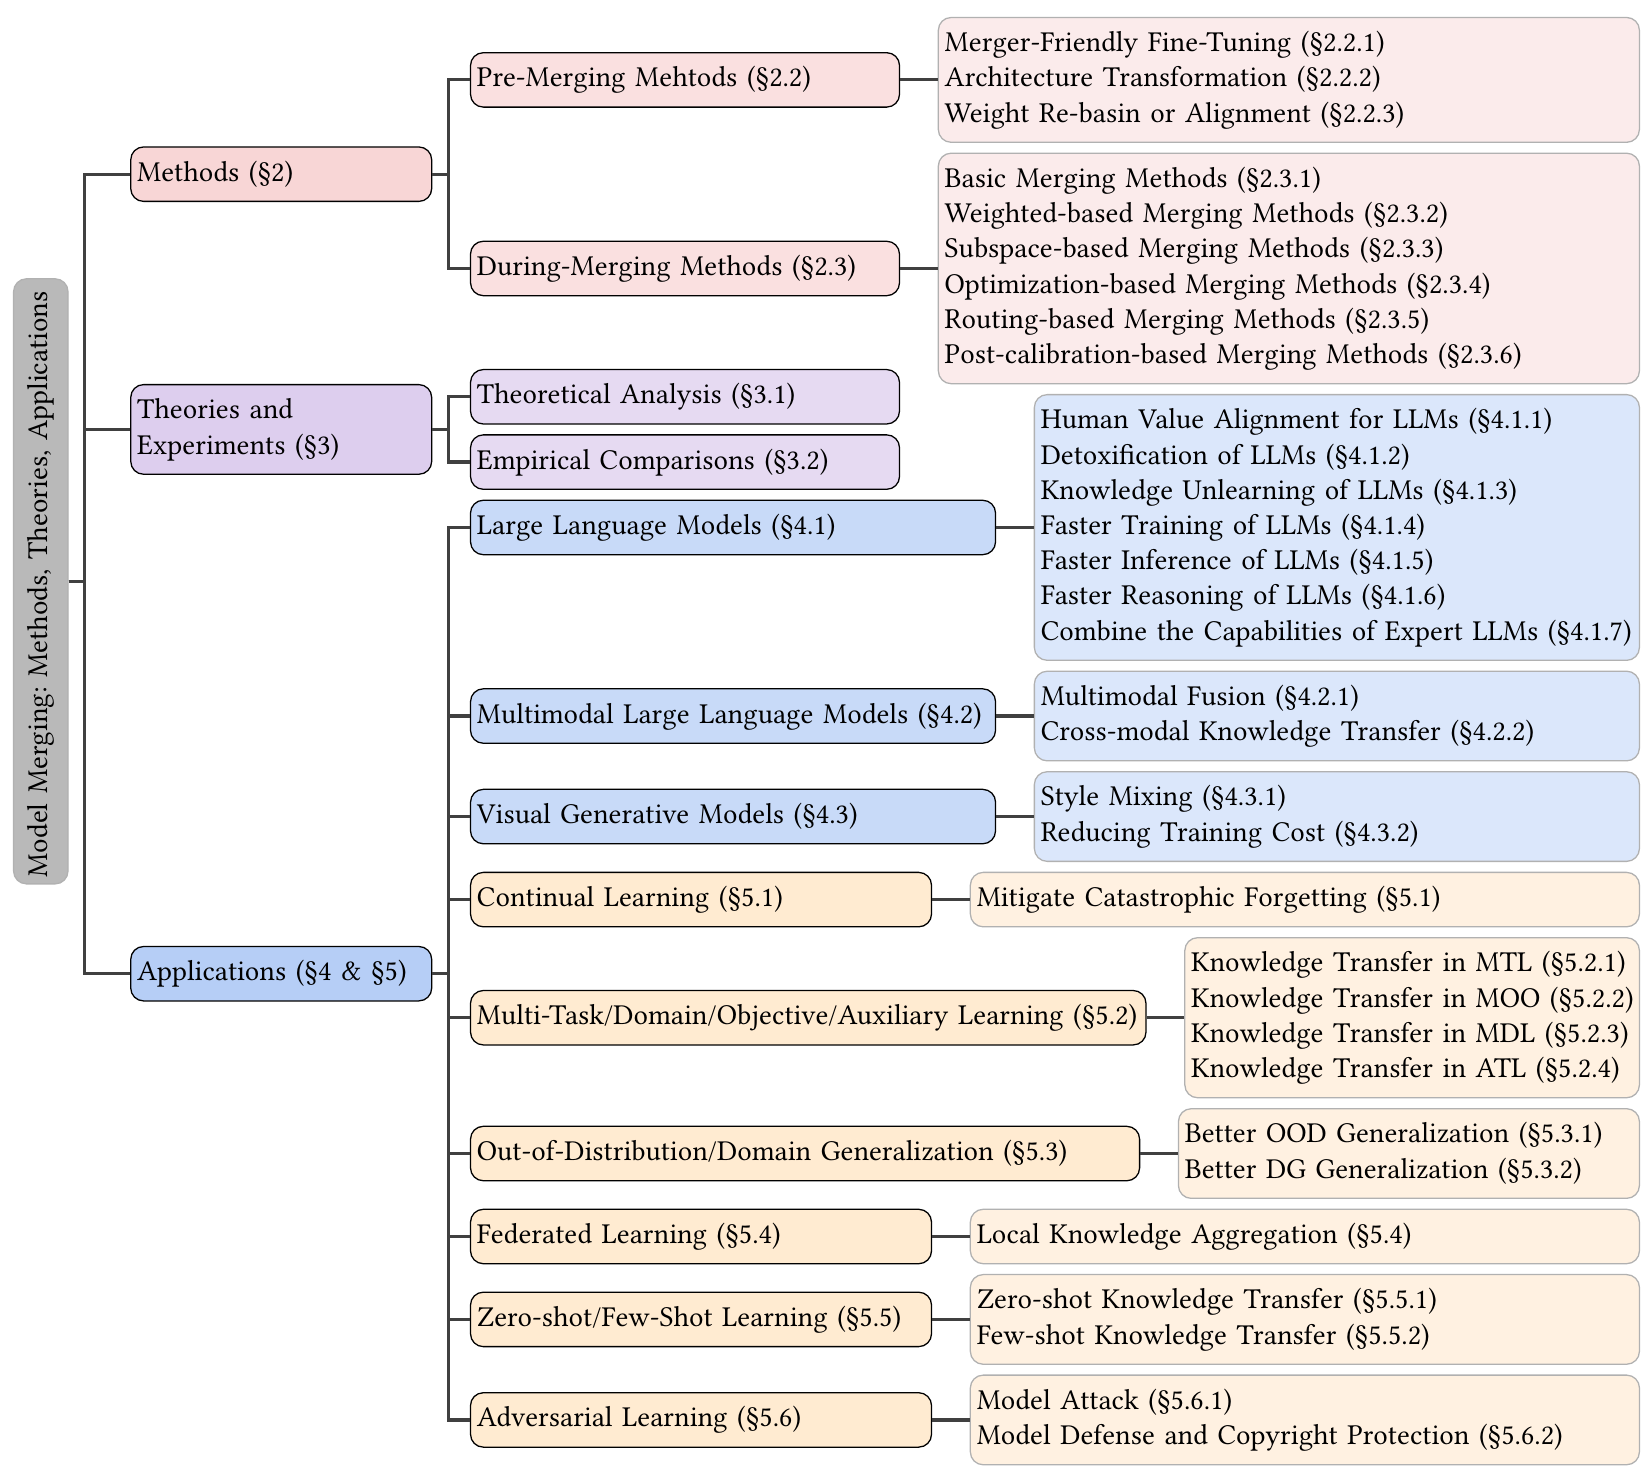
Cette figure sert de table des matières à toute la revue. En haut, les « méthodes » se répartissent en deux moments.
Avant la fusion (pre-merging), il s'agit de préparer de bonnes conditions pour la fusion :
- Ajustement fin favorable à la fusion : rendre les modèles plus faciles à fusionner dès l'ajustement fin. L'exemple type est l'arithmétique des tâches dans l'espace tangent, qui ajuste un modèle linéarisé pour mieux découpler les vecteurs de tâche ; des travaux ultérieurs ne linéarisent qu'une partie des couches pour réduire le coût, ou utilisent une minimisation sharpness-aware pour aplatir le paysage de perte ; d'autres n'ajustent qu'une petite partie des paramètres pour limiter les conflits.
- Transformation d'architecture : des modèles d'architectures différentes ne peuvent pas combiner directement leurs paramètres ; on les ramène d'abord à une même architecture par distillation des connaissances ou ajout de couches. FuseLLM et FusionChat relèvent de cette catégorie, ce qui demande des données et un entraînement.
- Réalignement des poids : les modèles entraînés indépendamment sont d'abord alignés par permutation des neurones pour tomber dans le même bassin. Git Re-Basin et l'alignement par transport optimal OTFusion se trouvent ici ; les auteurs citent aussi l'observation de REPAIR selon laquelle l'efficacité de l'alignement dépend fortement des couches de normalisation.
Pendant la fusion (during-merging), on traite les conflits entre tâches, en six catégories :
- Méthodes de base : la moyenne directe, ou l'arithmétique des tâches.
- Méthodes pondérées : fixer des poids par modèle, par couche, voire par paramètre. Par exemple, chercher les coefficients par algorithme évolutionnaire ; AdaMerging apprend les coefficients sur des données de test non étiquetées, avec l'entropie comme perte de substitution ; RegMean calcule une solution en forme close pour les couches linéaires ; Fisher Merging mesure l'importance des paramètres par l'information de Fisher. SLERP est aussi classé dans cette catégorie.
- Méthodes par sous-espace : projeter les vecteurs de tâche dans un sous-espace creux ou de faible rang. Côté creux, TIES-Merging, DARE et Model Breadcrumbs ; côté faible rang, TSV-M, ISO-C et KnOTS, qui appliquent une SVD aux vecteurs de tâche.
- Méthodes par optimisation : exploiter les propriétés des vecteurs de tâche eux-mêmes pour écrire une fonction objectif sans données, par exemple rendre les vecteurs de tâche plus orthogonaux (AWD), ou construire une perte sans données sur les couches linéaires (WUDI-Merging).
- Méthodes par routage : les catégories précédentes produisent un modèle fixe. Le routage décide dynamiquement de la fusion selon l'entrée ; WEMoE, par exemple, fusionne les couches linéaires avec des poids donnés par un réseau de routage. C'est généralement l'approche la plus performante, au prix de paramètres supplémentaires à conserver et d'une inférence plus lente.
- Correction a posteriori : les représentations internes du modèle fusionné s'écartent beaucoup de celles de chaque expert. Representation Surgery et d'autres méthodes ajoutent un petit module qui corrige cet écart.
Ce que montre un tableau comparatif
Les auteurs comparent les méthodes représentatives selon plusieurs dimensions : nombre de paramètres après fusion, absence ou non de réglage, données requises, caractère statique ou dynamique, et granularité des poids (globale, par tâche, par couche, par paramètre). Mis côte à côte, plusieurs compromis sautent aux yeux.
- Avec la plupart des méthodes, le modèle fusionné a le nombre de paramètres d'un seul modèle ; les méthodes de routage et de correction en ont davantage, WEMoE même bien davantage.
- Plus la granularité des méthodes pondérées est fine, meilleures elles sont généralement, mais elles demandent le plus souvent des données supplémentaires pour estimer les poids, comme un jeu de validation ou un jeu de test non étiqueté.
- Beaucoup de méthodes par optimisation et par sous-espace de faible rang mettent en avant qu'elles se passent de données.
Les auteurs concluent qu'aucune méthode ne convient à toutes les situations ; il faut choisir selon les exigences de performance, la difficulté de mise en œuvre, les données et la puissance de calcul disponibles.
Une théorie encore fragmentaire
Le troisième chapitre rassemble les analyses théoriques, classées en trois catégories selon l'origine des modèles fusionnés.
- Une même trajectoire d'entraînement : pour SWA ou EMA, dans des cadres simplifiés comme la régression aux moindres carrés, on dispose d'une décomposition biais-variance, ainsi que de bornes de stabilité et de généralisation dans les cas convexe et non convexe.
- Même tâche, hyperparamètres différents : l'explication passe par la connectivité linéaire des modes et les minima plats. Des modèles ajustés depuis un même modèle préentraîné avec des réglages différents sont généralement reliés linéairement.
- Tâches différentes : le NTK et le découplage des poids expliquent l'arithmétique des tâches ; certains travaux relient aussi vecteurs de tâche et gradients, et montrent que pour une époque de descente de gradient sur le lot complet, le vecteur de tâche est exactement le taux d'apprentissage multiplié par le gradient négatif.
Les auteurs admettent franchement que ces trois volets théoriques n'expliquent chacun qu'une partie, reposent pour la plupart sur des hypothèses de point de départ commun, de réseaux larges ou de linéarisation, n'ont pas encore été vérifiés sur les grands modèles de langage, et qu'aucun cadre unifié n'existe encore.
Discussion
Les comparaisons menées par les auteurs
Dans la revue, les auteurs mènent aussi leurs propres expériences comparatives, sur cinq backbones : les ViT-B/32 et ViT-L/14 de CLIP fusionnant 8 tâches de classification d'images, RoBERTa-Large fusionnant 8 tâches GLUE, Llama-3.1-8B fusionnant 5 tâches de génération de texte, et InternVL-2.5 fusionnant 5 tâches multimodales.
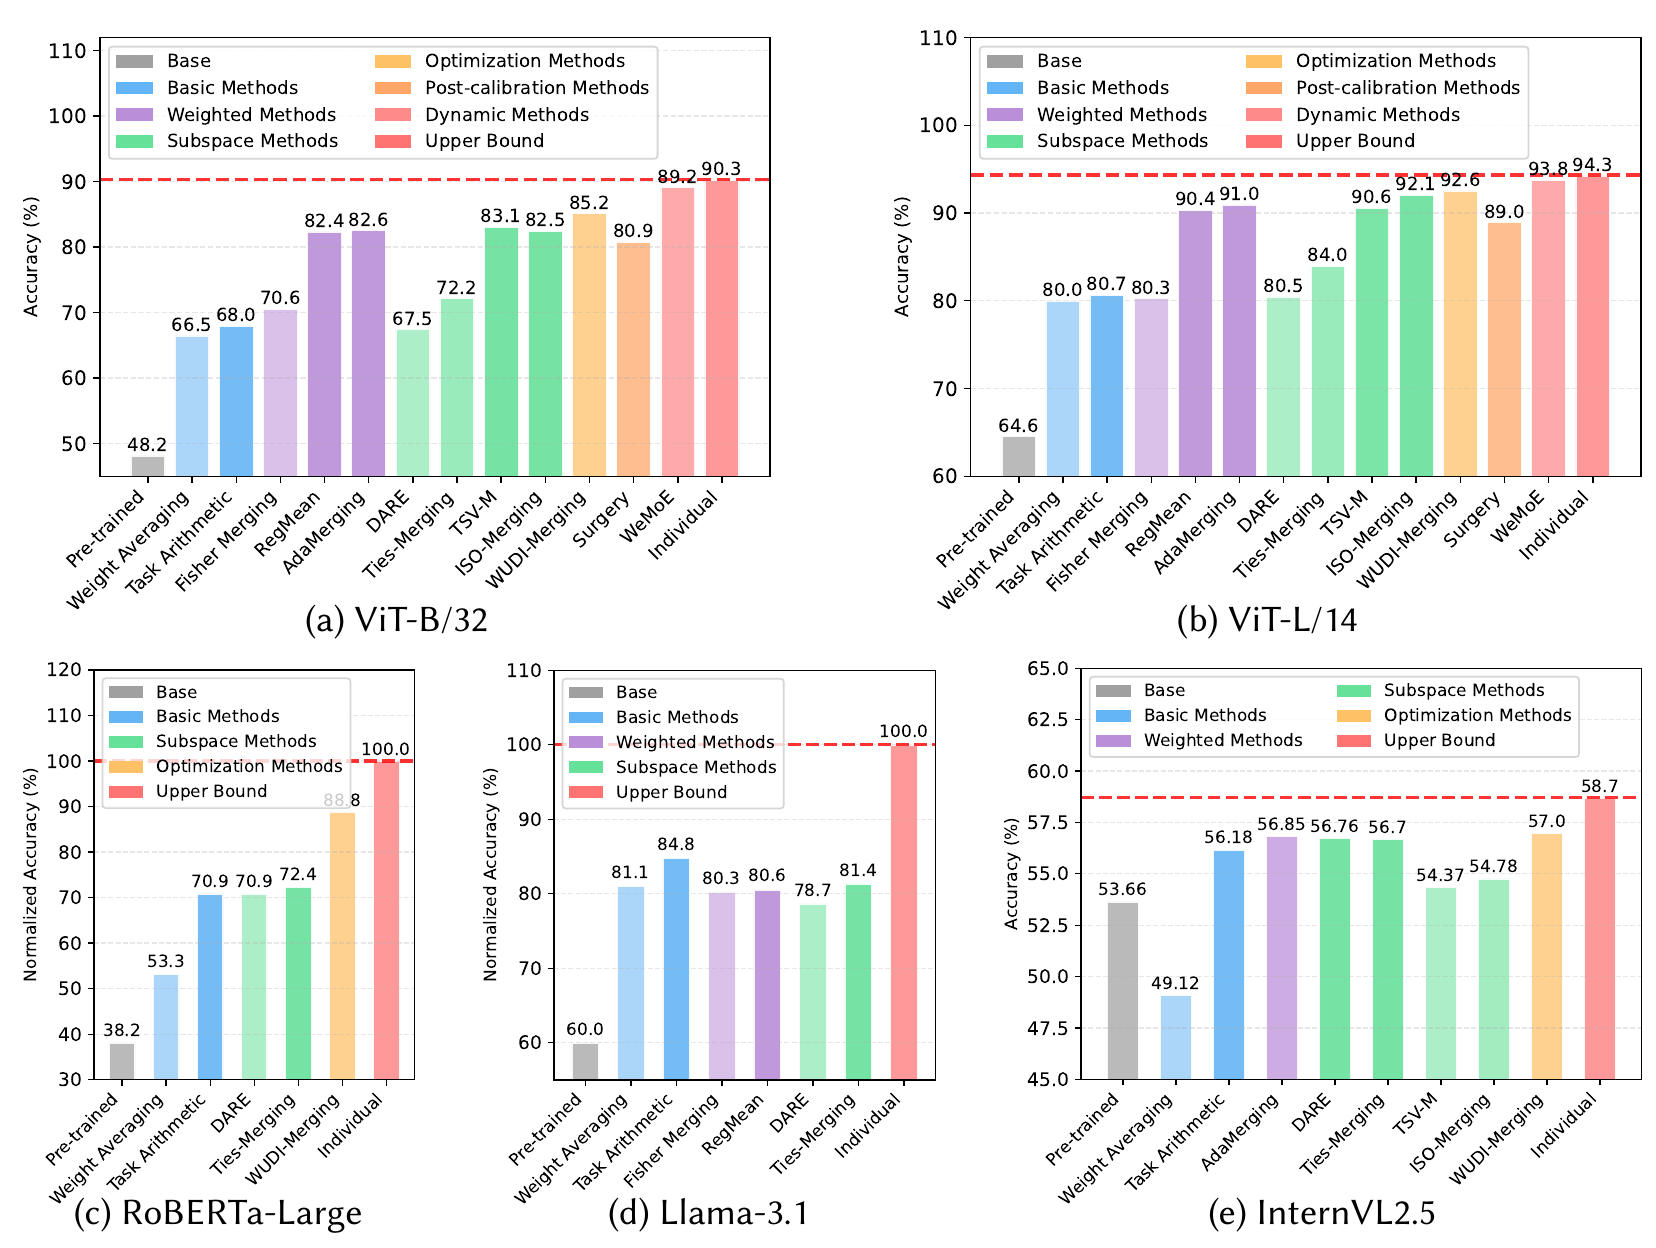
Dans chaque graphique, la barre grise la plus à gauche est le modèle préentraîné, la rouge la plus à droite le modèle ajusté séparément sur chaque tâche, c'est-à-dire la borne supérieure. Entre les deux, les méthodes en couleurs sont d'autant meilleures qu'elles approchent la ligne rouge en pointillés.
Commençons par ViT-B/32. La moyenne directe n'atteint que 66.5, loin de la borne de 90.3 ; les méthodes pondérées et par sous-espace de faible rang montent à 82 ou 83 ; WUDI-Merging, sans données, atteint 85.2 ; WEMoE, une méthode de routage qui demande des paramètres supplémentaires, atteint 89.2 et rattrape presque la borne. Sur ViT-L/14, toutes les méthodes font bien mieux, et WEMoE atteint 93.8 pour une borne de 94.3. Les grands modèles se fusionnent plus facilement, ce qui rejoint l'observation de Plus grand, plus facile à fusionner.
Avec Llama-3.1, le tableau change complètement. L'arithmétique des tâches arrive en tête avec 84.8 ; Fisher Merging, RegMean, DARE et TIES se situent entre 78.7 et 81.4, derrière l'arithmétique des tâches, et à peine au-dessus ou en dessous des 81.1 de la moyenne directe ; il reste plus de dix points jusqu'à la borne de 100. Les méthodes « avancées » qui l'emportent nettement en vision ne gardent aucun avantage sur les tâches de génération des modèles de langage.
Sur InternVL2.5, la moyenne directe, à 49.12, passe même sous les 53.66 du modèle préentraîné : la fusion dégrade le modèle. Les écarts entre méthodes ne dépassent pas un ou deux points ; la meilleure, WUDI-Merging, atteint 57.0, pour une borne de 58.7.
Cette comparaison est l'un des apports les plus précieux de la revue. Beaucoup de méthodes de fusion ont été développées et réglées sur les huit tâches de classification de CLIP ; sur les LLM et les modèles multimodaux, le classement est bouleversé. Avant de choisir une méthode, mieux vaut refaire une comparaison sur son propre modèle et ses propres tâches.
Sept usages pour les grands modèles de langage
Le quatrième chapitre recense les applications de la fusion de modèles aux LLM ; plusieurs directions recoupent d'autres notes du site.
- Alignement sur les préférences humaines : entraîner séparément des modèles conformes à différentes préférences, puis les fusionner selon les besoins de l'utilisateur.
- Détoxification : retirer des sorties toxiques ou mensongères en soustrayant un vecteur de tâche.
- Désapprentissage : retirer de la même façon, par soustraction, des connaissances précises, par exemple des contenus protégés par le droit d'auteur appris par erreur, sans le coût d'un réentraînement depuis zéro.
- Accélérer l'entraînement : moyenner des checkpoints pendant le préentraînement. Les auteurs rangent ici PMA et WSM, qui remplacent tous deux la décroissance du taux d'apprentissage par une moyenne de checkpoints.
- Accélérer l'inférence des MoE : fusionner d'abord les paramètres des experts avant le calcul, pour réduire le nombre d'experts à calculer.
- Accélérer le raisonnement : fusionner un modèle de raisonnement à longue réflexion avec un modèle généraliste aux réponses brèves, pour raccourcir les sorties. Dans l'exemple cité par les auteurs, l'arithmétique des tâches et TIES réduisent d'environ moitié la longueur du raisonnement sur un modèle 7B, avec une précision à peu près inchangée.
- Combiner des capacités expertes : fusionner des modèles experts de domaines différents en un modèle généraliste.
Quant à l'usage réel dans les rapports techniques, la revue en parle peu. Pour le détail de la façon dont les rapports de Llama 3, Tülu 3, Command A et d'autres inscrivent la fusion dans leur procédure d'entraînement officielle, il faut revenir à chacun d'eux.
Problèmes ouverts
Le dernier chapitre liste sept directions ; les premières sont les plus concrètes.
- L'écart avec les modèles indépendants : la fusion dépend encore fortement de la prémisse « même modèle préentraîné, taux d'apprentissage et nombre de pas d'ajustement soigneusement contrôlés ». Même ainsi, dès que les tâches se multiplient, l'écart devient net ; sur Llama-3.1, la meilleure méthode atteint 84.8 pour une borne de 100.
- Théorie : la fusion de modèles de tâches différentes, entraînés depuis zéro, n'a presque aucune explication théorique.
- Confiance : les propriétaires de modèles veulent empêcher que leurs modèles soient fusionnés, et ceux qui fusionnent doivent se prémunir contre des portes dérobées cachées dans les modèles.
- Efficacité : les méthodes performantes demandent généralement de charger tous les modèles en mémoire à la fois ; fusionner 72 ViT-B/32 ajustés exige par exemple plus de 200 Go ; la recherche de coefficients demande aussi des évaluations répétées.
- Modèles hétérogènes : pour des modèles d'architectures différentes, on ne peut aujourd'hui que les distiller d'abord vers une même architecture, ce qui coûte cher.
Comment lire cette revue
C'est une revue très large ; son cinquième chapitre couvre encore plus d'une dizaine de sous-domaines, dont l'apprentissage continu, l'apprentissage multitâche, la généralisation hors distribution, l'apprentissage fédéré, l'apprentissage few-shot et les attaques antagonistes, chacun généralement traité en un ou deux paragraphes.
À quoi sert-elle le mieux ? Sa classification peut servir de carte. Face à une nouvelle méthode de fusion, situez-la d'abord : avant ou pendant la fusion, avec quelles données, statique ou dynamique ; vous saurez à peu près quel problème elle résout et ce qu'elle coûte. Les détails et les conditions expérimentales de chaque méthode restent à vérifier dans les articles originaux.
Conclusion
Avec ses deux phases, « avant la fusion » et « pendant la fusion », cette revue organise les méthodes éparses en une carte claire, complétée par la théorie, les applications et les défis.
Ce qu'il faut surtout en retenir, c'est la comparaison menée par les auteurs eux-mêmes. Les méthodes avancées qui brillent sur CLIP ne battent pas forcément, sur Llama-3.1, la plus simple arithmétique des tâches.
Les méthodes ne manquent pas ; commencez par les comparer à l'arithmétique des tâches.