Article original
Git Re-Basin: Merging Models modulo Permutation Symmetries
- Publication
- ICLR 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2209.04836
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmerginggitrebasin2022,
  title = {{Git Re-Basin: Merging Models modulo Permutation Symmetries}},
  author = {Samuel K. Ainsworth and Jonathan Hayase and Siddhartha Srinivasa},
  year = {2022},
  eprint = {2209.04836},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2209.04836}
}
Les unités cachées n'ont pas d'ordre imposé. Échanger les unités 3 et 7, en échangeant aussi les entrées correspondantes de la couche suivante, laisse la sortie du réseau identique.
Hecht-Nielsen discutait déjà cette symétrie de permutation en 1990. Une même fonction possède ainsi un grand nombre d'écritures en poids. L'article donne quelques ordres de grandeur :
| Architecture | Permutations des unités cachées |
|---|---|
| MLP à trois couches, largeur 512 | |
| VGG16 | |
| ResNet50 | |
| Borne haute du nombre d'atomes de l'Univers observable |
D'après la Table 1 de l'article.
On sait depuis longtemps qu'interpoler deux réseaux entraînés depuis des initialisations indépendantes fait souvent apparaître un mur de perte. En 2021, Entezari et al. avancent une conjecture : en tenant compte de toutes les permutations, la plupart des solutions trouvées par SGD seraient reliées linéairement sans barrière. Le paysage pourrait ainsi posséder un seul bassin, à permutation près.
Samuel Ainsworth, Jonathan Hayase et Siddhartha Srinivasa, de l'Université de Washington, veulent en faire un outil : étant donnés deux modèles indépendants, peut-on permuter l'un pour le transporter dans le bassin de l'autre, puis les moyenner ?
Définir le problème
La mesure reprend la barrière de perte de Frankle et al. :
C'est la perte maximale sur le segment moins la moyenne aux extrémités. Une valeur nulle caractérise l'absence de bosse.
L'objectif est une permutation qui préserve la fonction de B et minimise la barrière entre et . À la couche , une matrice de permutation transforme les poids de B ainsi :
réordonne les unités de sortie de la couche ; ajuste ses entrées à la permutation de la couche précédente.
Les positions d'entrée et de sortie ont un sens et restent fixes : on ne peut échanger arbitrairement les canaux RGB ou les classes pour rapprocher les poids. Seules les dimensions cachées sont permutables, avec tous les biais, paramètres de normalisation et connexions de branches associés. Les deux chemins d'une addition résiduelle exigent des permutations compatibles, plutôt que des réordonnancements indépendants par couche.
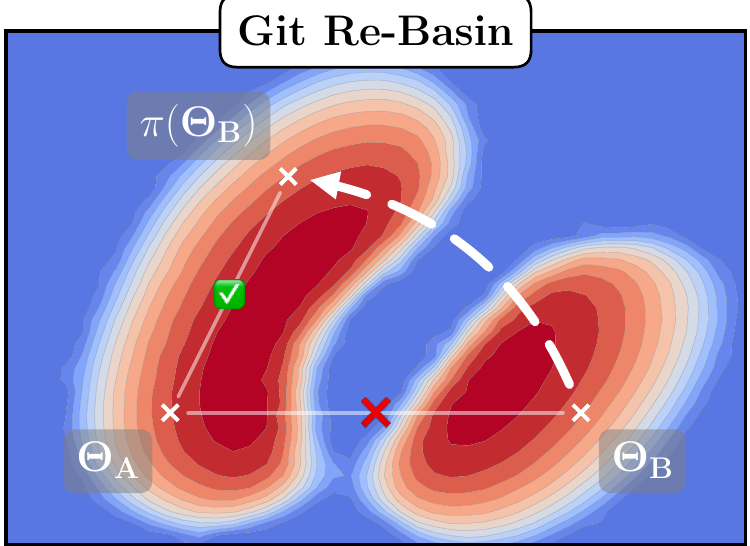
Ce schéma résume l'objectif. Les poids et sont dans des vallées distinctes et leur milieu sort des vallées. Remplacer par l'écriture fonctionnellement identique le place dans le bassin de , avec un milieu qui reste à l'intérieur.
Résoudre le problème
Les auteurs proposent trois méthodes de recherche de permutations.
Apparier les activations
La première est intuitive. Deux modèles du même problème ont probablement appris des caractéristiques semblables à des positions différentes. On fait passer les données d'entraînement dans les deux réseaux et collecte les activations de la couche . On cherche la permutation qui les rapproche :
Le membre de droite est un problème d'affectation linéaire classique, résoluble en temps polynomial, par exemple par l'algorithme hongrois. Les couches sont traitées indépendamment et une passe sur les données suffit.
Apparier les poids
La seconde méthode utilise seulement les poids, sans données.
Dans la première couche, chaque ligne décrit ce qu'observe une unité. Si la ligne de A ressemble à la ligne de B, les deux unités calculent probablement une caractéristique semblable. Prenons trois unités et quatre entrées :
import numpy as np
from scipy.optimize import linear_sum_assignment

# 模型 A 第一層的三個單元,各有 4 個輸入權重
W_A = np.array([[ 1.0, -0.5,  0.2,  0.0],
                [ 0.1,  0.9, -0.8,  0.3],
                [-0.6,  0.0,  0.4,  1.1]])

# 模型 B 學到差不多的三個單元,只是順序換成 (A 的第 2, 0, 1 個),數值也略有不同
W_B = np.array([[-0.5,  0.1,  0.5,  1.0],
                [ 0.9, -0.4,  0.1, -0.1],
                [ 0.2,  1.0, -0.7,  0.2]])

S = W_A @ W_B.T                       # S[i, j]:A 的單元 i 和 B 的單元 j 有多像
print(S.round(2))
rows, cols = linear_sum_assignment(S, maximize=True)
print("A 的單元 i 配到 B 的單元", cols)
[[-0.45  1.12 -0.44]
 [-0.06 -0.38  1.54]
 [ 1.6  -0.61 -0.18]]
A 的單元 i 配到 B 的單元 [1 2 0]
Le maximum de chaque ligne de la matrice de similarité désigne ici la bonne correspondance : l'unité 0 de A rejoint la 1 de B, la 1 rejoint la 2, et la 2 rejoint la 0. La réponse est visible à l'œil dans ce petit exemple. Avec des centaines d'unités et des similarités moins nettes, l'algorithme cherche l'affectation dont la somme totale est maximale.
Il faut ensuite appliquer correctement la permutation. Ajoutons une couche de sortie et comparons B avant et après réordonnancement :
W_out = np.array([[1., -2., 0.5], [0.3, 0.4, -0.7]])
x = np.array([0.2, -0.1, 0.5, 1.0])
before = W_out @ np.maximum(W_B @ x, 0)
W_B_aligned = W_B[cols, :]       # 隱藏層換列
W_out_aligned = W_out[:, cols]  # 下一層的輸入換欄
after = W_out_aligned @ np.maximum(W_B_aligned @ x, 0)
print("換位前後功能相同:", np.allclose(before, after))
換位前後功能相同: True
Aucun modèle n'a encore été moyenné : B a seulement changé d'écriture. L'alignement doit préserver sa sortie ; la moyenne avec A modifiera ensuite la fonction. Vérifier séparément ces deux opérations permet de distinguer une permutation mal appliquée d'une moyenne peu efficace.
La difficulté vient des dépendances entre couches. Une unité est définie par ses poids entrants autant que sortants ; changer la permutation de la couche réordonne aussi les entrées de la couche . L'objectif global devient :
Les auteurs démontrent que cette somme d'affectations bilinéaires est NP-difficile et qu'à partir de trois couches, même une approximation à facteur constant ne possède pas d'algorithme polynomial.
Ils emploient une descente par coordonnées. En fixant les autres couches, l'optimisation de redevient une affectation linéaire ordinaire :
Le premier terme compare les entrées, alignées sur la couche précédente ; le second compare les sorties, alignées sur la suivante. Les couches sont mises à jour dans un ordre aléatoire jusqu'à stabilisation des permutations. En pratique, les auteurs rapportent quelques secondes à quelques minutes.
Chaque changement accepté augmente le produit scalaire global et les permutations possibles sont en nombre fini : la procédure s'arrête. Mais elle rapproche des poids sans minimiser directement la perte sur les données, et son point final ne garantit que l'absence d'amélioration par ces mises à jour. Sur ImageNet, limiter le procédé à un seul balayage donne environ 7 % de top-1 pour le modèle fusionné, contre 51.01 % en répétant jusqu'à convergence. Ne jamais revenir sur une couche déjà traitée fait perdre l'information apportée par les suivantes.
Apprendre la permutation avec un estimateur straight-through
La troisième méthode apprend directement les permutations en minimisant la perte de la moyenne de et de la projection de . La projection sur la permutation la plus proche n'étant pas différentiable, un estimateur straight-through utilise la projection en passe avant, puis fait comme si elle était absente en passe arrière.
C'est la méthode la plus efficace, mais elle exige une boucle d'entraînement complète et coûte bien davantage.
Plus précisément, l'optimiseur conserve une variable libre . À chaque passe avant, il cherche parmi les permutations équivalentes de B celle qui en est la plus proche, , puis calcule la perte de . La projection utilise encore l'appariement des poids. En passe arrière, elle est approximée par l'identité pour transmettre le gradient à . Le résultat livré reste une permutation de B d'origine : la fonction de cette extrémité est préservée.
| Alignement | Données requises ? | Objectif | Coût principal |
|---|---|---|---|
| Activation matching | Oui, représentations intermédiaires | Correspondance des activations par couche | Passes avant et affectations |
| Weight matching | Non | Produit scalaire global des poids | Affectations répétées par couche |
| STE matching | Oui, perte de fusion | Perte d'entraînement du modèle au point milieu | Boucle d'entraînement et projections répétées |
Avec les mêmes données et des architectures compatibles, on peut employer activations ou STE. Sans les données d'origine, l'appariement des poids reste disponible. C'est aussi cette option peu coûteuse que les auteurs utilisent ensuite pour fusionner des modèles entraînés séparément.
Discussion
Une fois les places alignées, le segment devient praticable
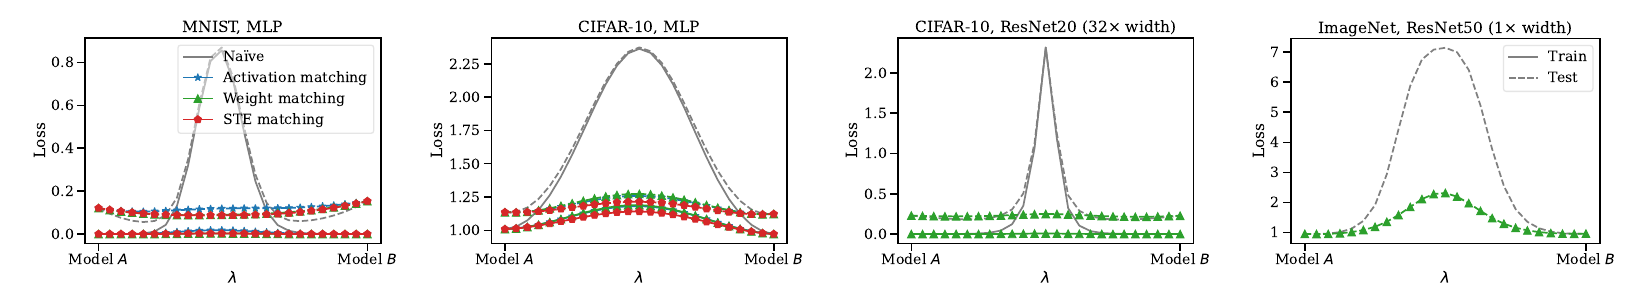
De gauche à droite, modèles et données se complexifient. L'interpolation directe grise présente toujours une montagne ; les trois méthodes d'alignement la réduisent.
Sur MNIST, elles annulent toutes la barrière. Avec poids ou STE, la perte de test devient même convexe : les mélanges centraux dépassent A et B. Sur CIFAR-10, ResNet20 élargi 32 fois atteint aussi une barrière nulle, une première sur ResNet à la connaissance des auteurs. Sur ImageNet, ResNet50 conserve une colline, avec une réduction de 67 % de la barrière.
Les écarts entre méthodes sont modestes. STE est le meilleur et le plus coûteux. L'appariement des poids, sans données et en quelques secondes, fait presque aussi bien que celui des activations. Les auteurs y voient un bon compromis.
Les architectures demandent toutefois attention. Les MLP ont trois couches cachées de 512 unités, ReLU et aucune normalisation. Les VGG et ResNet20 CIFAR utilisent LayerNorm, des recadrages, rotations et retournements, et momentum SGD. Le ResNet50 ImageNet conserve BatchNorm, réestimé pour chaque modèle interpolé. Refaire l'expérience avec un modèle CIFAR BatchNorm standard peut donc produire d'autres courbes.
Les 67 % mesurent une réduction relative de la barrière de perte. La précision top-1 de 51.01 % au milieu sur ImageNet montre qu'une forte réduction peut encore laisser le modèle fusionné loin derrière ses extrémités. La contribution porte surtout sur les conditions d'un alignement à faible barrière ; la fusion sans perte de modèles ImageNet indépendants reste à résoudre.
Plus large, plus facile à relier
Pourquoi la barrière ImageNet subsiste-t-elle ? Les auteurs soupçonnent une largeur insuffisante.
Ils élargissent progressivement VGG-16 et ResNet20 sur CIFAR-10 avant d'apparier les poids. À largeur standard, la connectivité linéaire manque ; en élargissant, la barrière descend jusqu'à 0. Leur hypothèse est qu'une capacité suffisante, notamment en largeur, doit absorber la complexité des données pour que cette connectivité apparaisse.
Pour les réseaux étroits, la recherche de permutation peut être insuffisante, ou d'autres symétries peuvent manquer, comme les changements d'échelle entre couches. Les auteurs présentent les permutations comme une composante nécessaire mais incomplète.
Une propriété acquise pendant l'entraînement
La connectivité apparaît progressivement. Sur les MLP MNIST et CIFAR-10, les auteurs alignent et mesurent la barrière à chaque époque : elle est haute au début, puis diminue.
Ils construisent aussi un contre-exemple : certaines solutions obtenues sans SGD restent sans connexion linéaire quelle que soit la permutation. La conjecture d'Entezari porte précisément sur les solutions SGD ; le contre-exemple suggère donc un rôle du biais de l'optimiseur.
Ce petit réseau a deux entrées et deux couches cachées de deux unités. Deux modèles résolvent parfaitement le même problème, mais placent le traitement de la première et de la seconde dimension dans des couches différentes. Permuter les unités à l'intérieur d'une couche ne déplace pas ce partage du travail entre couches. Toutes les permutations sont énumérables et conservent une barrière. Cette preuve dépasse un simple échec de recherche et souligne l'existence d'autres symétries.
Entraîner séparément, réunir ensuite
La dernière expérience se rapproche d'un usage concret. CIFAR-100 est partagé en deux ensembles : A contient 20 % des exemples des classes 0 à 49 et 80 % de ceux des classes 50 à 99 ; B contient les proportions inverses. Un ResNet20 est entraîné sur chacun.
Leur fusion par appariement des poids réduit la perte sur tout le test par rapport aux deux modèles initiaux, avec moitié moins de mémoire et de calcul que leur ensemble, et améliore la calibration. Elle reste derrière le modèle entraîné sur toutes les données et derrière l'ensemble ; l'interpolation directe est bien pire.
Les données sont disjointes, mais chaque modèle voit les 100 classes, avec des proportions inverses. Le sens des sorties est ainsi cohérent. Les gains portent sur l'entropie croisée et la calibration : la précision de classification ne dépasse pas simultanément les deux modèles initiaux. Il faut conserver cette nuance en décrivant le résultat.
L'annexe étend aussi la méthode à plusieurs modèles. On aligne successivement chaque modèle sur la moyenne des autres, puis on prend la moyenne globale. Avec 32 MLP ayant chacun vu la moitié de MNIST, la calibration approche celle de l'ensemble des sorties et un seul modèle reste à l'inférence. Cet exemple dépasse le cas de deux modèles, tout en restant loin de la taille et de la difficulté des grands modèles de langage actuels.
Conclusion
Git Re-Basin propose une étape concrète avant la moyenne de modèles indépendants : aligner leurs unités. L'appariement des poids ne demande aucune donnée, prend quelques secondes et peut annuler la barrière pour des réseaux suffisamment larges.
La limite est visible aussi : ResNet50 standard sur ImageNet conserve une barrière. REPAIR montrera ensuite que la variance des activations s'effondre dans le modèle moyen aligné, et qu'une remise à l'échelle réduit encore cette barrière.
Les fusions courantes de grands modèles de langage partent souvent d'ajustements d'un même checkpoint préentraîné et en reprennent les coordonnées. Avec des modèles entraînés indépendamment, il faut d'abord résoudre l'alignement étudié ici, puis mesurer ce que la fusion conserve de leurs fonctions.