Article original
Loss Surfaces, Mode Connectivity, and Fast Ensembling of DNNs
- Publication
- NeurIPS 2018Conférence
- Premier dépôt sur arXiv
- arXiv:1802.10026
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelmergingmodeconnectivity2018,
  title = {{Loss Surfaces, Mode Connectivity, and Fast Ensembling of DNNs}},
  author = {Timur Garipov and Pavel Izmailov and Dmitrii Podoprikhin and Dmitry Vetrov and Andrew Gordon Wilson},
  year = {2018},
  eprint = {1802.10026},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1802.10026}
}
Entraînez deux fois le même réseau avec deux graines aléatoires différentes : vous obtiendrez des poids très différents, mais des précisions proches.
Ces deux jeux de poids sont deux points dans l'espace des paramètres. Reliez-les par un segment et évaluez quelques points sur ce segment : le taux d'erreur au milieu est souvent catastrophique. Dans l'exemple de l'article, un VGG-16 sur CIFAR-10 atteint 90 % d'erreur de test au milieu du segment, soit le niveau du hasard pour dix classes.
On imagine donc assez naturellement chaque solution au fond d'une vallée isolée, séparée des autres par de hautes montagnes.
Garipov, Izmailov, Podoprikhin, Vetrov et Wilson, du centre d'IA Samsung de Moscou, de Skoltech, de Cornell et de la Haute École d'économie de Moscou, posent une autre question. Si le chemin droit est impraticable, pourquoi ne pas prendre un virage ?
Définir le problème
Soient et les poids de deux réseaux entraînés indépendamment, et la perte d'entraînement. Leur connexion linéaire s'écrit :
Les auteurs cherchent une courbe dont les extrémités restent fixées en et , dont la forme dépend du paramètre , et dont la perte reste faible sur tout le trajet.
Trouver une telle courbe oblige à revoir l'image des vallées isolées. En cas d'échec, il faut encore distinguer une famille de courbes trop restrictive, une optimisation infructueuse et une réelle difficulté à relier les points ; une seule recherche infructueuse ne permet pas d'écarter tous les autres chemins.
Résoudre le problème
Apprendre la courbe
Chaque point de la courbe est un jeu de poids que l'on peut injecter dans le réseau pour calculer une perte. L'objectif est la perte moyenne sur toute la courbe :
On estime le gradient de cette espérance par échantillonnage. À chaque étape, on tire un dans , on calcule les poids au point correspondant, on évalue la perte sur un mini-lot, puis on effectue une descente de gradient sur . Les extrémités et restent fixes ; seul le paramètre qui détermine la forme de la courbe est appris.
Deux formes de courbes
Les auteurs utilisent deux paramétrisations très simples. La première est une ligne brisée à un seul coude, placé en :
La seconde est une courbe de Bézier quadratique, dont est le point de contrôle :
Dans les deux cas, et donnent exactement les deux extrémités. a la même forme que les poids du réseau : il y a donc autant de paramètres à apprendre que dans un réseau entier.
Calculons le milieu de la courbe de Bézier. Pour , chaque extrémité compte pour , et le point de contrôle pour . Déplacer ce point d'une unité dans une direction déplace donc les poids du milieu d'une demi-unité. Lors de la rétropropagation, le gradient de la perte par rapport au point de contrôle est celui par rapport aux poids courants, multiplié par . Les poids des extrémités ne figurent pas dans l'optimiseur : les deux modèles d'origine restent intacts.
Le principe est le même pour la ligne brisée, avec un multiplicateur qui dépend de la moitié parcourue. L'entraînement de la courbe réutilise ainsi les passes avant et arrière habituelles ; le principal calcul supplémentaire est une combinaison linéaire des poids. Il faut toujours des données d'entraînement, une optimisation supplémentaire et de la mémoire pour un point de contrôle. Trouver un chemin de faible perte a donc un coût bien réel.
Un essai sur un petit réseau
Un petit réseau suffit à voir l'effet. Prenons les 1 797 chiffres manuscrits de 8×8 pixels intégrés à scikit-learn et un MLP à deux couches cachées de 200 unités chacune. On entraîne les deux extrémités sur les mêmes 1 200 images, avec des poids initiaux différents, puis on apprend une courbe de Bézier en initialisant son point de contrôle au milieu du segment :
import torch
import torch.nn as nn
from torch.func import functional_call
from sklearn.datasets import load_digits

X, y = load_digits(return_X_y=True)
X = torch.tensor(X / 16.0, dtype=torch.float32)
y = torch.tensor(y)
perm = torch.randperm(len(X), generator=torch.Generator().manual_seed(0))
idx_train, idx_test = perm[:1200], perm[1200:]

def make(seed):
    torch.manual_seed(seed)
    return nn.Sequential(nn.Linear(64, 200), nn.ReLU(),
                         nn.Linear(200, 200), nn.ReLU(),
                         nn.Linear(200, 10))

def train(model, seed, steps=480):
    opt = torch.optim.SGD(model.parameters(), lr=0.1)
    g = torch.Generator().manual_seed(seed)
    for _ in range(steps):
        b = idx_train[torch.randint(len(idx_train), (50,), generator=g)]
        loss = nn.functional.cross_entropy(model(X[b]), y[b])
        opt.zero_grad(); loss.backward(); opt.step()
    return {k: v.detach() for k, v in model.state_dict().items()}

w1 = train(make(1), seed=10)                 # 兩個端點:同樣的資料,不同的初始權重
w2 = train(make(2), seed=20)
net = make(0)

@torch.no_grad()
def evaluate(w):
    loss = nn.functional.cross_entropy(functional_call(net, w, (X[idx_train],)), y[idx_train]).item()
    acc = (functional_call(net, w, (X[idx_test],)).argmax(1) == y[idx_test]).float().mean().item()
    return f"loss {loss:.3f}, 測試 {acc:.1%}"

def line(t):
    return {k: (1 - t) * w1[k] + t * w2[k] for k in w1}

theta = {k: v.clone().requires_grad_(True) for k, v in line(0.5).items()}   # 彎點從直線中點出發

def bezier(t):
    return {k: (1 - t) ** 2 * w1[k] + 2 * t * (1 - t) * theta[k] + t ** 2 * w2[k] for k in w1}

opt = torch.optim.SGD(theta.values(), lr=0.1)
g = torch.Generator().manual_seed(0)
for _ in range(1200):
    t = torch.rand((), generator=g).item()   # 每一步隨機抽一個 t
    b = idx_train[torch.randint(len(idx_train), (50,), generator=g)]
    loss = nn.functional.cross_entropy(functional_call(net, bezier(t), (X[b],)), y[b])
    opt.zero_grad(); loss.backward(); opt.step()   # 只更新彎點 theta,端點不動

for t in [0, 0.25, 0.5, 0.75, 1]:
    print(f"t={t:<4}  直線: {evaluate(line(t))}  |  曲線: {evaluate(bezier(t))}")
t=0     直線: loss 0.119, 測試 95.5%  |  曲線: loss 0.119, 測試 95.5%
t=0.25  直線: loss 0.415, 測試 93.6%  |  曲線: loss 0.142, 測試 95.5%
t=0.5   直線: loss 0.949, 測試 88.9%  |  曲線: loss 0.156, 測試 95.3%
t=0.75  直線: loss 0.420, 測試 95.0%  |  曲線: loss 0.140, 測試 95.3%
t=1     直線: loss 0.119, 測試 94.8%  |  曲線: loss 0.119, 測試 94.8%
functional_call permet de fournir directement des poids externes à une même architecture : chaque point de la courbe peut être évalué ainsi. La perte vaut 0.119 aux deux extrémités. Au milieu du segment, elle monte à 0.949 ; au milieu de la courbe apprise, elle reste à 0.156, avec une précision de test proche de 95 %.
Ce réseau est petit et le mur sur le segment reste relativement bas. Les réseaux de l'article sont bien plus grands, et leurs murs bien plus hauts.
Discussion
Les courbes sur de grands réseaux
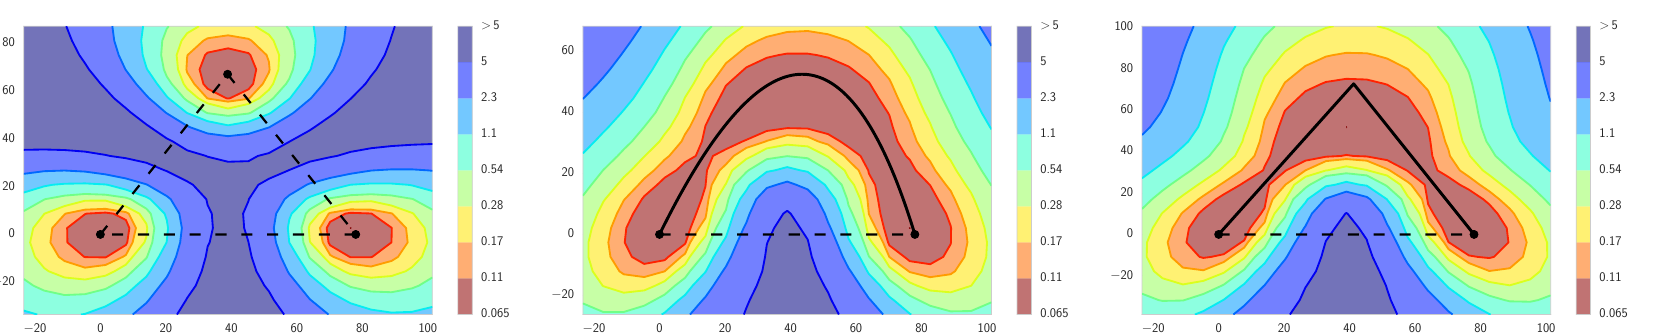
Cette figure montre la perte d'entraînement de ResNet-164 sur CIFAR-100. Chaque panneau est une coupe bidimensionnelle de l'espace des paramètres. L'axe horizontal passe par deux solutions ; le rouge désigne une faible perte et le bleu une forte perte.
À gauche, le plan est défini par trois solutions entraînées indépendamment. Chacune occupe une zone rouge, séparée des autres par du bleu : on retrouve l'intuition des vallées isolées. Au centre et à droite, le plan contient la courbe apprise. Un passage rouge relie alors les deux solutions du bas, tandis que le segment pointillé qui les joint traverse toujours le bleu.
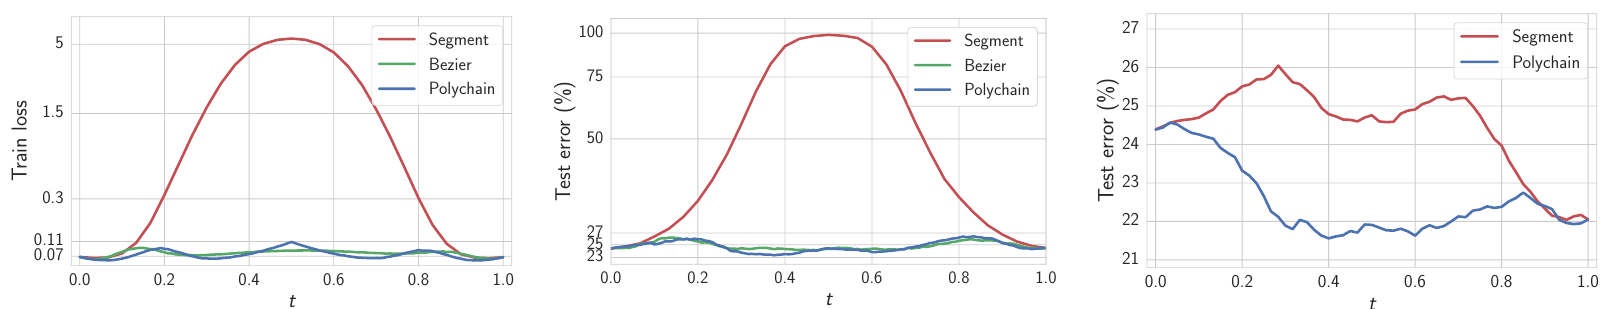
La Figure 2 représente la même expérience sous forme de courbes. Dans les panneaux de gauche et du centre, le rouge correspond au segment : perte d'entraînement et erreur de test explosent au milieu. La courbe de Bézier en vert et la ligne brisée en bleu restent presque plates.
La hauteur du mur dépend de l'architecture. Sur CIFAR-10, VGG-16 atteint 90 % d'erreur de test au milieu du segment. ResNet-158 et Wide ResNet-28-10 atteignent au pire 80 % et 66 %. Pour les auteurs, cela rejoint les observations antérieures d'un paysage de perte plus régulier pour les réseaux résiduels que pour des architectures classiques comme VGG.
Le chemin n'est pas unique non plus. Pour les mêmes extrémités, deux lignes brisées apprises avec des graines différentes sur VGG-16 ont des coudes distants de 29.6, contre 50 entre les extrémités.
Sur la courbe, chacun fait ses propres prédictions
Si la perte reste faible partout, les points de la courbe seraient-ils simplement des écritures différentes du même modèle ?
Le graphique de droite apporte une réponse. On construit un ensemble de deux modèles en moyennant les sorties de l'extrémité et d'un point . En avançant sur la ligne brisée, son erreur commence à baisser vers . Pour , il fait aussi bien que l'ensemble des deux extrémités entraînées indépendamment. Un petit déplacement suffit donc à obtenir un modèle qui conserve une bonne précision tout en produisant des prédictions sensiblement différentes.
Si les points ne faisaient que réécrire la même fonction, par exemple en compensant les échelles des poids de part et d'autre d'une ReLU, l'ensemble n'apporterait aucun gain. L'annexe montre aussi comment construire de telles courbes sans intérêt pour l'ensemble.
De la courbe à l'ensemble
Cette observation conduit à la seconde contribution de l'article : Fast Geometric Ensembling, ou FGE.
Puisqu'un petit déplacement autour d'une solution permet de trouver d'autres bons modèles, on peut éviter d'apprendre explicitement une courbe. FGE commence par un calendrier d'apprentissage habituel pendant environ 80 % du budget, puis utilise des cycles très courts de 2 à 4 époques. Un taux élevé fait sortir du creux, un taux faible y ramène ; on sauvegarde les poids à chaque minimum du taux, puis on combine les prédictions des modèles sauvegardés.
La différence avec Snapshot Ensembles tient à l'ampleur des déplacements. Snapshot Ensembles utilise des cycles de 20 à 40 époques dès le début ; FGE réserve les cycles courts à la fin. Sur Preactivation-ResNet-164 et CIFAR-100, la distance euclidienne entre deux sauvegardes FGE est d'environ 7, contre environ 40 pour Snapshot Ensembles.
Le résultat ImageNet est parlant. À partir d'un ResNet-50 préentraîné dont l'erreur top-1 vaut 23.87 %, les auteurs ajoutent 5 époques de FGE avec des cycles de 2 époques. L'ensemble final de 4 modèles, modèle initial compris, atteint 23.31 % d'erreur, soit un gain de 0.56 point.
FGE reste un ensemble : chaque modèle doit être exécuté à l'inférence.
Le cycle et les points de sauvegarde
Regardons d'abord la moitié gauche de la figure originale : de haut en bas, elle montre le taux d'apprentissage, l'erreur de test et la distance dans l'espace des paramètres au point de départ. Les cercles noirs indiquent les sauvegardes. À droite, les résultats sont comparés à budget d'entraînement égal : les croix désignent les instantanés seuls, et les losanges reliés les ensembles.
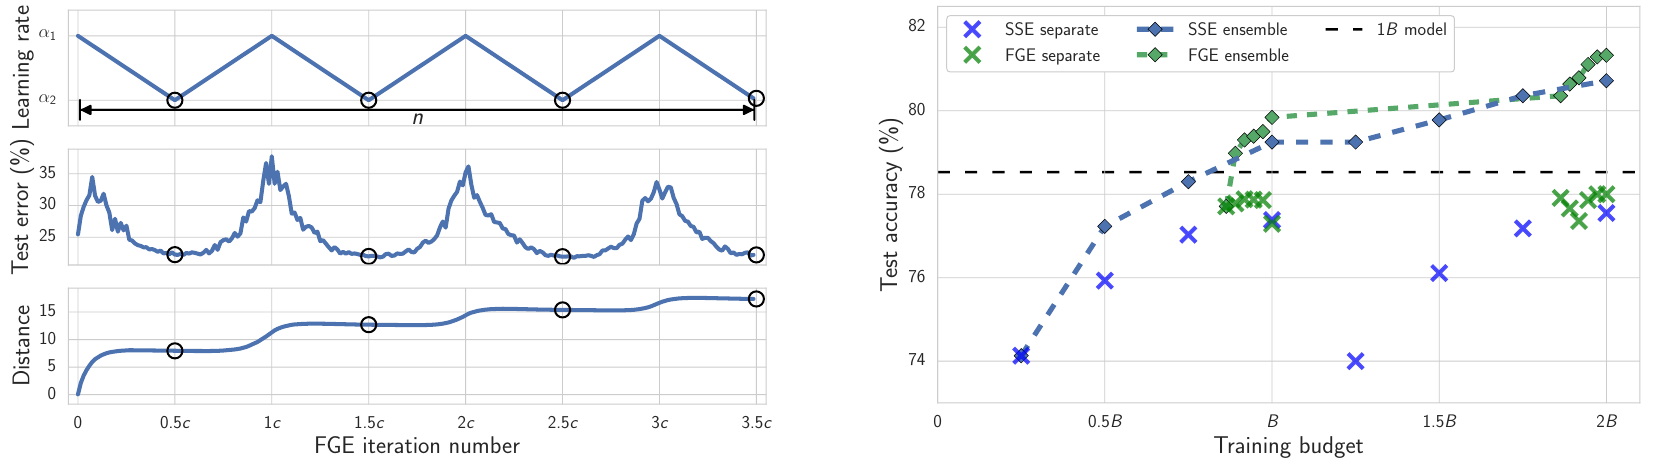
Le taux d'apprentissage FGE suit un triangle. Un cycle comporte un nombre pair de mises à jour par mini-lots ; désigne la position dans le cycle et ses bornes :
Le taux descend de la borne haute à la borne basse, puis remonte. La sauvegarde intervient au milieu du cycle, à , lorsque le taux vaut . Près de la borne haute, l'erreur peut temporairement augmenter ; les auteurs conservent les poids après leur retour dans une zone de faible erreur.
Sur CIFAR, VGG utilise des cycles de 2 époques, avec et ; ResNet et WRN utilisent 4 époques, avec et . Par exemple, pour un budget standard de ResNet de époques, on suit le calendrier habituel jusqu'à l'époque 125, puis on collecte 6 modèles entre les époques 126 et 147. Ces instantanés partagent toute la trajectoire précédente, ce qui évite de répéter des entraînements depuis zéro.
On voit aussi la différence de rôle entre la recherche de courbe et FGE. La première partie fixe deux extrémités et apprend un coude pour vérifier l'existence d'un passage de faible perte. FGE part d'un seul modèle et explore les solutions voisines avec des cycles courts. Son exécution ne demande ni seconde extrémité préentraînée ni courbe de Bézier apprise au préalable.
Quel gain à budget égal ?
Pour comparer des ensembles, il faut distinguer le budget d'entraînement et le nombre de modèles à l'inférence. Dans l'article, est le nombre d'époques nécessaires à la convergence d'un modèle avec la méthode habituelle ; correspond au double. Voici les résultats sur CIFAR-100 pour , en erreur de test : plus bas est meilleur.
| Architecture | Entraînement indépendant Ind | Snapshot Ensembles | FGE |
|---|---|---|---|
| VGG-16, | 27.4 ± 0.1 | 26.4 ± 0.1 | 25.7 ± 0.1 |
| Preactivation ResNet-164, | 21.5 ± 0.4 | 20.9 ± 0.2 | 20.2 ± 0.1 |
| WRN-28-10, | 19.2 ± 0.2 | 17.9 ± 0.2 | 17.7 ± 0.2 |
Erreur de test (%), d'après la Table 1 de l'article. Le budget est identique au sein d'une ligne ; le nombre de modèles exécutés dépend de la méthode.
FGE dépasse Snapshot Ensembles dans les trois cas, avec un gain de 0.7 point pour VGG et ResNet. À , WRN sur CIFAR-100 obtient 17.48 % pour Ind, 17.30 % pour SSE et 16.95 % pour FGE. Mais sur CIFAR-10, avec WRN et , Ind obtient 3.31 % contre 3.52 % pour FGE. L'avantage dépend donc du jeu de données, de l'architecture et du budget.
Les auteurs mesurent aussi la diversité des prédictions. Sur CIFAR-100 avec ResNet-164, deux modèles indépendants prédisent des classes différentes pour 19.97 % des images de test, contre 14.57 % pour deux instantanés d'une même exécution FGE. Un instantané FGE est légèrement moins précis : environ 78.0 %, contre environ 78.5 % pour un modèle entraîné indépendamment. Le gain vient du nombre plus élevé d'instantanés utiles obtenus dans le même temps, qui compense leur précision et leur diversité un peu plus faibles.
Reste BatchNorm. Quand les poids changent sur la courbe, la distribution des activations intermédiaires change aussi. Dans l'annexe, les auteurs réestiment les statistiques des réseaux qui utilisent BatchNorm avant de mesurer la perte. Conserver les moyennes et variances accumulées d'une extrémité peut ajouter une inadéquation statistique au mur observé. Avant d'examiner le paysage, chaque point doit correspondre à un réseau capable d'inférer correctement.
Conclusion
Avec un entraînement très simple, cet article relie deux solutions indépendantes par une ligne à un seul coude. Sa perte reste presque constante, alors que le segment direct rencontre un mur élevé.
L'image des vallées isolées cède la place à des solutions reliées par des passages de faible perte, mais courbes. Cela explique aussi l'échec d'une moyenne directe entre deux réseaux entraînés indépendamment : elle emprunte précisément le segment.
Le coût d'inférence de FGE laisse une question ouverte. Deux semaines plus tard, les mêmes auteurs présentent SWA : les poids sauvegardés sont directement moyennés pour former un seul modèle.