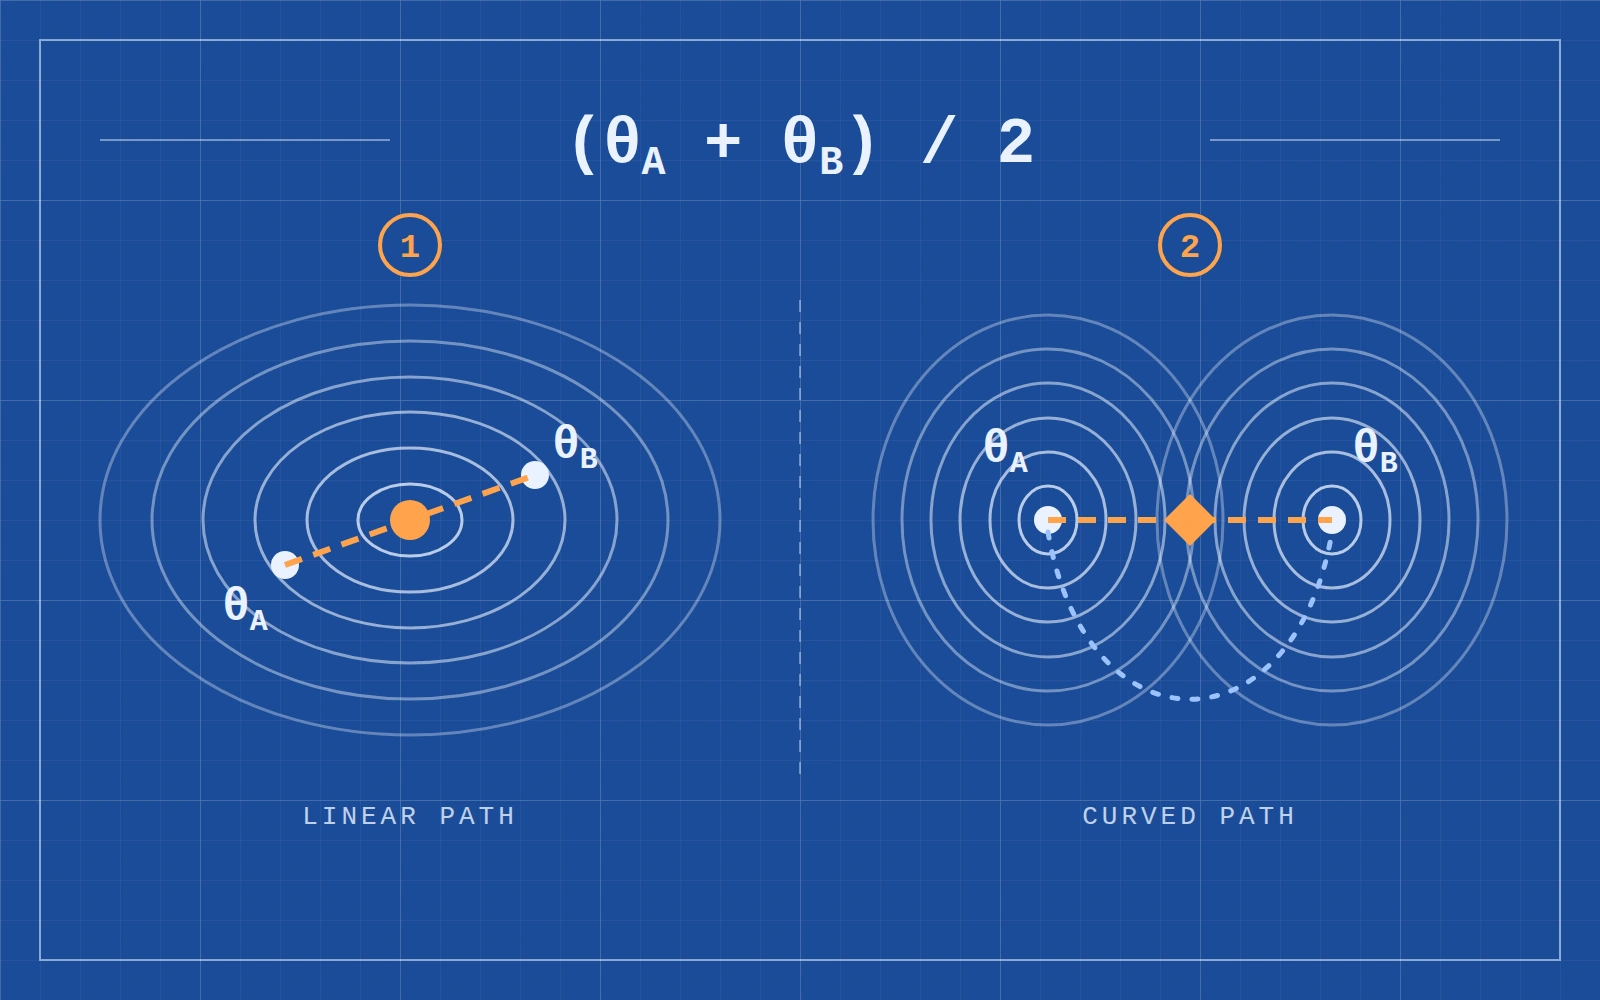
2016 年 2 月、Google の Brendan McMahan らは、後に FedAvg と呼ばれる連合学習アルゴリズムを arXiv で提案した。各端末は自分のデータでモデルを訓練し、サーバーは戻ってきた重みを平均する。
明らかな懸念があった。ニューラルネットワークの損失関数は凸ではない。著者ら自身も、パラメータ空間で二モデルを平均した結果は、いくらでも悪くなりうると書いている。
そこで小さな実験を行った。隠れ層が二つの MNIST 分類器を二つ用意し、重ならない各 600 枚の手書き数字で 240 ステップ訓練する。重みを比率を変えて混ぜ、全訓練集合での損失を測った。
初期重みの乱数シードが異なると、中間で損失が大きく跳ね上がる。同じシードにすると、平均モデルの損失は両方の親より低くなった。FedAvg Figure 1
まず実測の曲線を見よう。横軸は混合比率、縦軸は MNIST 全訓練集合の損失だ。左右で縦軸の尺度は異なる。左は中間に山ができ、右の中間は両端より低い。
論文第 2 節の、小さな図一枚の観察だった。
8 年後、Hugging Face の Open LLM Leaderboard 上位は、マージしたモデルで埋まった。コミュニティの解説は「GPU 不要」で新モデルを安く作れると紹介する。2024 年 3 月には、運営がマージモデルを既定で非表示にしていた。
さらに一年後、Cohere は六つの専門モデルを加重平均し、1,110 億パラメータの Command A を作った。各専門モデルに対する平均低下は 1.8% だけだった。2026 年 4 月、DeepSeek-V4 も専門モデル群を先に訓練したが、最後は蒸留で一つへ教え込むことを選んだ。技術報告は、重みマージでよくある性能低下を避けられると述べる。
この記事は、あの小さな図から始める。まずノート PC で二モデルを平均し、どう壊れ、どう直るかを見る。その後、時間をたどり、「足して 2 で割る」が連合学習の小実験からランキングの錬金術へ、さらに各社の訓練工程へ進んだ道を見ていこう。
前半は原理だ。異なる起点で平均できない理由と、整列や共通の起点による解決を見る。
後半は応用で、微調整モデルのスープとタスクベクトルから、ランキングと各社の訓練工程へ進む。
まずノート PC で平均してみる
FedAvg の設定を再現してみよう。MNIST は scikit-learn 付属の digits に替える。1,797 枚の 8×8 手書き数字で、追加ダウンロードは不要だ。モデル、学習率、バッチサイズ、ステップ数は論文に合わせ、各 200 ユニットの二つの隠れ層、学習率 0.1、バッチ 50 で 240 ステップ訓練する。
import torch
import torch.nn as nn
from sklearn.datasets import load_digits

X, y = load_digits(return_X_y=True)                    # 1,797 張 8×8 的手寫數字
X = torch.tensor(X / 16.0, dtype=torch.float32)
y = torch.tensor(y)
perm = torch.randperm(len(X), generator=torch.Generator().manual_seed(0))
idx_a, idx_b, idx_test = perm[:600], perm[600:1200], perm[1200:]

def make(seed):
    torch.manual_seed(seed)                            # 種子決定初始權重
    return nn.Sequential(nn.Linear(64, 200), nn.ReLU(),
                         nn.Linear(200, 200), nn.ReLU(),
                         nn.Linear(200, 10))

def train(model, idx, seed):
    opt = torch.optim.SGD(model.parameters(), lr=0.1)
    g = torch.Generator().manual_seed(seed)            # 種子決定資料順序
    for epoch in range(20):                            # 600 張、批次 50,共 240 步
        order = idx[torch.randperm(len(idx), generator=g)]
        for b in order.split(50):
            loss = nn.functional.cross_entropy(model(X[b]), y[b])
            opt.zero_grad()
            loss.backward()
            opt.step()
    return model
make のシードが初期重み、train のシードがデータ順序を決める。重ならない各 600 枚を訓練に使い、残り 597 枚をテストに残す。
小さな道具を二つ書く。mix は比率 で重みを混ぜる。
なら足して 2 で割る。evaluate は二つの訓練集合を合わせた損失と、テスト精度を返す。
def mix(m1, m2, t):
    sd1, sd2 = m1.state_dict(), m2.state_dict()
    merged = make(0)
    merged.load_state_dict({k: t * sd1[k] + (1 - t) * sd2[k] for k in sd1})
    return merged

@torch.no_grad()
def evaluate(model):
    seen = torch.cat([idx_a, idx_b])                   # 兩份訓練資料合起來
    loss = nn.functional.cross_entropy(model(X[seen]), y[seen]).item()
    acc = (model(X[idx_test]).argmax(1) == y[idx_test]).float().mean().item()
    return f"loss {loss:.3f}, 測試 {acc:.1%}"

for name, seed_a, seed_b in [("不同起點", 1, 2), ("同一起點", 1, 1)]:
    A = train(make(seed_a), idx_a, seed=10)
    B = train(make(seed_b), idx_b, seed=20)
    print(name)
    print("  A   :", evaluate(A))
    print("  B   :", evaluate(B))
    print("  平均:", evaluate(mix(A, B, 0.5)))
不同起點
  A   : loss 0.264, 測試 92.1%
  B   : loss 0.270, 測試 93.0%
  平均: loss 1.277, 測試 83.4%
同一起點
  A   : loss 0.264, 測試 92.1%
  B   : loss 0.266, 測試 93.3%
  平均: loss 0.252, 測試 93.6%
異なる起点の二モデルは、それぞれテスト精度が約 92%、93% あるのに、平均すると 83.4% に落ち、損失は約 0.27 から 1.277 に跳ね上がる。
同じ起点では、平均の損失は 0.252 で、A の 0.264、B の 0.266 より低い。テスト精度 93.6% も両方の親モデルより高い。それぞれ半分のデータしか見ていないのに、平均すると両集合を合わせた訓練データで両方よりよい。小データで、FedAvg の右の図の傾向を再現できた。
ただし、ここでは分けて訓練し、一度平均しただけだ。完全な FedAvg は平均モデルを端末へ戻し、各々数ステップ更新して回収し、データ量で加重する処理を反復する。この例はデータ量が等しいため半分ずつでよいが、異なれば比率も変える。一回分を理解してから、多ラウンドの連合訓練を見るとわかりやすい。
を 0 から 1 まで動かして曲線にしよう。
五組のシードでも傾向は同じだった。平均すると、親モデルのテスト精度は 92.9%、異なる起点の直接平均は 80.2%、同じ起点の平均は 93.6%。機械や PyTorch の版によって、小数点以下は少し変わりうる。
同じネットワークの順番を変える
異なる起点ではなぜ平均できないのか。さらに極端な例を見よう。
隠れ層の 200 ユニットに固定の順序はない。3 番と 7 番を入れ替えても、次層が入力を読む位置も一緒に変えれば、計算結果はまったく同じだ。重み行列の行を入れ替えても、関数は変わらない。
この置換対称性は Hecht-Nielsen が 1990 年に論じている。Git Re-Basin §1
このネットワークは各 200 ユニットの二層だけで、 通り、約 の表現がある。どれも同じモデルだ。
では A と「順序を乱した A」を平均しよう。
def permute(model, p1, p2):
    sd = {k: v.clone() for k, v in model.state_dict().items()}
    sd["0.weight"], sd["0.bias"] = sd["0.weight"][p1], sd["0.bias"][p1]  # 第一層的 200 個單元換位
    sd["2.weight"] = sd["2.weight"][:, p1]                              # 下一層讀輸入的順序跟著換
    sd["2.weight"], sd["2.bias"] = sd["2.weight"][p2], sd["2.bias"][p2]  # 第二層的 200 個單元換位
    sd["4.weight"] = sd["4.weight"][:, p2]
    out = make(0)
    out.load_state_dict(sd)
    return out

A = train(make(1), idx_a, seed=10)
g = torch.Generator().manual_seed(100)
A2 = permute(A, torch.randperm(200, generator=g), torch.randperm(200, generator=g))

print(torch.allclose(A(X), A2(X), atol=1e-5))         # 每一張圖的輸出都一樣嗎?
print("A   :", evaluate(A))
print("A2  :", evaluate(A2))
print("平均:", evaluate(mix(A, A2, 0.5)))
True
A   : loss 0.264, 測試 92.1%
A2  : loss 0.264, 測試 92.1%
平均: loss 1.215, 測試 84.3%
True は全 1,797 枚の出力が十万分の一以内の誤差で一致することを示し、精度も両方 92.1%。それでも足して 2 で割ると 84.3% に落ちる。
自分自身との平均でも壊れる原因は、対応位置だ。A の 3 番は A2 の 3 番と平均されるが、後者は元の A の別ユニットで、異なる特徴を担当する。無関係な検出器を半分ずつ混ぜると、どちらでもないものになりやすい。
異なるシードで訓練した二モデルも似ている。似た特徴を、異なる位置で学んだ可能性がある。
整列してから平均する
順番が問題なら、先にそろえよう。Entezari らは 2021 年、全置換を考慮すれば、SGD の解の多くは直線で混ぜても障壁がないという大胆な予想を示した。Entezari ら
2022 年の Git Re-Basin は置換探索を提案した。単純な重み照合(weight matching)はデータ不要だ。各層で A、B の全ユニット対の類似度を計算し、線形割当問題を解いて、合計が最大の一対一対応を求める。古典的にはハンガリー法で解ける。入力重み、バイアス、次層へ送る重みを比較し、二層の置換が依存するため何巡か繰り返す。
from scipy.optimize import linear_sum_assignment

def match(ref, other, iters=20):
    a, b = ref.state_dict(), other.state_dict()
    p1, p2 = torch.arange(200), torch.arange(200)
    for _ in range(iters):
        # 第一層:比對每個單元的輸入權重、偏差,以及它送往下一層的權重
        s1 = (a["0.weight"] @ b["0.weight"].T
              + torch.outer(a["0.bias"], b["0.bias"])
              + a["2.weight"].T @ b["2.weight"][p2])
        p1 = torch.as_tensor(linear_sum_assignment(s1.numpy(), maximize=True)[1])
        # 第二層:同樣的比對,輸入端改用剛排好的 p1
        s2 = (a["2.weight"] @ b["2.weight"][:, p1].T
              + torch.outer(a["2.bias"], b["2.bias"])
              + a["4.weight"].T @ b["4.weight"])
        p2 = torch.as_tensor(linear_sum_assignment(s2.numpy(), maximize=True)[1])
    return permute(other, p1, p2)

A = train(make(1), idx_a, seed=10)
B = train(make(2), idx_b, seed=20)
B2 = match(A, B)
print(torch.allclose(B(X), B2(X), atol=1e-5))         # 換位不改變 B 的功能
print("直接平均  :", evaluate(mix(A, B, 0.5)))
print("對齊後平均:", evaluate(mix(A, B2, 0.5)))
True
直接平均  : loss 1.277, 測試 83.4%
對齊後平均: loss 0.383, 測試 91.6%
置換後の B2 の出力は B と同じだ。A と平均すると精度は 83.4% から 91.6%、損失は 1.277 から 0.383 へ戻る。先ほどの水色の曲線で、中間の山がかなり低くなった。
五シード平均も 80.2% から 92.2% へ回復する。大部分を救うが、同じ起点の 93.6% には少し届かず、損失も両方の親モデルを下回らない。
Git Re-Basin は大きなモデルでも似た傾向を見る。CIFAR-10 で ResNet-20 の幅を 32 倍にすると、独立訓練した二モデルの整列後に障壁ゼロを達成した。著者らの知る限り初めての例だ。ImageNet の標準幅 ResNet-50 では 67% 減るがゼロにはならない。広いほど整列後につながりやすい。Git Re-Basin
下の曲線は成功と限界を並べる。灰色は直接補間、緑は weight matching。三つ目の広い ResNet-20 はほぼ平らだが、右端の標準 ResNet-50 は盛り上がりが残る。実線が訓練損失、破線がテスト損失なので、片方だけを見てはいけない。
CIFAR は正規化を LayerNorm に変え、ImageNet は BatchNorm を保って補間後に統計量を推定し直す。整列ではバイアス、正規化、残差分岐も一緒に扱う必要があり、各層の行だけを並べ替えても完了しない。この MLP はそれらがないからこそ、数十行で実行できる。
この道は通れるが、各層で割当を解く必要があり、十分な幅も要る。
同じ起点から出発する
もう一つの道は、訓練経路の一部を共有し、置換探索を省くことだ。
FedAvg は同じ初期重みを使った。2019 年に Frankle らは、ネットワークを複製し、異なるデータ順序と拡張で訓練を続け、終点間の直線の障壁を体系的に調べた。初期化から障壁がないのは最小の MNIST ネットワークだけで、他は少し一緒に訓練する必要がある。CIFAR-10 の ResNet-20 は全体の約 3%、ImageNet の ResNet-50 は 20%。その後は、抽出した複数の訓練の終点が線形につながる領域へ入った。Frankle ら §1
「安定」は、終点間の最大誤り率から両端の平均を引いた値が 2 ポイント未満という定義だ。ResNet-20 が初めて満たす時点のテスト誤り率はまだ約 25% で、最後には 8.3% になる。学習は未完了でも、その後の終点を直接混ぜやすくなる。初期化の共有と、訓練経路の共有は分けて考える必要がある。
複製時点を横軸に沿って遅らせると、次の五図になる。縦軸は不安定性で、赤がテスト、紫が訓練。LeNet は最初からほぼゼロ、他は経路の共有が必要だ。前三図は iteration、後二図は epoch で、時間単位も一緒に読む。
この小さな MLP も最小の部類だろう。先の実験は同じシードだけで十分だった。
別の谷も完全に隔絶しているとは限らない。2018 年、Garipov らと Draxler らは独立に、独立訓練した二解の間に損失がほぼ一定の曲がった道を見つけた。直線では高い壁に当たり、上図右の破線のように回り道が必要だ。Garipov ら、Draxler ら
元の図の色は実測損失だ。左の三つの独立解の間は直線が高損失領域を通る。中央のベジェ曲線と右の折れ線は低損失領域で両端をつなぐ。新たに学習したのは経路であり、両端の中点の位置を動かしてはいない。
同年、Garipov の共同著者 Izmailov らが SWA を提案した。同じ訓練の複数時点を平均する。比較的高い固定学習率や循環学習率で SGD に谷底近くを歩かせ、通った重みを等しく平均する。論文は、SGD 軌跡の重み平均を Ruppert の 1988 年の仕事までさかのぼる。ImageNet の ResNet-50 に訓練後 10 エポックの SWA を加えると、top-1 は 76.15% から 76.97%。平均点が平坦な領域へ入るため汎化がよくなる、と著者らは考える。SWA Table 2
CIFAR-100/ResNet-164 の断面が説明を具体化する。左の三つの×は FGE 標本で、平均点は中央だ。中央はテスト誤り率、右は訓練損失を見る。SGD と SWA の相対性能は異なり、訓練損失の最小点とテスト誤り率の最小点は一致するとは限らない。
三者の役割は異なる。モード連結性は回り道の存在を示し、その探索には訓練が要る。線形モード連結性は直線も通れることを求め、重み平均へ直接つながる。SWA は同じ軌跡の近傍点を集め、デプロイするモデルを一つにまとめる。曲がった通路だけなら、端点の平均は通路外へ落ちることがある。
SWA は重み平均がアンサンブルに近い理由も局所的に説明する。checkpoint の平均を 、偏差を とすれば 。その近くで出力を展開すると、
一次項が相殺され、出力アンサンブルとの差は二次項になる。近い checkpoint なら一モデルでアンサンブルを近似できる理由だ。遠く離れるか、近傍の非線形性が強ければ、二次項を無視できない。BatchNorm 統計量も平均モデルに合わせて再推定する。近さと線上の性能を確かめて初めて、導出を実装へつなげられる。
共通の起点を身近にしたのは事前訓練モデルだ。Neyshabur らは 2020 年、同じ事前訓練重みから微調整したモデルは同じ盆地に残り、特徴も似てパラメータも近いと観察した。ランダム初期化ではこの性質がない。Neyshabur ら
同じ CLIP、同じ Llama から出発する微調整モデルは、共通の起点を持つ兄弟になる。マージの主な舞台は、ここから微調整へ移る。
一鍋のスープ
通常は異なるハイパーパラメータで一群を訓練し、検証集合で最良の一つを選んで残りを捨てる。
2021 年の WiSE-FT は単純な形から始めた。ゼロショット CLIP は分布シフトでも比較的頑健だが、微調整後は ImageNet が強く、シフト後は弱くなる。両者の重みを線形に混ぜると、五つの ImageNet 派生シフトで従来法より 4~6 ポイント、ImageNet 自体も 1.6 ポイント改善し、推論コストは変わらなかった。WiSE-FT
六データセットの曲線を直接見よう。横軸 がゼロショット、 が微調整後で、ピンクの線が中間の重みだ。水平の点線はよいほうの端点。最良点が中間にあるデータセットは複数あるが、位置は異なり、一係数ですべての分布を自動的に最適化できない。
2022 年の Model Soups は「捨てていた一群」を使う。CLIP ViT-B/32 をランダム探索で ImageNet 上 72 回微調整した結果は、
- 最良の単一モデル:80.38%
- 全 72 モデルの平均(uniform soup):79.97% で、最良より低い
- 貪欲スープ(greedy soup):81.03%
- 72 モデルの出力アンサンブル:81.19% だが、推論は 72 回
原表の ImageNet 列の数値だ。右の Dist. shifts は五シフトの平均で、そちらでは uniform soup が greedy soup より高い。選択用の検証データによって、得意なテストも変わる。
貪欲スープは素朴だ。検証精度順に並べ、最良から一つずつ加えて試す。検証精度が下がらなければ残し、下がれば飛ばす。大きすぎる学習率などで別の盆地へ入ったモデルは、全平均を悪くするが、貪欲スープでは鍋に入れずに済む。
この CLIP は最後に 5 メンバーを残した。すでに 個なら候補は 。毎回半分ずつでは、後から入れたモデルが重くなる。ImageNet 訓練集合の約 2% で配合を選び、公式 validation はテストに残す。試すたび新候補の評価は必要だが、逆伝播は要らない。
保証は選択用データで低下しないことに限られ、テストは別途測る。出力アンサンブルには確率較正の利点もあり、論文のスープには同じ改善がなかった。一モデルの分類精度を重視するなら魅力的だが、確率で拒答や人手確認を決めるなら較正も比較したい。
JFT-3B 事前訓練の ViT-G/14 では、58 微調整モデルから 14 個を選び、ImageNet 90.94% に達した。当時の最高 CoAtNet-7 の 90.88% を超え、推論計算量は 25% 少ない。Model Soups Table 1、Table 3
ここまでのスープは全モデルが同じタスクを解く。次は異なるタスクを一鍋に入れる。
タスクベクトル
2022 年末、Ilharco らは微調整を一つの方向として捉えた。事前訓練重み とタスク A の微調整重み の差を取る。
はタスクベクトル(task vector)で、各重みの移動方向と量を記録する。これで算術ができる。
複数のベクトルを足して同時処理を試み、符号を反転して加えるなら、対応能力を下げつつ他行動を保てるか試す。 は保留した検証データで選ぶ。
CLIP の八画像分類タスクは、車種、テクスチャ、衛星画像、住所の数字などだ。二つを足すと対象二タスクで専門モデルの精度の平均 98.9% を保ち、八ベクトルから選べる最良のマルチタスクモデルは 91.2%。全八タスクのデータによる直接の微調整は 99.4% だった。マージは再訓練と元データの取得を省くが、能力差は残る。Task Arithmetic §4、付録 D
ViT-L/14 の下図は、各タスクの精度を専門モデルで割り、八タスクで平均する。淡い点がベクトル部分集合、濃い折れ線が個数別の平均だ。追加で全体能力は上がるが、各専門モデルが解く 1.0 までは差がある。
減算も有効だ。有害コメントで微調整した GPT-2 Large のベクトルを引くと、固定プロンプトからの 1,000 生成の毒性判定率は 4.8% から 0.8%、WikiText-103 の perplexity は 16.4 から 16.9 になる。指定評価での行動変化であり、特定情報の削除を確かめるには別の検証が要る。Task Arithmetic §3
なぜ足せるのか。Ortiz-Jimenez らは 2023 年、異なるベクトルが入力空間の重ならない領域へ作用する、重みの「分離性」が重要だと考えた。ランダム初期化 ViT で同じことをすると、加算後のマルチタスク精度は当てずっぽう程度になる。この対照は、事前訓練が分離の構造を与えることを支える。Ortiz-Jimenez ら §6.2
FedAvg の図と同じく、起点が共通である必要があり、できれば事前訓練した起点がよい。
起点が同じなら座標も共通だが、各位置の変更は重なる。CLIP の多くのタスクベクトルのコサイン類似度は 0.01~0.03、MNIST と SVHN のような近いタスクは約 0.18 だった。ほぼ直交することは干渉が小さい理由の手がかりになるが、各変更が出力へどう作用するかも必要だ。次の TIES は全体のタスクベクトルがほぼ直交しても、局所のパラメータが衝突する場合を扱う。
パラメータのけんか
91.2% は専門モデルに対する保持率だった。別の小さな設定を見ると、TIES-Merging の CLIP ViT-B/32 は八タスクの個別微調整で平均精度 90.5%。タスク算術で一つにすると、検証で係数を選んでも 70.1% になる。元の精度で見ても、八能力の保持は難しい。TIES-Merging Table 1
ViT-B/32 列を読むと、専門モデルが 90.5、検証ありのタスク算術が 70.1、TIES が 73.6。上半分と下半分は Validation の条件が異なり、70.1 と上の 60.4 を同じ条件の比較に混ぜてはいけない。
Yadav らは二つの干渉を挙げる。冗長性では、わずかな微調整変更がほぼ役立たず、混合時に他者の大きな変更を薄める。符号衝突では、A が増やし B が減らす同じパラメータが打ち消し合う。二モデルでも衝突し、増やすほど衝突するパラメータが増えた。TIES-Merging §3
説明用の三タスク、六パラメータで計算しよう。
import numpy as np

tau = np.array([[ 0.8, -0.1,  0.5,   0.02, -0.6, 0.3 ],   # 任務 A
                [-0.7,  0.4,  0.6,  -0.03,  0.1, 0.05],   # 任務 B
                [ 0.9, -0.2, -0.05,  0.01, -0.5, 0.4 ]])  # 任務 C

print("直接平均:", tau.mean(0).round(3))

# 1. Trim:每個任務只留絕對值最大的一半
k = tau.shape[1] // 2
cut = np.sort(np.abs(tau), axis=1)[:, -k][:, None]
trimmed = np.where(np.abs(tau) >= cut, tau, 0.0)
print(trimmed)

# 2. Elect:每個參數用剩下數值的總和投票,決定正負號
sign = np.sign(trimmed.sum(0))

# 3. Merge:只平均和投票結果同號的值
agree = (np.sign(trimmed) == sign) & (trimmed != 0)
ties = (trimmed * agree).sum(0) / np.maximum(agree.sum(0), 1)
print("TIES    :", ties.round(3))
直接平均: [ 0.333  0.033  0.35   0.    -0.333  0.25 ]
[[ 0.8  0.   0.5  0.  -0.6  0. ]
 [-0.7  0.4  0.6  0.   0.   0. ]
 [ 0.9  0.   0.   0.  -0.5  0.4]]
TIES    : [ 0.85  0.4   0.55  0.   -0.55  0.4 ]
0 番を見る。A、C は +0.8、+0.9 で増やし、B は −0.7 で減らす。直接平均は 0.333。TIES は総和が正なので、A、C だけを平均して 0.85 にする。
1 番は冗長性の例だ。B の +0.4 だけが大きく、A、C は −0.1、−0.2。平均では 0.033 に相殺されるが、小さい値を刈れば 0.4 が残る。3 番は三つとも小さな変更なので、刈ってゼロにする。
名前も Trim、Elect sign、Merge の三段階から来る。論文では各タスクの絶対値上位 20% を残し、単一タスクでは全保持とほぼ同程度だと先に確かめた。マージ後は を掛けて、事前訓練重みへ戻す。
符号は総量で選び、 と二つの でも正になる。最後はそのマスの同符号の残存メンバー数で割り、刈った 0 は数えない。20% で十分という根拠は T0-3B の効率的微調整で、その配合を全パラメータの T5、CLIP へ適用した。自分のタスクでは保持率も探索したい。
ViT-B/32 八タスクで検証ありの TIES は 73.6%、タスク算術は 70.1%。検証なしは 72.4% と 60.4% だ。個別微調整の 90.5% にはまだ遠い。
上限実験では、訓練済みマルチタスクモデルの符号で選出を置き換えた。十一の効率的微調整タスクで 72.0%、マルチタスクは 73.1%、元の TIES は 66.4% だった。方向をよく選べれば改善余地は大きいが、この oracle はすでに完全なマルチタスク訓練を使っており、デプロイ時に無料で得られるものではない。
九割を捨てる
2023 年 11 月の DARE はさらに進む。微調整と事前訓練の差、delta パラメータを比率 でランダムに捨て、残りに を掛ける。
なぜ掛け直すのか。残る確率は で、 倍すれば期待値が元へ戻る。
非常に多く捨てられる。SFT 後の delta は多くが 0.002 以内で冗長性が高く、90%、場合によっては 99% でも能力への影響は小さい。大きいほど高い に耐え、700 億では 99% も影響が小さい。DARE は捨てる前処理で、その後をタスク算術や TIES に任せる。DARE §1
左図は規模差を示す。横軸が破棄率、縦軸が GSM8K 精度で、0.99 では 7B が急落し、70B は元に近い。右はマージ後の三評価で、言語、数学、コードの保持を分けて見る。
delta が大きいと使えないことも明記する。継続事前訓練では約 0.03 に達し、DARE が失敗する。WizardCoder-Python-13B は CodeLlama-13b-Python 由来で、その差は 0.0002 以内だが、Llama 2 との差は 0.01 を超えることが多い。後者を基底にすると問題になる。
10% 捨てるだけで HumanEval と MBPP の pass@1 は 63.41、55.4 から 0 に落ちる。期待値の等式は成立しても、抽出一回の分散は 。delta が大きく、高破棄率で残りを拡大すると出力を保ちにくい。0.002 は観察された尺度で、層とデータ分布も必要であり、全モデルの共通しきい値にはできない。
前処理の結果にも勝敗がある。13B の指示・数学専門モデルのタスク算術では GSM8K は 66.34% から 66.26%。TIES では 15.77% から 36.16% に戻す。三専門のタスク算術は 58.45% から 56.48% に落ちる。TIES は方向と平均の干渉、DARE は差分の重なりという別の部分を直し、組合せ後も実測が要る。
捨てるのは delta で、基底の全重みは残る。復元後も同じサイズの dense モデルだ。変更の 1% を残しても、推論量は自動的に 1% にならない。助けるのはマージと差分の疎化で、デプロイの高速化は別に扱う。
最後に著者らは CPU だけで 7B をマージし、Open LLM Leaderboard の 7B 首位になった。
同じ頃、コミュニティはすでに盛り上がっていた。
GPU 不要の錬金術
2023 年 11 月 5 日、Hugging Face に Goliath-120B が登場した。Llama 2 70B の微調整版 Xwin、Euryale から区間を取り出し、交互に積み、深いモデルにする。マージ時に勾配訓練はしていない。Goliath-120B モデルカード この組み方は frankenmerge と呼ばれ、フランケンシュタインにちなみ、異なるモデルの部品で新モデルを作る。厳密には重みを一つも平均していない。
道具は Charles Goddard の mergekit だ。線形平均、SLERP、タスク算術、TIES、DARE、直接積層の passthrough を設定ファイルで実行でき、メモリが足りなければ CPU でも混ぜられる。2024 年 3 月の論文は、すでに千以上のマージを支えたと述べる。Upstage の SOLAR-10.7B も最初に同様の積層を行い、その後に継続事前訓練する。MergeKit
「GPU 不要」は、ソースのテンソルを読み、混ぜ、新 checkpoint に書く段階を指す。元の訓練には計算がかかり、評価や推論には完全なモデルを動かす必要がある。Goliath は積層で経路と保存量も増える。追加の勾配訓練を省いても、120B 級のデプロイ要件は残る。
マージという名には異なる操作が含まれる。固定層数の補間は構造を保ち、passthrough は層数を変え、SOLAR はさらに学習する。安さを比べるなら、生成、評価、デプロイを少なくとも分けたい。
なぜ弧に沿うのか
SLERP は球面線形補間で、Ken Shoemake の 1985 年のコンピュータアニメーション論文に由来し、回転間を滑らかに遷移するために使われた。2024 年初めには人気のマージ法だが、一度に二モデルだけを扱う。
直交する長さ 1 の と を直接平均すると で、長さは になる。SLERP は円弧を進み、中点 の長さを 1 に保つ。
コミュニティの説明は、高次元の直線混合はベクトルを短くし、方向の変化のほうが長さより意味を持ちやすい、というものだ。Labonne、2024-01-09 上の比較は等長単位ベクトルで、実モデルは層ごとのノルムと角度を測る必要がある。共通基底からの変更も相互角度も小さければ、 から二係数は と に近づき、線形補間に近くなる。小角近似であって、DARE の delta の絶対値だけからモデル全体の角度は導けない。後で見る Cohere の 1,110 億モデルでは、SLERP に明確な利点はなかった。
ランキング
2024 年 1 月 9 日、Maxime Labonne は Hugging Face の mergekit 解説で、GPU 不要の安価な方法が Open LLM Leaderboard の多数の上位モデルを生んだと紹介した。本人の SLERP による Marcoro14-7B-slerp も 1 月初めに 7B 首位になった。同時に、最良モデルを混ぜると汚染も引き継ぎ、「Marcoro14-7B-slerp は汚染されていると考えてよい」と明記する。Labonne、2024-01-09
汚染(contamination)は評価問題が訓練データに入ることだ。公開問題で訓練する例があり、マージは系譜の確認が難しい。親もマージモデルで、世代ごとに微調整していることもある。
2024 年 3 月、Sakana AI が進化的マージを発表した。冒頭で、ランキングがマージに占められ、「黒魔術や錬金術」とも見られ直感に頼ると述べる。解決は進化的アルゴリズムで配合と層間のデータ経路を探索することだ。日本語数学の EvoLLM-JP は 7B で MGSM-JA 52.0 を取り、一部の日本語評価で以前の複数の 70B も上回った。Akiba ら
後の版は設定を詳しく示す。三つの Mistral-7B 系の日本語・数学モデルを使い、主結果はソースごとの density と weight だけを探す。層別自由度を最大にする必要はなかった。別途翻訳した 1,069 問で探索し、最終 MGSM-JA の 250 問を残す。PS は 52.0%、DFS を続けると 55.2% で、サイズも 7B から 10B へ増える。テスト以外のデータで配合を決めてこそ、能力の転移を調べられる。Akiba ら §3.1
原図の層の色が操作を区別する。PS はテンソルを混ぜ、DFS は層と順序を選ぶ。両方なら内容と経路を変え、最終サイズと順伝播経路も異なりうる。
この頃、ランキングはマージを既定で隠していた。3 月 11 日、何度も首位を取った作者が抗議した。merge のタグだけで隠され、フラグ付きや削除済みモデルと並べられ、否定的な印象を与えるという。
Hugging Face の Clémentine Fourrier は、根本には系譜をほぼ追えない問題があると答えた。Llama の微調整なら基底とデータがわかるが、マージには「マージのマージのマージや、削除済みモデル」まで含まれ、意図せず汚染しやすい。マージ、微調整、再マージ、DPO を重ねた学術スコアが実用へ結びつかないことが多く、「そのため既定で非表示」にしている。Open LLM Leaderboard 議論 #629
これは透明性と評価選択の問題だ。親や係数を同じ評価で何度も選べば、評価自体が配合探索へ参加する。元のテスト問題を見たかは、データ系譜を別に調べる必要がある。配合に使わないテストを残し、実際の用途の出力も見たい。この議論は汚染への懸念と運営理由を示したが、各マージモデルの汚染を個別に立証したものではない。
訓練工程へ入る
ランキングの外でも、マージは各社の訓練工程へ広まった。
公開報告によくあるのは、同じ配合で得た複数の結果を平均する方法だ。
- Llama 3(2024 年 7 月):報酬モデル、SFT、DPO の各段階で、データ版やハイパーパラメータを変えたモデルを平均する。Llama 3 §4.1.5 画像 SFT も探索結果を並べ、上位 K 個を平均する。最良の単一モデルを一貫して超え、ハイパーパラメータへの感度も下がると報告する。Llama 3 §7.5.2
- Gemma 2(2024 年 7 月):同じ後訓練工程でハイパーパラメータを変え、平均する。Google DeepMind の WARP を引用する。Gemma 2 §4
- OLMo 2(2024 年 12 月):7B の mid-training で同じ 50B tokens を三つの順序で訓練して平均する。六データ配合で試し、平均は各々の最良以上だった。OLMo 2 Table 14
- Tülu 3(2024 年 11 月):異なるシードの SFT をスープにしたが、最良シードと最良スープがほぼ同じで、一貫性のため最良の一回を採用した。Tülu 3 Table 14
Tülu 3 は覚えておきたい。平均が役立たないこともある。
事前訓練にも入る。ByteDance Seed の PMA は固定学習率で checkpoint を平均し、4.11 億の dense から 2,000 億の MoE まで試す。性能が改善し、学習率アニーリング後の性能も早く予測できる。Ant Group の WSM はさらに、学習率減衰段階を checkpoint マージで置き換える。PMA、WSM
対象も異なる。SWA と固定学習率の checkpoint averaging は同じ軌跡の時点を集める。Model Soups とデータ順序を変える実験は、共通 checkpoint から分岐して訓練する。前者は収集の開始と長さ、後者は入れる分岐の選択が要る。共通する条件は、互換性のあるパラメータ座標と、平均後のタスク再評価だ。
六つの専門モデル、二鍋のスープ
Cohere の 2025 年 4 月の Command A 報告は、工程の中心にマージを置く。
1,110 億パラメータの Command A は、基本の指示モデルから、コード、安全、RAG、数学、多言語、長文脈を含む一般能力の六専門モデルを訓練する。SFT の六つをスープへ混ぜ、そこから領域別の選好最適化と強化学習を行う。報告が呼ぶ六つの RL 専門モデルを再び混ぜ、最後に仕上げる。Command A §3
最も単純な線形加重平均を使い、経験則と総当たりで係数を選ぶ。SLERP やタスクベクトルも試したが、明確な改善がなく複雑さが増したという。線形なら、マージのマージを一回に展開でき、工程を追いやすい利点もある。
ただし係数を残す必要がある。A、B を平均して C と半分ずつ混ぜると だ。一回の線形マージにできても、等重みの とは違う。起点に加え、層のソース、各段階の係数、途中の再訓練を記録して初めて、最終モデルの由来を追える。
各領域の最良専門モデルに対し、平均低下は 1.8%、大半の指標は 2.5% 以内で、コードが最も落ちた。この規模では重みを大幅に動かしても、対応領域の変化は 2%~3% だけだった。マージ後の低学習率の少量 SFT で、多くが専門モデルと同等以上へ戻る。Command A §4.9
原図は失うスコアを示す。左はマージから専門モデルのスコアを引いた指標の分布、右は領域平均、誤差棒は標準偏差だ。コードの低下が大きく、RAG はゼロに近い。全体平均が小さくても、ある仕事の明確な損失を隠すことがある。
報告の経験則は、昔の図の延長にも見える。
- 共通の起点:全専門モデルが同じ汎用指示モデルから始める。ツール用の特殊 token も共通の起点から通常どおりマージするほうが、その token を訓練した専門モデルだけを選ぶよりよい。
- 一つずつ除く:毎回一専門モデルを外して混ぜ、他能力を弱めるものを探す。干渉を減らすため各訓練データに他領域を少し混ぜる。共有データの文体や形式の小差でも衝突する。
- マージは安く、評価は高い:最終モデルは 500 評価指標を参考にし、各候補に大量の推論計算が要る。
少し短く考えさせる
推論モデルの登場で、マージは思考の短縮にも使われる。
Kimi k1.5 の 2025 年 1 月の報告は、長い思考連鎖と短い思考連鎖の重みを直接平均し、token 効率を改善した。ただし比較の最良は平均でなく、専用の long2short 強化学習だった。Kimi k1.5 §2.4、§3.4
成績と生成長を同時に見る必要がある。推論能力を下げても短くなるが、残したい能力を失う。Kimi はスコアと token 数を比べ、追加訓練不要の平均に対し、rejection sampling、DPO、long2short RL は学習を増やして長さと正しさの取捨を改善する。安いマージも、訓練手法と同じ取捨の図で比べたい。
ドイツの TNG Technology Consulting は 2025 年 4 月、さらに大きい例を作る。6,710 億の MoE、DeepSeek-V3-0324 と DeepSeek-R1 を R1T Chimera に組んだ。注意層と共有専門家は V3-0324、ルーティング対象の専門家は R1 から一式取る。自社評価では R1 の推論性能を保ち、出力 token は約 40% 減る。比率を変えた中間モデルも、ほぼすべて使えたという。Assembly of Experts
成績を見る
体系的な研究比較も増え、結論は個々の手法論文より慎重だ。
Yang らの 2025 年末のサーベイ版は統一設定で再評価した。ViT-B/32 の八画像タスクは個別微調整の上限 90.3% に対し、直接平均は 66.5% で、加重や部分空間法が一部を埋める。Llama-3.1-8B の五領域では全手法が事前訓練と専門モデルの間にあり、最良でも専門モデルの 84.8%。複雑な部分空間法や加重法が単純なタスク算術に負けることもある。Yang ら §3.2
Yadav らは 2024 年、PaLM-2 を 640 億まで拡大し、二基底、四サイズ、四手法、2/4/6/8 専門モデルを同じ行列で測った。大きいモデルと IT 基底は通常混ぜやすく、64B の IT で八個なら四手法とも held-in は約 0.93。24B では重み平均 0.77、タスク算術 0.92 で、差は大きい。Yadav ら
held-in は専門モデル、held-out は基底で割る。64B 八個のタスク算術の未知タスクは 1.09 で、マルチタスクの 1.05 よりよい。しかし既習タスクは 0.93 で、マルチタスクの 0.99 より低い。実用的な専門能力を残し、未知汎化を改善する可能性と、その取捨を両方の指標で見る必要がある。
64B の四手法の棒はほぼ重なる。左の 1.0 は専門モデル、右の 1.0 は PaLM-2-IT 基底で、同じ高さでも分母が違う。八個では右は基底超え、左はまだ専門モデルに届かない。
TMLR が 2026 年 3 月に刊行した研究は、実際に近い状況を見る。各基底に Hugging Face の公開 12 微調整版を集めると、目的が重なり、衝突もする。四モデル、16 評価、六種類を比べ、単純なタスク算術が最も安定するが改善幅は小さい。TIES と Model Stock は基底近く、TSV-Merge、Iso-C は数とともに下がり、TA+Subspace Boosting は TA に近い。Hitit ら
normalization が有効な点は特に大事だ。 の TA は実際は差分の平均で、十二差分の直接加算は 12 倍になる。付録で無効にすると に敏感になる。同じ TA、TIES という名でも、正規化、保持率、尺度をそろえる必要がある。
図を上下に並べると、真偽値一つの違いが大きい。横軸 、縦軸平均精度、色は四基底で、上の有効時は通常範囲で平ら、下の無効時は係数とともに急落する。上は右端に 10 も試し、横軸は列挙した係数の位置を示す。
研究は基底超えと、プール最良の微調整版超えも分ける。前者に成功しても後者は失敗しうる。Llama 3.1 8B には強い既存版があり、マージは一度も超えなかった。新 checkpoint の価値は、元から選べるモデルと比べたい。
そして DeepSeek-V4 だ。2026 年 4 月の報告は数学、コード、agent、指示追従の専門モデルを SFT と GRPO で訓練する。統合は多教師のオンポリシー蒸留(on-policy distillation)で、学生が自ら回答を生成し、十を超える教師から、その回答に対する出力分布を学ぶ。知識を logit 水準で同じパラメータへ整列し、「従来の重みマージや混合強化学習に多い性能低下を実際に避ける」と報告する。DeepSeek-V4 §5.1
両社とも領域専門を育てるが、統合空間が違う。Command A は互換な重みを直接組み、V4 は学生自身の生成経路で教師の分布を学ぶ。前者は統合の勾配訓練を省き、後者は追加訓練で異なる教師の行動を教える。モデル、データ、目標が異なる二報告だけでは、マージと蒸留の普遍的な優劣は比較できない。
MoE も加えると選択肢が整理できる。
| 統合方法 | 最後に残すもの | 推論の実行 | 主に確認する条件 |
|---|---|---|---|
| 重み平均/タスクベクトル | 同構造の一モデル | 元の構造の一順伝播 | 基底、テンソルの意味、能力の互換性 |
| 固定経路の積層 | 選んだソース層 | 毎回同じ新経路 | 表現の接続、深さ、推論コスト |
| MoE | 複数の内部専門家とルーティング | token ごとに一部を選ぶ | ルーティング、負荷、保存する重み |
| 多教師蒸留 | 学生モデル | 学生自身の構造 | 教師採点、訓練データ、学生容量 |
前述のモデルと工程に基づく本記事の整理。組合せも可能で、複数の完全な領域モデルを、MoE の学生へ蒸留する例も考えられる。
Command A の「六専門」は六つの完全な checkpoint で、MoE 層内の専門家モジュールとは階層が違う。V4 は蒸留でも疎な MoE 推論を保て、Chimera は既存 MoE の一組の重みを直接替える。対象とデプロイ経路を区別して初めて、節約する部分がわかる。
混ぜるのは速いのに、なぜ評価は長いのか
評価コストは何度も現れた。貪欲スープはメンバーごとに選択データを評価し、進化的マージは千以上の候補を作り、大規模研究は基底、規模、部分集合を交差する。パラメータ加算は読み書きだが、使えるかを知るには完全なモデルで多様な入力を処理する必要がある。
比較するならデータとプロンプトを固定し、基底、最良の単独版、線形平均の三基準を残し、小さく係数探索する。配合選択の検証と最終テストを分け、増やす能力、失えない能力、回答長や拒答も見る。Command A の一つずつ除く方法は、あるソースが何を改善し何を犠牲にするかも教える。
こうした比較で残す手法を決める。線形平均で足りるなら複雑な射影は不要だ。重要能力が下がり続ければ、マージ後の少量訓練、専門データの再構成、蒸留を比べられる。ランキングの数項目だけを使うと、配合もそこへ適応しやすい。
結局、足して 2 で割ると役立つのか?
何を平均するかで答えが変わる。
- 同じ起点、同じタスク:シード、ハイパーパラメータ、同じ訓練の時点が異なる場合。最も安定し、SWA、Model Soups、Llama 3、OLMo 2 などの公開工程へ入っている。ただし Tülu 3 のように改善しないこともある。
- 同じ起点、異なる能力:タスク算術、TIES、DARE、Command A。役立つが通常は専門モデルに届かない。大モデルは単純な線形で足りることも多く、各専門の最高点より、専門同士の一貫性が重要だ。DeepSeek-V4 はここで蒸留を選んだ。
- 異なる起点:ニューロンの置換を扱い、十分な幅があって初めて障壁ゼロへ近づける。言語モデルの多くは共通の事前訓練から始め、この問題を回避する。
同じ基底の微調整モデルがいくつかあれば、まず単純な線形平均を試し、係数を検証で選ぼう。数が多ければ Cohere のように一つずつ外し、足を引くものを探せる。評価の十分さは、手法選び以上に結果を左右するかもしれない。
10 年前、FedAvg の著者らは平均がいくらでも悪くなりうると心配した。その後、共有する訓練経路、互換な座標、制御された微調整、退化を見つける評価という、より確かな条件が見つかった。異なる能力を一組の重みへ収めるには、どれも気を配りたい。
マージは、足して 2 で割るだけだ。
大変なのは、その後に 500 個の評価が待っていることだ。