原論文
Model Merging in LLMs, MLLMs, and Beyond: Methods, Theories, Applications and Opportunities
- arXiv への初回投稿
- arXiv:2408.07666
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingmodelmergingsurvey2024,
  title = {{Model Merging in LLMs, MLLMs, and Beyond: Methods, Theories, Applications and Opportunities}},
  author = {Enneng Yang and Li Shen and Guibing Guo and Xingwei Wang and Xiaochun Cao and Jie Zhang and Dacheng Tao},
  year = {2024},
  eprint = {2408.07666},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2408.07666}
}
ここ数年、モデルマージの論文は急速に増え、手法の名前も次々に生まれている。
タスク算術、TIES、DARE、AdaMerging、RegMean、Fisher Merging、Model Breadcrumbs、TSV-M、WEMoE……。どの論文も、マージ時のある種の干渉を解決したと言う。しかし、それらを並べて見る人はあまりいない。それぞれどの問題を扱っているのか。どんなデータが必要か。大規模言語モデルでも成り立つのか。
中山大学深圳キャンパス、中国の東北大学、南洋理工大学の Yang、Shen、Guo らによるこのサーベイは、まさにこうした問いに答えようとするものだ。2024 年 8 月に初めて公開され、その後も更新が続き、2025 年末の第五版では四十ページに拡充されている。著者らは別に GitHub の論文リストも管理し、新しい研究を収録し続けている。
このノートでは、分類の仕方、著者ら自身が行った比較実験、そして未解決とされる問題に焦点を当てる。
問題の定義
モデルマージは他のやり方と何が違うか
著者らはまず、モデルマージを四つの近い学習方式と比べる。
- 単一タスク学習:タスクごとに専門モデルを一つ訓練する。互いに干渉しないが、知識は共有できず、モデル数もタスク数とともに増える。
- マルチタスク学習:一つのモデルで全タスクを同時に学ぶが、全タスクのデータを手元にそろえて一緒に訓練する必要がある。
- 連合学習:データは各クライアントに残し、モデルの更新はサーバーが集約するが、多くの通信ラウンドが必要になる。
- アンサンブル学習:複数の専門モデルを同時に保持し、出力を組み合わせる。推論と保存のコストがどちらも高い。
モデルマージは、訓練済みの専門モデル数個のパラメータを直接組み合わせて単一のモデルを得る。ほとんどの場合、元のデータも再訓練も必要ない。
形式的には、アーキテクチャが同じ 個のモデル が与えられる。これらは通常、同じ事前訓練モデル から微調整したもので、目標は次を求めることだ。
最も簡単な版はそのまま平均することだ。著者らは、平均ではしばしばかなり悪い結果になると指摘し、その原因を二種類に分ける。一つはマージの前提条件が欠けていること、例えばモデルが同じ盆地にない、アーキテクチャが一致しないといった場合だ。もう一つは、異なるタスク間でパラメータが衝突し、干渉し合うことである。
サーベイ全体の手法の分類は、この二つの原因に沿って展開される。
問題を解く
分類:マージ前とマージ中
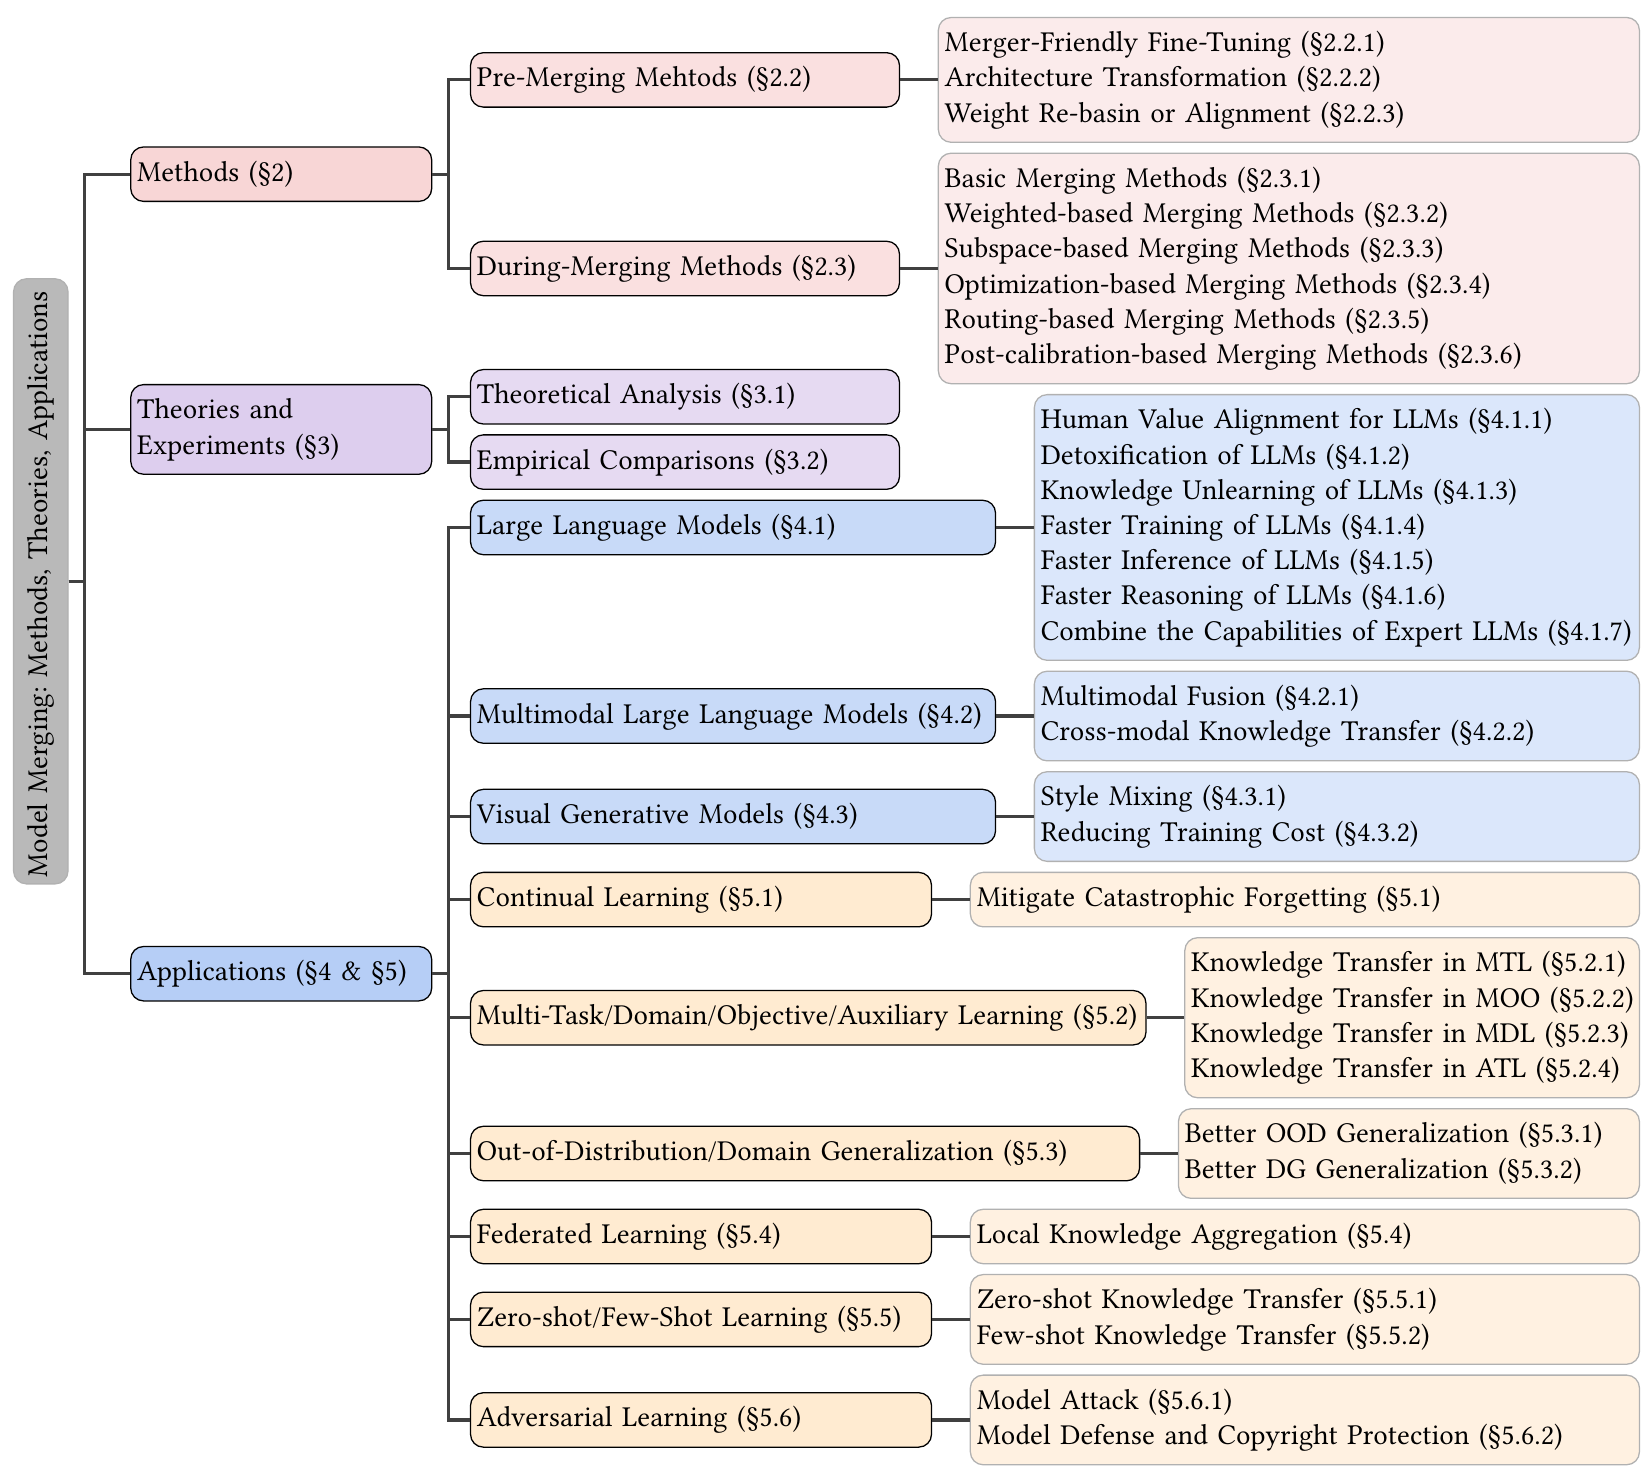
この図が全体の目次だ。上部の「手法」は二つの時点に分かれる。
マージ前(pre-merging) の手法は、マージによい条件を整えることを目的とする。
- マージしやすい微調整:微調整の段階で、モデルをマージしやすくしておく。代表は接空間のタスク算術で、線形化したモデルで微調整し、タスクベクトルの分離性を高める。後続研究には、一部の層だけを線形化してコストを下げるもの、sharpness-aware 最小化で損失地形をより平坦にするもの、ごく一部のパラメータだけを微調整して互いの衝突を減らすものもある。
- アーキテクチャ変換:アーキテクチャの異なるモデルはパラメータを直接組み合わせられないので、まず知識蒸留や層の追加で同じアーキテクチャにそろえる。FuseLLM や FusionChat がこれに当たり、代償としてデータと訓練が必要になる。
- 重みの再整列:独立に訓練したモデルを、まずニューロンの置換で整列し、同じ盆地に入れる。Git Re-Basin や、最適輸送による整列の OTFusion がここに入る。著者らは REPAIR の観察も引用し、整列の効果は正規化層に大きく左右されるとしている。
マージ中(during-merging) の手法はタスク間の衝突を扱い、六種類に分かれる。
- 基本的な手法:そのまま平均する、またはタスク算術。
- 重み付け手法:モデルごと、層ごと、さらにはパラメータごとに重みを決める。例えば進化的アルゴリズムで係数を探すもの、AdaMerging のようにラベルなしのテストデータでエントロピーを代理損失として係数を学習するもの、RegMean のように線形層について閉形式解を求めるもの、Fisher Merging のように Fisher 情報でパラメータの重要度を測るものがある。SLERP もこの種類に分類される。
- 部分空間手法:タスクベクトルを疎または低ランクの部分空間へ射影する。疎なものには TIES-Merging、DARE、Model Breadcrumbs があり、低ランクのものにはタスクベクトルを SVD する TSV-M、ISO-C、KnOTS がある。
- 最適化手法:タスクベクトル自体の性質を使い、データ不要の目的関数を書く。例えばタスクベクトルをより直交させるもの(AWD)や、線形層でデータ不要の損失を構成するもの(WUDI-Merging)がある。
- ルーティング手法:ここまでの種類でマージして得られるのは固定のモデルだ。ルーティング手法は入力に応じてマージの仕方を動的に決める。例えば WEMoE は、ルーティングネットワークに従って線形層を重み付きでマージする。たいてい効果は最も高いが、追加のパラメータを保持する必要があり、推論も遅くなる。
- 事後補正:マージ後のモデルは、内部表現が各専門モデルと大きく異なる。Representation Surgery などの手法は小さなモジュールを加え、このずれを補正する。
比較表の要点
著者らは代表的な手法をいくつかの観点で並べて比較している。マージ後のパラメータ数、調整不要かどうか、必要なデータ、静的か動的か、そして重みの粒度(全体、タスク、層、パラメータ)だ。並べて比べると、いくつかのトレードオフがはっきりする。
- ほとんどの手法はマージ後のパラメータ数がモデル一つ分だ。ルーティングと補正の手法は一つ分を超え、WEMoE は一つ分をはるかに上回る。
- 粒度が細かい重み付け手法ほど成績はよいことが多いが、たいてい重みを推定するための追加データ、例えば検証集合やラベルなしのテスト集合が必要になる。
- 最適化手法や低ランク部分空間手法の多くは、データ不要をうたっている。
著者らの結論は、すべての状況に合う手法はなく、求める性能、実装の難しさ、手元のデータと計算資源に応じて選ぶべきだというものだ。
理論はまだ断片的
第 3 章は理論解析をまとめ、マージするモデルの出どころによって三つに分ける。
- 同じ訓練軌跡:SWA や EMA など。最小二乗回帰のような簡略化した設定ではバイアスと分散の分解があり、凸・非凸の場合の安定性と汎化の上界もある。
- 同じタスク、異なるハイパーパラメータ:線形モード連結性と平坦な極小値で説明する。同じ事前訓練モデルから異なる設定で微調整したモデルは、通常線形に連結している。
- 異なるタスク:NTK と重みの分離性でタスク算術を説明する。タスクベクトルを勾配と結びつける研究もあり、フルバッチの勾配降下で 1 エポック訓練した場合、タスクベクトルはちょうど学習率に負の勾配を掛けたものに等しい。
著者らも率直に述べるように、三つの理論はそれぞれ一部分を語るだけで、多くは共通の出発点、広いネットワーク、線形化といった仮定の上に立っている。大規模言語モデルに当てはまるかは未検証で、統一的な枠組みもまだない。
議論
著者ら自身による比較
著者らはサーベイの中で独自の比較実験も行っており、五つのバックボーンを扱う。CLIP の ViT-B/32 と ViT-L/14 で八つの画像分類タスクを、RoBERTa-Large で八つの GLUE タスクを、Llama-3.1-8B で五つのテキスト生成タスクを、InternVL-2.5 で五つのマルチモーダルタスクをマージする。
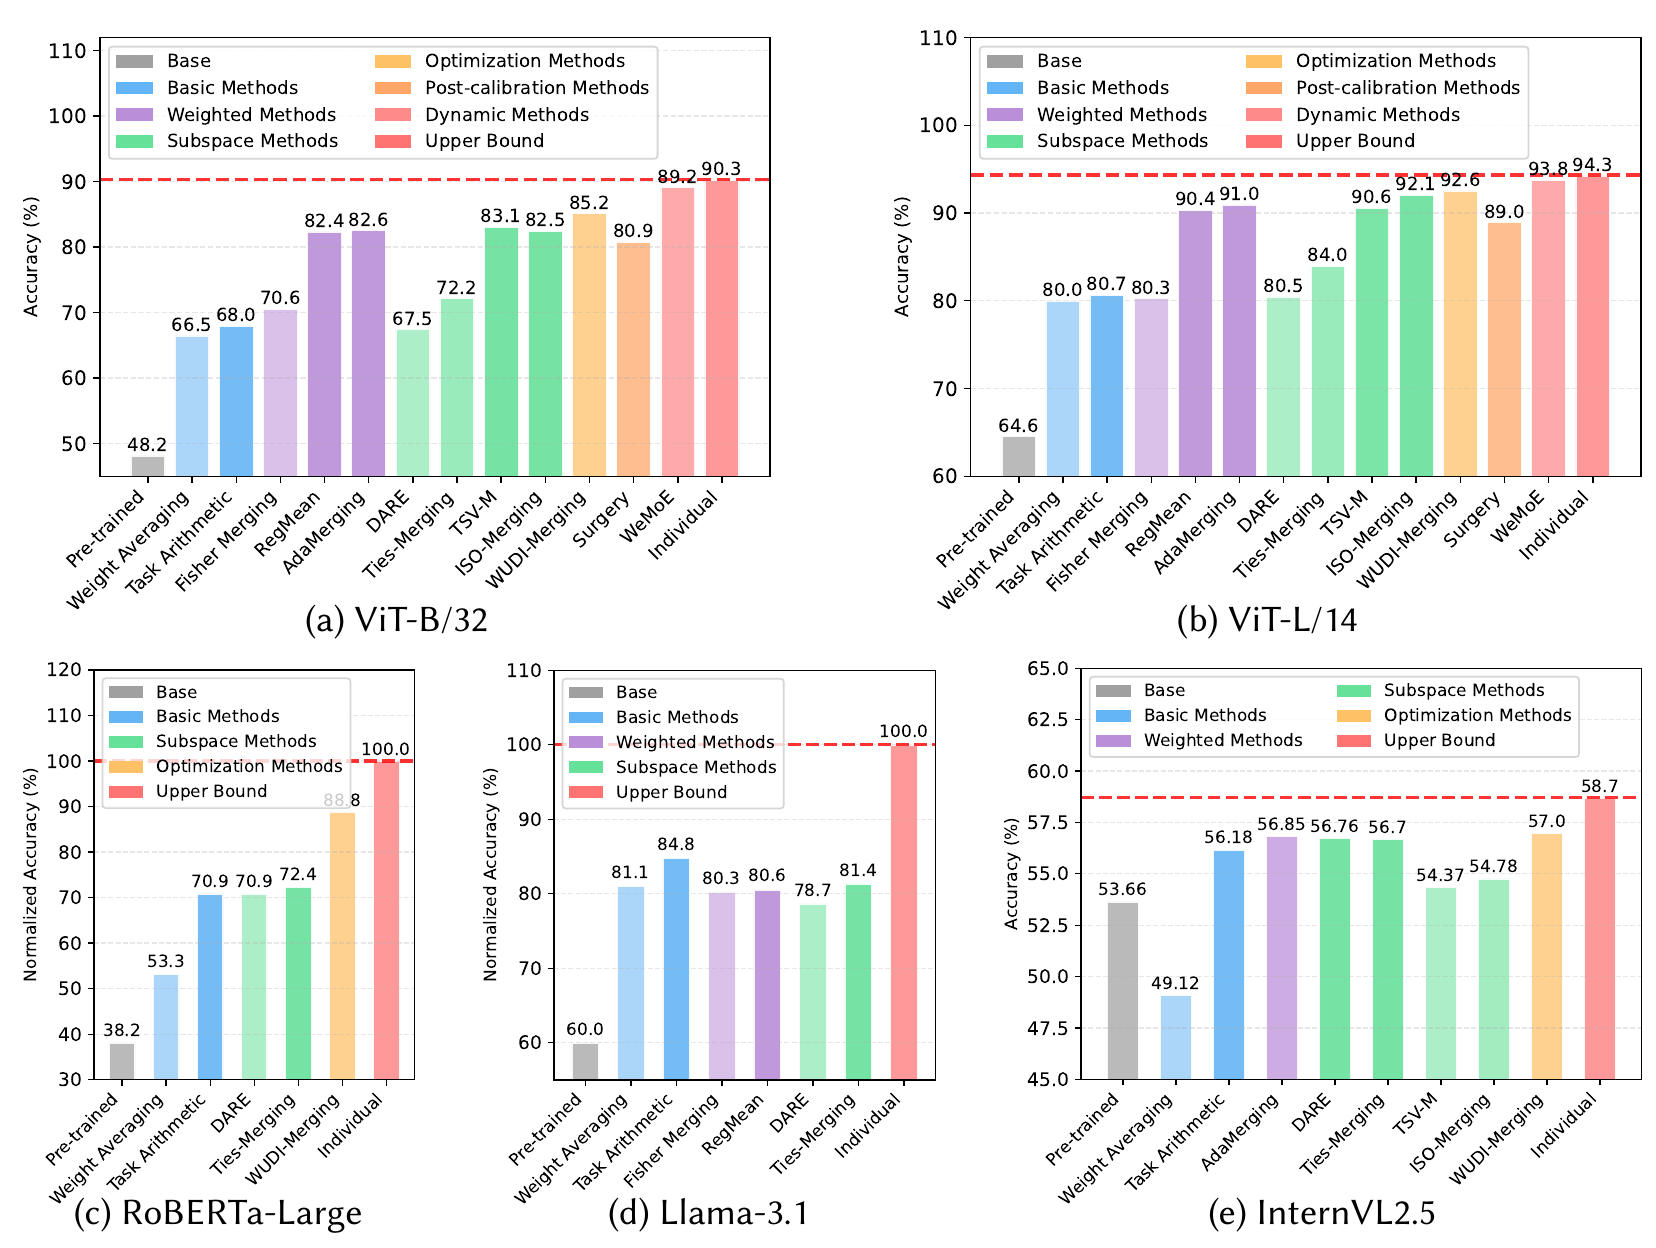
各図の左端の灰色は事前訓練モデル、右端の赤は各タスクを個別に微調整したモデル、つまり上限だ。間にある色とりどりの手法は、赤い破線に近いほどよい。
まず ViT-B/32。単純平均はわずか 66.5 で、上限の 90.3 から遠い。重み付け手法と低ランク部分空間手法は 82~83 まで引き上げ、データ不要の WUDI-Merging は 85.2、追加パラメータが必要なルーティング手法の WEMoE は 89.2 に達して上限にほぼ追いつく。ViT-L/14 ではどの手法もずっとよく、WEMoE が 93.8、上限が 94.3 だ。大きなモデルほどマージしやすく、大きいほど混ぜやすいという観察と一致する。
次に Llama-3.1 を見ると、結果はまるで違う。タスク算術が 84.8 で首位に立ち、Fisher Merging、RegMean、DARE、TIES はいずれも 78.7~81.4 でタスク算術より悪く、単純平均の 81.1 をわずかに上回るか下回る程度だ。上限の 100 にはまだ十数ポイント足りない。視覚タスクで明らかに勝っていた「高度な」手法は、言語モデルの生成タスクでは優位に立てない。
InternVL2.5 では、単純平均の 49.12 が事前訓練モデルの 53.66 より低く、マージでかえってモデルが悪くなる。手法間の差は一、二ポイントしかなく、最良の WUDI-Merging が 57.0、上限が 58.7 だ。
この比較は、このサーベイで最も読む価値のある部分の一つだ。多くのマージ手法は CLIP の八つの分類タスクで開発・調整されたもので、LLM やマルチモーダルモデルに移ると順位が入れ替わる。手法を選ぶ前に、自分のモデルとタスクで改めて比べ直したほうがよい。
大規模言語モデルでの七つの用途
第 4 章は LLM におけるモデルマージの応用を挙げており、いくつかの方向は本サイトの他のノートと関係する。
- 人間の選好への整合:異なる選好に沿うモデルを別々に訓練し、ユーザーの必要に応じてマージする。
- 無害化:タスクベクトルを引く方法で、有害な出力や事実に反する出力を取り除く。
- 忘却:同じく引き算で特定の知識を取り除く。例えば誤って学習した著作権保護コンテンツを消し、ゼロから訓練し直すコストを省く。
- 訓練の高速化:事前訓練中に checkpoint を平均する。著者らは PMA と WSM をどちらもここに分類しており、両者とも checkpoint の平均を学習率減衰の代わりとして使う。
- MoE 推論の高速化:専門家のパラメータを先にマージしてから計算し、計算する専門家の数を減らす。
- 推論モデルの高速化:長く考える推論モデルと、短く答える一般モデルをマージし、出力を短くする。著者らが引用する例では、タスク算術と TIES で 7B モデルの思考の長さを約半分に減らし、精度はほぼ変わらない。
- 専門能力のマージ:異なる分野の専門モデルを一つの汎用モデルにまとめる。
技術報告での実際の使われ方については、このサーベイはあまり触れていない。Llama 3、Tülu 3、Command A などの報告がマージを正式な訓練工程にどう組み込んだかは、それぞれの報告に戻って確かめる必要がある。
未解決の問題
最終章は七つの方向を挙げており、最初のいくつかが最も実際的だ。
- 独立モデルとの差:マージは依然として「同じ事前訓練モデルから出発し、微調整の学習率とステップ数を慎重に制御する」という前提に強く依存している。それでもタスクが増えると差ははっきりし、例えば Llama-3.1 での最良の手法は 84.8 で、上限は 100 だ。
- 理論:異なるタスクをゼロから訓練したモデル同士のマージには、理論的な説明がほとんどない。
- 信頼性:モデルの所有者は自分のモデルを勝手にマージされないよう守りたいし、マージする側はモデルにバックドアを仕込まれるのを防がなければならない。
- 効率:高性能な手法は、たいていすべてのモデルを同時にメモリへ読み込む必要がある。例えば微調整した ViT-B/32 を 72 個マージするには 200GB を超えるメモリが要る。係数の探索でも評価を繰り返す必要がある。
- 異種モデル:アーキテクチャの異なるモデルは、今のところまず同じアーキテクチャへ蒸留するしかなく、コストが高い。
このサーベイの読み方
これは範囲の非常に広いサーベイで、第 5 章では継続学習、マルチタスク学習、分布外汎化、連合学習、少数ショット学習、敵対的攻撃など十を超えるサブ分野も扱うが、それぞれ一、二段落で済ませていることが多い。
では、何に使うのが向いているのか。分類は地図として使える。新しいマージ手法に出会ったら、まずそれがマージ前かマージ中か、どんなデータが必要か、静的か動的かを確かめれば、何の問題を解こうとしていて、どんな代償を払うのかがおおよそわかる。個々の手法の細部や実験条件は、やはり原論文で確かめる必要がある。
結論
このサーベイは「マージ前」と「マージ中」の二段階で、散らばっていたマージ手法を明快な地図にまとめ、理論、応用、課題も補った。
読み終えて一番持ち帰る価値があるのは、著者ら自身による比較だ。CLIP でよい成績を出す高度な手法も、Llama-3.1 では最も単純なタスク算術に勝てるとは限らない。
手法はたくさんある。まずはタスク算術を基準に比べてみてからの話だ。