原論文
Assembly of Experts: Linear-time construction of the Chimera LLM variants with emergent and adaptable behaviors
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2506.14794
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingassemblyofexperts2025,
  title = {{Assembly of Experts: Linear-time construction of the Chimera LLM variants with emergent and adaptable behaviors}},
  author = {Henrik Klagges and Robert Dahlke and Fabian Klemm and Benjamin Merkel and Daniel Klingmann and David A. Reiss and Dan Zecha},
  year = {2025},
  eprint = {2506.14794},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2506.14794}
}
DeepSeek にはかつて、よく似ているのに性格はまるで違う二つのモデルが同時にあった。
一つは DeepSeek-R1 だ。推論モデルで、答える前に <think> と </think> の間に長い思考過程を書く。数学の問題は得意だが、口数が多い。もう一つは 2025 年 3 月に更新された DeepSeek-V3-0324 で、一般的な対話モデルだ。思考過程は書かず、答えは率直で、速い。
両者のアーキテクチャはまったく同じで、どちらも DeepSeek-V3 のベースから出発しており、総パラメータは 6,710 億。R1 の推論能力と V3-0324 の簡潔さを、訓練し直さずに一つにできたら、これほどお得なことはない。
ドイツのソフトウェアコンサルティング会社 TNG Technology Consulting は、本当にそれをやってのけた。2025 年 4 月にマージで作った DeepSeek-R1T-Chimera を Hugging Face に公開し、一か月余り後にこの論文を追加して、どう作ったのか、途中でどんな現象を見たのかを説明した。
問題の定義
まず DeepSeek-V3 のアーキテクチャを振り返っておこう。これが論文全体を理解する鍵になる。
これは混合専門家(MoE)の Transformer で、デコーダ層は全 61 層ある。最初の 3 層は通常の密な層で、残りの 58 層はフィードフォワードネットワークが専門家に置き換えられている。各層には共有専門家があり、すべての token がそこを通る。さらに 256 個のルーティング専門家があり、ルーターが token ごとに 8 個を選んで使う。そのため総パラメータは 671B でも、一つの token が実際に使うのは約 37B だけだ。
モデルを一つ分解すれば、テンソルファイルの山になる。DeepSeek-V3 ファミリーの safetensors 重みファイルには計 91,991 個のテンソルがあり、いくつかの種類に分けられる。最初の 3 層の密な層、各層の注意、共有専門家、ルーティング専門家、そしてルーターのゲートだ。
二つのモデルをマージするとき、テンソルの種類ごとに別々に扱える。これが著者らの言う「組み立て」だ。二つのモデルにそれぞれどれだけ重みを与えるかだけでなく、どの部品をマージし、どれを一方からそのまま使うかも決める。
以前にも、マージで推論モデルの回答を短くしようとした例はある。たとえば Wu らは 7B から 14B のモデルではうまくいったが、32B 以上のモデルでは困難に直面し、回答を大幅に短くしながら推論の品質を保つのは難しかった。この論文が答えようとするのは、671B のモデルをこのように組み立てられるのか、そして組み立てたモデルの振る舞いがどう変わるのか、だ。
問題を解く
マージの規則
をベースモデル(ここでは V3-0324)、 をその他のモデル(ここでは R1 だけ)とする。各テンソル について、マージ後のテンソルは次のようになる。
ここで調整できるものは三つある。
- :各モデルの重み。通常は凸結合で、、合計は 1。モデルが二つなら、 がそのまま R1 の比率になる。
- :マージするテンソルの集合。著者らは二通りを比較する。一つはすべてのテンソル(full merging)、もう一つはルーティング専門家だけでゲートを含まないもの(expert merging)だ。
- :しきい値。ベースとの差が十分に大きいテンソルだけをマージする。差は正規化した Frobenius ノルムで測る。つまりノルムをテンソルの要素数の平方根で割ったものだ。
しきい値は TIES-Merging の刈り込みの考え方を借りているが、TIES はパラメータ単位で刈り込むのに対し、ここではテンソル全体をまとめてマージするかどうかを決める。
実装は、91,991 個のテンソルを一つずつ読み込み、マージ結果を計算して同じ形式のファイルに書き戻すだけで、vLLM でそのまま読み込める。計算量はモデルサイズに比例するので、タイトルで「線形時間」とうたっている。勾配計算はまったく要らない。
まず二つのモデルの違いを見る
著者らはまず、R1 と V3-0324 のテンソルごとの差を測った。結果にはくっきりした規則性があった。ルーティング専門家の差はモデル全体でかなり均一で、最初と最後の数層にだけ目立つパターンがある。共有専門家のゲート射影は、前のほうの層ではほとんど同じだが、最後の数層では差が大きい。注意層にも似た傾向がある。
この差の分布が、後にしきい値 を選ぶ根拠になった。
どう評価するか
各マージモデルは 8 枚の H100 または 8 枚の MI325X 上で vLLM により推論し、主に二つのベンチマークを測る。MT-Bench(多ターン対話の品質)と AIME-2024(数学コンテストの問題)だ。両者を平均したものを、著者らは「知能スコア」と呼ぶ。
コストは平均出力 token 数で測り、R1 の出力量を 100% とする。
さらに振る舞いの指標が一つある。著者らは各回答を必ず <think> で始めさせ、回答に閉じタグ </think> が現れるかを見る。R1 では必ず現れ、V3-0324 では一度も現れない。この割合が、モデルがどれだけ「推論モデルらしい」かを表す。
議論
ほぼどの組合せでも使える
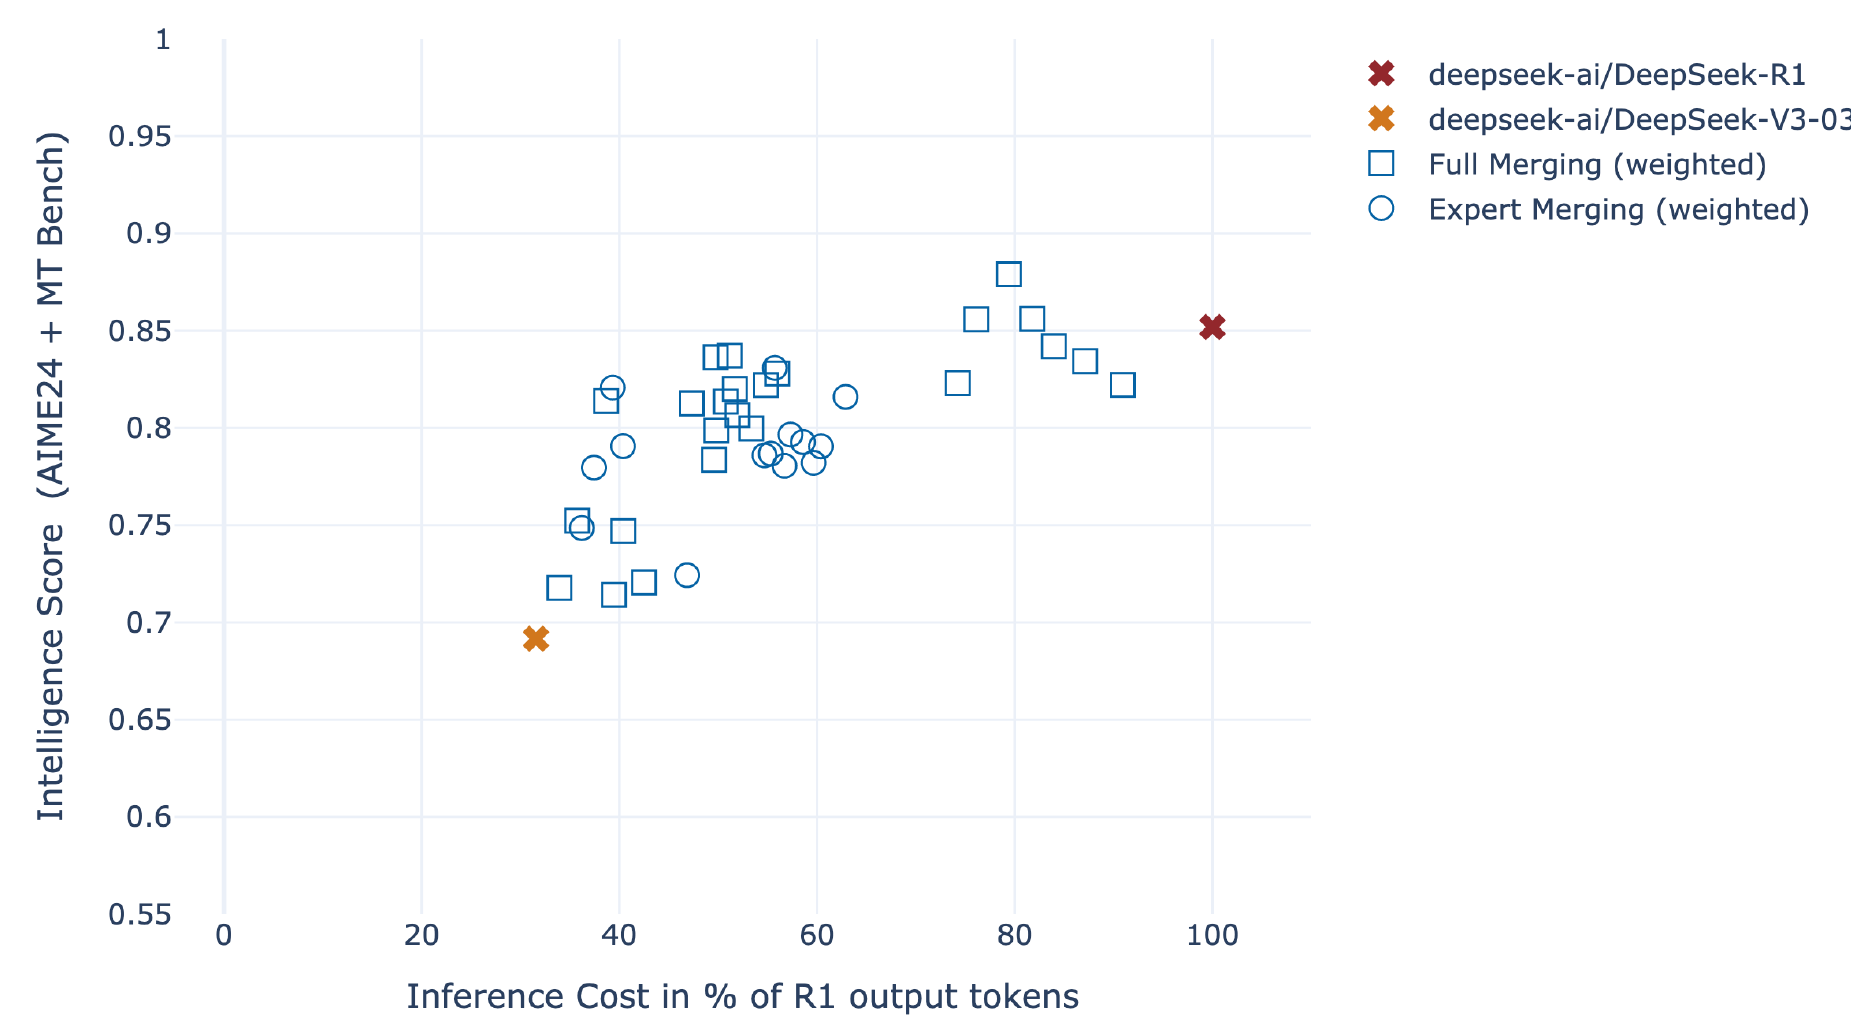
この図の理想の位置は左上、つまりスコアが高くコストが低いところだ。
R1 は右側にあり、スコア約 0.85、コスト 100%。V3-0324 は左下にあり、スコア約 0.69、コスト約 31%。さまざまなマージモデルが両者の間に散らばり、底まで落ちたものは一つもない。探索したパラメータ空間全体で、壊れたモデルが一つも出なかったことを著者らは特に強調している。
コスト 50% 前後、スコア 0.82 以上の位置に点がいくつもあり、半分の token で R1 に近いスコアを得ている。さらに全テンソルマージの点が一つ、コスト約 80% でスコアが 0.88 近くあり、R1 自体より高い。
著者らはこれを、V3、V3-0324、R1 がすべて同じ低損失の谷にあり、凸結合では谷の外に出ないためだと解釈する。これは Model Soups の観察と一致しており、規模が何桁も大きくなっただけだ。
推論の振る舞いは突然現れる
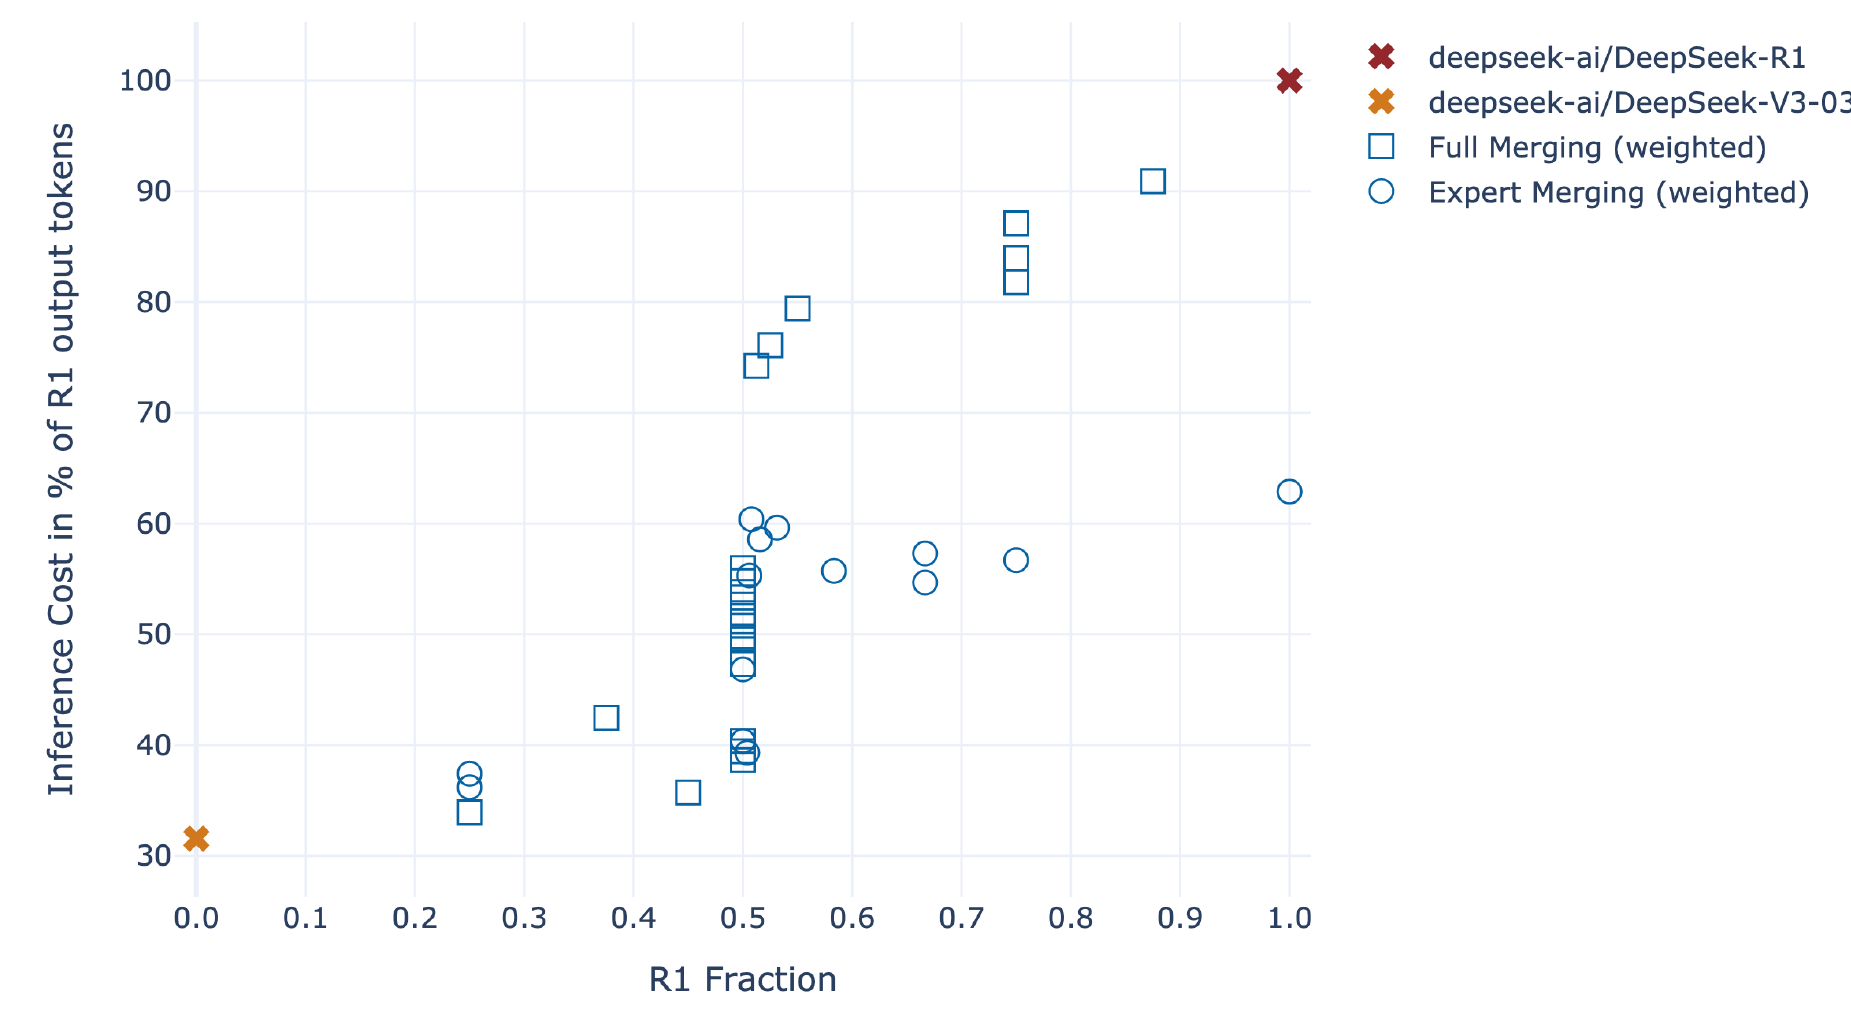
横軸は R1 の比率 だ。出力長は 0.5 付近で急に跳ね上がり、その前後はどちらも比較的平らで、S 字型の曲線のような形をしている。
</think> タグでは、これがさらにはっきりしている。R1 の比率が 0.504 以上のマージモデルは、たいてい完全な思考過程を書いて </think> で締めくくり、比率がほんの少し低いものは、たいてい書かない。この転換点は、0.5 付近のごく狭い範囲にしかない。
つまり、マージモデルの性質によって変わり方が違う。一般的な推論能力は比率に応じてなめらかに変わるが、「思考過程を書くかどうか」という振る舞いの特徴はスイッチのようで、しきい値を越えて初めて現れる。
図のもう一つの要点は、二種類の記号の差だ。ルーティング専門家だけをマージしたもの(丸)のコストは、全テンソルのマージ(四角)より全体にずっと低い。ルーティング専門家をすべて R1 のものに置き換えても、コストは R1 の六割程度にとどまる。
しきい値:どの部品が重要か
に固定した全テンソルマージで、著者らはしきい値 を段階的に上げた。しきい値が低いと、注意とルーティング専門家のテンソルの大部分がマージされる。ある程度まで上げると、共有専門家のテンソルの多くが除外され、V3-0324 の値が残る。さらに上げると注意のテンソルも除外され、差の最も大きいルーティング専門家だけがマージされ続ける。
その結果、コストはしきい値とともに下がり続け、知能スコアはずっと安定したままだった。しきい値が高くなって R1 のルーティング専門家を大量に除外し始めたところで、ようやくスコアが下がり始める。
R1T-Chimera
以上の観察をまとめて、著者らは二つの仮説を立てる。第一に、R1 の推論能力は主にルーティング専門家に収められている。第二に、V3-0324 のその他の部分、つまり注意、共有専門家、密な層は、これらの専門家と協働するのに十分で、性能を目立って下げない。
そこで彼らは最も極端な設定を試した。ルーティング専門家だけをマージし、しかも として、ルーティング専門家を完全に R1 のものに置き換え、他はすべて V3-0324 のままにする。これが DeepSeek-R1T-Chimera だ。
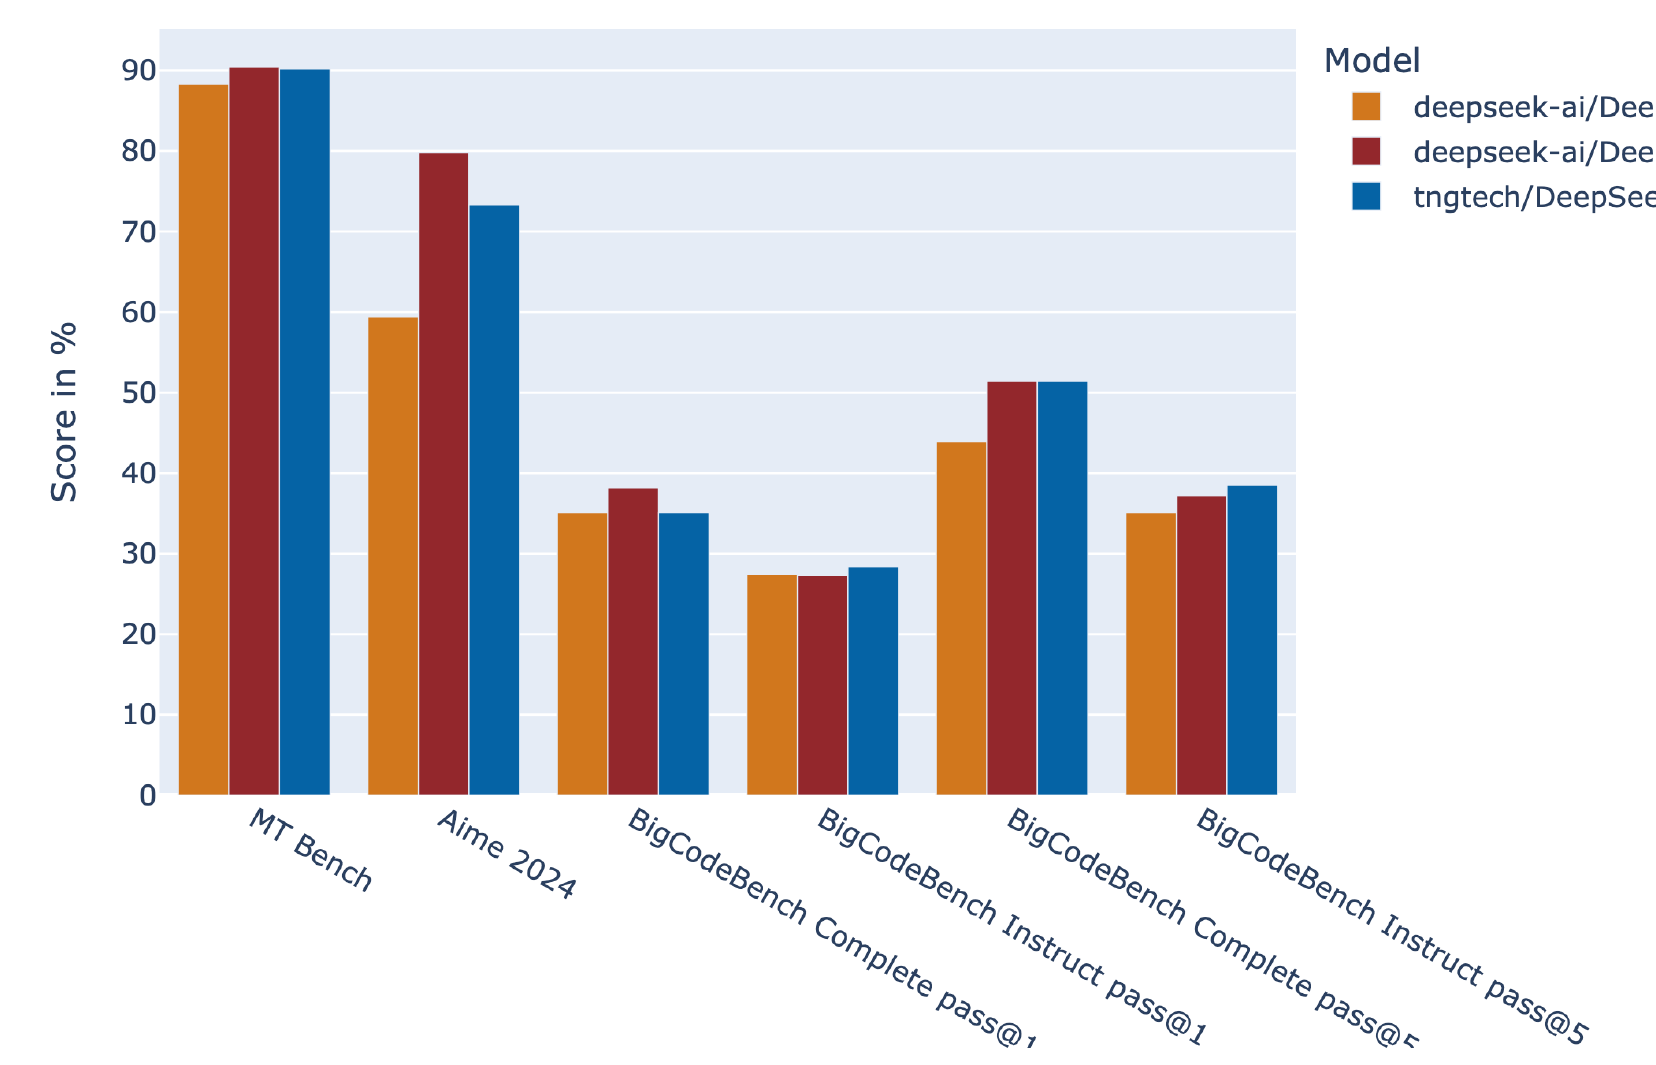
MT-Bench では三つがほぼ横並びだ。AIME 2024 では Chimera が約 73 点で、V3-0324 の約 59 点を大きく上回るが、R1 の約 80 点にはまだ及ばない。BigCodeBench の四つの下位項目では、Chimera はおおむね R1 と同等だった。出力 token は約四割少ない。
Chimera の思考過程は二つの親モデルのどちらよりも簡潔で整理されている、と著者らは述べるが、これは定性的な観察で、論文は数値化していない。
TNG はまず社内の GPU クラスタで R1 を Chimera に置き換え、その後に重みを公開した。論文によれば、2025 年 5 月末には、サーバーレス推論プラットフォームの Chutes を通じて、毎日 50 億近くの token を処理していた。
証拠の範囲
この論文の実験設計はかなり簡素で、覚えておくべきことがいくつかある。
- 評価が少なすぎる:パラメータ探索全体で、MT-Bench と AIME-2024 の二つのベンチマークしか使っていない。AIME-2024 は 30 問しかなく、一、二問の差が数パーセントポイントになる。論文は繰り返し回数も分散も報告していない。
- 「知能スコア」は独自の指標:モデルが審査する対話スコアと、数学コンテストのスコアをそのまま平均したもので、順位付けには使えても、能力の絶対的な物差しとしては粗すぎる。
- 親モデルの組は一つだけ:すべての観察は V3-0324 と R1 から来ており、「推論能力はルーティング専門家にある」という仮説は、他のモデルファミリーではまだ検証されていない。
関連研究の中で著者らは、Kimi k1.5 のチームが比較したところ、長さペナルティ付きの損失で微調整するほうが、長短二種類の推論モデルをマージするより、token を節約するモデルを作れたことにも触れている。マージの強みは安さにあり、最良であるとは限らない。
TNG は 2025 年 7 月に R1T2 Chimera も公開した。親モデルを三つ(R1-0528、R1、V3-0324)に変え、やはり V3-0324 の注意と共有層を引き継いでいる。
結論
この論文はモデルマージを 671B の規模で行い、MoE の構造を利用して「マージ」を「部品選び」に細分化した。R1 のルーティング専門家を V3-0324 の体に移植して、推論能力は R1 に近く、出力は四割短いモデルを得た。その間、勾配計算は一切していない。
最も面白いのは、途中で観察された相転移だ。推論能力はなめらかに変わるのに、思考過程を書く習慣は、R1 の比率が半分を超えた瞬間に突然現れる。
MoE モデルの部品はこうして分解して付け替えられるが、それは二つのモデルが同じベースから来ている場合に限る。別のファミリーの MoE 同士を縫い合わせたら、それこそ本当にただのつぎはぎの怪物だ。