原論文
Gemma 2: Improving Open Language Models at a Practical Size
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2408.00118
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformersgemma22024,
  title = {{Gemma 2: Improving Open Language Models at a Practical Size}},
  author = {Gemma Team and Morgane Riviere and Shreya Pathak and Pier Giuseppe Sessa and Cassidy Hardin and Surya Bhupatiraju and Léonard Hussenot and Thomas Mesnard and Bobak Shahriari and Alexandre Ramé and Johan Ferret and Peter Liu and Pouya Tafti and Abe Friesen and Michelle Casbon and Sabela Ramos and Ravin Kumar and Charline Le Lan and Sammy Jerome and Anton Tsitsulin and Nino Vieillard and Piotr Stanczyk and Sertan Girgin and Nikola Momchev and Matt Hoffman and Shantanu Thakoor and Jean-Bastien Grill and Behnam Neyshabur and Olivier Bachem and Alanna Walton and Aliaksei Severyn and Alicia Parrish and Aliya Ahmad and Allen Hutchison and Alvin Abdagic and Amanda Carl and Amy Shen and Andy Brock and Andy Coenen and Anthony Laforge and Antonia Paterson and Ben Bastian and Bilal Piot and Bo Wu and Brandon Royal and Charlie Chen and Chintu Kumar and Chris Perry and Chris Welty and Christopher A. Choquette-Choo and Danila Sinopalnikov and David Weinberger and Dimple Vijaykumar and Dominika Rogozińska and Dustin Herbison and Elisa Bandy and Emma Wang and Eric Noland and Erica Moreira and Evan Senter and Evgenii Eltyshev and Francesco Visin and Gabriel Rasskin and Gary Wei and Glenn Cameron and Gus Martins and Hadi Hashemi and Hanna Klimczak-Plucińska and Harleen Batra and Harsh Dhand and Ivan Nardini and Jacinda Mein and Jack Zhou and James Svensson and Jeff Stanway and Jetha Chan and Jin Peng Zhou and Joana Carrasqueira and Joana Iljazi and Jocelyn Becker and Joe Fernandez and Joost van Amersfoort and Josh Gordon and Josh Lipschultz and Josh Newlan and Ju-yeong Ji and Kareem Mohamed and Kartikeya Badola and Kat Black and Katie Millican and Keelin McDonell and Kelvin Nguyen and Kiranbir Sodhia and Kish Greene and Lars Lowe Sjoesund and Lauren Usui and Laurent Sifre and Lena Heuermann and Leticia Lago and Lilly McNealus and Livio Baldini Soares and Logan Kilpatrick and Lucas Dixon and Luciano Martins and Machel Reid and Manvinder Singh and Mark Iverson and Martin Görner and Mat Velloso and Mateo Wirth and Matt Davidow and Matt Miller and Matthew Rahtz and Matthew Watson and Meg Risdal and Mehran Kazemi and Michael Moynihan and Ming Zhang and Minsuk Kahng and Minwoo Park and Mofi Rahman and Mohit Khatwani and Natalie Dao and Nenshad Bardoliwalla and Nesh Devanathan and Neta Dumai and Nilay Chauhan and Oscar Wahltinez and Pankil Botarda and Parker Barnes and Paul Barham and Paul Michel and Pengchong Jin and Petko Georgiev and Phil Culliton and Pradeep Kuppala and Ramona Comanescu and Ramona Merhej and Reena Jana and Reza Ardeshir Rokni and Rishabh Agarwal and Ryan Mullins and Samaneh Saadat and Sara Mc Carthy and Sarah Cogan and Sarah Perrin and Sébastien M. R. Arnold and Sebastian Krause and Shengyang Dai and Shruti Garg and Shruti Sheth and Sue Ronstrom and Susan Chan and Timothy Jordan and Ting Yu and Tom Eccles and Tom Hennigan and Tomas Kocisky and Tulsee Doshi and Vihan Jain and Vikas Yadav and Vilobh Meshram and Vishal Dharmadhikari and Warren Barkley and Wei Wei and Wenming Ye and Woohyun Han and Woosuk Kwon and Xiang Xu and Zhe Shen and Zhitao Gong and Zichuan Wei and Victor Cotruta and Phoebe Kirk and Anand Rao and Minh Giang and Ludovic Peran and Tris Warkentin and Eli Collins and Joelle Barral and Zoubin Ghahramani and Raia Hadsell and D. Sculley and Jeanine Banks and Anca Dragan and Slav Petrov and Oriol Vinyals and Jeff Dean and Demis Hassabis and Koray Kavukcuoglu and Clement Farabet and Elena Buchatskaya and Sebastian Borgeaud and Noah Fiedel and Armand Joulin and Kathleen Kenealy and Robert Dadashi and Alek Andreev},
  year = {2024},
  eprint = {2408.00118},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2408.00118}
}
小さいモデルを強くする最もありふれた方法は、データをたくさん与えることだ。
Llama 3 の 8B モデルは 15T token を見ており、スケーリング則が勧める量をはるかに超えている。この手は効くが、効き目はどんどん薄れていく。報告は冒頭で、Chinchilla のスケーリング則に従えば、性能はおおむねデータ量の対数でしか伸びないと指摘する。最新の小さいモデルは大量のデータを追加しても、多くのベンチマークで 1~2 ポイントしか得ていない。
これは、小さいモデルがまだ訓練し足りないことも示している。問題は、データはいつか尽きることと、データを倍にするたびに訓練コストも倍になることだ。
Google DeepMind の Gemma チームは 2024 年 6 月に Gemma 2 を公開し、方向を変えた。小さいモデルにより多くの token を見せるのではなく、一つひとつの token からより多くを学ばせる。方法は知識蒸留で、大きいモデルの予測分布を本来の正解ラベルの代わりに使う。
Gemma 2 には 2B、9B、27B の三サイズがある。2B と 9B は蒸留で訓練し、27B はゼロから訓練した。
問題の定義
通常の言語モデルの訓練では、各位置でモデルに教えるのは、次の token が何かという一つのことだけだ。
例を挙げよう。「今日は__が飲みたい」で、訓練データの次の語が「コーヒー」なら、目標は「コーヒー」だけが 1、他がすべて 0 の one-hot ベクトルになる。しかし「お茶」や「水」も十分ありうるのに、one-hot の目標はそれらにまったく触れない。
すでに訓練済みの大きいモデルがあれば、「コーヒー 0.6、お茶 0.3、水 0.1」と言うかもしれない。この分布全体を目標にすれば、小さいモデルは同じ位置で「お茶でも通じる」ことまで学べる。著者らは蒸留の目的をはっきり書いており、蒸留で「利用可能な token 数を超える訓練をシミュレートする」のだという。
蒸留の損失関数は、教師分布 と生徒分布 の交差エントロピーだ。
は文脈で、和は語彙全体にわたる。教師分布を one-hot に置き換えると、この式は通常の次 token 予測に戻る。
このアイデア自体は新しくなく、Gemini 1.5 も蒸留を使っている。この報告が答えようとするのは、蒸留を大規模な事前訓練に使い、小さいモデルに最適量をはるかに超える token を見せたら、どれほど効くのかという問いだ。
問題を解く
アーキテクチャ
Gemma 2 は第一世代と同じくデコーダのみの Transformer で、コンテキスト長は 8,192、RoPE と近似版の GeGLU を使う。新しい設計は四つある。
- 局所注意と大域注意の交互配置。一層ごとに切り替え、局所層は 4,096 token のスライディングウィンドウを使い、大域層は 8,192 token 全体を見る。
- Logit soft-capping。注意層と最後の出力層では、logit がすべて を通る。上限は注意層で 50、出力層で 30 とする。
- 前後の両方で正規化。各サブレイヤーの入力と出力の両方に RMSNorm を使い、訓練を安定させる。
- グループ化クエリ注意(GQA)、グループ数は 2。
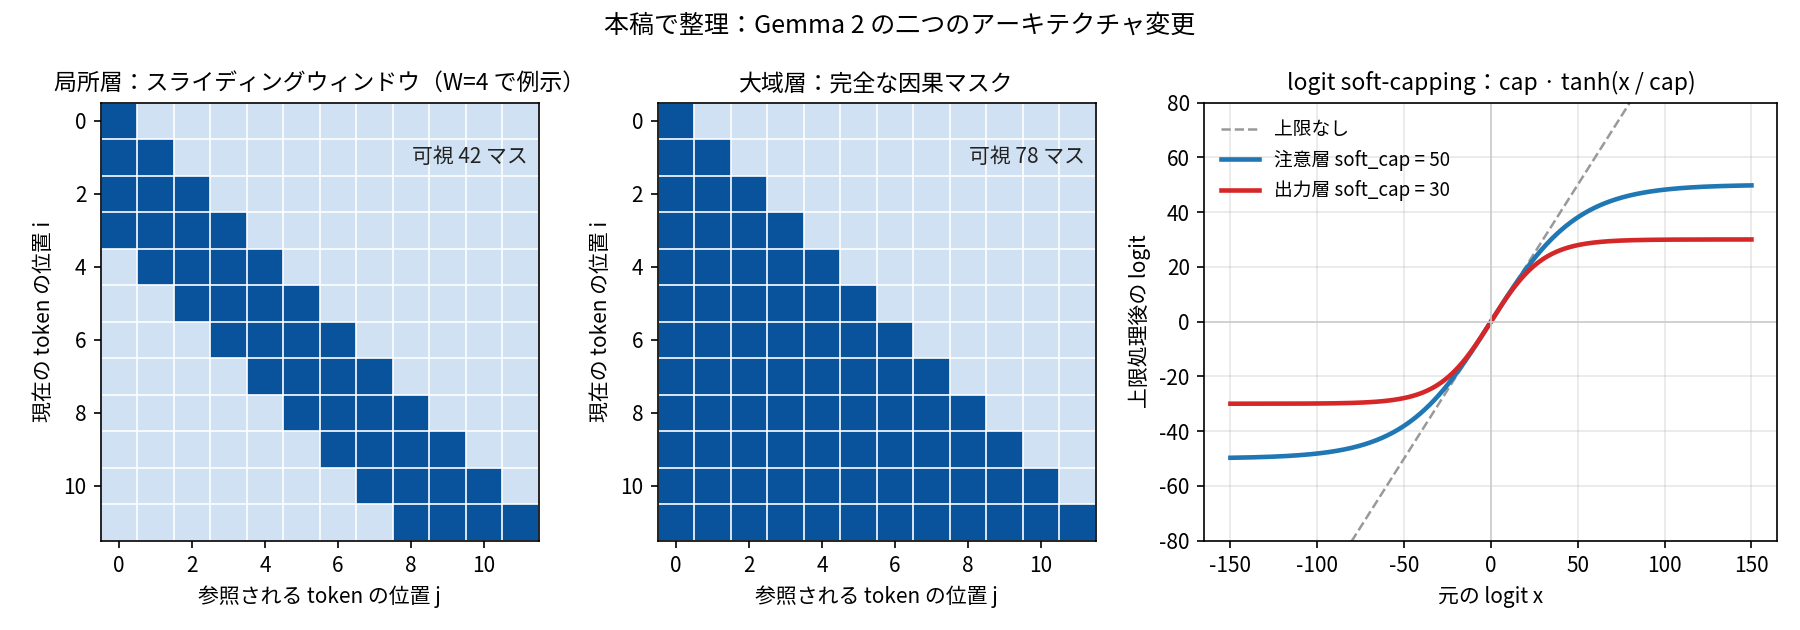
左の二枚のマスクは、局所層が何を節約するのかを示している。大域層の各 token はそれより前のすべての token を見られ、計算量は長さの二乗で増える。局所層の各 token はウィンドウ内の token しか見ず、量は一定だ。交互に使えば、半分の層で計算を節約しつつ、一層おきに全体を見る能力を保てる。
右図が soft-capping だ。logit が小さいときはほとんど影響を受けず、tanh は 0 付近で直線に近い。logit がとても大きいと上限付近に抑えられ、ある値が大きくなりすぎて softmax がほぼ一か所しか見なくなるのを防ぐ。この設計は訓練の安定性に役立つが、後で見るように、推論側でちょっとした面倒も引き起こした。
三つのモデルの構成は次のとおりだ(報告の Table 1 より)。
| 2B | 9B | 27B | |
|---|---|---|---|
| 隠れ次元 | 2,304 | 3,584 | 4,608 |
| 層数 | 26 | 42 | 46 |
| フィードフォワード層の次元 | 18,432 | 28,672 | 73,728 |
| 注意ヘッド / KV ヘッド | 8 / 4 | 16 / 8 | 32 / 16 |
| 語彙 | 256,128 | 256,128 | 256,128 |
語彙は Gemini の 256K token を引き継いでいる。もともと多数の言語に対応するための設計なので、埋め込み層のパラメータが多い。2B モデルでは約 5.9 億のパラメータが埋め込み層にあり、埋め込み以外のパラメータは約 20 億だ。
事前訓練データとハードウェア
27B は 13T token、9B は 8T、2B は 2T で訓練した。データは英語中心で、ウェブ、コード、科学論文を含む。Gemma 2 はマルチモーダルモデルではなく、多言語能力に向けた特別な訓練もしていない。
2B と 9B のデータ量は、どちらもスケーリング則が勧める量をはるかに超えている。よく使われる「1 パラメータあたり約 20 token」で粗く見積もると、2B の最適量は約 40B token で、実際には 2T を使っており、50 倍になる。9B は約 180B token で、実際には 8T を使っており、こちらも四十数倍だ。
訓練には Google 自社の TPU を使った。2B は 512 個の TPUv5e、9B は 4,096 個の TPUv4、27B は 6,144 個の TPUv5p。報告は、Gemma 2 の事前訓練全体の炭素排出量を CO2 換算で約 1,248 トンと見積もっている。
後訓練:最後の一歩は平均
後訓練は三段階に分かれる。
- SFT:合成と実際のプロンプトを使い、回答は主により大きな教師モデルが生成する。加えて、生徒自身の出力分布の上でも蒸留を行う。
- RLHF:報酬モデルは方策モデルより一桁大きく、多ターン対話をより重視する。プロンプトの一部に LMSYS-Chat-1M を使うが、プロンプトだけを取り、そこに含まれる回答は使わない。
- モデルマージ:異なるハイパーパラメータで全工程を通して得たモデルを平均する。
三段階目が引用しているのは、同じチームの Ramé らによる WARP だ。報告は一文で触れるだけで、マージ前後の比較は示していない。
議論
蒸留はどれほど役に立つのか
報告のアブレーションは多くないが、どれも一つの設計判断に狙いを定めている。最も重要なのは蒸留だ。
| 2B モデル、500B token で訓練 | ゼロから訓練 | 7B 教師から蒸留 |
|---|---|---|
| 三ベンチマークの平均 | 60.3 | 67.7 |
500B token はすでに 2B モデルの最適量の 10 倍だが、それでも蒸留は 7.4 ポイント上回る。ここで 7B を教師にしたのは、「27B が 9B を教える」サイズ比をシミュレートするためだ。
蒸留の利点は、モデルが大きくなると消えてしまうのだろうか。著者らは 7B の教師を固定し、200M、400M、1B の三種類の生徒を訓練した。
| 検証パープレキシティ | 200M | 400M | 1B |
|---|---|---|---|
| ゼロから訓練 | 23 | 19 | 17 |
| 蒸留 | 21 | 17 | 15 |
三サイズとも安定して 2 低く、差は縮まらなかった。
本番モデルの比較でも同じだ。Gemma 2 の 2B は 2T token、第一世代の 2B は 3T token を使った。データは少ないのに、新しいモデルは各ベンチマークで明らかによい。9B は一部のベンチマークで第一世代の 7B より約 10% 高い。著者らはこれを蒸留の功績とする。
ただし、第一世代と第二世代の間では、蒸留以外にもアーキテクチャ、データ、後訓練が変わっており、この比較だけで功績を蒸留に帰すことはできない。本当にきれいな証拠は上の二つのアブレーション表で、しかもどちらも本番モデルよりずっと小さい設定で行われている。
その他のアーキテクチャのアブレーション
- GQA とマルチヘッド注意:9B モデルの四ベンチマーク平均は、マルチヘッド注意が 50.3、GQA が 50.8 で、差は小さい。著者らが GQA を選んだのは、パラメータが少なく推論が速いからだ。
- 深さと幅:同じパラメータ数の 9B で、深い版は平均 52.0、広い版は 50.8。差は小さいが一貫しており、そのため Gemma 2 は第一世代より深い。
- 推論時にスライディングウィンドウを縮める:9B モデルのウィンドウを 4,096 から 2,048、1,024 に縮めても、パープレキシティは 1.63 から 1.63、1.64 に変わるだけだ。必要なら、ウィンドウを縮めて推論速度を少し稼げる。
- 書式に対する安定性:12 通りのプロンプトと評価書式の組合せで、MMLU スコアの標準偏差は Gemma 2 の 9B が 0.9、27B が 1.0 で、Mistral 7B は 6.9 だった。
成績
事前訓練版の 27B を Hugging Face の評価セットで Llama 3 70B と比べると、MMLU 75.2 対 79.2、GSM8K 74.0 対 76.9、HellaSwag 86.4 対 88.0 だった。モデルは 2.5 倍小さく、訓練データの 13T token も Llama 3 の 15T より少ないのに、数ポイント遅れるだけだ。ゼロから訓練したモデルの性能はおおむねサイズの対数でしか伸びず、27B は Llama 3 と同じパレート曲線上にあるのかもしれない、と著者らは率直に述べている。
後訓練版で最も注目されたのは、LMSYS Chatbot Arena での成績だ。27B の Elo は 1218 で、Llama 3 70B の 1206 より高い。9B は 1187 で、GPT-4-0314 の 1186 と同等。2B(厳密には 2.6B)は 1126 で、GPT-3.5-Turbo-0613 の 1116 より高い。
これらの比較はすべて総パラメータ数で計算している。一般的な機器でオープンモデルを使うとき、制約になるのはたいてい活性化パラメータではなくメモリの総使用量だからだ、と著者らはわざわざ説明している。
人手評価と記憶
Arena とは別に、著者らは人手評価を二組行った。単一ターンのプロンプトでは、安全性と指示追従を GPT-4o と比較した。多ターンでは、評価者が 500 の多ターン対話シナリオで、全体の満足度と目標の達成度に 1~5 点を付けた。第一世代の Gemma 1.1 7B と比べ、Gemma 2 の三サイズはどちらの指標でもよく、たとえば 27B ではユーザー満足度が 3.32 から 4.20 に上がった。
報告は、モデルが訓練データをどれだけ逐語的に記憶しているかも測った。訓練データのある一節から先頭 50 token を与え、続く 50 token をそのまま吐き出すかを見る。Gemma 2 の逐語的な記憶率は 0.1% 未満で、同クラスの他のモデルより明らかに低い。編集距離 10% をしきい値とする近似的な記憶率はそれより高いが、それでも第一世代 Gemma の逐語的な記憶率より低い。データの出所別に見ると、コード、Wikipedia、科学論文がより多く記憶されていた。
Soft-capping の実際のコスト
Soft-capping は論文では二行しか占めていないが、コミュニティでは少なからぬ面倒を引き起こした。
Gemma 2 の公開時、主流の FlashAttention 実装はどれも注意スコアへの soft-capping に対応していなかった。Hugging Face はリリースノートで、FlashAttention による高速化をあきらめるか、性能を犠牲にするかのどちらかになると注意を促した。llama.cpp は soft-capping を加える修正で、Gemma 2 を読み込むと FlashAttention をそのままオフにするようにし、変換済みの GGUF ファイルも作り直す必要があった。公開初期には Hugging Face 上でも、27B の出力に誤字や幻覚が出るという報告があり、議論スレッドが指していた修正は、推論側にこの一段を補うことだった。
一見無害な安定化の工夫一つのために、推論のエコシステム全体が追いつくまで数週間かかった。
この報告が語らないこと
報告は事前訓練データの具体的な構成を説明しておらず、2B と 9B の教師がそれぞれどのモデルなのかも書いていない。アブレーションの書きぶりから、著者らが「27B が 9B を教える」を目標の比率にしていたことはうかがえるが、本番の教師が何かは明記されていない。後訓練のデータ、ハイパーパラメータ、モデルマージの詳細も、数文しかない。
結論
Gemma 2 の言いたいことは複雑ではない。小さいモデルはデータを多く見るより、一つひとつの token により多くの情報を持たせたほうがよい。大きいモデルの確率分布を訓練目標にし、2B と 9B を最適量をはるかに超えるデータで蒸留して、同クラス最高の成績を得た。
アーキテクチャの変更、つまり局所と大域の交互配置、soft-capping、前後の正規化は、どれも新発明ではないが、組み合わせると実に実用的だ。
Gemma 2 をデプロイする前に、推論フレームワークが soft-capping を実装しているか確かめておこう。tanh が一つ欠けるだけで、モデルは誤字を書き始める。