原論文
What is being transferred in transfer learning?
- 発表先
- NeurIPS 2020国際会議
- arXiv への初回投稿
- arXiv:2008.11687
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modeltuningwhatistransferred2020,
  title = {{What is being transferred in transfer learning?}},
  author = {Behnam Neyshabur and Hanie Sedghi and Chiyuan Zhang},
  year = {2020},
  eprint = {2008.11687},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2008.11687}
}
ImageNet の事前訓練重みから微調整するのは、コンピュータビジョンのほぼ定番の第一手だ。
写真の分類にも、医用画像にも、手描きの落書きにさえ使う。効くことは誰もが知っており、よくある説明は「特徴の再利用」だ。事前訓練がエッジ、テクスチャ、形状を学び、下流タスクがそれをそのまま使うというものである。
しかし、この説明には明らかな穴がある。胸部 X 線画像は ImageNet の写真とまるで似ておらず、落書きに至っては数本の線にすぎない。それなのに、なぜ事前訓練が役に立つのか。
Google の Neyshabur、Sedghi、Zhang の三人は一連の実験を設計し、「事前訓練はいったい何を持ち込んでいるのか」を測定可能ないくつかの問いに分解した。その答えの一つが、後にモデルマージの重要な根拠になる。
問題の定義
著者らはモデルを四種類に分ける。以下ではこの略称をずっと使う。
- P:ImageNet で事前訓練済みのモデル。
- RI:ランダム初期化のモデル。
- P-T:P から出発し、対象データで微調整(fine-tune)したモデル。
- RI-T:RI から出発し、対象データで直接訓練したモデル。
対象タスクには、ImageNet からの距離が異なる四つのデータセットを選んだ。DomainNet の real(実写の写真)、clipart(クリップアート)、quickdraw(Google のゲーム「Quick, Draw!」でプレイヤーが描いた落書き)、そして CheXpert の胸部 X 線画像で、後になるほど自然な写真から離れる。
DomainNet の各ドメインには 345 の物体クラスがあり、著者らはそれぞれ訓練用に 5 万枚、テスト用に 5 万枚を抽出する。CheXpert では訓練集合から 5 万枚ずつ二組を抽出して訓練とテストに使い、タスクは五種類の胸部所見の判定だ。
モデルはすべて ResNet-50 で、Fixup 初期化を使い、BatchNorm 層はすべて取り除いている。
答えるべき問いは三つある。事前訓練の利点のうち、どれだけが特徴の再利用によるのか。P-T と RI-T はパラメータ空間で何が違うのか。ネットワークのどの部分が本当に転移しているのか。
問題を解く
まず学習曲線を見る
四つの対象タスクのいずれでも、P-T は RI-T よりよく、収束もずっと速い。差が最も大きいのは real で、特徴の再利用という直感に合う。なにしろ実写の写真は ImageNet に一番近い。
だが CheXpert と quickdraw でも改善がある。少なくともこの二つのタスクでは、「視覚特徴の再利用」だけではすべてを説明しきれないようだ。
画像をバラバラにする
特徴の再利用を切り分けるため、著者らはごく直接的な実験を行った。対象データの画像を同じ大きさのブロックに切り、位置をランダムに入れ替える。
224×224 のブロックはシャッフルしないのと同じで、ブロックが小さいほど物体の形と構造は徹底的に壊れる。1×1 では全画素がばらばらになるが、一つの画素の RGB 三値はまだまとまって動く。そこで著者らは「*」という設定も加え、各チャネルの画素が個別に動き、ほかのチャネルにまで移るようにした。
「*」になると、画像に残るのは画素値の分布だけで、視覚的な構造は一切なくなる。事前訓練で学んだエッジやテクスチャが役立つはずはない。
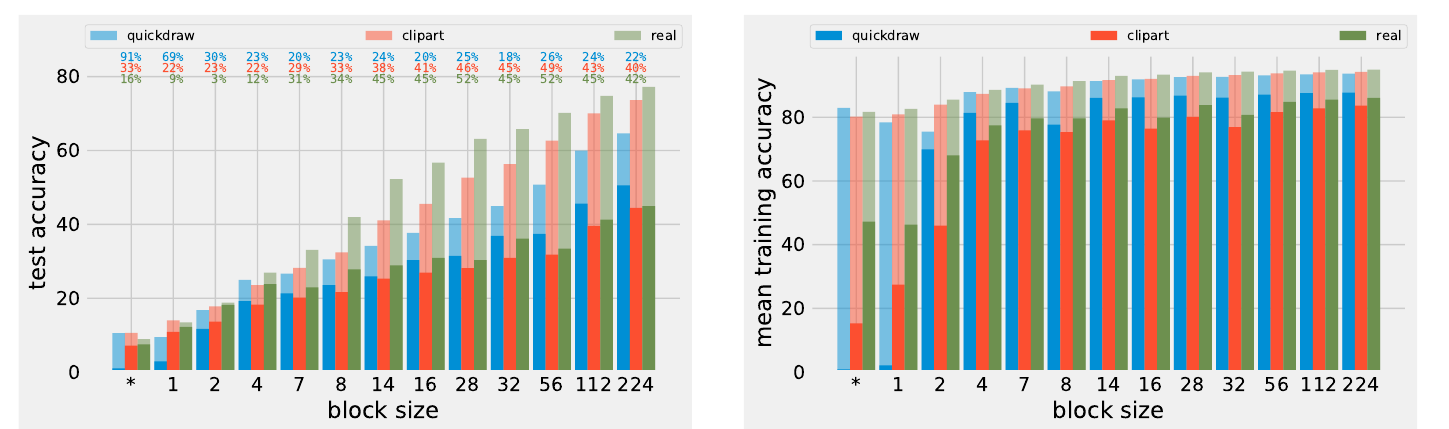
一番見るべきは、左図上部の三段の小さな数字だ。これは相対的な精度差 、つまり事前訓練による利点がどれだけの割合を占めるかを示す。
real(緑)はシャッフルなしで 42%、ブロックを 2 まで縮めると 3% になる。clipart(赤)も 40% 前後から 20% 強へ下がる。ブロックが小さいほど事前訓練の利点は減る。これが特徴の再利用の証拠だ。
quickdraw(青)は違う。ほとんどのブロックサイズで 20%~25% 前後を保ち、ブロックが小さくなっても下がらない。1×1 と「*」では、数字がかえって 69% と 91% に跳ね上がる。この二つでは RI-T がほとんど学習できないため、相対差がこれほど大きくなる。
右図は訓練の速さだ。P-T の訓練精度はブロックがどれほど小さくても安定しているが、RI-T は小さなブロックで大きく下がる。「*」の設定では、quickdraw の RI-T の平均訓練精度はほぼゼロで、P-T はなお 80% 以上ある。
この図は、事前訓練の利点を二つの部分に分ける。
- 特徴の再利用:事前訓練データに似ているほど寄与が大きく、画像の構造が壊れると消える。
- 低レベルの統計:画素値の分布しか残っていなくても、事前訓練重みは訓練をずっと速くし、最終精度を高めることもある。
著者らは後者を「低レベルの統計」と呼び、視覚的・意味的な構造を一切含まないことを強調する。事前訓練重みのどの性質、例えば重みのスケールなどが最適化を助けているのかについて、論文はそれ以上分解していない。
モデルの中を開けてみる
次に著者らは、訓練済みのモデルそのものを比較する。
誤りの重なり。 二つの P-T(異なる乱数シードで微調整)の誤りはよく似ている。P-T と RI-T の間では、一致しない誤りがずっと多い。著者らが DomainNet の例を見ると、P-T が誤り RI-T が正解した標本の多くは曖昧な画像で、P-T が正解し RI-T が誤った標本には簡単な画像が少なからず含まれていた。
特徴の類似度。 著者らは CKA(centered kernel alignment)で、二つのモデルの同じ層が出力する特徴を比べる。CheXpert での Table 1 は次のとおりだ。
| 比較対象 | conv1 | layer 1 | layer 2 | layer 3 | layer 4 |
|---|---|---|---|---|---|
| P-T & P | 0.6225 | 0.4592 | 0.2896 | 0.1877 | 0.0453 |
| P-T & P-T | 0.6710 | 0.8230 | 0.6052 | 0.4089 | 0.1628 |
| P-T & RI-T | 0.0036 | 0.0011 | 0.0022 | 0.0003 | 0.0808 |
| RI-T & RI-T | 0.0016 | 0.0088 | 0.0004 | 0.0004 | 0.0424 |
二つの P-T はどの層でもよく似ている。二つの RI-T も精度は悪くないが、特徴はほとんど似ていない。出力側に近づくほど P-T と P の類似度は下がり、微調整が主に上位層を変えていることを示す。
パラメータ距離。 二つの P-T はパラメータ空間でも近い。CheXpert では二つの P-T の 距離が約 200、二つの RI-T では約 255 だ。DomainNet の三ドメインでは差がさらに明確で、二つの P-T は 178~219、二つの RI-T は 777~822 になる。
同じ盆地
これがモデルマージに最も関係する節だ。著者らは二つの解 と の間を線形補間し、経路上のモデルの性能を見る。
二つの解が同じ平坦な盆地にあれば、補間の経路も盆地の中にとどまり、性能は落ちない。
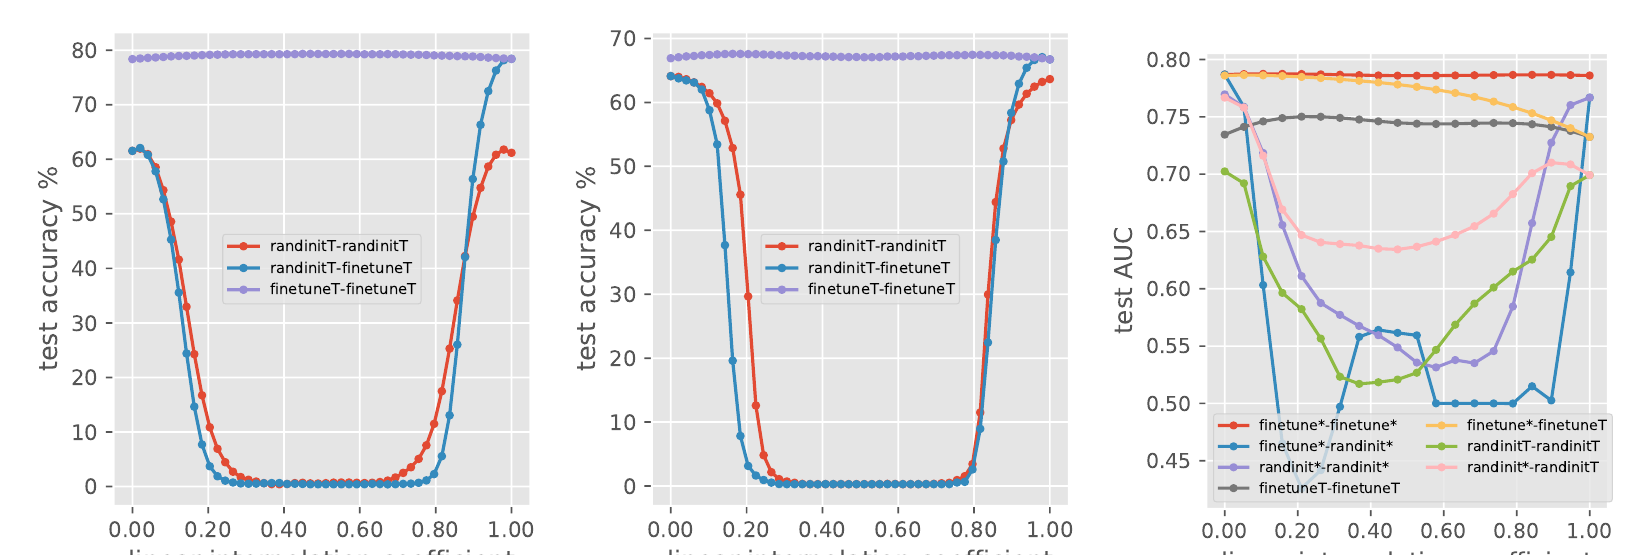
左の二つの図は読みやすい。real では、二つの P-T の間の紫の線が最初から最後まで 80% 付近にあり、二つの RI-T の間の赤い線は中ほどでほぼゼロまで落ちる。quickdraw も同じだ。
さらに興味深いのは、著者らが二つの RI-T にまったく同じランダム初期値を使わせ、訓練過程のランダム性だけを変えても、やはり障壁が現れたことだ。出発点を共有するだけでは足りず、その出発点は事前訓練済みでなければならない。CheXpert では、RI-T は同じ訓練軌跡の最良の checkpoint と最終 checkpoint の間にさえ小さな障壁があり、P-T にはない。
著者らは「盆地」を正式に定義することも試み、-basin と呼ぶ。ある凸集合が盆地と見なされるには、その中の多くの点の損失が平均に近く、集合の境界にガウスノイズを加えたり外側へ延ばしたりすると、損失がはっきり上がらなければならない。テスト誤り率を損失とすると、二つの P-T が属する盆地のパラメータは、real が 、clipart が 、quickdraw が だ。二つの RI-T については、同じ盆地に入るような妥当な が見つからない。
補間経路の中ほどのモデルは、両端より少しよいことさえある。同じ事前訓練の出発点から微調整したモデルは、そのまま平均できる。これが、この論文で後続研究に最も役立った観察だ。
どの層が転移しているか
著者らは Zhang らの方法にならい、訓練済みネットワークのあるモジュールだけを初期値へ巻き戻し、他のモジュールは訓練後の値のままにして、性能がどれだけ落ちるかを見る。大きく落ちるモジュールを「重要」なモジュールと呼ぶ。
CheXpert では、P-T の重要なモジュールの分布は通常の教師あり訓練とほぼ同じで、違いは全結合層が P-T にとって重要になる点だけだ。分類ヘッドは新しいタスクのために初めて訓練されるので、これは妥当である。
著者らはさらに Chatterji らのモジュール重要度の定義を拡張し、初期値から最適値へ向かう経路上で、モジュールのパラメータがどれだけのノイズに耐えられるかを測る。出力に近いモジュールほど谷が狭く、むやみに動かせない。入力に近いモジュールは比較的余裕がある。これは「下位層は汎用的な特徴、上位層はタスク固有の特徴を学ぶ」という以前からの観察と呼応し、特徴の再利用が主に入力に近い層で起きることも示している。
RI-T のモジュールには、経路上に転換点も現れ、谷がそこで広がったり狭まったりする。著者らは訓練途中で盆地が変わったことと関係するのではと推測しているが、はっきりとは説明できていない。
事前訓練はどこまで続けるべきか
最後の実験は実用的だ。著者らは ImageNet の事前訓練の各エポックの checkpoint を取り、それぞれ微調整する。事前訓練では第 30、60 エポックで学習率を減衰させている。
全体の傾向は後の checkpoint ほどよいというものだが、細かい点がいくつかある。
- 学習率減衰の前後の数個の checkpoint(例えば 29、30、31)では、微調整の結果はほぼ同じだ。事前訓練の精度は減衰時に大きく跳ね上がるが、下流への効果は同じようには上がらない。
- 訓練の速さの利点は checkpoint 10 あたりでほぼ飽和する。最終精度は real と clipart では checkpoint 60 前後まで上がり続ける。quickdraw の最終精度はかなり早く、checkpoint 10 で頭打ちになる。
- したがって、事前訓練モデル自身の精度は、転移効果の信頼できる指標とは限らない。
著者らはこれらの結果を盆地の観察と結びつける。事前訓練の初期の checkpoint はまだ最終的な盆地の外にあり、盆地に入った後は、どの checkpoint から出発してもあまり変わらない。だから比較的早い checkpoint から微調整を始めてもよい。
議論
これは分析型の論文で、新しい手法は提案していない。価値は、実際に使えるいくつかの観察にある。
証拠の範囲は覚えておきたい。すべての実験はアーキテクチャが一つ(BatchNorm なしの ResNet-50)、事前訓練の出所が一つ(ImageNet)で、対象タスクは四つの画像データセットだ。著者らは関連研究の節で、NLP の転移学習はデータの性質、事前訓練の方法、分布の隔たりのいずれも異なり、この論文は視覚だけを扱うと明言している。
「低レベルの統計」も記述にすぎない。画像をバラバラにしても何らかの利点が残ることはわかるが、効いているのが画素の分布なのか、重みのスケールなのか、それとも他の最適化上の性質なのかを、論文は切り分けて検証していない。モジュール重要度の転換点についても、著者らは推測を残しただけだ。
影響が最も大きかったのは「同じ盆地」という観察だ。著者らは結論で、同じ盆地内のモデルを平均しても性能は損なわれないと一文で触れただけだった。二年後、Model Soups はこれを実際の手法にした。異なるハイパーパラメータで微調整した多数のモデルをそのまま平均し、平均が成り立つ根拠としてこの論文を引用している。
結論
事前訓練が持ち込むものは二種類ある。一つは視覚特徴で、下流データが ImageNet に似ているほど役立つ。もう一つは画素までバラバラにしても残る低レベルの統計で、主に訓練を速くする。
同じ事前訓練重みから出発した微調整モデルは、互いに特徴が近く、パラメータ距離も近く、線形補間に障壁がない。ゼロから訓練したモデルは、同じランダム初期値を共有していても、こうはならない。
次に同じ事前訓練モデルから微調整した重みを二つ手にしたら、すぐにどちらかを選ばないでほしい。試しに平均してみよう。二つとも真ん中のモデルにかなわないかもしれない。