原論文
Command A: An Enterprise-Ready Large Language Model
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2504.00698
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformerscommanda2025,
  title = {{Command A: An Enterprise-Ready Large Language Model}},
  author = {Team Cohere and Aakanksha and Arash Ahmadian and Marwan Ahmed and Jay Alammar and Milad Alizadeh and Yazeed Alnumay and Sophia Althammer and Arkady Arkhangorodsky and Viraat Aryabumi and Dennis Aumiller and Raphaël Avalos and Zahara Aviv and Sammie Bae and Saurabh Baji and Alexandre Barbet and Max Bartolo and Björn Bebensee and Neeral Beladia and Walter Beller-Morales and Alexandre Bérard and Andrew Berneshawi and Anna Bialas and Phil Blunsom and Matt Bobkin and Adi Bongale and Sam Braun and Maxime Brunet and Samuel Cahyawijaya and David Cairuz and Jon Ander Campos and Cassie Cao and Kris Cao and Roman Castagné and Julián Cendrero and Leila Chan Currie and Yash Chandak and Diane Chang and Giannis Chatziveroglou and Hongyu Chen and Claire Cheng and Alexis Chevalier and Justin T. Chiu and Eugene Cho and Eugene Choi and Eujeong Choi and Tim Chung and Volkan Cirik and Ana Cismaru and Pierre Clavier and Henry Conklin and Lucas Crawhall-Stein and Devon Crouse and Andres Felipe Cruz-Salinas and Ben Cyrus and Daniel D'souza and Hugo Dalla-Torre and John Dang and William Darling and Omar Darwiche Domingues and Saurabh Dash and Antoine Debugne and Théo Dehaze and Shaan Desai and Joan Devassy and Rishit Dholakia and Kyle Duffy and Ali Edalati and Ace Eldeib and Abdullah Elkady and Sarah Elsharkawy and Irem Ergün and Beyza Ermis and Marzieh Fadaee and Boyu Fan and Lucas Fayoux and Yannis Flet-Berliac and Nick Frosst and Matthias Gallé and Wojciech Galuba and Utsav Garg and Matthieu Geist and Mohammad Gheshlaghi Azar and Ellen Gilsenan-McMahon and Seraphina Goldfarb-Tarrant and Tomas Goldsack and Aidan Gomez and Victor Machado Gonzaga and Nithya Govindarajan and Manoj Govindassamy and Nathan Grinsztajn and Nikolas Gritsch and Patrick Gu and Shangmin Guo and Kilian Haefeli and Rod Hajjar and Tim Hawes and Jingyi He and Sebastian Hofstätter and Sungjin Hong and Sara Hooker and Tom Hosking and Stephanie Howe and Eric Hu and Renjie Huang and Hemant Jain and Ritika Jain and Nick Jakobi and Madeline Jenkins and JJ Jordan and Dhruti Joshi and Jason Jung and Trushant Kalyanpur and Siddhartha Rao Kamalakara and Julia Kedrzycki and Gokce Keskin and Edward Kim and Joon Kim and Wei-Yin Ko and Tom Kocmi and Michael Kozakov and Wojciech Kryściński and Arnav Kumar Jain and Komal Kumar Teru and Sander Land and Michael Lasby and Olivia Lasche and Justin Lee and Patrick Lewis and Jeffrey Li and Jonathan Li and Hangyu Lin and Acyr Locatelli and Kevin Luong and Raymond Ma and Lukáš Mach and Marina Machado and Joanne Magbitang and Brenda Malacara Lopez and Aryan Mann and Kelly Marchisio and Olivia Markham and Alexandre Matton and Alex McKinney and Dominic McLoughlin and Jozef Mokry and Adrien Morisot and Autumn Moulder and Harry Moynehan and Maximilian Mozes and Vivek Muppalla and Lidiya Murakhovska and Hemangani Nagarajan and Alekhya Nandula and Hisham Nasir and Shauna Nehra and Josh Netto-Rosen and Daniel Ohashi and James Owers-Bardsley and Jason Ozuzu and Dennis Padilla and Gloria Park and Sam Passaglia and Jeremy Pekmez and Laura Penstone and Aleksandra Piktus and Case Ploeg and Andrew Poulton and Youran Qi and Shubha Raghvendra and Miguel Ramos and Ekagra Ranjan and Pierre Richemond and Cécile Robert-Michon and Aurélien Rodriguez and Sudip Roy and Sebastian Ruder and Laura Ruis and Louise Rust and Anubhav Sachan and Alejandro Salamanca and Kailash Karthik Saravanakumar and Isha Satyakam and Alice Schoenauer Sebag and Priyanka Sen and Sholeh Sepehri and Preethi Seshadri and Ye Shen and Tom Sherborne and Sylvie Shang Shi and Sanal Shivaprasad and Vladyslav Shmyhlo and Anirudh Shrinivason and Inna Shteinbuk and Amir Shukayev and Mathieu Simard and Ella Snyder and Ava Spataru and Victoria Spooner and Trisha Starostina and Florian Strub and Yixuan Su and Jimin Sun and Dwarak Talupuru and Eugene Tarassov and Elena Tommasone and Jennifer Tracey and Billy Trend and Evren Tumer and Ahmet Üstün and Bharat Venkitesh and David Venuto and Pat Verga and Maxime Voisin and Alex Wang and Donglu Wang and Shijian Wang and Edmond Wen and Naomi White and Jesse Willman and Marysia Winkels and Chen Xia and Jessica Xie and Minjie Xu and Bowen Yang and Tan Yi-Chern and Ivan Zhang and Zhenyu Zhao and Zhoujie Zhao},
  year = {2025},
  eprint = {2504.00698},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2504.00698}
}
Cohere は企業顧客を中心とするカナダの言語モデル企業で、共同創業者の一人 Aidan Gomez は「Attention Is All You Need」の共著者だ。同社のモデルは検索拡張生成(RAG)、ツール利用、多言語を売りにしており、チャットのランキングで一位を争うより、企業の実際の場面で使いやすく、デプロイしやすいことを重視している。
2025 年 3 月、Cohere は Command A を公開した。1,110 億パラメータのモデルで、23 の商用言語に対応し、A100 または H100 が二枚あればデプロイできる。重みは非商用ライセンス(CC-BY-NC)で、研究用に公開されている。
この技術報告の重点は後訓練の流れにある。一般的なやり方は、一つのモデルに SFT、選好学習、強化学習を順に施すことだ。Command A では、複数のチームがそれぞれ別の能力を得意とする専門モデルを訓練し、最後にモデルマージで一つにまとめる。報告によれば、この規模でモデルマージを後訓練の中核に据えたのは初めてだという。
問題の定義
企業で使う言語モデルは、多くのことを同時にこなす必要がある。文書を読んで質問に答える、ツールを呼び出す、コードを書く、数学を解く、多言語を話す、安全規範を守る、そしてとても長いコンテキストを扱う。
これらの能力は、訓練のやり方が大きく違う。コードと数学は検証しやすく、データを大量に合成でき、検証可能な報酬で強化学習ができる。安全性と RAG は主に人手のラベルに頼り、データ量がずっと少ないので、選好比較での訓練に向いている。これらのデータを全部混ぜ、同じハイパーパラメータで一つのモデルを訓練しても、すべての項目を最良にするのは難しい。
組織にも同じ問題がある。複数のチームが同時に別々の能力を改善するとき、全員が同じモデルの上で作業すれば、互いの実験が干渉し合い、進捗も互いに待たなければならない。
各能力をそれぞれ最良まで訓練し、それから安く一つにまとめられないだろうか。これが報告全体の問いだ。
問題を解く
アーキテクチャと事前訓練
まず土台を手早く見ておこう。Command A はデコーダのみの Transformer で、主な設計は三つある。
- 交互に並ぶ注意層:4 層ごとに 3 層がスライディングウィンドウ注意、1 層が系列全体を見る完全注意で、比率は 3:1。スライディングウィンドウ層は RoPE を使い、完全注意層は位置符号化を一切使わない(NoPE)。
- 並列の Transformer ブロック:注意とフィードフォワードネットワークを、直列につなぐのではなく並列に計算する。著者らによれば、性能は同等で、スループットは明らかに上がる。
- その他:GQA、SwiGLU、バイアス項なし、入力と出力で埋め込み行列を共有。語彙は 255,000 token あり、埋め込みを共有すれば大量のメモリを節約できる。
訓練では µP を使って小さいモデルでハイパーパラメータを調整し、そのまま大きいモデルへ移す。主要な行列積は FP8 で計算する。著者らは不安定さを観察しなかったが、最初から最後まで FP8 で通すと下流の性能がやや落ちるので、まず BF16 でしばらく訓練してから FP8 に切り替えた。事前訓練の最後にはクールダウン期間があり、学習率は 50,000 ステップで から に下がる。コンテキスト長はまず 8K のまま保ち、その後 32K、128K、256K へと段階的に伸ばす。
後訓練:二回のマージ
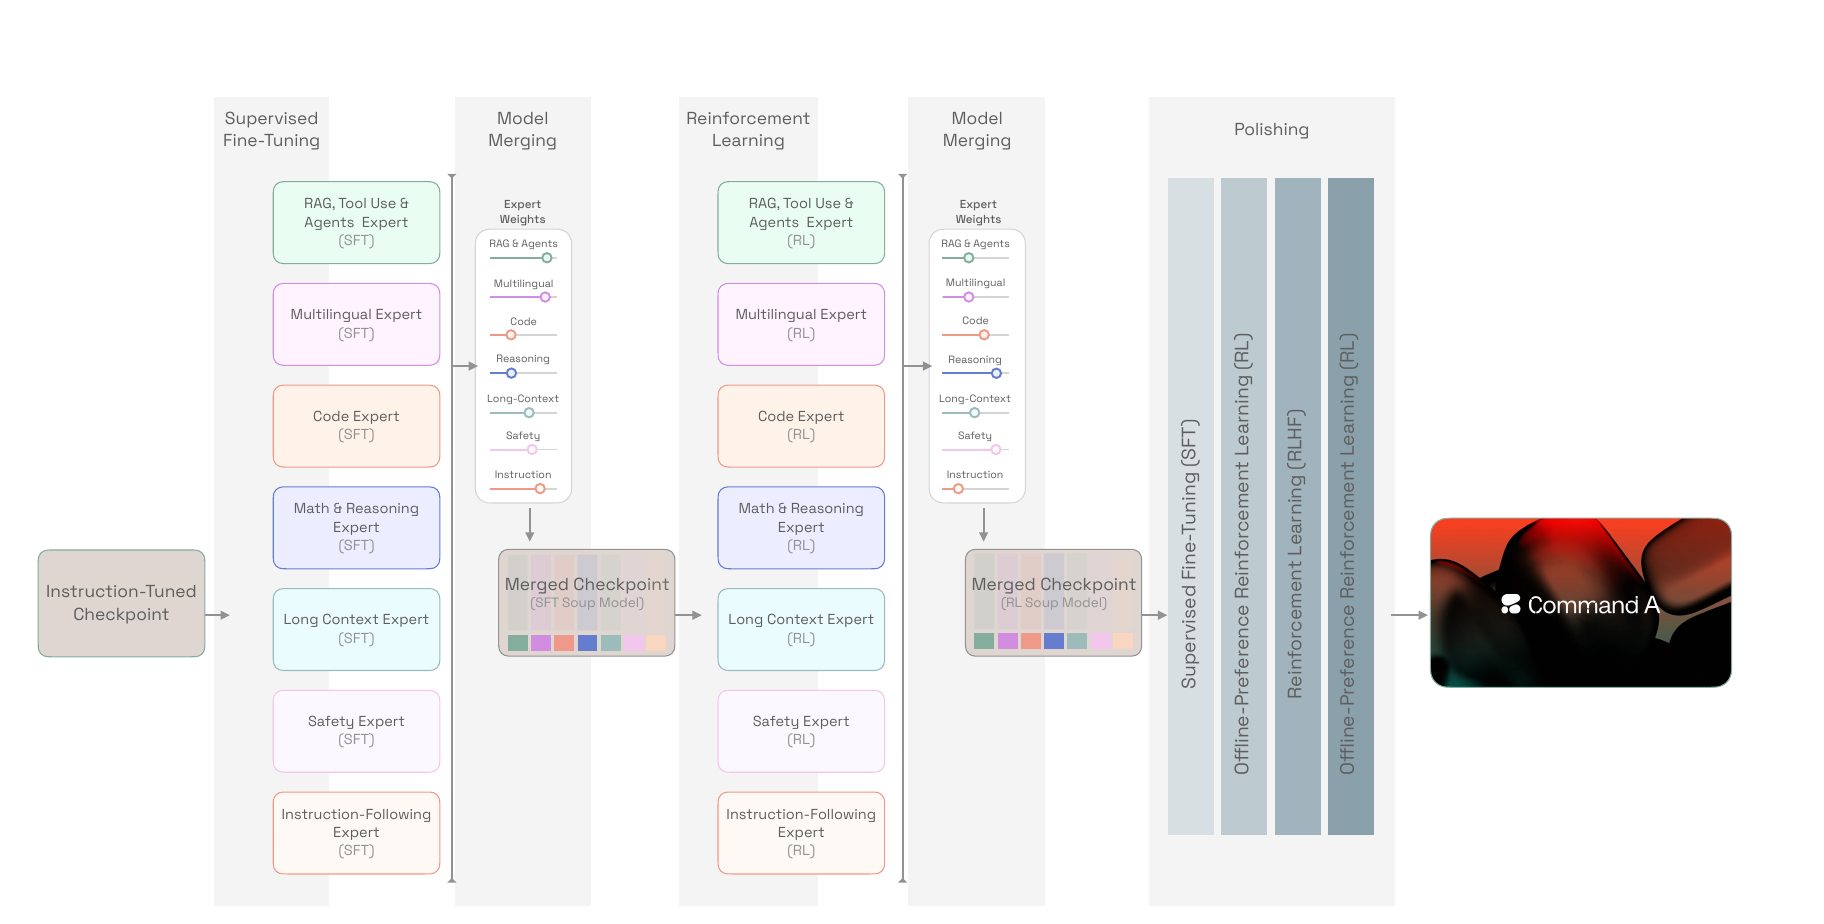
この図は左から右へ読む。
- 指示モデル:まず事前訓練モデルに SFT を一回施し、基本的な能力を備えた指示モデルを得る。
- SFT 専門モデル:同じ指示モデルから出発し、複数の専門モデルを並列に訓練する。それぞれ専用のデータ配合とハイパーパラメータを使う。報告の本文には六つが挙がっている。コード、安全性、RAG、数学、多言語、そして汎用と長文脈だ。
- SFT Soup:これらの専門モデルを一つのモデルにマージする。
- RL 専門モデル:SFT Soup から出発し、強化学習の専門モデル群をまた並列に訓練する。領域ごとに適した方法を使い、数学とコードは検証可能な報酬、安全性と多言語は選好比較だ。
- RL Soup:もう一度マージする。
- 仕上げ:最後に全体のアラインメントを一巡行い、マージで残った問題を直し、全体のスタイルを人の好みに合わせる。
図の二つの「Model Merging」の欄にはスライダーが一列に描かれており、マージのときに各専門モデルの重みを調整できることを表している。これが流れ全体の鍵だ。マージ後にある能力が足りないとわかっても、訓練し直す必要はなく、スライダーを動かしてマージし直せばよい。
マージの四つの用途
報告はモデルマージを四つの用途に分けており、Command A はそのすべてを使った。
- 専門モデルのマージ:得意な能力の異なるモデルを一つにまとめる。これが主役だ。
- Polyak 平均:同じ訓練の複数の checkpoint を平均し、確率的勾配のノイズを減らす。
- シードのマージ:異なる乱数シードで訓練したモデルを平均し、偶然の影響を減らす。
- 補間による能力の回復:専門モデルは短いコンテキストだけで訓練されるため、長文脈の能力が劣化する。専門モデルと元のベースモデルを補間すると、専門モデルの新しい能力を保ちつつ、長文脈の能力の大部分を取り戻せる。著者らは、これが Google DeepMind の WARP によく似ていると指摘している。
線形マージで十分
専門モデルのマージには線形平均を使う。
著者らは SLERP とタスク算術も試したが、目立った改善はなく、かえって複雑さが増した。線形マージにはもう一つ実用的な性質がある。結合法則を満たすので、マージのマージも一回のマージとして書け、流れ全体を追跡しやすい。
重み は人手で探索する。ある専門モデルの重みを増やせば、その領域の性能がおおむね上がる。この関係は直観的だ。しかし重みの合計は 1 でなければならないので、他の領域はそれに応じて下がり、それらがどれだけ落ちるかは予測しにくい。著者らの探索法は両方を組み合わせる。足りない領域があればその専門モデルの重みを上げ、さらに現在の候補を中心に、各専門モデルの重みを少しずつ摂動させて総当たりで探索する。
この過程全体で、500 の評価指標を追跡した。従来の集中型の開発なら、これほど多くの指標を同時に見るのはずっと難しかっただろう、と著者らは述べる。
最良より一貫性が大事
マージが成功するかどうかは、専門モデル同士の「相性」に大きく左右される。著者らはいくつかの経験則をまとめている。
すべての専門モデルを同じ指示モデルから出発させる。 理由の一つは特殊 token だ。ツール呼び出しなどの特殊 token を使う専門モデルもあれば、使わない専門モデルもあり、使わない側ではそれらの token の埋め込みが訓練されていない。著者らは、これらの埋め込みを訓練済みの専門モデルからだけ取ることも試したが、全員が同じ出発点から始めて普通に平均するほうがよかった。もう一つの理由は長文脈だ。後訓練はたいてい長文脈の能力を弱め、しかも取り戻しにくい。もともと長文脈を扱える指示モデルから出発すれば、保ちやすい。
「一つ抜き」のマージを行う。 探索のときに、ある専門モデルを抜いたマージ結果をあえて比べれば、どの専門モデルが他の足を引っ張っているのかを突き止められる。著者らはこの現象を「衝突」と呼ぶ。
各専門モデルに他の領域のデータを少し入れる。 少量の領域横断データは正則化項のように働き、専門モデルが離れすぎないようにして、互いの相性を保つ。衝突は、共有データのスタイルや書式の小さな違いから生じることもある。
著者らの結論は、専門モデル間の一貫性を保つほうが、単一の専門モデルの最良の性能を追うより大事だということだ。
マージは安く、評価は高い
これは実際の製品でこそ出会う問題だ。学術研究では通常、専門モデルの組を固定し、少数の指標を目標に最良のマージ法を探す。しかし Command A は数百の指標を同時に見なければならず、重みの組を一つ試すたびに評価一式を走らせる必要がある。マージ自体の計算量は小さいが、評価には大量の推論時間がかかる。
しかも専門モデル自体も変わり続ける。著者らによれば、マージを成功させる作業の大部分は、実は専門モデルの訓練方法を見直すことだったという。
議論
マージは専門モデルの能力をどれだけ保ったか
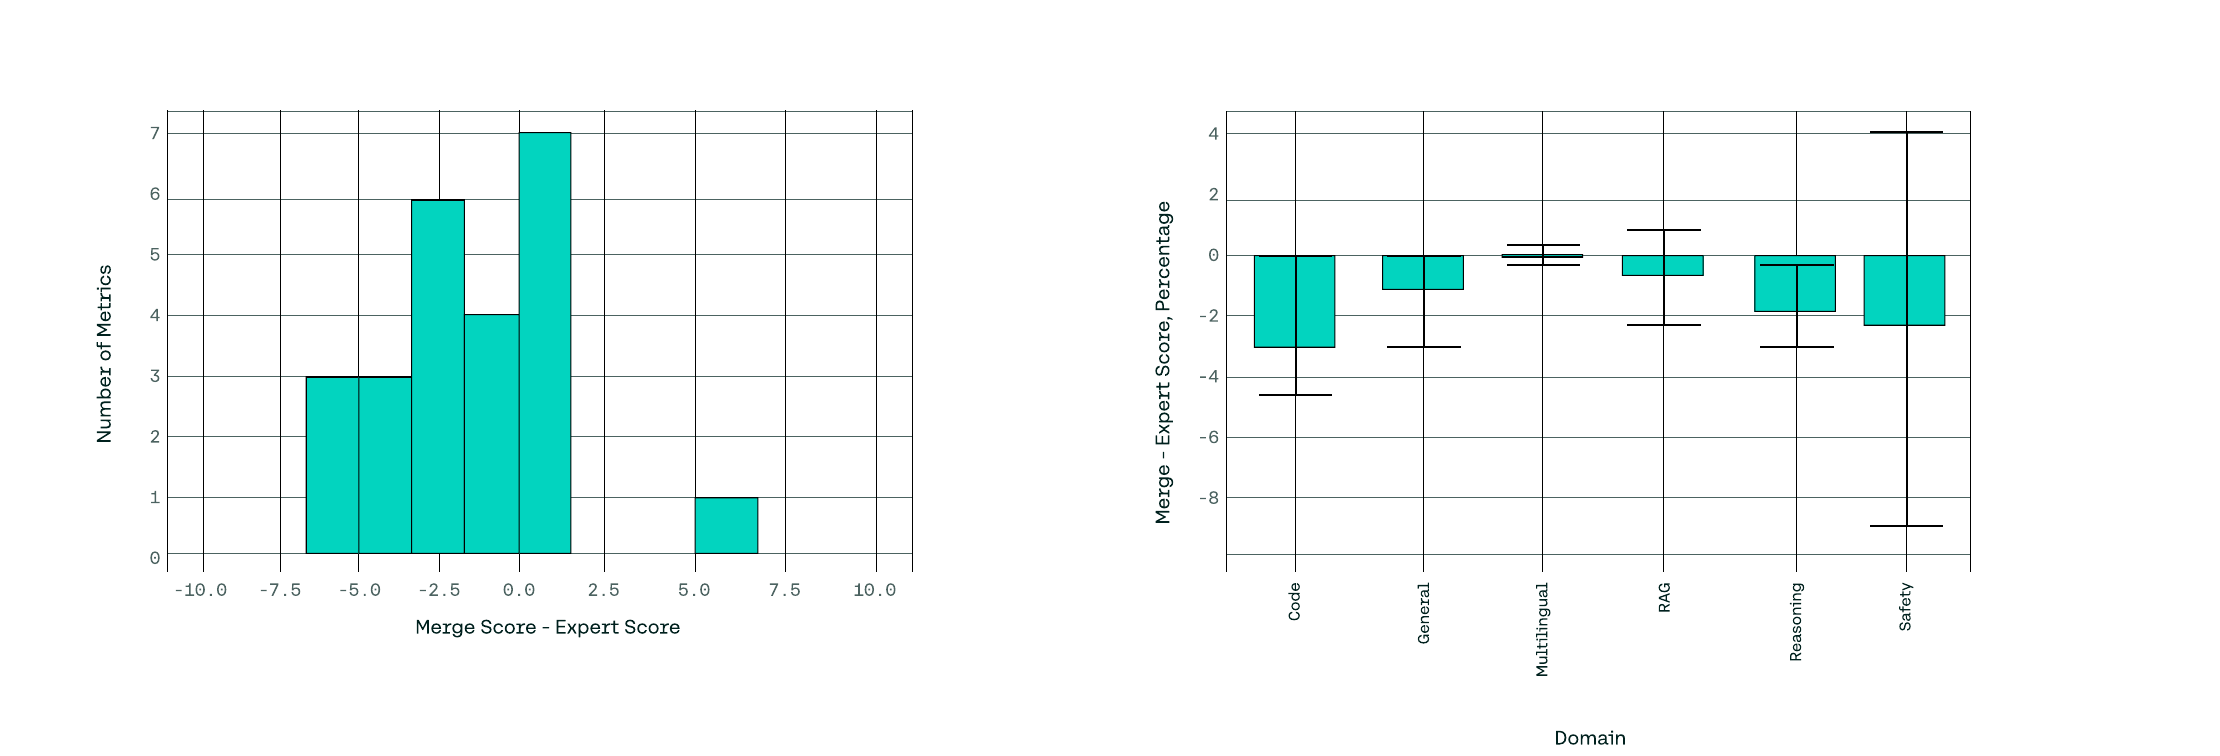
左図は、追跡したすべての指標について、マージ後と最良の専門モデルとのスコア差を示している。大多数は 0 付近のやや左に集まっている。報告によれば平均の低下はわずか 1.8% で、大多数の指標が最良の専門モデルから 2.5% 以内にとどまり、専門モデルよりよくなったものも少しある。
右図は領域別に分けたものだ。多言語、RAG、一般能力が最もよく保たれ、コードの落ち込みが最も大きく、平均で約 3% だ。安全性は誤差棒が長く、マージ後の変化が安全性の指標によって大きくばらつくことを示している。
著者らは、111B の規模ではマージがかなり安定していることも観察した。専門モデルの重みを大きく変えても、領域の性能はたいてい 2%~3% しか変わらず、ある能力が丸ごと崩れることはまれだった。
マージは粗い操作
マージ後のモデルが損失地形の局所最適点にある保証はない。著者らは、マージ後のモデルに、主要な SFT より 10~20 倍低い学習率で少しだけ SFT を追加すると、性能が目に見えて上がり、多くの指標が専門モデルの 100% に達するか、それを超えることを見つけた。
著者らの直観的な説明では、マージは各能力を組み合わせられるが、それらは表現空間の中でまだ「そろって」いないかもしれず、少量の勾配更新でそれらの能力を収まるべき位置に調整できる。これは仕上げ段階の役割とも合っており、仕上げはマージで落ちたスコアの補修にも使われる。
仕上げ自体には、Cohere の二つの手法、オフラインの SRPO とオンラインの CoPG を交互に使う。著者らによれば、交互に使うと互いを補正し合い、ある段階で後退が起きても、たいてい次の段階で引き戻される。
全体の成績
学術ベンチマークでは、Command A は DeepSeek-V3、GPT-4o、Llama 3.3 70B と勝ったり負けたりしている。たとえば MATH は 80.0 で、DeepSeek-V3 の 70.2、GPT-4o の 68.5 より高い。GPQA は 50.8 で、DeepSeek-V3 の 59.1 より低い。企業向けエージェントタスクの τ-bench は 51.7 で、DeepSeek-V3 の 39.1 より高い。
人手評価では、Command A の GPT-4o(2024 年 11 月版)と DeepSeek-V3 に対する勝率はおおむね五分五分で、コードの項目では DeepSeek-V3 に対する勝率が 54.7%、GPT-4o に対しては 46.8% だった。速度については、Command A は毎秒最大 156 token を出力でき、GPT-4o の 1.75 倍、DeepSeek-V3 の 2.4 倍だと著者らは主張している。これはベンダー自身の測定で、デプロイ条件が違えば数字も変わる。
この報告を読むときの注意点
マージの効果は分布図と平均値で示されるだけで、専門モデルごと、重みの組ごとの具体的なスコアは載っておらず、「マージせずにデータを直接混ぜて一つのモデルを訓練する」対照群とも比べていない。重みは人手で探したもので、専門モデルの組や規模を変えても同じ経験則が成り立つのかは、報告では検証されていない。
結論
Command A は、モデルマージを研究上のテクニックから大規模モデルの開発工程へと変えた。各チームが一つの能力をそれぞれ最良まで鍛え、最も単純な線形平均で一つのモデルにまとめる。必要なら重みを調整してマージし直せばよく、訓練し直す必要はない。
報告で最も実用的なのは、いくつかの経験談だ。すべての専門モデルを同じ出発点から始めること、各専門モデルに他の専門モデルのデータを少し混ぜること、「一つ抜き」のマージで足を引っ張る専門モデルを見つけること、マージ後に低い学習率の SFT を数ステップ足すこと。
学術論文の多くは、どのマージ法が最良かを競っている。Cohere は最も単純なものを選び、専門モデル同士をうまくかみ合わせることに力を注いだ。マージは最後のひと押しにすぎず、修行はすべてその前にある。