原論文
Arcee's MergeKit: A Toolkit for Merging Large Language Models
- arXiv への初回投稿
- arXiv:2403.13257
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingmergekit2024,
  title = {{Arcee's MergeKit: A Toolkit for Merging Large Language Models}},
  author = {Charles Goddard and Shamane Siriwardhana and Malikeh Ehghaghi and Luke Meyers and Vlad Karpukhin and Brian Benedict and Mark McQuade and Jacob Solawetz},
  year = {2024},
  eprint = {2403.13257},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.13257}
}
2023 年末から 2024 年初めごろ、Hugging Face に長い名前のモデルが大量に現れたことがある。
名前には slerp、ties、dare といった語がよく含まれ、二、三のモデル名をそのままつなげたものもあった。これらのモデルは新たな訓練を経ていない。作成者は既存の微調整モデル数個の重みを混ぜて、そのままアップロードしただけだ。その多くが一時は Open LLM Leaderboard の上位に食い込んだ。
裏にあった道具はたいてい同じで、Arcee の Charles Goddard らが開発したオープンソースのライブラリ MergeKit だ。この論文はその正式な紹介で、分量は短く、主にツールの設計と対応する手法を説明し、医療分野のマージ実験を一組添えている。
この論文を読む価値は、「モデルマージ」が論文からコミュニティの日常へ移ったとき、実際にどんな姿になったかがよく見えることにある。
問題の定義
モデルマージの研究は、重み平均、Model Soups、タスク算術から TIES-Merging と DARE まで、すでに何年も蓄積されていた。しかし論文ごとにコードはばらばらで、多くは特定のモデルとデータセット向けだった。70B の言語モデル二つをマージしようとすると、ごく実際的な問題にぶつかる。
- メモリ:70B モデル二つを 16 ビットで保存すると二、三百 GB になり、普通のマシンには載らない。複数を同時に置くのはなおさら無理だ。
- アーキテクチャの違い:Llama、Mistral、Qwen は重みの命名も層の構造も異なり、それぞれ個別に扱う必要がある。
- レシピを再現しにくい:どのモデルにどれだけの重みを与え、どの層にどの手法を使うかが使い捨てのスクリプトに書かれ、他の人が同じようにやるのは難しい。
著者らが作りたかったのは、プログラムを書けない人でもモデルをマージでき、研究者は新しい手法を手軽に加えられる共通のツールだ。
問題を解く
論文はマージ手法をどう分類するか
著者らはまずマージ手法を分類し、MergeKit がどこまで対応しているかも示した。
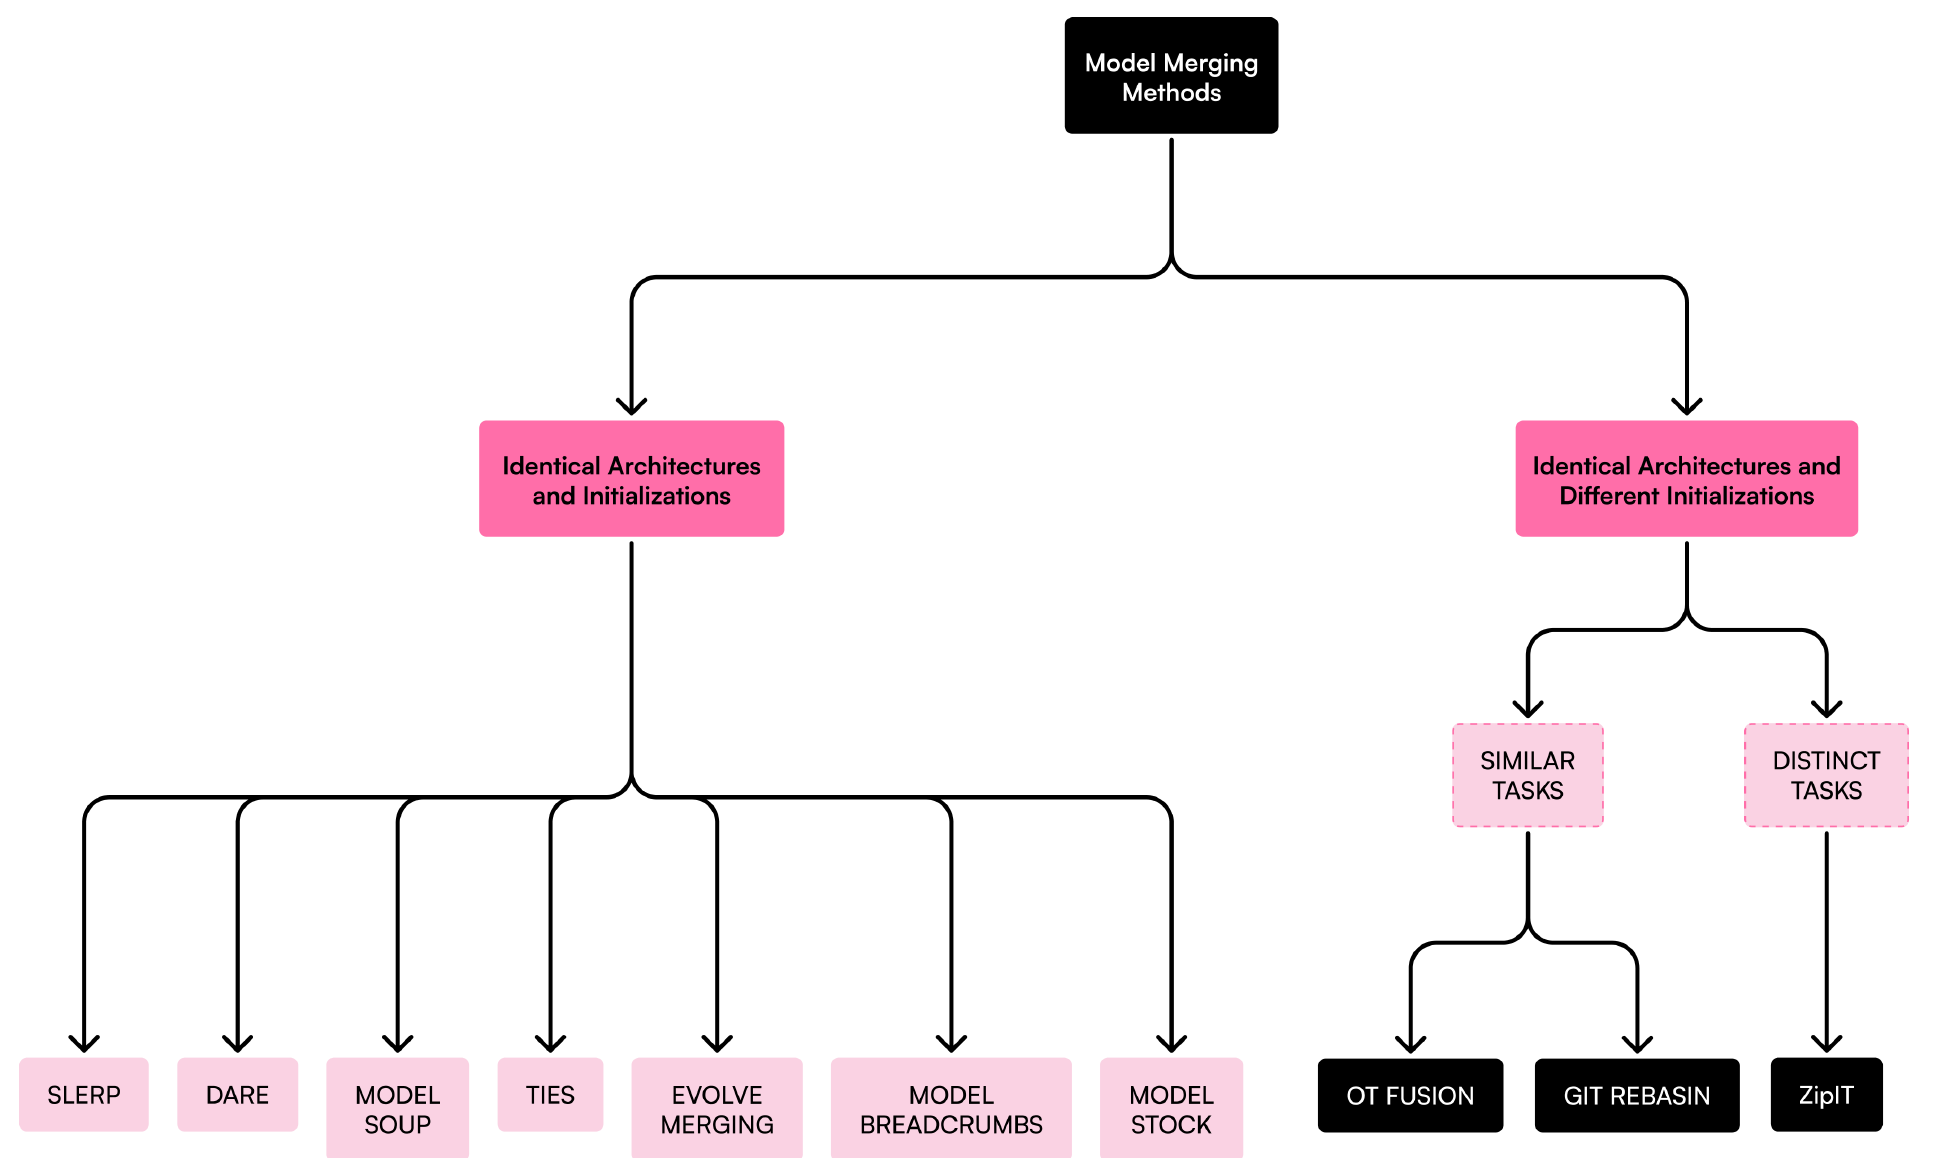
分類の基準は二つ、モデルのアーキテクチャが同じかどうかと、同じ初期化から来ているかどうかだ。
左の枝が MergeKit が実際に対応する範囲で、すべて「アーキテクチャが同じで、同じ基底モデルから出発している」ことを要求する。これはまさに線形モード連結性とタスク算術が成り立つ条件だ。右の枝は独立に訓練したモデルを扱い、先にニューロンを整列する必要があり、論文の執筆時点では未対応だった。著者らも、右の手法は今のところ左ほど広く使われていないと率直に認めている。
アーキテクチャがまったく異なるモデル同士をつなぐもの、例えばクロスアテンションで二つのモデルを接続する CALM や、二つのモデルの出力分布をそろえる FuseLLM は、いずれも追加の訓練が必要で、著者らはそれらをマージではなく「融合」に分類する。
マージのレシピは YAML 一枚
MergeKit の主なインターフェースは YAML の設定ファイルだ。設定ファイルにマージ手法、入力モデル、手法に必要なパラメータを書けば、実行はコマンド一行で済む。
mergekit-yaml path/to/your/config.yml ./output-model-directory
TIES マージの設定は、例えば次のように書ける(公式の examples/ties.yml より)。
models:
  - model: psmathur/orca_mini_v3_13b
    parameters:
      density: [1, 0.7, 0.1] # density gradient
      weight: 1.0
  - model: garage-bAInd/Platypus2-13B
    parameters:
      density: 0.5
      weight: [0, 0.3, 0.7, 1] # weight gradient
  - model: WizardLM/WizardMath-13B-V1.0
    parameters:
      density: 0.33
      weight:
        - filter: mlp
          value: 0.5
        - value: 0
merge_method: ties
base_model: TheBloke/Llama-2-13B-fp16
parameters:
  normalize: true
  int8_mask: true
dtype: float16
三つの 13B モデルはいずれも同じ Llama-2-13B から微調整したもので、base_model がこの共通の基底を指定し、タスクベクトルは各モデルとの差になる。density は TIES の刈り込み後に残す割合、weight は各タスクベクトルの重みだ。
この設定ファイルでは、さらに二つの機能を使っている。
第一に、パラメータをリストで書ける。density: [1, 0.7, 0.1] は層の深さに沿って補間され、一本の「グラデーション」になる。浅い層はすべてを残し、深い層ほど残す量が減る。
第二に、filter でパラメータの適用範囲を指定できる。WizardMath の設定では MLP 層に 0.5 の重み、他のテンソルに 0 を与えている。つまり MLP 層の変化だけを取り込む。
設定ファイルの利点は、マージのレシピが共有・再現・改変できるテキストになることだ。コミュニティの多くのマージモデルのモデルカードには、こうした YAML がそのまま添えられている。
SLERP がよく使われる理由
MergeKit が対応する手法のうち、コミュニティで最もよく使われるものの一つが SLERP(spherical linear interpolation、球面線形補間)だ。1985 年のコンピュータアニメーション研究に由来し、もとは回転を滑らかに補間するためのものだった。
二つのテンソル 、 の間の通常の線形補間は だ。SLERP はまず正規化した両者のなす角 を求め、球面に沿って進む。
両者は何が違うのか。長さ 1、なす角 90 度の二つのベクトルを取ると、線形補間の中点の長さは に縮むが、SLERP の中点の長さは 1 のままだ。なす角が大きいほど、線形補間は重みを大きく「縮める」。
しかし同じ基底から微調整した言語モデルでは、重み同士のなす角はたいてい小さい。なす角が 2 度なら線形補間の中点の長さは で、二つの方法にほとんど差はない。MergeKit の実装もこの点を考慮し、二つのテンソルの正規化した内積が 0.9995 を超えると、通常の線形補間に切り替える。
論文は SLERP の成功が「球面上の経路は直線より損失障壁が低いことが多い」ことを示すと述べるが、これは著者らの主張で、論文には対応する障壁の測定はない。
また、SLERP は一度に二つのモデルしかマージできないため、先ほどの例では TIES を使った。公式の gradient-slerp.yml の例は SLERP の別の使い方を示している。attention と MLP に異なる補間係数を使い、しかも係数を層の深さに沿って変える。例えば attention は から へ徐々に変わり、MLP はその逆になる。
足し引きしない二つのマージ
MergeKit には、パラメータ空間でまったく演算しない手法も二つある。
Passthrough はコミュニティで「FrankenMerging」と呼ばれ、異なるモデルの層をそのままつなぎ合わせて、普通ではない層数の新しいモデルを作る。人気の Goliath-120B は、Xwin と Euryale という二つの Llama-2 70B 微調整モデルの層を 16 層前後ずつ区切り、前後を一部重ねながら交互につないでいる。SOLAR-10.7B の Depth Up-Scaling の第一段階も同じで、同じ 32 層モデルを二つ複製し、一方から最後の 8 層、他方から最初の 8 層を取り除いて 48 層につなぎ、その後さらに事前訓練を続ける。
mergekit-moe はコミュニティで「FrankenMoE」と呼ばれ、いくつかの密なモデルを専門家として束ね、一つの Mixture-of-Experts(MoE)モデルを組み立てる。ルーターは、プロンプトの隠れ状態で意味に基づくルーティングをしてもよいし、ランダムに初期化して後から訓練してもよい。
どちらの手法も整列や補間の理論とは無関係で、つなぎ合わせたものが使えるかどうかは、評価で確かめるしかない。
ノート PC で 70B モデルをマージする
MergeKit の効率は「out-of-core」の設計から来る。モデル全体を一度にメモリへ読み込まず、その時の演算に必要なテンソルだけを読み込む。
一回のマージは内部で有向非巡回グラフ(DAG)として表され、各ノードが一つの演算になる。スケジューラはこのグラフに従って実行順序を決め、同時にメモリに置くデータをできるだけ少なくし、不要になった中間結果も自動で解放する。著者らによれば、これで MergeKit は研究用クラスタから、GPU がなくメモリも限られたノート PC まで、規模を縮めて動かせる。
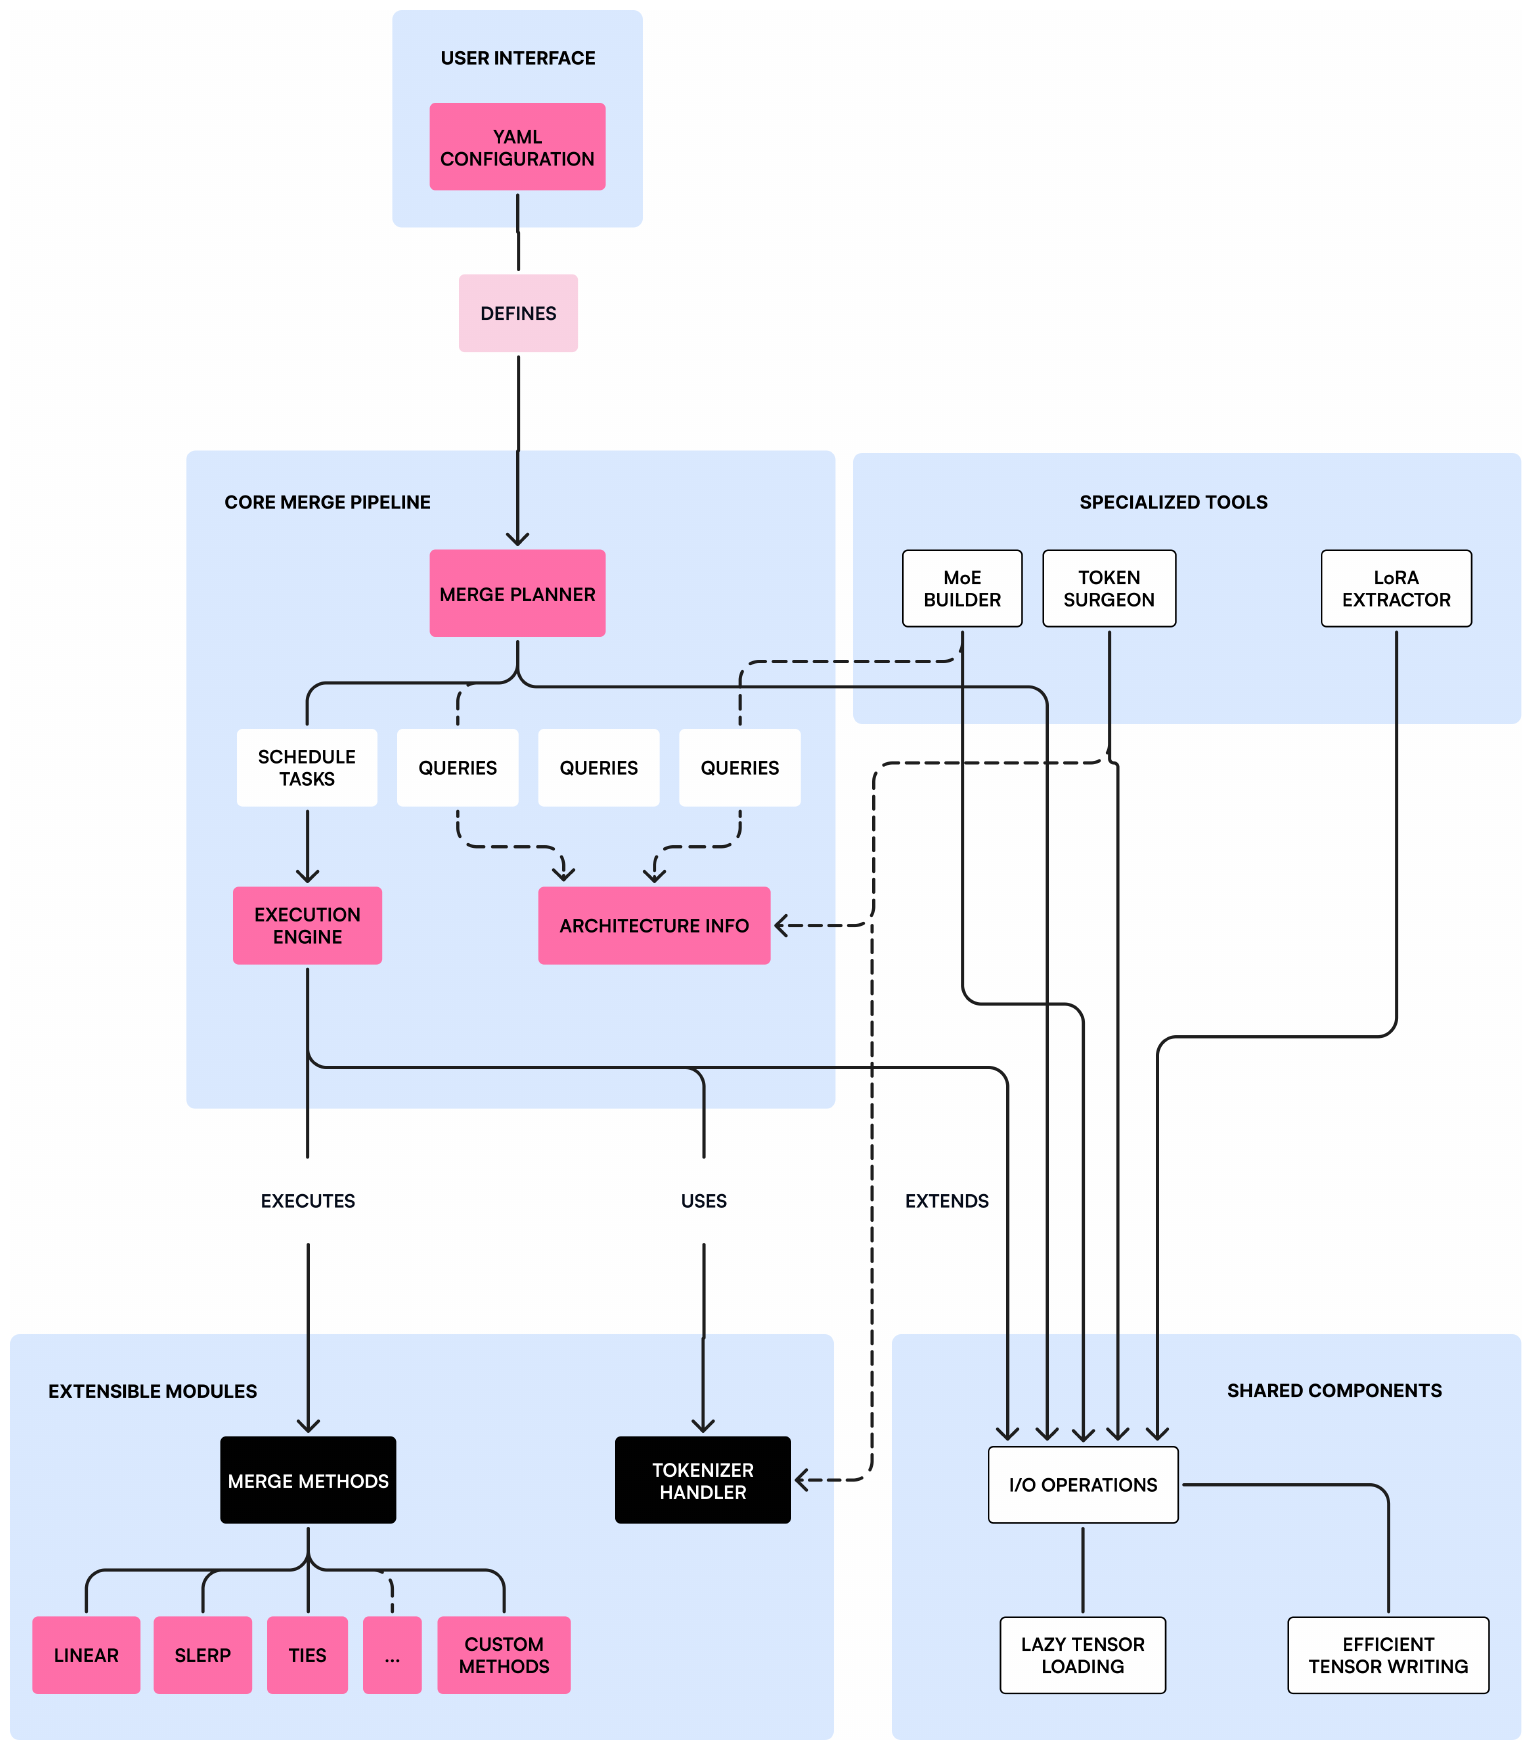
この構成図は、新しい手法を加えたい人に最も役立つ。著者らは、まず把握すべきモジュールを挙げている。merge_methods/base.py は新手法が実装すべきインターフェースを定義し、graph.py はスケジューリングとデータ移動を担い、plan.py は演算グラフを作り、architecture.py は各モデルの構造を記述する。ほとんどのアーキテクチャは簡単な JSON ファイル一つで定義される。
議論
医療分野の実験一組
論文で唯一の実験は、医療モデル Meditron-7B と Llama2-7B-Chat のマージだ。どちらも Llama2-7B の基底から出発しており、Meditron は大量の医療コーパスで事前訓練を続けている。
| モデル | USMLE | MedMCQA | PubMedQA | ARC-C | HellaSwag | MMLU |
|---|---|---|---|---|---|---|
| Llama2-7B-Chat | 35.90 | 35.45 | 73.40 | 44.20 | 55.40 | 46.37 |
| Meditron-7B | 38.40 | 24.07 | 71.40 | 40.20 | 54.50 | 33.06 |
| LERP | 39.10 | 36.65 | 75.60 | 46.76 | 58.66 | 48.44 |
| SLERP | 39.20 | 36.91 | 75.60 | 46.84 | 58.67 | 47.97 |
| DARE-TIES | 36.37 | 27.56 | 72.20 | 42.92 | 54.79 | 41.17 |
| TIES | 38.73 | 32.27 | 75.60 | 45.05 | 58.23 | 45.03 |
前の三列は医療の試験問題と質疑応答、後の三列は一般的な能力だ。
DARE-TIES が USMLE で Meditron-7B を下回る(36.37 対 38.40)のを除けば、マージモデルは医療の三項目のいずれでも Meditron-7B を上回る。LERP と SLERP は一般的な能力でも Llama2-7B-Chat を超える。著者らはこれをもとに、医療分野では SLERP が最良だとしている。
ただし、この表を読むときにはいくつか注意がいる。第一に、LERP と SLERP の差はほとんどが 0.5 ポイント以内で、MMLU ではむしろ LERP のほうが高い。先に計算した「なす角が小さければ両者はほぼ同じ」と一致する。第二に、表にはマージの係数、評価のプロンプト形式、繰り返し回数の説明がなく、分散も示されていないため、これらの差が安定しているかは判断できない。第三に、モデルの組は一つ、分野も一つだけだ。この実験は使用例に近く、手法の優劣を比べるには足りない。
リーダーボードのマージ熱
論文によれば、MergeKit は「数千のモデルのマージを後押しした」。この熱狂は問題ももたらした。
2024 年 3 月、Open LLM Leaderboard の議論ページで、リーダーボードが「merge」タグの付いたモデルを既定で非表示にしているため、自分たちのマージモデルが人目に触れなくなったと不満を述べるユーザーがいた。リーダーボードを管理する Hugging Face の担当者の回答によれば、非表示の理由は、マージモデルの系譜がほとんどたどれないことにある。マージを重ねるうちに何のデータが混ざったのかわからなくなり、評価集合を意図せず汚染しやすい。しかも、こうしたモデルのスコアは実際の使用での能力に結びつかないことが多い(スレッド)。
これは MergeKit 自体の落ち度ではない。ただ、マージで新しいモデルを作るコストがほぼゼロになった一方、評価の信頼性は同じようには上がっていない。リーダーボードで高得点のモデルをたくさんマージすれば、スコアはさらに上がるかもしれない。だがそれは、各モデルがそれぞれ触れてしまった試験問題を足し合わせただけかもしれない。
ライセンスの転換
MergeKit は当初 LGPL v3 で公開された。2025 年 2 月、Arcee は v0.1 のリリースに合わせて Business Source License に切り替え、長期的な開発を支えるためだと説明した。同年 10 月 31 日には LGPL v3 に戻すと発表し、BSL での旧リリースはバージョン履歴に残っている。プロジェクトを特定の旧バージョンに固定しているなら、そのバージョンにどのライセンスが適用されるかを確認しておくとよい。
結論
MergeKit の論文は新しいマージ理論を示してはいない。貢献は工学的なものだ。各論文の手法を一つのフレームワークに収め、YAML でマージのレシピを共有できるようにし、遅延読み込みで大きなモデルを小さなマシンでマージできるようにした。
あまりに使いやすかったからこそ、モデルマージは 2024 年に論文からコミュニティの日常になった。後の Llama 3 や Tülu 3 などの技術報告でも、マージが正式な訓練工程に組み込まれている。
自分で手を動かす前に、一つ覚えておこう。MergeKit でマージは YAML 一枚の手間になったが、評価まで一緒に簡単になってはくれない。