原論文
Git Re-Basin: Merging Models modulo Permutation Symmetries
- 発表先
- ICLR 2023国際会議
- arXiv への初回投稿
- arXiv:2209.04836
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmerginggitrebasin2022,
  title = {{Git Re-Basin: Merging Models modulo Permutation Symmetries}},
  author = {Samuel K. Ainsworth and Jonathan Hayase and Siddhartha Srinivasa},
  year = {2022},
  eprint = {2209.04836},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2209.04836}
}
隠れ層のユニットに固定の順序はない。3 番と 7 番を入れ替えても、次の層が入力を読む位置も一緒に入れ替えれば、ネットワークの計算結果はまったく同じになる。
この置換対称性は、Hecht-Nielsen が 1990 年に論じている。同じ関数に、大量の異なる重み表現が対応する。論文は一般的なアーキテクチャでその数を計算した。
| アーキテクチャ | 隠れユニットの置換数 |
|---|---|
| 3 層 MLP、幅 512 | |
| VGG16 | |
| ResNet50 | |
| 観測可能な宇宙の原子数の上限 |
原論文 Table 1 より整理。
異なるランダム初期化から訓練した二つのネットワークを直線補間すると、中間に高い壁が現れることは以前から知られていた。2021 年、Entezari らは、置換の可能性を考慮すれば SGD の解の多くは障壁なく直線で結べる、という大胆な予想を示した。置換を同一視した損失地形には、盆地が一つしかないのかもしれない。
ワシントン大学の Samuel Ainsworth、Jonathan Hayase、Siddhartha Srinivasa は、この予想を使える道具にしようとした。独立に訓練した二つのモデルに対して、一方を他方の盆地へ「移す」置換を探し、直接平均できるだろうか。
問題の定義
Frankle らの損失障壁(loss barrier)で測る。
直線上の最大損失から、端点の損失の平均を引く。0 なら、この直線上に盛り上がりがない。
機能を変えない置換 を探し、 と の障壁をできるだけ小さくするのが目標だ。第 層の置換を置換行列 で表すと、モデル B の重みは次のように変わる。
は第 層の出力ユニットを入れ替え、 は前の層の置換に合わせて、この層が入力を読む順序を変える。
入力と出力の位置には意味があるため、両端は固定する。画像の RGB チャネルや分類器のクラス順序は、重みを近づけるために勝手に交換できない。動かせるのは内部の隠れ次元で、同じ次元を通るバイアス、正規化パラメータ、分岐接続も一緒に変える。残差加算の二経路も互換性のある置換が必要で、層ごとに独立して並べ替えてはいけない。
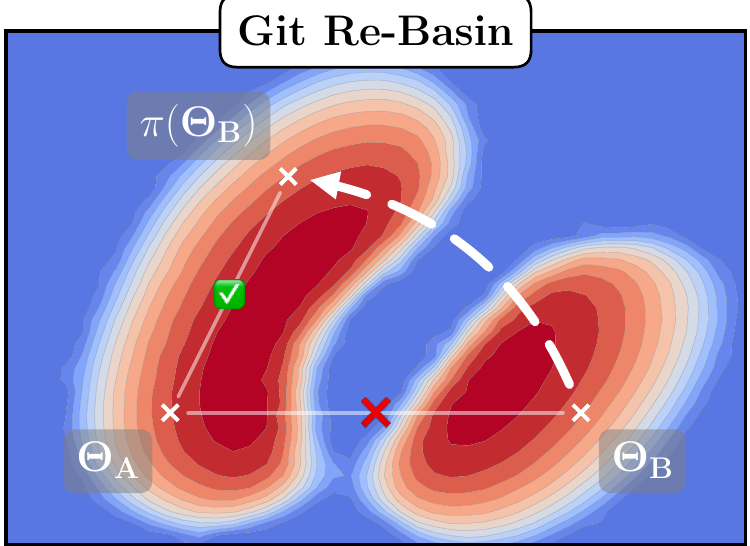
この図が論文全体の目標だ。異なる谷の と を結ぶ中点は谷の外に出る。 を機能がまったく同じ に置き換えると、 の谷へ入り、中点も谷内に収まる。
問題を解く
置換を探す三つの方法を提案する。
活性値を照合する
一つ目は直感的だ。同じタスクを解くモデルは似た特徴を、異なる位置で学んでいるかもしれない。訓練データを両モデルに入れ、第 層の活性値 を集め、最も近づける置換行列を求める。
右辺は古典的な線形割当問題(linear assignment problem)で、ハンガリー法などの多項式時間アルゴリズムがある。層ごとに独立に解け、データを一巡させればよい。
重みを照合する
二つ目はデータを一切見ず、重みだけを使う。
第 1 層の重みの各行は、一つのユニットが何を見ているかを表す。A の第 行と B の第 行が似ていれば、同じ特徴を計算しているかもしれない。3 ユニット、4 入力の例で計算しよう。
import numpy as np
from scipy.optimize import linear_sum_assignment

# 模型 A 第一層的三個單元,各有 4 個輸入權重
W_A = np.array([[ 1.0, -0.5,  0.2,  0.0],
                [ 0.1,  0.9, -0.8,  0.3],
                [-0.6,  0.0,  0.4,  1.1]])

# 模型 B 學到差不多的三個單元,只是順序換成 (A 的第 2, 0, 1 個),數值也略有不同
W_B = np.array([[-0.5,  0.1,  0.5,  1.0],
                [ 0.9, -0.4,  0.1, -0.1],
                [ 0.2,  1.0, -0.7,  0.2]])

S = W_A @ W_B.T                       # S[i, j]:A 的單元 i 和 B 的單元 j 有多像
print(S.round(2))
rows, cols = linear_sum_assignment(S, maximize=True)
print("A 的單元 i 配到 B 的單元", cols)
[[-0.45  1.12 -0.44]
 [-0.06 -0.38  1.54]
 [ 1.6  -0.61 -0.18]]
A 的單元 i 配到 B 的單元 [1 2 0]
類似度行列の各行の最大値は、ちょうど正しい対応を指す。A の 0 番は B の 1 番、1 番は 2 番、2 番は 0 番に対応する。この例は一目でわかるが、実際の数百ユニットでは類似度がこれほど明確ではない。割当アルゴリズムで、合計が最大になる対応を一度に求める。
置換を見つけたら、正しく適用する必要がある。出力層をつなぎ、置換前後の B の計算結果を確認する。
W_out = np.array([[1., -2., 0.5], [0.3, 0.4, -0.7]])
x = np.array([0.2, -0.1, 0.5, 1.0])
before = W_out @ np.maximum(W_B @ x, 0)
W_B_aligned = W_B[cols, :]       # 隱藏層換列
W_out_aligned = W_out[:, cols]  # 下一層的輸入換欄
after = W_out_aligned @ np.maximum(W_B_aligned @ x, 0)
print("換位前後功能相同:", np.allclose(before, after))
換位前後功能相同: True
まだ平均はしておらず、B を等価な表現へ変えただけだ。整列自体は B の出力を保ち、その後 A と平均して初めて関数が変わる。この二段階を分けて確認すると、置換の適用ミスと平均の効果不足を区別できる。
難しいのは層同士の依存だ。隠れユニットの役割は入力重みだけでなく、次の層へ送る重みにも依存する。第 層の置換を変えると、第 層の入力順序も変わる。全層の目的は、
この「双線形割当の和」は NP-hard で、3 層以上では定数倍の近似さえ多項式時間で解けない、と著者らは証明する。
折衷案は座標降下だ。他の層を固定して だけを見れば、通常の線形割当問題に戻る。
括弧の第一項は前層の整列を反映した入力側、第二項は次層の整列を反映した出力側を比べる。層をランダム順に更新し、置換が変わらなくなるまで繰り返す。実際には数秒~数分で収束するという。
全体の内積を増やす置換だけを受け入れ、置換の数は有限なので手順は停止する。ただし目的は重みを近づけることで、データ上の損失を直接最小化してはいない。停止点も、座標更新で改善できなくなった点だ。ImageNet で一巡だけに制限した対照では、マージモデルの top-1 精度は約 7% にとどまり、収束まで反復すると 51.01% になる。一度整列した層へ戻らなければ、後の層からの情報を逃す。
直通推定器で置換を学ぶ
三つ目は置換を学習対象にし、 と射影後の の平均の損失を最小化する。最も近い置換への射影は微分できないため、直通推定器(straight-through estimator、STE)を使う。順伝播は射影した重み、逆伝播は射影がないものとして扱う。
最もよい効果が得られるが、訓練ループを丸ごと回すためコストもずっと高い。
正確には、オプティマイザが自由に変えられる を保持する。毎回の順伝播で、B の等価な全置換から最も近い を探し、 の訓練損失を計算する。射影は重み照合を使い、逆伝播では恒等写像と近似して へ勾配を戻す。最終的に返すのは元の B のある置換なので、B の端点の関数は変わらない。
| 整列法 | データを使うか | 最適化する対象 | 主なコスト |
|---|---|---|---|
| Activation matching | 使う。中間表現を収集 | 層ごとの活性値の一致 | データの順伝播と各層の割当 |
| Weight matching | 使わない | 全ネットワークの重みの内積 | 層別割当の反復 |
| STE matching | 使う。マージ損失を計算 | 中点モデルの訓練損失 | 訓練ループと繰り返しの射影 |
同じデータがあり、構造に互換性があれば activation や STE を選べる。元の訓練データを取得できなくても weight matching は動く。最も低コストなこの方法が、後半で別々に訓練したモデルをマージする道具になる。
議論
整列すると、直線で通れる
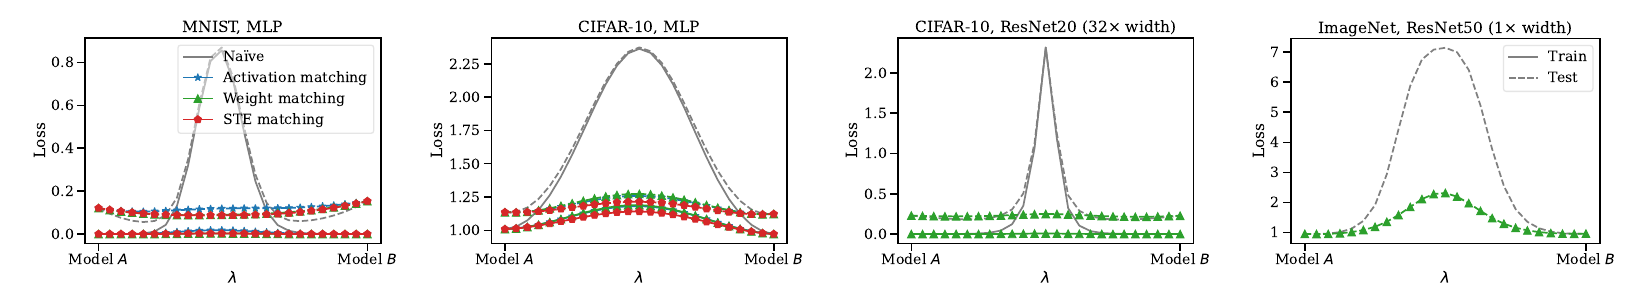
左から右へ、データとモデルが難しくなる。直接補間の灰線はすべて中間に山があり、三つの置換法はいずれも山を低くする。
MNIST は三法とも障壁ゼロ。重み照合と STE のテスト損失は凸な曲線になり、中間のモデルが A、B の両方を上回る。CIFAR-10 でも ResNet20 の幅を 32 倍にするとゼロになる。著者らの知る限り、ResNet で初めての結果だった。ImageNet の ResNet50 は小さな丘が残り、直接補間より障壁が 67% 減るが、ゼロにはならない。
三法の差は大きくない。STE は最良だが高コスト。重み照合はデータを使わず数秒で済み、データが必要な活性値照合と同程度になる。著者らはコストと効果のよい均衡だと考えている。
構造の違いも見落とせない。MLP は各 512 ユニットの三つの隠れ層、ReLU、正規化なし。CIFAR の VGG と ResNet20 は正規化を LayerNorm に変え、切り抜き、回転、反転を加えて momentum SGD で訓練する。ImageNet の ResNet50 だけが標準の BatchNorm を使い、補間モデルごとに統計量を再計算する。標準 BatchNorm の CIFAR モデルをそのまま使えば、異なる曲線になりうる。
67% は損失障壁の相対的な低下率であり、精度の 67 ポイント上昇とは異なる。ImageNet のマージ中点の top-1 が 51.01% という値も、障壁を大きく下げても中間モデルが端点よりかなり弱い場合を示す。主な成果は低障壁の置換を見つけられる条件の解明であり、独立な ImageNet モデルの無損失マージには課題が残る。
幅が広いほどつながりやすい
ImageNet でゼロにならない理由として、著者らは幅の不足を疑う。
CIFAR-10 の VGG-16 と ResNet20 を徐々に広げ、重み照合を行った。標準幅では線形連結性が見えないが、広げるほど障壁は 0 へ下がる。データの複雑さを収める十分な容量、特に幅があって、初めて線形連結性が現れるという仮説だ。
狭いモデルでは、十分よい置換が見つからないか、層をまたぐスケーリングなど、置換以外の対称性を考慮できていない可能性がある。著者らは置換対称性を「必要だが不完全」な一部分と位置づける。
最初からではなく、訓練で生まれる
線形連結性は訓練中に徐々に現れる。MNIST と CIFAR-10 の MLP を毎エポック照合して障壁を測ると、初期は高く、後から低下した。
反例も構成している。SGD で得たものでない解の中には、どの置換でも他の解と線形につながらないものがある。Entezari の予想は SGD の解に限定しているため矛盾しないが、連結性は SGD 自体の選好にも一部依存すると示唆される。
反例は二次元入力と、各 2 ユニットの二つの隠れ層だけだ。二モデルは同じ分類問題を完全に解くが、「第 1 次元の判定」と「第 2 次元の判定」を異なる層で担う。層内の入れ替えでは、この層をまたぐ分担を移せない。小さいので全置換を列挙でき、すべてを調べても障壁が残る。単に探索が失敗した例より強い証拠であり、使える対称性がユニット置換だけではないこともわかる。
別々に訓練して、一つにする
最後は実用に近い実験だ。CIFAR-100 を二分し、A はクラス 0~49 の 20% と 50~99 の 80%、B は逆の割合にして、それぞれ ResNet20 を訓練する。
重み照合でマージすると、全テスト集合での損失は A、B のどちらより低い。メモリと計算量はアンサンブルの半分で、確率の較正も元の二モデルよりよい。ただし全データで訓練したモデルや二モデルのアンサンブルには届かず、直接補間はさらに悪い。
二つの訓練集合は重ならないが、両モデルとも全 100 クラスを異なる割合で見ている。したがって分類ヘッドの意味をそろえられる。改善するのは交差エントロピーと確率較正で、分類精度は元の両モデルを同時に上回ってはいない。「異なるデータで訓練して混ぜると全面的によくなる」と要約すると、この取捨を落としてしまう。
付録には複数モデル版もある。一モデルを他モデルの平均へ整列する処理を順番に反復し、最後に全体平均を取る。各々が MNIST の半分を見る 32 個の MLP では、マージ後の較正が出力アンサンブルに近づき、推論は一つになる。二モデル以上の例だが、規模とデータの難しさは現代の大規模言語モデルとは離れている。
結論
Git Re-Basin は、異なる初期化のモデルを平均する前に「席順をそろえる」方法を与えた。重み照合はデータ不要で数秒で動き、十分広いネットワークでは障壁をゼロにできる。
境界も明確だ。幅が必要で、ImageNet の標準 ResNet50 はゼロにできない。後の REPAIR は、整列後の平均モデルで活性値の分散が縮むことを見つけ、再スケーリングによって ImageNet の障壁をさらに下げた。
後に一般的になる言語モデルのマージは、同じ事前訓練 checkpoint の微調整版から始め、共有のパラメータ座標を利用する。独立に訓練したモデルなら、まずこの整列問題を扱い、その後に機能がどれほど残るかを確かめる必要がある。