原論文
WSM: Decay-Free Learning Rate Schedule via Checkpoint Merging for LLM Pre-training
- 発表先
- ICLR 2026国際会議
- arXiv への初回投稿
- arXiv:2507.17634
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingwsm2025,
  title = {{WSM: Decay-Free Learning Rate Schedule via Checkpoint Merging for LLM Pre-training}},
  author = {Changxin Tian and Jiapeng Wang and Qian Zhao and Kunlong Chen and Jia Liu and Ziqi Liu and Jiaxin Mao and Wayne Xin Zhao and Zhiqiang Zhang and Jun Zhou},
  year = {2025},
  eprint = {2507.17634},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2507.17634}
}
大規模言語モデルの訓練で、学習率スケジュールはずっと面倒な設定だった。
従来の cosine スケジュールは、総訓練ステップ数が最初からわかっていないと曲線を描けない。もう少し多くのデータで訓練したくなれば、最初からやり直しになる。WSD(Warmup-Stable-Decay)は途中に学習率一定の安定期を挟み、安定期からいつでも分岐してアニーリングできる。DeepSeek-V3 や ERNIE 4.5 もこれを採用している。
しかし WSD にも、事前に決めておくことがたくさんある。いつアニーリングを始めるか、アニーリングに何 token 使うか、どの減衰曲線を使うか。アニーリングが終わった後でさらに訓練したくなったら、アニーリング前の状態に戻って計画し直すしかない。
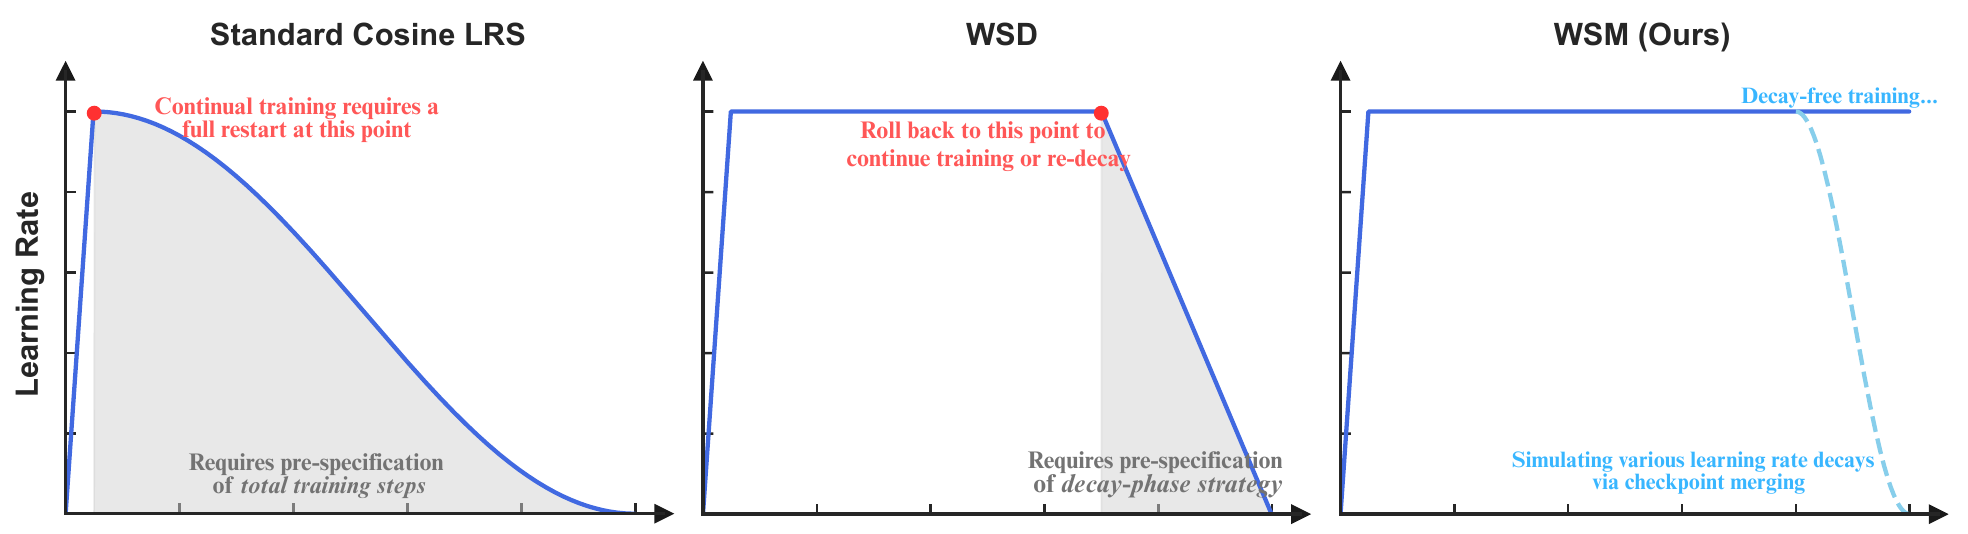
アント・グループの Ling チームと中国人民大学によるこの論文は、減衰の区間を丸ごと取り除こうとする。学習率はウォームアップ後ずっと一定のままで、アニーリングの効果は checkpoint のマージで得る。彼らはこのスケジュールを WSM(Warmup-Stable and Merge)と名付けた。
問題の定義
同じ時期、ByteDance Seed の PMA は、学習率一定の段階で checkpoint を平均すれば、スコアがアニーリング後のモデルに近づき、追いつくことさえあると見つけていた。
しかし「平均」と「アニーリング」の関係は、ずっとはっきり説明されてこなかった。平均するとき、各 checkpoint にどれだけの重みを与えるべきか。等重み平均や指数移動平均は、それぞれどんなアニーリングに対応するのか。この関係を式で書ければ、効果がよいと知られている任意の減衰曲線を、マージでシミュレートできる。
問題を解く
マージを減衰として書く
順に保存した 個の checkpoint があるとき、マージ後のモデルは次のようになる。
この式からは、学習率との関係が見えてこない。著者らは書き方を変え、各 checkpoint を「出発点に、その後の更新を加えたもの」として表す。 を第 ステップの更新量(学習率を掛けた後)とし、 とすると、
これをマージの式に代入し、二つの和の順序を入れ替える。第 回の更新 は のすべての checkpoint に現れるので、
となる。ここで だ。
この結果はとても直観的だ。checkpoint をマージすることは、 から出発し、その後の各ステップの更新に係数 を掛けて足し戻すことに等しい。 は を末尾から累積した和なので、 とともに必ず減少する。これはまさに、減衰する学習率の曲線だ。
逆向きもできる。ある減少する減衰曲線 が欲しければ、対応する checkpoint の重みは次のように一意に決まる。
これが論文の定理 3.1 だ。
一度計算してみる
小さな例で、両方向を一度たどってみよう。まず 5 個の checkpoint の等重み平均がどんな減衰に当たるかを見て、次に逆向きに 1-sqrt 減衰に必要な重みを求め、最後に両者の結果が本当に一致するかを確かめる。
import numpy as np

def merge_weights_from_decay(w):
    """定理 3.1:勾配の減衰係数 w_1..w_k から checkpoint の重み c_0..c_k を逆算する。"""
    k = len(w)
    c = np.zeros(k + 1)
    c[k] = w[-1]
    for j in range(1, k):
        c[j] = w[j - 1] - w[j]
    c[0] = 1 - w[0]
    return c

rng = np.random.default_rng(0)
k = 4
theta_n = rng.normal(size=3)
g = rng.normal(size=(k, 3)) * 0.1            # 学習率一定での k 回の更新
ckpts = [theta_n - g[:j].sum(0) for j in range(k + 1)]   # θ_n, θ_{n+1}, ..., θ_{n+k}

# 1) 直近 5 個の checkpoint を平均すると、どの減衰に当たるか?
c_mean = np.full(k + 1, 1 / (k + 1))
w_equiv = [c_mean[i:].sum() for i in range(1, k + 1)]
print("5 個の checkpoint を平均 → 各ステップの更新の実効倍率:", np.round(w_equiv, 2))

# 2) 1-sqrt 減衰にしたいなら、checkpoint の重みはどう与えるか?
t = np.arange(1, k + 1) / (k + 1)
w_sqrt = 1 - np.sqrt(t)
c_sqrt = merge_weights_from_decay(w_sqrt)
print("1-sqrt 減衰の倍率:", np.round(w_sqrt, 3))
print("対応する checkpoint の重み:", np.round(c_sqrt, 3), " 合計", round(c_sqrt.sum(), 6))

merged = sum(cj * th for cj, th in zip(c_sqrt, ckpts))
decayed = theta_n - (w_sqrt[:, None] * g).sum(0)
print("マージ結果と減衰結果の最大差:", np.abs(merged - decayed).max())
5 個の checkpoint を平均 → 各ステップの更新の実効倍率: [0.8 0.6 0.4 0.2]
1-sqrt 減衰の倍率: [0.553 0.368 0.225 0.106]
対応する checkpoint の重み: [0.447 0.185 0.142 0.12  0.106]  合計 1.0
マージ結果と減衰結果の最大差: 1.3877787807814457e-17
一行目は、5 個の checkpoint の等重み平均が、その後の 4 区間の更新にそれぞれ 0.8、0.6、0.4、0.2 を掛けることに等しく、つまり線形減衰になることを示している。三行目が逆算の結果だ。1-sqrt 減衰をシミュレートするには、最も古い checkpoint に最大の重み 0.447 を与え、その後は順に減らしていく。最後の行の差は浮動小数点誤差の範囲内で、二通りの計算が同じパラメータの組を与える。
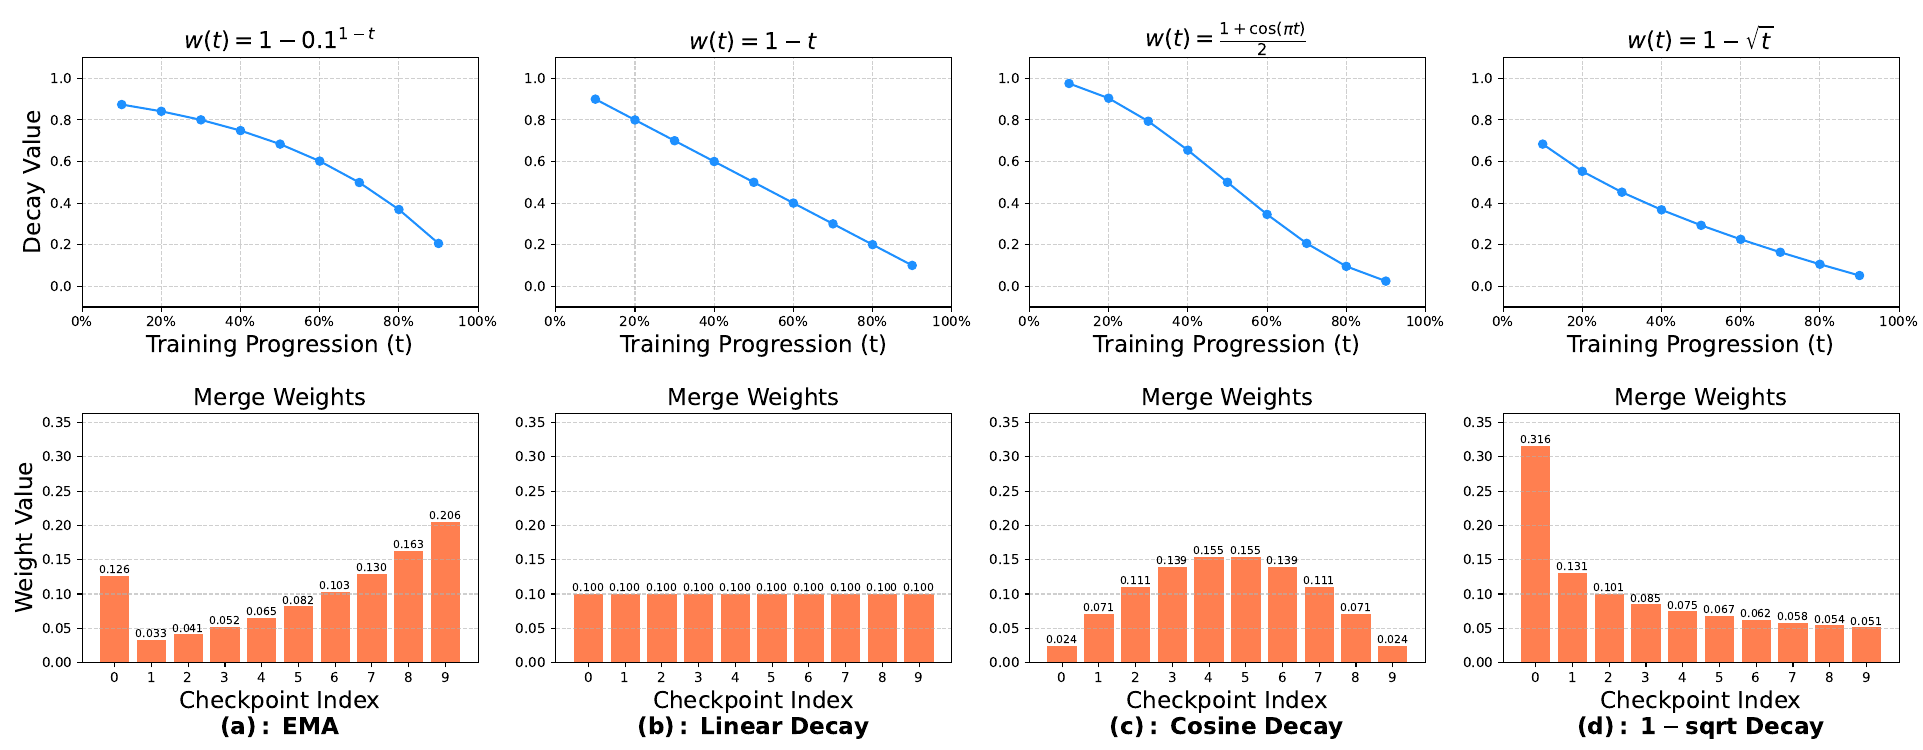
論文は、よく使われる四つのマージ方法をすべて減衰曲線に換算している。最も面白いのは EMA だ。EMA は新しい checkpoint に大きな重みを与え、一見もっともらしいが、換算すると凸の減衰曲線になる。前半はほとんど下がらず、最後になって慌てて急降下する。
WSM の流れ
この対応があれば、WSM の流れは三段階になる。
- ピーク学習率までウォームアップし、その後はずっと変えない。
- ある時点まで訓練したら、データを厳選した高品質データに切り替えてもよい。一般的な「アニーリングデータ」のやり方に当たる。
- 一定の token 数ごとに checkpoint を保存し、別の非同期プロセスが直近 個の checkpoint を取り続け、シミュレートしたい減衰曲線に従って重みを計算してマージする。
訓練そのものは一度も止まらず、マージしたモデルはいつでも評価や納品に回せる。
著者らはオフラインとオンラインの二種類のマージも比べた。すべての checkpoint を残すオフラインのマージなら、後から異なる減衰曲線やウィンドウサイズを試せる。最良の設定が見つかれば、直近 個の checkpoint だけを残すオンライン版に切り替えられる。コストは主にストレージで、著者らの実験では で十分だった。
議論
実験設定
モデルは Ling-mini で、総パラメータ 16.3B、活性化パラメータ 1.4B の MoE だ。アーキテクチャは密な層 1 層と MoE 層 19 層からなり、各層 256 個の専門家から 8 個を選び、さらに共有専門家が 1 個ある。オプティマイザは AdamW、ピーク学習率は 4.78e-4、バッチは 2048。
出発点は、学習率一定で 10.2T token 訓練した checkpoint で、そのうち 10T は通常の長さ、200B は長文脈のデータだ。ここから高品質のアニーリングデータに切り替え、二本に分けてそれぞれ 400B token 訓練する。
- WSD:通常どおり学習率を減衰させる。
- WSM:学習率を一定に保ち、25B token ごとに checkpoint を保存し、直近のいくつかを等重み平均でマージする。
WSD よりよい
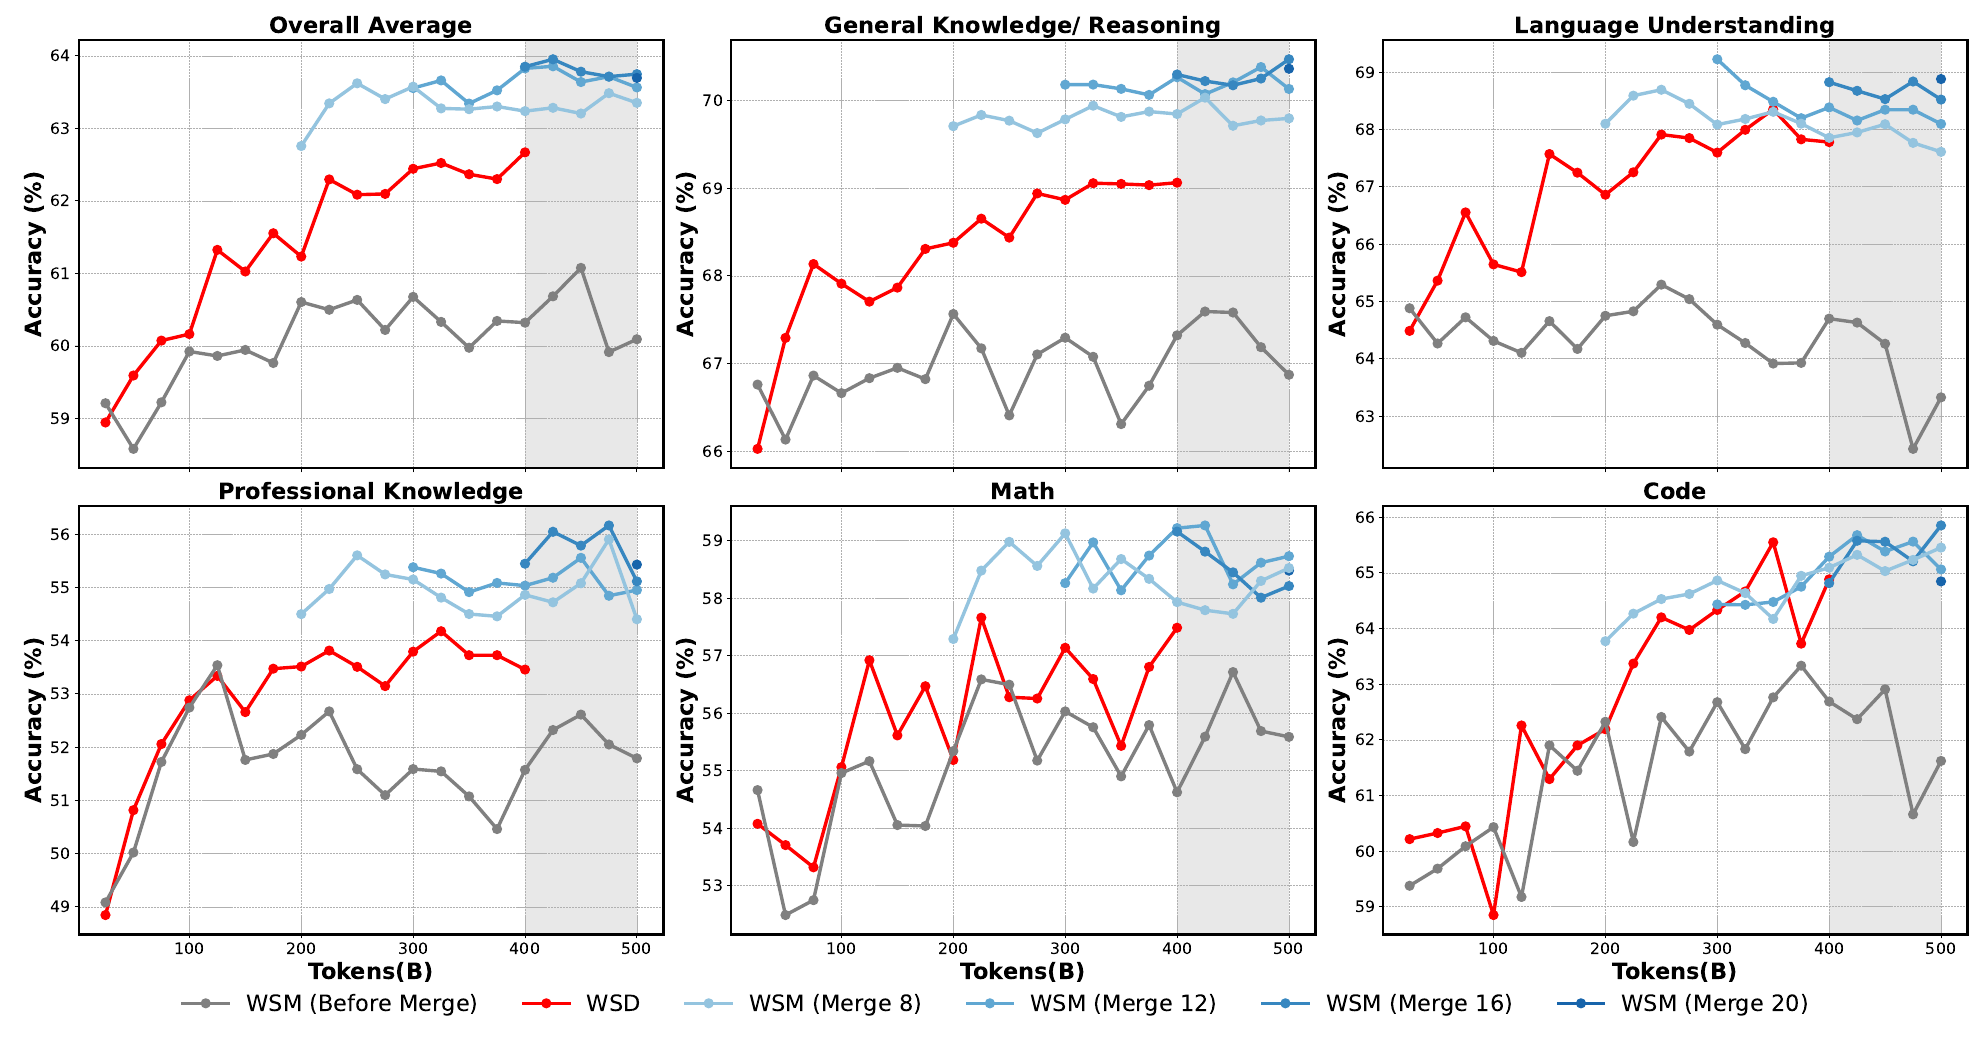
まず灰色の線と青い線を見よう。灰色の線は学習率一定でまだマージしていない checkpoint で、スコアはずっと低いところにとどまっている。マージ後の青い線は、一気に赤い線の上へ跳ぶ。全体平均の図では、赤い WSD は 400B で約 62.7、青い線の多くは 63 から 64 の間にある。
400B 以降の灰色の領域は、WSM のもう一つの利点だ。WSD の減衰は 400B で終わるので、さらに訓練するなら計画し直す必要がある。WSM の学習率は一度も下がっていないので、そのまま訓練を続けられる。
それぞれ最も成績のよい checkpoint を比べると、WSM は平均で 1.3 ポイント高い。数学、コード、専門知識のどれも伸びており、個別のベンチマークでは MATH が 2.7 ポイント、HumanEval が 2.4 ポイント、MMLU-Pro が 2.1 ポイント高い。
この優位は SFT の後も残る。両方のベースモデルに同じ設定で 5 epoch の SFT を行うと、WSM の全体平均は 64.07、WSD は 62.90 だった。ただしコード系は例外で、WSM のほうがかえって 0.28 ポイント低い。
どの時点でもアニーリングを予測できる
著者らは事前訓練の全期間にわたって、2T、4T、6T、8T、10T token に達するたびに比較も行った。一方は実際に 100B token アニーリングし、もう一方は直前の 100B token の範囲から 4 個の checkpoint を取って平均する。
今回使ったのは高品質のアニーリングデータではなく通常の事前訓練データなので、WSM の優位はそれほど目立たないが、両者のスコアは終始ぴったり寄り添っている。したがって WSM は「アニーリングしたらどれだけよくなるか」の見積もりにも使え、毎回アニーリングの分岐を立てる必要がない。
どの要因が最も重要か
マージ方法。1-sqrt 減衰をシミュレートする重み、等重み平均、EMA の三つを比べると、全体平均はそれぞれ 64.06、63.95、63.01 で、いずれも WSD の 62.67 より高い。1-sqrt が等重み平均をわずかに上回り、EMA は明らかに最も悪い。
これはアニーリングの経験と一致する。著者らは WSD の実験でも、凹の 1-sqrt 曲線と線形曲線のほうが凸の曲線よりよいことを見つけていた。EMA が対応するのは、まさに凸の減衰だ。
マージの期間。マージのウィンドウがカバーする token 数が多いほど性能はよいが、伸びはだんだん小さくなる。これもアニーリングと同じで、アニーリングデータはある程度まで増やすと、それ以上足してもあまり効かない。EMA では、ウィンドウサイズの影響がまったく見えない。
マージの粒度。マージの期間を 80B token に固定し、保存間隔を比べる。5B ごとに保存して 16 個をマージ、10B ごとに 8 個、20B ごとに 4 個、40B ごとに 2 個で、全体平均はそれぞれ 63.63、63.78、63.36、62.77。checkpoint を一つだけ取ると 60.33 だった。粒度が細かいほど連続的な減衰曲線に近づくが、その差は期間による差よりずっと小さい。
そのため著者らは、マージの期間こそ最も重要な要因で、保存間隔やマージする数より影響が大きいと考える。
マージに減衰を足しても上積みはない
マージで減衰をシミュレートできるなら、両者を重ねられないだろうか。著者らは減衰してからマージする方法と、マージしてから減衰する方法を試したが、どちらも追加の改善は得られなかった。マージしてから減衰したモデルは最初のうちはよいが、最終的には差がなくなる。
著者らの解釈では、マージと減衰は同じ目標に通じる二本の道で、互いに置き換えられるが、重ね合わせることはできない。
MoE への副作用
最後の観察は MoE の負荷分散だ。WSM のモデルは専門家の負荷の偏りが明らかに小さく、最大の偏りは 0.601 から 0.545 に、最小の偏りは 0.322 から 0.201 に下がった。ただし言語モデルの損失はやや高く、0.697 対 0.675 だった。マージによって各専門家の使われ方がより均等になる代わりに、損失が少し悪化する。両者が下流のスコアにどう影響するのかを、論文はそれ以上切り分けていない。
証拠の範囲
主要な実験は 16B の MoE モデル一つだけで、出発点はすでに 10.2T token 訓練した checkpoint だ。対照の WSD には、著者らが付録で比較した中で最も効果のよかった 1-sqrt 減衰を使っており、これで比較はより公平になっている。しかしアニーリングの長さは 400B token の一種類だけで、他の長さでも差が同じくらい大きいのかは、論文に書かれていない。要旨にある +3.5% MATH、+5.5% MMLU-Pro は別の比率の計算方法によるもので、パーセントポイントで数えると本文の 2.7 と 2.1 になる。
Ling チームのその後の Ling 2.0 技術報告も、WSM スケジュールを採用している。
結論
WSM は、和の順序を入れ替える一つの導出で、checkpoint のマージと学習率の減衰を結びつけた。マージ重みを末尾から累積した和がそのまま減衰係数になり、逆に任意の減少する減衰曲線からマージ重みを計算することもできる。
実装では、学習率はウォームアップ後もう調整せず、アニーリングはマージに任せる。訓練はずっと続けられ、どの時点でも「アニーリング後」のモデルが手に入り、しかも著者らの実験では WSD より少しよかった。
EMA に飛びつくのはまだ早い。いちばん手軽に見えるが、換算すると効果が最も悪い凸の曲線になる。