原論文
Model Merging in Pre-training of Large Language Models
- 発表先
- NeurIPS 2025国際会議
- arXiv への初回投稿
- arXiv:2505.12082
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingpretrainingmerging2025,
  title = {{Model Merging in Pre-training of Large Language Models}},
  author = {Yunshui Li and Yiyuan Ma and Shen Yan and Chaoyi Zhang and Jing Liu and Jianqiao Lu and Ziwen Xu and Mengzhao Chen and Minrui Wang and Shiyi Zhan and Jin Ma and Xunhao Lai and Deyi Liu and Yao Luo and Xingyan Bin and Hongbin Ren and Mingji Han and Wenhao Hao and Bairen Yi and LingJun Liu and Bole Ma and Xiaoying Jia and Xun Zhou and Siyuan Qiao and Liang Xiang and Yonghui Wu},
  year = {2025},
  eprint = {2505.12082},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2505.12082}
}
大規模言語モデルの事前訓練で一番つらいのは、最終的にどれだけよくなるかがわからないことだ。
今よく使われる学習率スケジュールは WSD(Warmup-Stable-Decay)と呼ばれる。短いウォームアップの後、一定の学習率で長く訓練し、最後に学習率を下げて「アニーリング」する。問題は、学習率一定の段階の checkpoint はスコアがいつも低めで、アニーリングが終わるまでモデルの最終的な水準が見えないことだ。訓練の方向が正しいかを知りたければ、別に分岐を作ってアニーリングする必要があり、そのたびに数百億から千億を超える token を余分に使う。
モデルマージの研究の多くは、微調整の後に異なるタスクのモデルをいくつか組み合わせるものだ。事前訓練段階のマージは別物で、組み合わせるのは同じ訓練軌跡上の checkpoint である。Llama 3 と DeepSeek-V3 の技術報告はどちらもこの種の技法を使ったと述べているが、詳細は説明していない。一般の研究者は大規模事前訓練の途中の checkpoint を入手できず、自分で研究するのも難しい。
ByteDance Seed のこの論文は、総パラメータ数最大 200B までの一連の密なモデルと MoE モデルをゼロから訓練し、事前訓練中の checkpoint のマージを丁寧に測った。このやり方を PMA(Pre-trained Model Average)と呼ぶ。
問題の定義
マージの対象は、同じ訓練軌跡上で順に保存した 個の checkpoint で、マージ後のモデルは重み付き和になる。
隣り合う二つの checkpoint の間は、token 数で数えた一定の訓練量 だけ離れている。例えば 、 なら、直近 80B token の間に 8B ごとに保存した 10 個の checkpoint を取る。
重み の割り振り方について、論文はよくある三つのやり方を比べる。
- SMA(単純移動平均):どの checkpoint も同じ重みで、。
- EMA(指数移動平均): を再帰的に計算する。新しい checkpoint ほど重みが大きく、 が大きいほど最新のものを重視する。
- WMA(加重移動平均):重みを線形に増やし、例えば としてから総和で割って正規化する。
なら、SMA の重みは 、WMA は だ。
著者らは研究を六つの問いに分ける。マージは性能にどう影響するか。どのマージ手法がよいか。間隔と数をどう選ぶか。マージ後のモデルを次の段階の出発点にすると役立つか。訓練の安定性を高められるか。そして、なぜマージが効くのか。
実験には社内のコーパスとアーキテクチャを使う。MoE モデルは 0.7B/7B(活性化パラメータ/総パラメータ)から 20B/200B まで、密なモデルは 411M から 70B までだ。評価は MMLU、BBH、GSM8K、HumanEval など十六の公開ベンチマークにわたり、多くの図表はそれらの加重平均スコアを報告している。
問題を解く
学習率一定の段階:平均するだけでよくなる
最初の実験が最も簡単だ。学習率一定の段階でしばらく訓練した後、checkpoint を平均し、最新の checkpoint と比べる。
四つのサイズの MoE モデルはいずれもはっきり改善した。Seed-MoE-1.3B/13B の HumanEval は 31.1 から 36.6 へ、Seed-MoE-10B/100B は 54.3 から 61.6 へ上がる。大きなモデルは、BBH のように飽和に近いベンチマークでは改善が小さい。付録の密なモデルも同様で、Seed-Dense-70B の HumanEval は 50.6 から 57.9、GSM8K は 85.9 から 91.3 に上がり、モデルが大きくなっても改善幅は小さくならない。
これは 2018 年の SWA と同じ直感だ。学習率が一定で大きめだと、モデルは谷底の近くを行ったり来たりし、各 checkpoint は谷の斜面の別々の位置にとどまる。平均すれば、谷底の中心に近づく。
アニーリング段階:早めに平均すれば終点に追いつく
二つ目の実験はアニーリング段階でマージする。学習率は cosine 曲線に沿って下がり、モデルのスコアは上がり続ける。
面白いことに、アニーリングが始まったばかりのときに checkpoint をマージすると、スコアはすでにアニーリング終了時とほぼ同じになる。大きめのモデルでは、普通にアニーリングを終えた結果を上回ることさえある。
ここから、より大胆な問いが生まれる。マージでアニーリングと同じ効果が得られるなら、いっそアニーリングしなくてもよいのではないか。
アニーリングせず、マージだけする
著者らは Seed-MoE-1.3B/13B の 1.4T token の時点から二本の訓練を分岐させる。一本は学習率を一定に保ち、もう一本はアニーリングを始め、それぞれさらに 250B token 訓練する。そして学習率一定のほうの checkpoint をマージする。
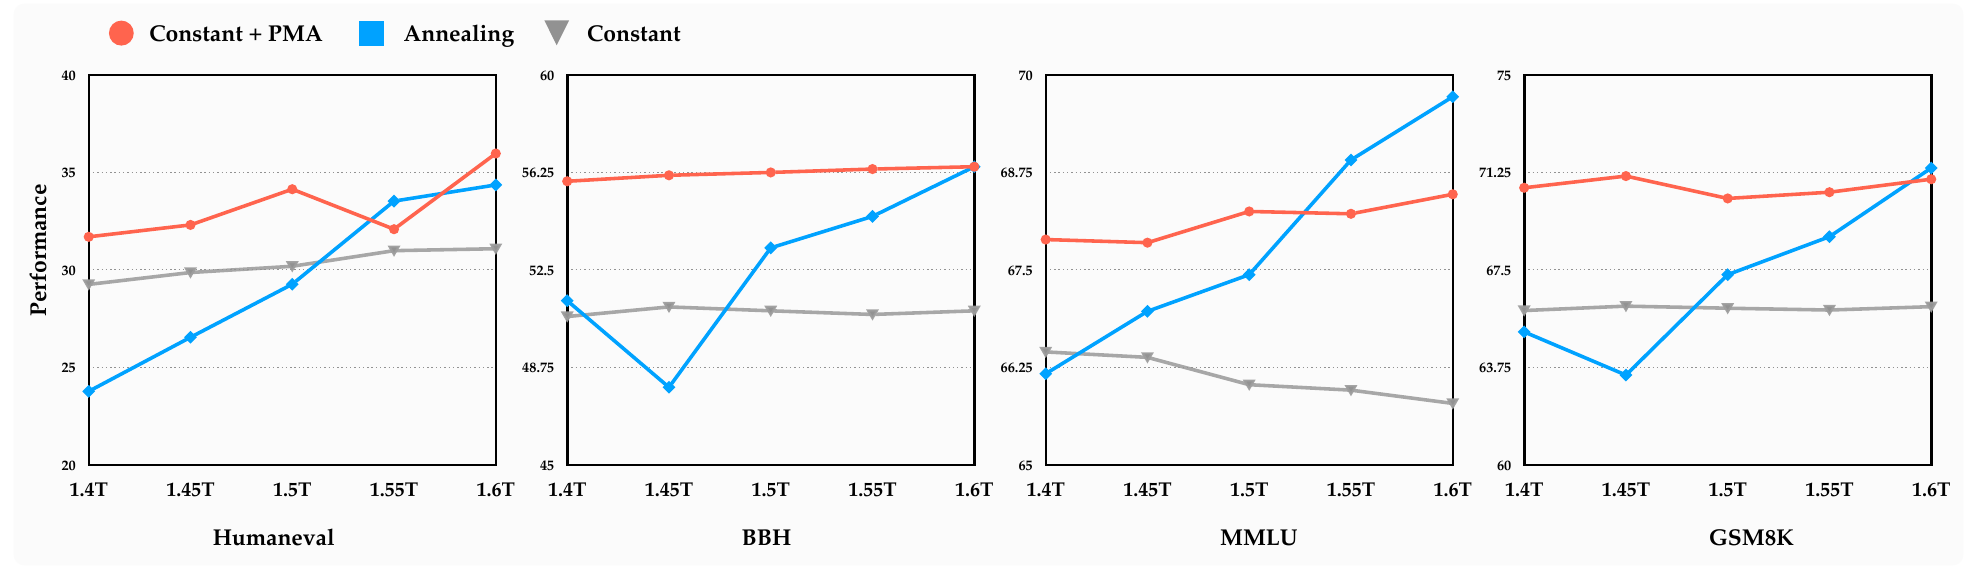
まず灰色と赤の線を見る。同じく学習率一定でも、マージしない灰色の線はほとんど伸びず、MMLU ではむしろ下がり続ける。マージした赤い線は最初から一段高い。
次に青い線。アニーリングの初期はスコアが低めで、BBH と MMLU ではいったん下がってから上がり続ける。1.6T になると、HumanEval、BBH、GSM8K では赤と青の線はほぼ同じで、MMLU ではアニーリングのほうが明らかに高く、二ポイントほど上回る。
著者らの結論では、学習率一定の訓練にマージを組み合わせれば、訓練過程のどの時点でもアニーリング後の性能をおおよそ予測でき、手早い検証に使うには割に合う。この結論は三つのベンチマークで成り立つが、MMLU は例外であることを、図を読むときに覚えておきたい。
マージの仕方:手法、間隔、数
手法。Seed-MoE-1.3B/13B で 204B token まで訓練した時点では、三つの手法はいずれもマージ前よりよく、WMA が最良で、 の EMA も に勝つ。訓練初期は重みの変化が大きく、新しい checkpoint ほど大きな重みを与える価値がある。訓練の後半になると、三つの手法の差はほとんどなくなる。著者らは以降、最も簡単な SMA を使う。
間隔 。 に固定し、 を 4B、8B、16B、32B token で比べる。訓練初期(204B token)では、16B と 32B の間隔はマージしない場合よりかえって悪い。さかのぼりすぎて、訓練初期のまだ不安定な重みが混ざるからだ。訓練が長くなるほど、間隔による差は小さくなる。
著者らは、モデルサイズに応じてスケールする経験値をまとめている。0.7B/7B モデルで約 4B token、1.3B/13B で約 8B、10B/100B で約 80B だ。大きなモデルは通常より大きなバッチを使うので、checkpoint 間の間隔もそれに合わせて長くなる。
数 。 に固定し、3、6、10、15 個の checkpoint を比べる。訓練初期に取りすぎると、やはり不安定な重みが混ざる。訓練後半は多いほどよく、 は より 1 ポイント近く高い。著者らは間を取って とする。
マージ後を次の段階の出発点にする
事前訓練の後には、通常、継続訓練(continued training、CT)、SFT、強化学習が続く。著者らはマージ後の重みを次の段階の出発点にし、これを PMA-init と呼ぶ。
CT 段階。Seed-MoE-0.7B/7B を約 1T token 訓練した後にマージし、続けて CT を行う。PMA-init は初期の損失がやや低く、MMLU も序盤はよい。しかし訓練が進むと、両者の損失はほぼ同じところに収束し、全体のスコアも並ぶ。学習率スケジュールをいくつか変えても、結論は同じだった。
SFT 段階。Seed-MoE-15B/150B で、マージ後の重みから 220M token の SFT を行う。同じ学習率で、PMA-init は MMLU が 86.8 から 87.1、LiveBench が 50.5 から 52.0、AMC-2023 が 61.0 から 64.0 になる。社内評価の OOD と指示追従も、それぞれ二ポイント以上上がる。
ただし著者らは、この幅の改善は他のサイズのモデルでは再現できなかったと正直に書いている。PMA-init は下流の性能を損なわず、役立つこともあるが、毎回役立つ保証はない。
損失スパイクから立ち直る
PMA-init には、少し意外な使い道もある。
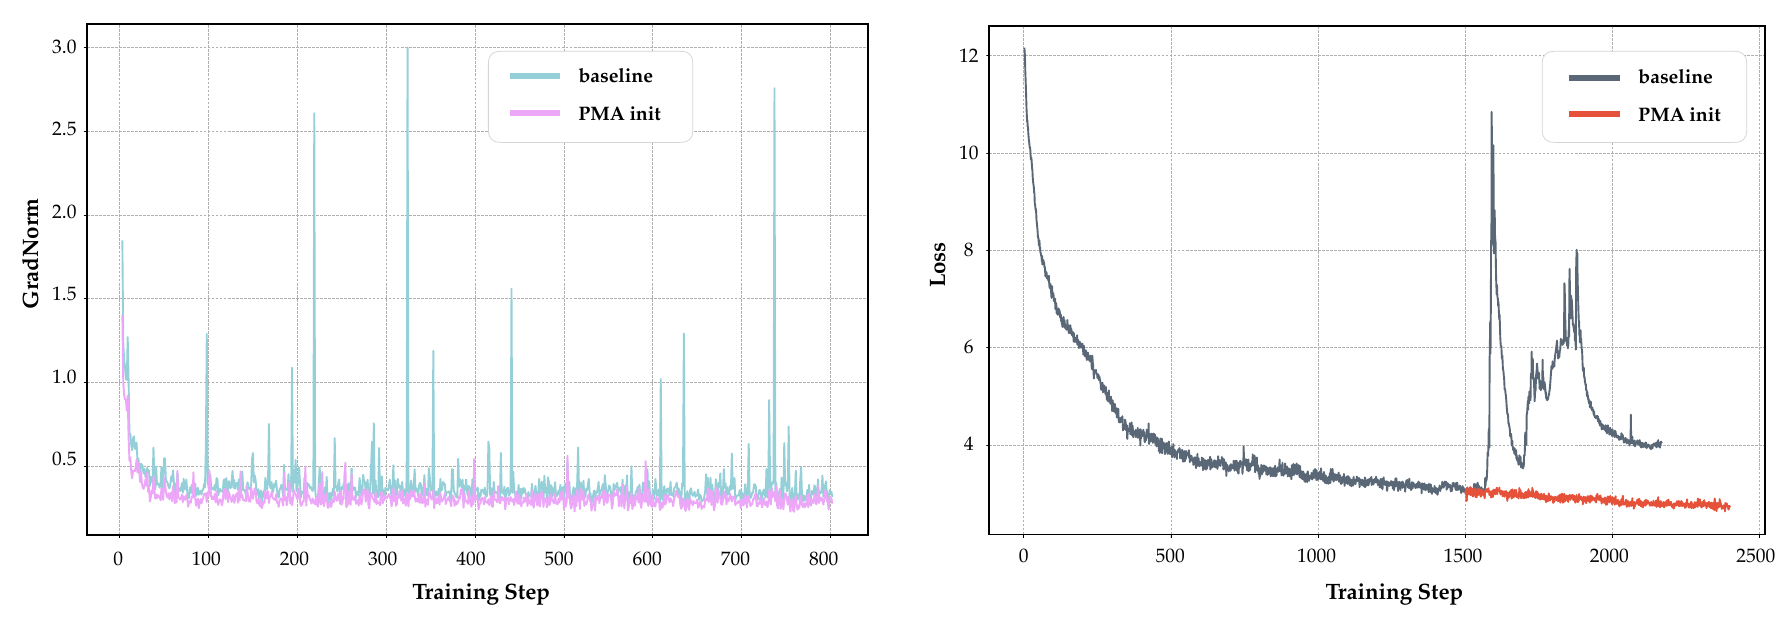
左図は SFT 時の勾配ノルムで、PMA-init の線は明らかに穏やかで、損失のスパイクも少ない。
右図は、著者らが意図的に作り出した不安定な訓練だ。大きなモデルで損失スパイクを直接研究するのはコストが高すぎるため、330M/3.3B の小さな MoE モデルに 6e-3 という特に大きな学習率を組み合わせ、大きなモデルでよく起きるスパイクを再現した。元の訓練はスパイクの後、二度と元の軌道に戻れない。著者らがスパイク前に保存した三つの checkpoint をマージしてそこから再開すると、訓練は元々問題が起きた位置を難なく通り過ぎた。
これは大規模訓練に実用的な選択肢を与える。立て直せない損失スパイクに遭遇しても、ずっと前の checkpoint まで戻ったり、最初からやり直したりする必要はない。まずスパイク前のいくつかの checkpoint を平均してから訓練を続ければよい。
議論
なぜ平均するとよくなるのか
著者らは、最適点 の近くでの損失の二次展開で説明する。各 checkpoint の最適点からのずれを 、ヘッセ行列を とし、最適点では勾配がゼロなので、
平均後のモデルのずれは だ。両辺を展開して比べると、マージモデルの損失が個々のモデルの平均損失より低くなる条件は
右辺は が正定値なら必ず正だ。左辺の交差項の多くが負なら、つまり各 checkpoint が最適点から見て「補い合う」方向にずれていれば、この条件は容易に成り立つ。
checkpoint 二つで最も極端な場合を試そう。 なら、二点は最適点のちょうど両側にあり、平均するとぴったり に落ちて、損失は最小の になる。 なら二点は重なり、平均しても何の得もない。
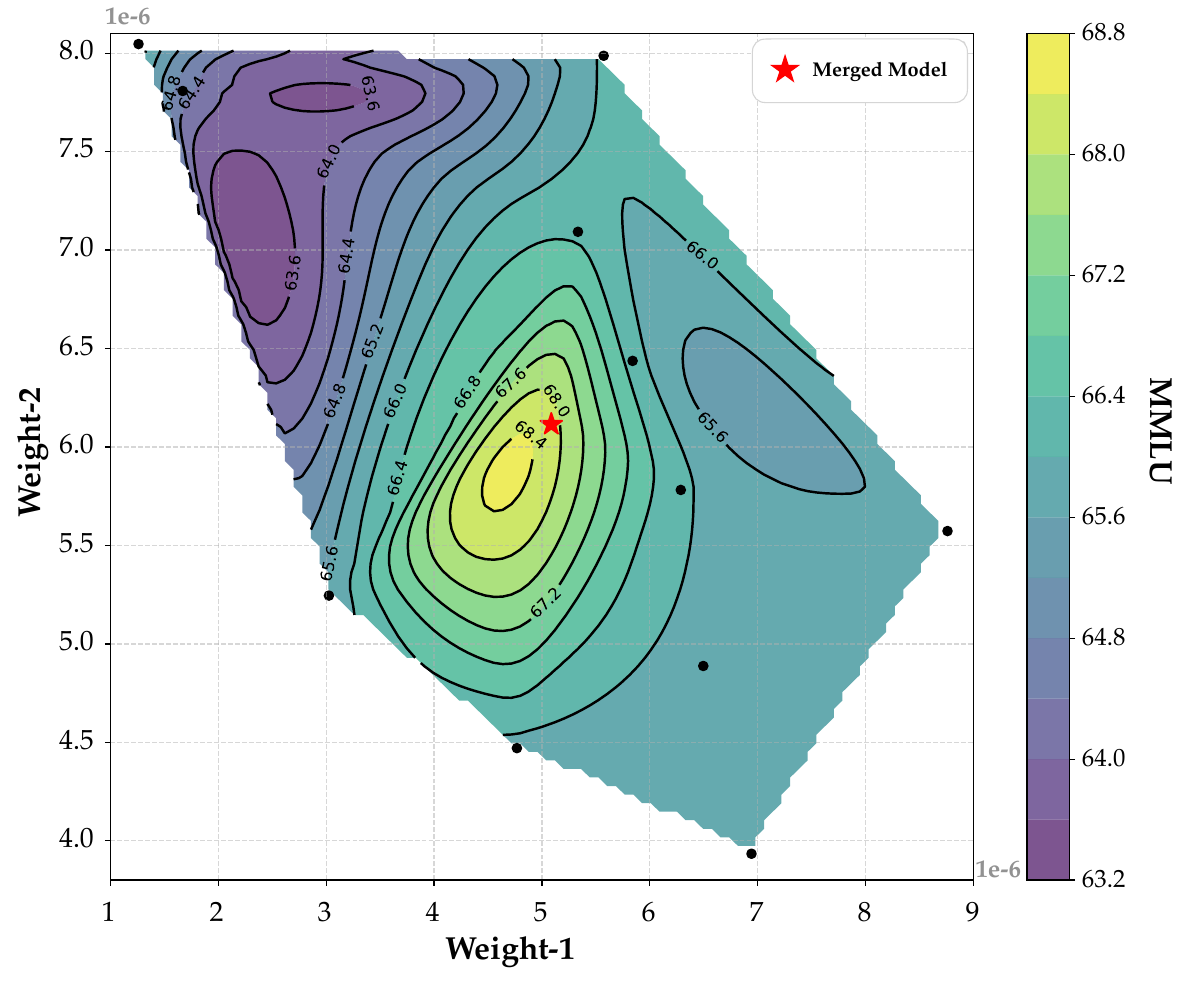
著者らは Seed-MoE-1.3B/13B のある層から二つのパラメータを選んで図にもしている。各 checkpoint は高スコア領域の周りに散らばり、平均した赤い星はより中心に近い。
アニーリングを終えた checkpoint をマージしても効果が限られる理由も、これで説明できる。学習率が十分下がると、checkpoint はすべて同じ小さな谷底に集まっており、ずれの方向はもう補い合わず、平均してもそこから抜け出せない。
ただし、この分析には多くの仮定がある。checkpoint がすべて同じ最適点の近くにあり、二次近似が成り立ち、ヘッセ行列が正定値であることを仮定している。非凸な事前訓練の過程では、どれも近似にすぎない。二つのパラメータの等高線図は、極めて高次元の空間の小さな断面で、著者ら自身も直感的な説明にしか使っていない。
この論文を読むときの注意点
モデル、アーキテクチャ、コーパスはすべて社内のもので、再現できない。主な指標は十六のベンチマークの加重平均で、その重みは公開されていない。間隔の経験値は三つのサイズの MoE モデルから得たもので、バッチサイズやデータの配合が変われば、数字がそのまま当てはまるとは限らない。
一方で、この論文の実験規模は公開文献ではめったにない。数億パラメータから総パラメータ二千億まで、すべてでアブレーションを行っており、自分たちの事前訓練工程に checkpoint の平均を取り入れたいチームにとって、非常に具体的な参考になる。
数か月後の WSM は同じ方向をさらに推し進め、学習率の減衰をまるごと checkpoint のマージに置き換えた。
結論
この論文は「事前訓練中に checkpoint を平均する」ことを、技術報告の一文から、体系的なアブレーションを伴う実験結果に変えた。
学習率一定の段階で直近の checkpoint を平均すると、スコアははっきり上がり、アニーリング後の性能もおおよそ予測できる。SMA で十分で、間隔はモデルサイズに応じて広げ、訓練の後半は checkpoint を多めにするとよい。PMA-init は CT と SFT で性能を損なわず、立て直せなかった損失スパイクを正しい軌道に引き戻すこともできる。
事前訓練の途中で成績をのぞき見したくなったら、まず直近十個の checkpoint を平均してみるといい。アニーリングに費やす数千億 token は、後で使っても遅くない。