原論文
Task Arithmetic in the Tangent Space: Improved Editing of Pre-Trained Models
- 発表先
- NeurIPS 2023国際会議
- arXiv への初回投稿
- arXiv:2305.12827
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingtangenttaskarithmetic2023,
  title = {{Task Arithmetic in the Tangent Space: Improved Editing of Pre-Trained Models}},
  author = {Guillermo Ortiz-Jimenez and Alessandro Favero and Pascal Frossard},
  year = {2023},
  eprint = {2305.12827},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.12827}
}
タスク算術によれば、微調整の前後の重みを引き算すると「タスクベクトル」が得られ、これらは足すことも引くこともできる。二つのタスクのベクトルを足せば、モデルは両方をこなせる。一つを引けば、モデルはそのタスクを忘れる。
効果は高いが、理由はずっとよくわかっていなかった。
当時よく言われていた説明では、大規模な事前訓練モデルを微調整しても重みはわずかしか動かず、ネットワークはこの狭い範囲でほぼ線形だとされた。線形なら、重みを足せば出力も当然足し合わされる。
EPFL の Ortiz-Jimenez、Favero、Frossard は、この説明を真剣に検証することにした。その結果、説明は誤りだとわかったが、誤った方向をそのまま進んだ先で、かえってよりよい方法にたどり着いた。
問題の定義
タスク算術が成り立つには何が必要か
まず「タスク算術が成り立つ」とは何かを明確にする。 を事前訓練重み、タスク で微調整した重みを とし、タスクベクトルを とする。各タスクには固有の入力範囲 がある。例えば EuroSAT の衛星画像や SVHN の番地の数字だ。異なるタスクの入力範囲は互いに重ならない。
著者らはタスク算術を次の性質として書く。
平たく言えば、複数のタスクベクトルを同時に加えた後、衛星画像を見たときのモデルの振る舞いは「衛星画像のベクトルだけを加えた」ものと同じでなければならない。どのタスクにも属さない入力を見たときは、事前訓練モデルと同じでなければならない。各ベクトルは自分の領域だけを変え、他を邪魔しない。
線形性の仮説
ニューラルネットワークは の近くで一次のテイラー展開ができる。
右辺は について線形で、カーネル法と等価だ。カーネル関数はニューラルタンジェントカーネル(neural tangent kernel、NTK) である。
微調整が本当にこの線形な範囲で起きているなら、 を加えたときの出力の変化は、二つのタスクそれぞれの変化の和になり、タスク算術は自動的に成り立つように見える。
では、CLIP の微調整は本当に線形なのだろうか。
問題を解く
検証その一:微調整は線形ではない
微調整が線形なら、微調整後のタスクベクトル を線形近似に当てはめた結果は、元の微調整モデルとほぼ同じになるはずだ。著者らはこれを事後線形化(post-hoc linearization)と呼ぶ。
実験はタスク算術の元論文の設定を踏襲し、CLIP の ViT-B/32、ViT-B/16、ViT-L/14 を、Cars、DTD、SUN397、EuroSAT、GTSRB、MNIST、SVHN、RESISC45 の八つのデータセットで微調整する。
結果、事後線形化の単一タスク精度は元の微調整モデルより明らかに低く、三つのサイズの ViT すべてで同じだった。著者らはこの差を「非線形の優位性」と呼ぶ。微調整は線形な範囲にとどまっていない。
もう一つの可能性として、非線形な部分は単一タスクには重要でも、タスク算術は線形な部分しか使っていないのかもしれない。著者らはこれも調べた。非線形な微調整で得たタスクベクトルを使い、事後線形化したモデルで八タスクを加算する。
| モデル | ViT-B/32 | ViT-B/16 | ViT-L/14 |
|---|---|---|---|
| 事前訓練(ゼロショット) | 48.4 | 55.2 | 64.4 |
| 非線形な微調整 | 71.4 | 75.5 | 85.1 |
| 事後線形化 | 57.1 | 65.0 | 75.2 |
表は八タスクの平均絶対精度(%)だ。事後線形化では 10 ポイント以上落ちており、タスク算術は明らかに非線形な部分も使っている。線形性の仮説は成り立たない。
ただし、表には奇妙な点も隠れている。正規化精度、つまりそれぞれの単一タスク微調整の精度で割った値で見ると、事後線形化のほうがむしろ高い。ViT-B/32 では非線形な微調整が 76.5%、事後線形化が 81.9% だ。タスクの忘却も同じで、事後線形化のほうがきれいに忘れる。
線形化したモデルはどのタスクでも成績が劣るが、「加算後にどれだけ保てるか」では勝っている。
重みの分離性
著者らは、タスク算術に必要な条件は重みの分離性(weight disentanglement)だと考える。
ここで は 上でのみ非ゼロ、 はすべてのタスク範囲の外でのみ非ゼロだ。モデルの出力は互いに重ならない局所的な関数に分解でき、それぞれは自分のタスクベクトルだけで制御される。
この条件は先ほどのタスク算術の性質と等価で、しかも線形性を要求しない。 はパラメータについてどんな形の関数でもよい。著者らはさらに、重みの分離性が述べているのは「互いに干渉しない」ことで、各タスクの成績がよいかどうかとは別の話だと念を押している。
分離の度合いを測るため、著者らは二つのタスクの間の分離誤差を定義する。
これはタスク のデータ上で、「自分のベクトルだけを加えた」場合と「両方を加えた」場合で予測が異なる割合だ。誤差が小さいほど、二つのベクトルは互いに干渉しない。
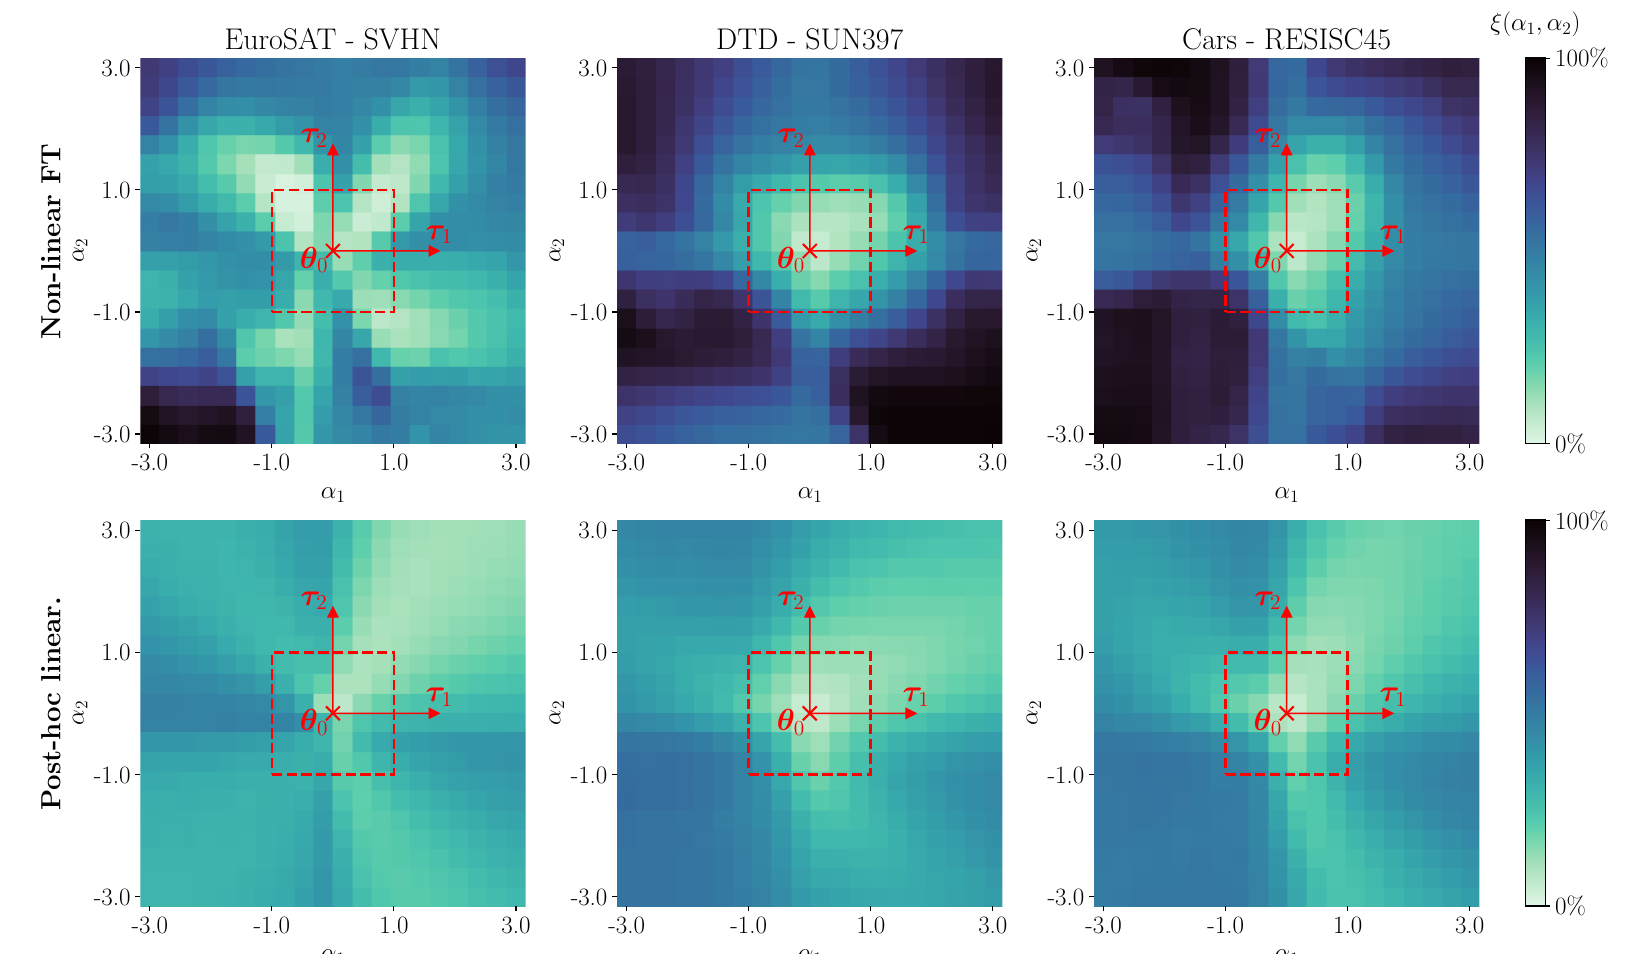
各図の中心が事前訓練重み で、二本の赤い矢印が二つのタスクベクトルだ。上段の非線形モデルは原点付近の小さな範囲だけが淡い色で、 が 1 を超えると誤差は急速に上がる。これでタスク算術の元論文の二つの経験的な観察が説明できる。最適な係数はたいてい 1 未満であること、そして微調整では学習率を小さく、ステップ数を少なくすべきことだ。
下段の事後線形化モデルでは、淡い領域がずっと広い。線形化するとタスクベクトル同士が干渉しにくくなる。これが正規化精度の高さの理由だ。
問題ははっきりした。線形化したモデルは分離性に優れるが単一タスクで弱すぎ、非線形モデルは単一タスクで強いが分離性に劣る。両方を取れないだろうか。
接空間で直接微調整する
著者らのやり方は、事後に線形化するのではなく、最初から線形化したモデルで微調整することだ。
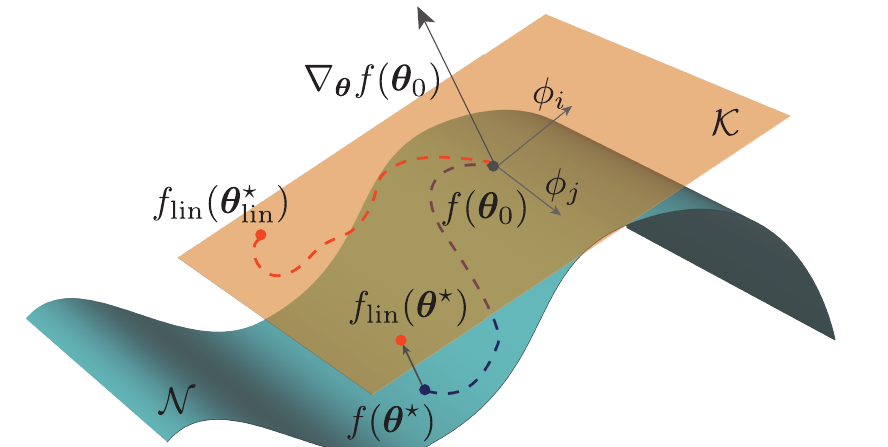
この図は三つのやり方を並べている。曲がった曲面 はすべてのネットワーク関数、平面 は での接空間だ。通常の微調整は曲面に沿って まで進む。事後線形化はこの終点を平面へ射影するので、精度が落ちる。線形化微調整は最初から最後まで平面上を進み、最適化の目標は平面上の最適点 そのものだ。
二つの線形モデルのカーネル関数は同じだが、タスクベクトル は線形モデルに対して直接最適化したものなので、単一タスクの性能がずっとよい。
実装上、線形化モデルは「 を固定し、変位を訓練する」ネットワークだ。PyTorch の torch.func.jvp を使えば、一回の順伝播で と、Jacobian に変位を掛けた結果を同時に計算できる。小さな MLP で、線形近似がいつ正確かを見てみよう。
import torch
from torch.func import functional_call, jvp

torch.manual_seed(0)
net = torch.nn.Sequential(torch.nn.Linear(4, 16), torch.nn.Tanh(), torch.nn.Linear(16, 2))
theta0 = {k: v.detach().clone() for k, v in net.named_parameters()}
x = torch.randn(8, 4)

def f(params):
    return functional_call(net, params, (x,))

def f_lin(params):
    delta = {k: params[k] - theta0[k] for k in params}
    out, dp = jvp(f, (theta0,), (delta,))     # f(θ0) と J·(θ − θ0) を一回の順伝播で計算する
    return out + dp

direction = {k: torch.randn_like(v) for k, v in theta0.items()}
for scale in [0.01, 0.1, 1.0]:
    theta = {k: theta0[k] + scale * direction[k] for k in theta0}
    gap = (f(theta) - f_lin(theta)).abs().max().item()
    print(f"変位の倍率 {scale:<4}  元モデルと線形化モデルの最大差 {gap:.5f}")
変位の倍率 0.01  元モデルと線形化モデルの最大差 0.00152
変位の倍率 0.1   元モデルと線形化モデルの最大差 0.13638
変位の倍率 1.0   元モデルと線形化モデルの最大差 8.19715
変位が小さいうちは両者はほぼ同じだが、変位が大きくなると差は急速に開く。通常の微調整がどこまで進もうと、線形モデルはそれを追えない。線形化微調整はモデルを接空間に縛りつけるので、どれだけ遠くへ進んでも、重みと出力の関係は線形のままだ。
論文の実験では、著者らは CLIP の画像エンコーダだけを線形化し、テキストエンコーダはもともと凍結している。訓練設定は通常の微調整とまったく同じで、2,000 ステップ、バッチ 128、学習率 、AdamW と cosine スケジュールを使い、ハイパーパラメータの追加調整もしていない。
議論
加算も減算もよくなった
最後の行が線形化微調整の結果だ。
| タスク加算(絶対/正規化 %) | ViT-B/32 | ViT-B/16 | ViT-L/14 |
|---|---|---|---|
| 非線形な微調整 | 71.4/76.5 | 75.5/80.0 | 85.1/88.8 |
| 線形化微調整 | 76.5/85.4 | 81.3/86.0 | 88.5/93.5 |
八タスクを加算したときの平均絶対精度は、三つのモデルでそれぞれ 5.1、5.8、3.4 ポイント上がる。
タスクの忘却は、あるタスクベクトルを引いた後、対照タスクの ImageNet で事前訓練時の精度の少なくとも 95% を保つという条件のもとで、対象タスクをどこまで下げられるかで評価する。ViT-B/32 では、非線形な微調整で対象タスクは 24.0% まで、線形化微調整では 10.9% まで下がり、13.1 ポイント多く忘れる。ViT-L/14 では 18.0% から 7.9% になる。対照タスクの精度はほぼ同じだ。
係数の選び方は元論文と同じで、すべてのタスクで一つの を共有し、0~1 を 0.05 刻みで探して、訓練データの一部で最良の値を選ぶ。
線形化の利点は小さなモデルで最も大きく、モデルが大きいほど差は小さい。付録でも、大きなモデルほどもともと分離性が高いことが見つかっている。
代償
線形化はただではない。付録によれば、推論時には各演算でもう一度導関数を計算する必要があり、元のモデルのおよそ二~三倍の時間がかかる。訓練時の勾配の計算量とメモリもおよそ倍になる。著者らはこれを「定数倍の増加にすぎない」と書くが、大きなモデルでは、二~三倍の推論コストはそのままデプロイに響く。
後の研究もここを切り口にした。例えば Partial Linearization は LoRA の adapter だけを線形化し、コストを一部のパラメータに抑えている。
なぜ分離するのか
著者らは最後に、カーネル法の観点から説明を与える。カーネル関数は固有関数の組 に分解できる。各タスクが「自分の入力範囲内でのみ非ゼロ」の固有関数だけを使うなら、異なるタスク同士は干渉しない。
著者らは ViT-B/32 で実際に確かめた。RESISC45 で線形化微調整を行い、その NTK を固有分解して、各入力点での固有関数のエネルギーの総和を計算する。RESISC45 のデータ点ではエネルギーが明らかに高く、対照の Cars のデータ点では低かった。RESISC45 を表す固有関数は、確かに RESISC45 のデータに集中している。
著者らは、この局所化はタスク算術の必要条件ではないとも説明している。固有関数は他の領域で互いに打ち消し合うこともありうる。固有関数が各領域内で線形独立な場合に限り、必要条件になる。
分離性は事前訓練で身につく
最後の実験では事前訓練を取り除く。ランダム初期化の ViT から出発し、八つのタスクでそれぞれ微調整してタスクベクトルを得て、加算する。
結果、タスク算術はまったく機能しなかった。ランダム初期化の ViT-B/32 を非線形に微調整した単一タスクの平均は 48.5% だが、八つのベクトルを加算すると 5.5% しか残らず、ランダム初期化のまま微調整していないモデル(5.3%)とほぼ同じだ。線形化微調整でも同じだった。
したがって、重みの分離性は事前訓練の過程で生まれる。事前訓練は意味を切り分ける特徴を学ぶだけでなく、それらの意味領域を制御する重みの方向も互いに分ける。
証拠の範囲
主な実験はすべて CLIP ViT と八つの画像分類データセットで行い、付録で T5 と畳み込みネットワークも扱っている。タスク同士の「入力範囲が互いに重ならない」ことが定義全体の前提で、八つのデータセットではおおむね成り立つ。二つのタスクの入力がもともと重なる場合、例えば同じテキストに対する二種類のラベル付けでは、この分析はそのまま当てはめられない。
結論
この論文はまず「タスク算術は線形な微調整から来る」という説明を覆し、次にタスク算術に必要な条件を重みの分離性、つまり異なるタスクベクトルがそれぞれ自分の入力範囲だけに影響することとして定式化した。
線形化したモデルは分離性に優れるが、単一タスクでは弱すぎる。微調整を接空間へそのまま移せば両方の利点を同時に得られ、代償は推論に二~三倍の時間がかかることだ。
デプロイの予算がこの倍率を許し、しかも大量のタスクベクトルをよく足し合わせるなら、線形化微調整は試す価値がある。公式コードは線形化モデルを通常の nn.Module として包んでいるので、訓練スクリプトはほとんど変えなくてよい。
予算が足りなくても構わない。係数を 1 以内に抑えておけばよい。1 を超えると、タスクベクトル同士がけんかを始める。