原論文
2 OLMo 2 Furious
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2501.00656
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformersolmo22024,
  title = {{2 OLMo 2 Furious}},
  author = {Team OLMo and Pete Walsh and Luca Soldaini and Dirk Groeneveld and Kyle Lo and Shane Arora and Akshita Bhagia and Yuling Gu and Shengyi Huang and Matt Jordan and Nathan Lambert and Dustin Schwenk and Oyvind Tafjord and Taira Anderson and David Atkinson and Faeze Brahman and Christopher Clark and Pradeep Dasigi and Nouha Dziri and Allyson Ettinger and Michal Guerquin and David Heineman and Hamish Ivison and Pang Wei Koh and Jiacheng Liu and Saumya Malik and William Merrill and Lester James V. Miranda and Jacob Morrison and Tyler Murray and Crystal Nam and Jake Poznanski and Valentina Pyatkin and Aman Rangapur and Michael Schmitz and Sam Skjonsberg and David Wadden and Christopher Wilhelm and Michael Wilson and Luke Zettlemoyer and Ali Farhadi and Noah A. Smith and Hannaneh Hajishirzi},
  year = {2024},
  eprint = {2501.00656},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2501.00656}
}
この報告のタイトルは冗談で、映画『ワイルド・スピード X2』の英題「2 Fast 2 Furious」をもじっている。
中身はいたって真面目だ。OLMo はアレン人工知能研究所(AI2)の「完全オープン」な言語モデルシリーズで、重みだけでなく、事前訓練データ、訓練コード、途中の checkpoint、訓練ログまで公開している。この種のモデルは研究にとって重要だ。訓練ダイナミクスや、データと記憶の関係を調べたいなら、完全オープンなモデルしか使えない。ただ、その性能は重みだけを公開するモデルにずっと一歩遅れていた。
OLMo 2 はこの差を縮めようとする。7B、13B、32B の三サイズがあり、最大 6.6T token まで訓練し、後訓練には同じチームの Tülu 3 のレシピをそのまま適用した。報告が重点を置くのは、事前訓練の安定性、中間訓練(mid-training)のレシピ、後訓練、そして訓練基盤の四つだ。
このノートでは主に前の二つを見る。一つ目は OLMo 2 が大きくなるための前提で、二つ目ではモデルマージが使われている。
問題の定義
前の版の OLMo-0424 は、性能こそ想定の範囲内だったが、訓練の過程はかなり不安定だった。
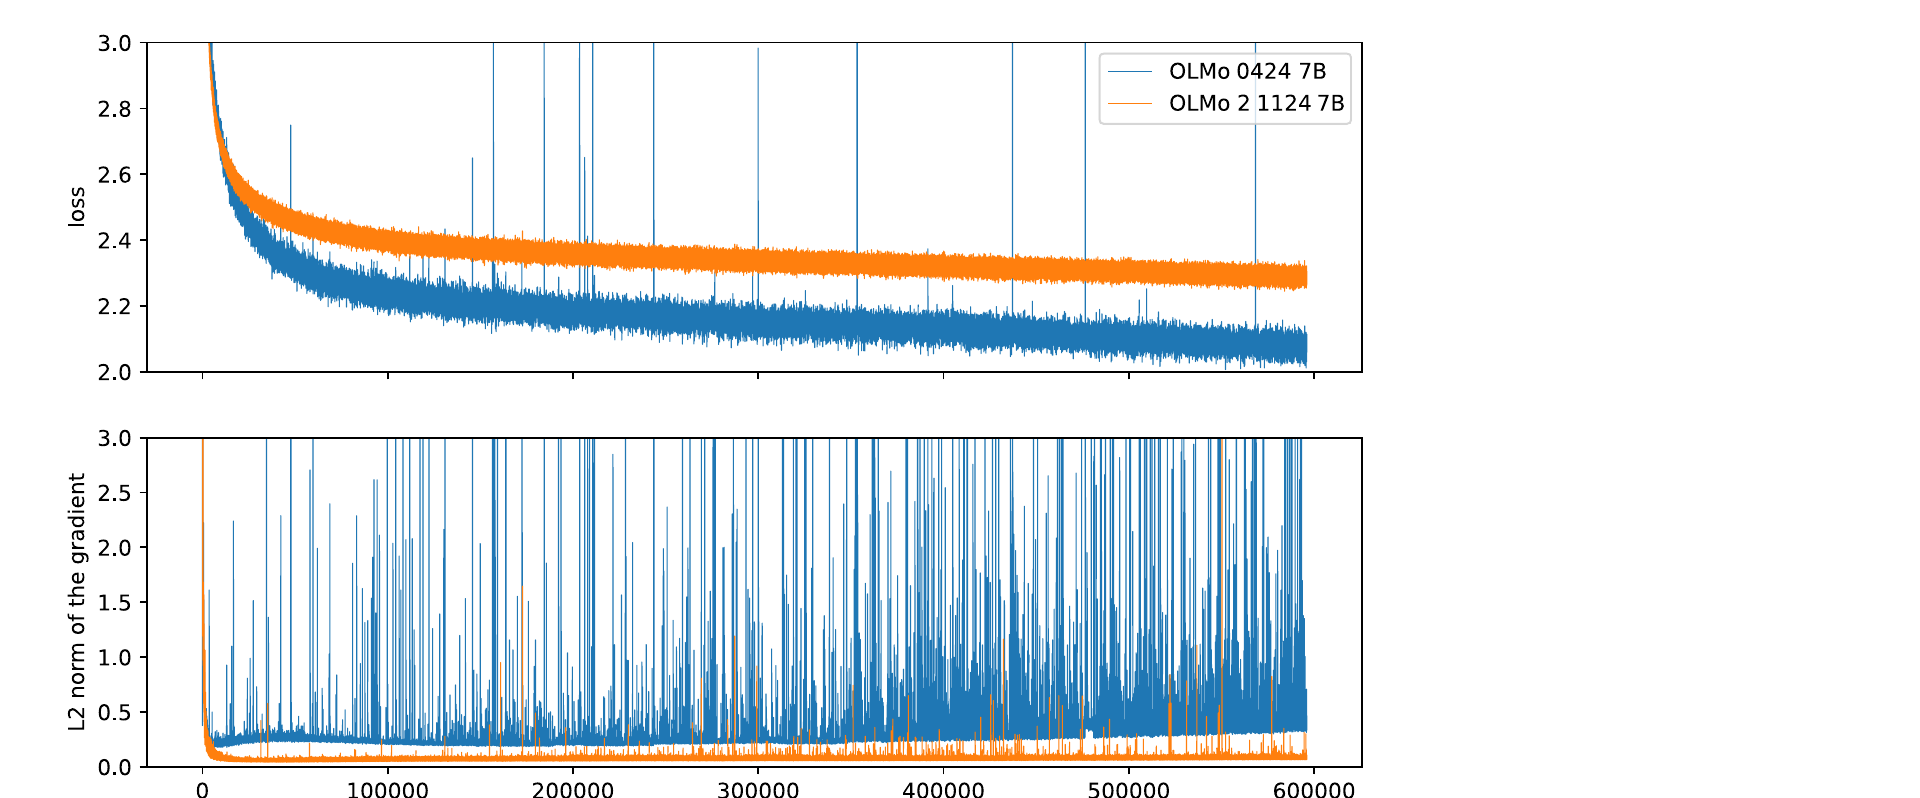
青が OLMo-0424 で、問題は二つある。一つ目は損失と勾配ノルムの突然のスパイクで、しかも勾配のスパイクは損失のスパイクより先に現れることが多い。二つ目は、勾配ノルムのベースラインが訓練全体を通じてゆっくり大きくなり、それにつれてスパイクもますます頻繁になることだ。著者らは、モデルが大きいほどスパイクが多く、二つが重なると最終的に訓練が発散し、規模をまったく広げられないことに気づいた。
橙が OLMo 2 で、勾配はほぼ底に張り付いている。上図で橙の損失が高めに見えるのは、二つの訓練で使ったデータが違うからで、直接は比べられない。
では、どの変更が青い線を橙の線に変えたのだろうか。
問題を解く
安定性のための七つの変更
著者らは全部で七つの変更を加えた。データに手を入れたもの、アーキテクチャに手を入れたもの、ハイパーパラメータを一つ変えただけのものがある。
1. 繰り返しの多い n-gram を除く。 著者らがスパイクの起きたバッチを調べると、g400g400g400g400... や延々と続く 255, 255, 255, ... のような繰り返しの断片がよく見つかった。関係ははっきりしない。同じ断片が大きいモデルではスパイクを起こすのに、小さいモデルでは起こさず、データの順序を変えるだけで何も起きなくなることもある。それでも全体としては、この種のデータを除くとスパイクの頻度が下がる。
やり方は、データ整理の段階で、32 回以上繰り返す n-gram(n は 1~13 token)を含む文書を削除することだ。訓練コードもデータを読み込むときにもう一度チェックし、すり抜けたものは損失をマスクする。これで勾配のスパイクははっきり減るが、勾配ノルムがゆっくり上がる問題には効かない。
2. 初期化。 OLMo-0424 はスケーリング初期化を使い、深い層ほど初期値を小さくしていた。OLMo 2 は最も単純なやり方に戻し、すべてのパラメータを平均 0、標準偏差 0.02 の正規分布から抽出する。著者らはランダムに初期化したモデルで、活性値と勾配が最初の層から最後の層までにどれだけ拡大・縮小するかを測った。新しい初期化は、深さや幅が変わってもスケールを保ちやすかった。
3. RMSNorm。 パラメータを持たない LayerNorm を RMSNorm に置き換える。
4. 正規化の位置。 これはやや珍しい選択だ。通常の Pre-LN は入力を先に正規化してから注意層やフィードフォワード層に送るが、OLMo 2 はサブレイヤーの出力を正規化するように変えた。
このやり方は Swin Transformer V2 から来ている。残差ストリーム 自体は正規化されないが、各層が足し込む増分はまず一定のスケールに抑えられるので、ある層が突然大きな値を加えることがない。
5. QK-norm。 注意を計算する前に、query と key に RMSNorm をかけ、注意の logit が大きくなりすぎるのを防ぐ。
6. Z-loss。 損失に を加える。 は出力層の softmax の分母だ。logit 全体が大きくなり続けると もそれにつれて大きくなり、この項がそれを引き戻す。
この項にはちょっとした逸話もある。FlashAttention ライブラリの交差エントロピー実装には z-loss が組み込まれており、著者らは予備として PyTorch で別の版も書いた。両者は順伝播の結果が同じなのに、逆伝播が食い違い、著者らは数値精度の違いを疑った。訓練損失にも下流の性能にも影響は見えなかったが、著者らは実装を切り替えた区間の訓練を捨て、分岐点に戻って元の実装でやり直すことにした。訓練の途中では、どんな実装もできるだけ変えないようにしている。
7. 二つのオプティマイザ設定。 埋め込み層には重み減衰をかけないことにし、AdamW の を から に下げた。後者によって、訓練初期の勾配ノルムが低く、安定する。
この七つの変更に、新発明は一つもない。著者らの貢献は、一つずつ実験して OLMo という設定での効果を測り、そのうえで全部を一つのレシピにまとめたことにある。
二段階の事前訓練
OLMo 2 の事前訓練は二段階に分かれる。
第一段階は訓練計算量の九割以上を占め、約 3.9T token の OLMo 2 Mix 1124 を使う。その 95% 超がウェブデータ(主に DCLM 由来)で、残りはコード(StarCoder)、論文(peS2o、arXiv)、数学系のウェブページ、Wikipedia だ。コードデータは GitHub のスター数が 2 以上のリポジトリだけを残す。最も頻出する一語が全文の 30% を超える文書も削除し、バイナリやほぼ数字だけの内容を取り除く。
第二段階を著者らは中間訓練と呼び、計算量の 5%~10% を占める。この段階で学習率は 0 まで線形に下がり、データは厳選した Dolmino Mix 1124 に切り替わる。品質分類器が選んだ上位 7% のウェブページ、汚染除去した FLAN の指示データ、論文、Wikipedia、Stack Exchange の質疑応答に、数学能力を補うための合成データを加えたものだ。
効果は大きい。7B モデルは中間訓練を経て開発評価の平均スコアが 10.6 ポイント上がり、第一段階だけを終えた 13B を上回った。GSM8K は 24.1 から 67.5、MMLU は 59.8 から 63.7、DROP は 40.7 から 60.8 に上がった。
小さなアニーリングでデータを選ぶ
中間訓練のデータはどう選ぶのか。50B token のアニーリングを丸ごと走らせるのは高すぎるので、著者らは安価な方法を考案し、microanneal と名付けた。
- 評価したい数学データの出所を一つ、または小さな組で選ぶ。
- 一般データから同じ量の token を取り、数学が半分、一般データが半分の小さな混合を作る。
- この小さな混合をアニーリングとして訓練し、学習率はその長さに合わせて 0 まで線形に下げる。
microanneal は全部で 19 回、合計 130B token で、50B の完全なアニーリング三回分よりも少ない。しかも、たいてい 10B token も訓練しないうちに差が見えてくる。この考え方は Llama 3 がアニーリングで小さなデータセットを評価したやり方によく似ているが、より体系的に行っている。
中間訓練のモデルスープ
次が、このノートで最も注目する一歩だ。中間訓練の最後に、著者らは一回だけ走らせるのではなく、同じデータでデータ順序を変えて何度か走らせ、その結果を平均した。
これが有効であることを確かめるため、著者らは 7B で六種類の中間訓練配合を比べた。それぞれ三つの異なるデータ順序で 50B token ずつ走らせ、「三回のうち最良の一つ」と「三つの平均」を比較した。
| 配合 | 評価 | 最良の単一モデル | 三つの平均 |
|---|---|---|---|
| A | OLMES | 75.6 | 77.0 |
| B | OLMES | 75.3 | 77.3 |
| C | OLMES | 76.3 | 76.8 |
| A | MMLU | 61.2 | 62.0 |
| B | MMLU | 61.5 | 62.7 |
| C | MMLU | 62.8 | 63.5 |
六種類の配合と四種類の評価で計二十四組の比較があり、そのうち二十三組で、平均したモデルは最良の単一モデルより悪くならず、多くはよかった。たとえば配合 B の OLMES は 2 ポイント上がった。例外は配合 E の GSM* で、平均すると 60.5 から 43.0 に落ちた。
そのため、最終的な OLMo 2 はすべて「スープ」だ。7B は、それぞれ 50B token 走らせた三つのモデルを平均した。13B と 32B は四つを平均した。三つは各 100B token、もう一つは 300B token 走らせたもので、著者らはこれが 100B の三つだけを平均するよりよいことを見つけた。
ここで Tülu 3 と比べておきたい。同じチームが SFT の段階で異なるシードのモデルを平均したときは、最良の単一モデルを上回らなかった。一方、中間訓練で異なるデータ順序のモデルを平均すると、ほぼすべての組で効果があった。両者の違いは、中間訓練の各モデルがどれも 50B 以上の token を見ていて、同じ事前訓練 checkpoint から出発し、学習率を 0 まで下げている点にある。この条件は Model Soups や PMA が研究した状況に近い。論文はこの二つの結果を正面から比べておらず、これは本稿の推測にすぎない。
後訓練
後訓練は基本的に Tülu 3 をそのまま使う。SFT、長さ正規化 DPO、RLVR だ。変更点は二つある。選好データでは、ライセンスの緩いモデルで回答を生成するように変えた。RLVR は最良の性能を得るため、複数の段階に分けて行った。
議論
計算量と性能のパレートフロンティア
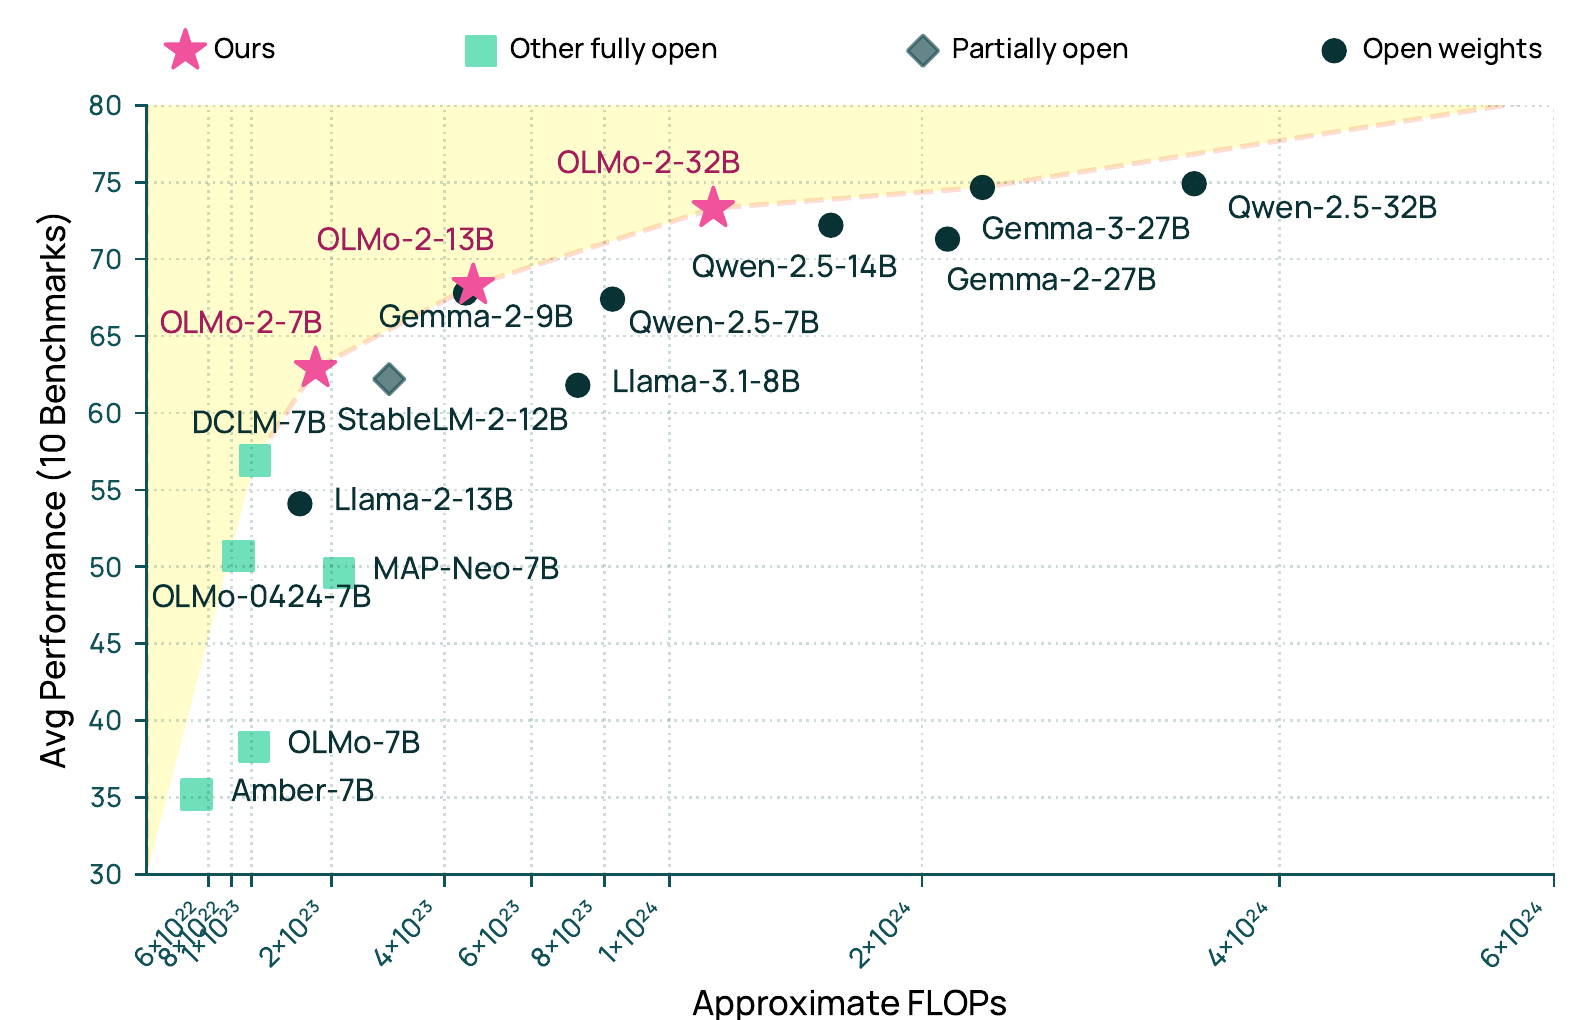
横軸は事前訓練の計算量、縦軸はベースモデルの 10 ベンチマーク平均だ。ピンクの星は左上の破線上にあり、同じ計算量なら OLMo 2 のほうが性能がよく、同じ性能なら使う計算量が少ないことを表す。たとえば OLMo 2 13B と Gemma 2 9B はスコアが近く、Qwen 2.5 7B はより多くの計算を使って、ほぼ同じ位置にたどり着いている。
緑の四角は他の完全オープンなモデルで、ほとんどが左下にあり、OLMo 2 はそれらから大きく引き離している。
後訓練版の比較は、報告の Table 7 の平均スコアから取った。
| モデル | 平均 | 事前訓練 FLOPs() |
|---|---|---|
| OLMo 2 7B Instruct | 56.5 | 1.8 |
| Llama 3.1 8B Instruct | 59.1 | 7.2 |
| Qwen 2.5 7B Instruct | 61.6 | 8.2 |
| OLMo 2 13B Instruct | 63.5 | 4.6 |
| OLMo 2 32B Instruct | 68.8 | 13.0 |
| Qwen 2.5 32B Instruct | 68.1 | 35.0 |
| GPT-4o mini | 65.7 | — |
7B は依然として Llama 3.1 8B と Qwen 2.5 7B に遅れるが、事前訓練の計算量はそれらの四分の一ほどしかない。32B は Qwen 2.5 32B の四割に満たない計算量で、わずかに高い平均スコアを得ており、GPT-4o mini も上回る。
この報告を読むときの注意点
- 安定性の証拠の多くは単一の設定での訓練曲線の比較で、七つの変更はまとめて投入されており、個々の寄与には部分的なアブレーションしかない。
- GSM8K の扱い。著者らは事前訓練後の数学能力がとても低いと気づいたとき、GSM8K の 1,319 問から 200 問を抜き出して中間訓練の開発セットにした。そのため GSM8K は完全には未見の評価ではない。報告の最終成績は残りの 1,119 問だけを使っており、著者らは脚注でこの点を明記している。
- モデルスープの証拠は 7B での 50B token の中間訓練から来ており、13B と 32B の四モデルの組合せについては「実験的によりよい」と言うだけで、完全な表はない。
結論
OLMo 2 は、地に足のついた工学の報告だ。新しいアーキテクチャはなく、安定性、データ配合、評価方法を一つずつ固め、完全オープンなモデルを初めて計算効率のフロンティアに立たせた。
モデルマージにとっては、きれいな成功例を提供している。同じ出発点、同じデータ、異なるデータ順序でアニーリングし、終わってから平均すれば、最良の一つより悪くなることはほとんどない。
手元に計算資源の余裕があるなら、一つのデータ順序に賭ける必要はない。中間訓練をあと二回走らせて平均するほうが、最良の一回を選び出すより割に合う。