原論文
DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2606.19348
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{deepseekdeepseekv42026,
  title = {{DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence}},
  author = {DeepSeek-AI and Anyi Xu and Bangcai Lin and Bing Xue and Bingxuan Wang and Bingzheng Xu and Bochao Wu and Bowei Zhang and Chaofan Lin and Chen Dong and Chenchen Ling and Chengda Lu and Chenggang Zhao and Chengqi Deng and Chengyu Hou and Chenhao Xu and Chenze Shao and Chong Ruan and Conner Sun and Damai Dai and Daya Guo and Dejian Yang and Deli Chen and Donghao Li and Dongjie Ji and Erhang Li and Fang Wei and Fangyun Lin and Fangzhou Yuan and Feiyu Xia and Fucong Dai and Guangbo Hao and Guanting Chen and Guoai Cao and Guolai Meng and Guowei Li and Han Yu and Han Zhang and Hanwei Xu and Hao Li and Haofen Liang and Haoling Zhang and Haoming Luo and Haoran Wei and Haotian Yuan and Haowei Zhang and Haowen Luo and Haoyu Chen and Haozhe Ji and Hengqing Zhang and Honghui Ding and Hongxuan Tang and Huanqi Cao and Huazuo Gao and Hui Qu and Hui Zeng and J Yang and JQ Zhu and Jia Luo and Jia Song and Jia Yu and Jialiang Huang and Jialu Cai and Jian Liang and Jiangting Zhou and Jiasheng Ye and Jiashi Li and Jiaxin Xu and Jiewen Hu and Jieyu Yang and Jin Chen and Jin Yan and Jingchang Chen and Jingli Zhou and Jingting Xiang and Jingyang Yuan and Jingyuan Cheng and Jingzi Zhou and Jinhua Zhu and Jiping Yu and Joseph Sun and Jun Ran and Junguang Jiang and Junjie Qiu and Junlong Li and Junmin Zheng and Junxiao Song and Kai Dong and Kaige Gao and Kang Guan and Kexing Zhou and Kezhao Huang and Kuai Yu and Lean Wang and Lecong Zhang and Lei Wang and Leyi Xia and Li Zhang and Liang Zhao and Lihua Guo and Lingxiao Luo and Linwang Ma and Linyan Zhu and Litong Wang and Liyu Cai and Liyue Zhang and Longhao Chen and MS Di and MY Xu and Max Mei and Miaojun Wang and Mingchuan Zhang and Minghua Zhang and Minghui Tang and Mingming Li and Mingxu Zhou and Minmin Han and Ning Wang and Panpan Huang and Panpan Wang and Peixin Cong and Peiyi Wang and Peng Zhang and Qiancheng Wang and Qihao Zhu and Qingyang Li and Qinyu Chen and Qiushi Du and Qiwei Jiang and Rui Tian and Ruifan Xu and Ruijie Lu and Ruiling Xu and Ruiqi Ge and Ruisong Zhang and Ruizhe Pan and Runji Wang and Runqian Chen and Runqiu Yin and Runxin Xu and Ruomeng Shen and Ruoyu Zhang and Ruyi Chen and SH Liu and Shanghao Lu and Shangmian Sun and Shangyan Zhou and Shanhuang Chen and Shaofei Cai and Shaoheng Nie and Shaoqing Wu and Shaoyuan Chen and Shengding Hu and Shengyu Liu and Shiqiang Hu and Shirong Ma and Shiyu Wang and Shuiping Yu and Shunfeng Zhou and Shuting Pan and Shuying Yu and Songyang Zhou and Tao Ni and Tao Yun and Tian Jin and Tian Pei and Tian Ye and Tianle Lin and Tianran Ji and Tianyi Cui and Tianyuan Yue and Tingting Yu and Tun Wang and W Zhang and WL Xiao and Wangding Zeng and Wei An and Weilin Zhao and Wen Liu and Wenfeng Liang and Wenjie Pang and Wenjing Luo and Wenjing Yao and Wenjun Gao and Wenkai Yang and Wenlve Huang and Wenqing Hou and Wentao Zhang and Wenting Ma and Xi Gao and Xiang He and Xiangwen Wang and Xianzu Wang and Xiao Bi and Xiaodong Liu and Xiaohan Wang and Xiaokang Chen and Xiaokang Zhang and Xiaotao Nie and Xiaowen Sun and Xiaoxiang Wang and Xin Cheng and Xin Liu and Xin Xie and Xingchao Liu and Xingchen Liu and Xingkai Yu and Xingyou Li and Xinyu Yang and Xinyu Zhang and Xu Chen and Xuanyu Wang and Xuecheng Su and Xueyin Chen and Xuheng Lin and Xuwei Fu and YC Yan and YQ Wang and YW Ma and Yanfeng Luo and Yang Zhang and Yanhong Xu and Yanru Ma and Yanwen Huang and Yao Li and Yao Li and Yao Xu and Yao Zhao and Yaofeng Sun and Yaohui Wang and Yi Qian and Yi Shao and Yi Yu and Yichao Zhang and Yifan Ding and Yifan Shi and Yijia Wu and Yiliang Xiong and Yiling Ma and Ying He and Ying Tang and Ying Zhou and Yingjia Luo and Yinmin Zhong and Yishi Piao and Yisong Wang and Yixiang Zhang and Yixiao Chen and Yixuan Tan and Yixuan Wei and Yiyang Ma and Yiyuan Liu and Yonglun Yang and Yongqiang Guo and Yongtong Wu and Yu Wu and YuKun Li and Yuan Cheng and Yuan Ou and Yuanfan Xu and Yuanhao Li and Yuduan Wang and Yuehan Yang and Yuer Xu and Yuhan Wu and Yuhao Meng and Yuheng Zou and Yukun Zha and Yunfan Xiong and Yupeng Chen and Yuping Lin and Yuqian Cao and Yuqian Wang and Yushun Zhang and Yuting Yan and Yutong Lin and Yuxian Gu and Yuxiang Luo and Yuxiang You and Yuxuan Liu and Yuxuan Zhou and Yuyang Zhou and Yuzhen Huang and ZF Wu and Zehao Wang and Zehua Zhao and Zehui Ren and Zekai Zhang and Zhangli Sha and Zhe Fu and Zhe Ju and Zhean Xu and Zhenda Xie and Zhengyan Zhang and Zheren Gao and Zhewen Hao and Zhibin Gou and Zhicheng Ma and Zhigang Yan and Zhihong Shao and Zhixian Huang and Zhixuan Chen and Zhiyu Wu and Zhizhou Ren and Zhongyu Wu and Zhuoshu Li and Zhuping Zhang and Zian Xu and Zihao Wang and Zihua Qu and Zihui Gu and Zijia Zhu and Zilin Li and Zipeng Zhang and Ziwei Xie and Ziyi Gao and Ziyi Wan and Zizheng Pan and Zongqing Yao},
  year = {2026},
  eprint = {2606.19348},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2606.19348}
}
DeepSeek-V3 から DeepSeek-R1 まで、このシリーズはずっと同じことをしてきた。より少ない計算で、より強いモデルを作ることだ。
推論モデルが登場してから、この取り組みには新しい難題が加わった。モデルはまず長い思考を書いてから答え、エージェントタスクではさらに、とても長いツール呼び出しの記録の中を行き来しながら作業しなければならず、コンテキストはしばしば数十万 token に達する。標準の注意は計算量が長さの二乗で増え、KV キャッシュも長さに比例して大きくなる。コンテキストが長くなると、推論コストは注意にすっかり食われてしまう。
DeepSeek-V4 は、この問題への答えだ。報告で公開されたのはプレビュー版で、モデルは二つある。DeepSeek-V4-Pro は総パラメータ 1.6T、token あたりの活性化パラメータ 49B。DeepSeek-V4-Flash は総パラメータ 284B、活性化パラメータ 13B。どちらも 100 万 token のコンテキストにネイティブ対応し、重みもどちらも公開されている。
報告にはアーキテクチャ上の新しい要素が三つある。二種類の圧縮注意を組み合わせた CSA と HCA、従来の残差接続に代わる mHC、そして Muon オプティマイザだ。後訓練では、モデルマージにとって重要な変更が一つある。DeepSeek は専門モデルの能力を、重みのマージや混合強化学習で統合するのをやめ、複数教師の on-policy 蒸留を使うようになった。
問題の定義
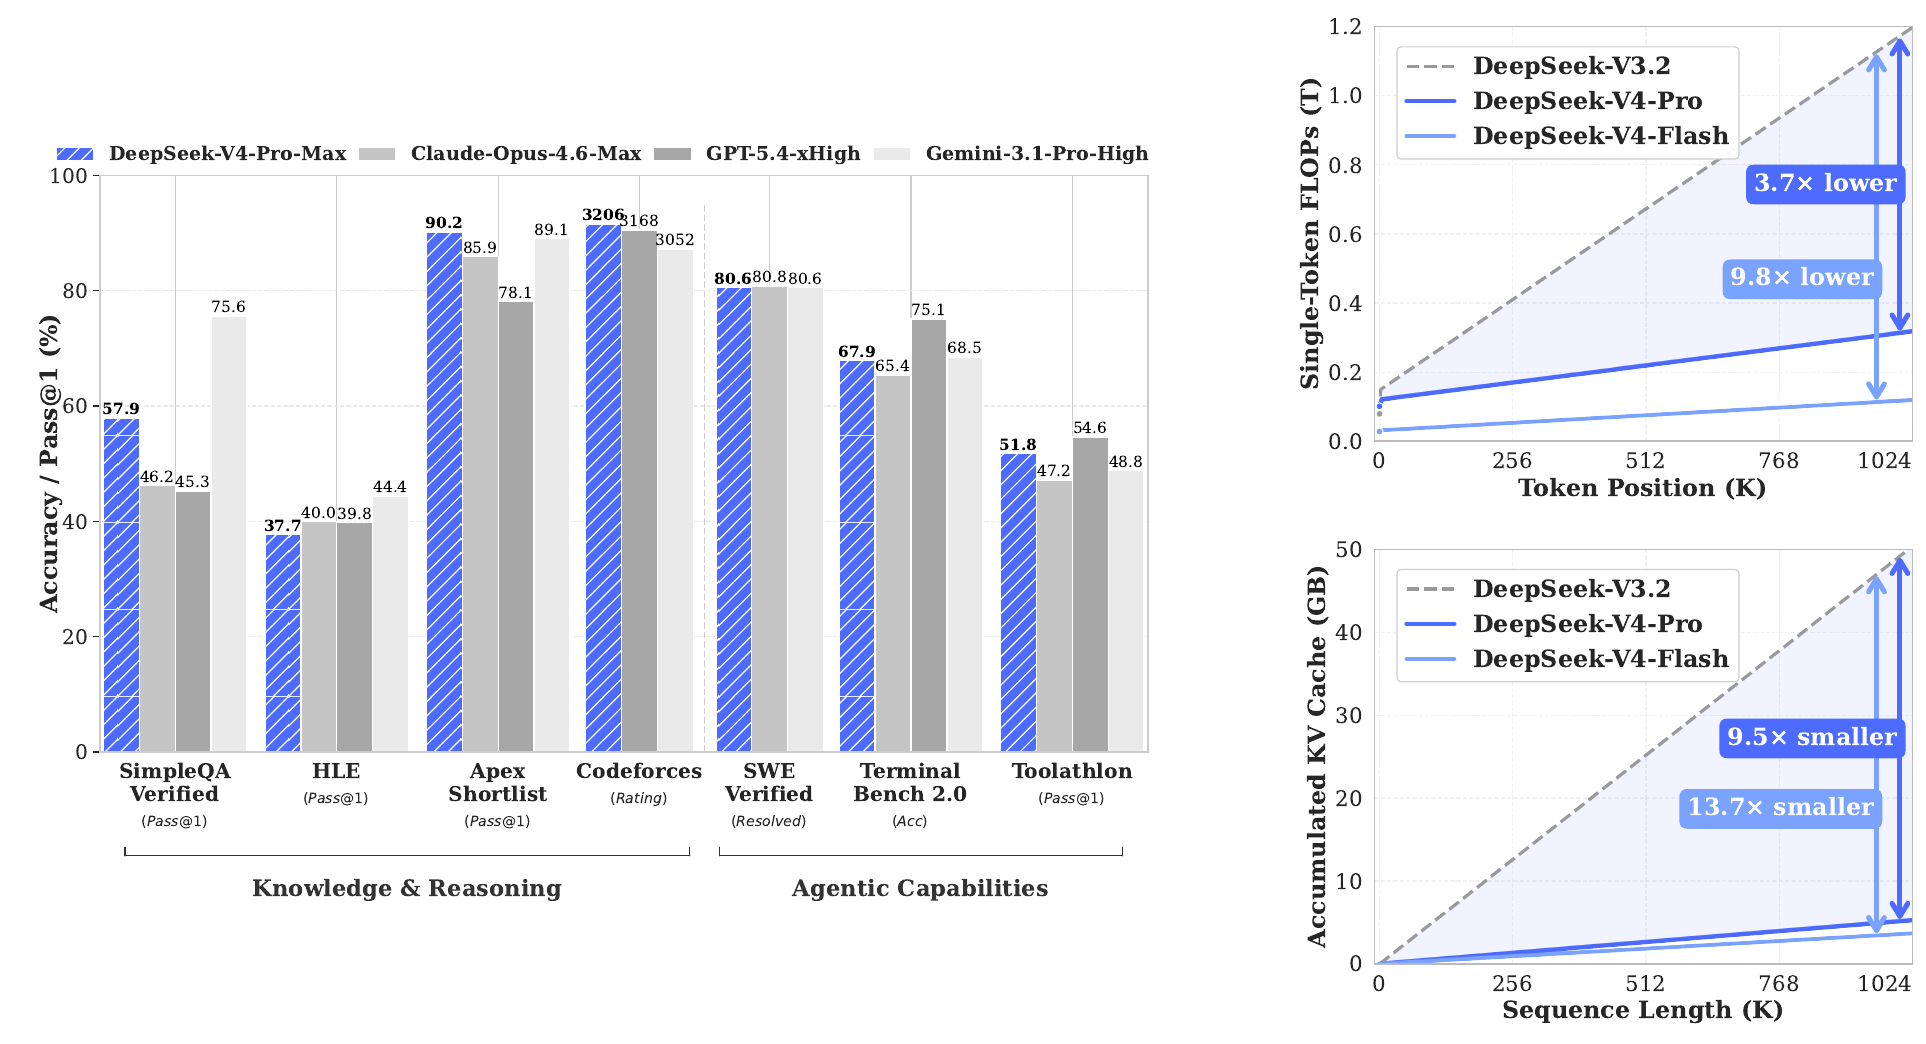
まず右の二枚を見よう。これが報告全体の目標だ。
右上図は token を一つ生成するのにかかる計算量で、横軸はその token のコンテキスト内での位置だ。前世代の DeepSeek-V3.2 の破線はほぼ一直線に上がっていき、位置が後ろになるほど token 一つが高くつく。100 万 token の地点では、V4-Pro は V3.2 の 27%、V4-Flash は 10% で済む。
右下図は KV キャッシュだ。同じく 100 万 token で、V4-Pro は V3.2 の 10%、V4-Flash は 7% で済む。
V3.2 はすでにスパース注意を使っており、もともと無駄の多い比較対象ではない。しかも V4-Pro の token あたりの活性化パラメータは V3.2 より多い。したがってこの二枚の図の差は、主に注意の再設計から来ている。
左は、最強設定の DeepSeek-V4-Pro-Max と三つのクローズドモデルの比較で、後の議論で戻ってくる。
問題を解く
全体のアーキテクチャ
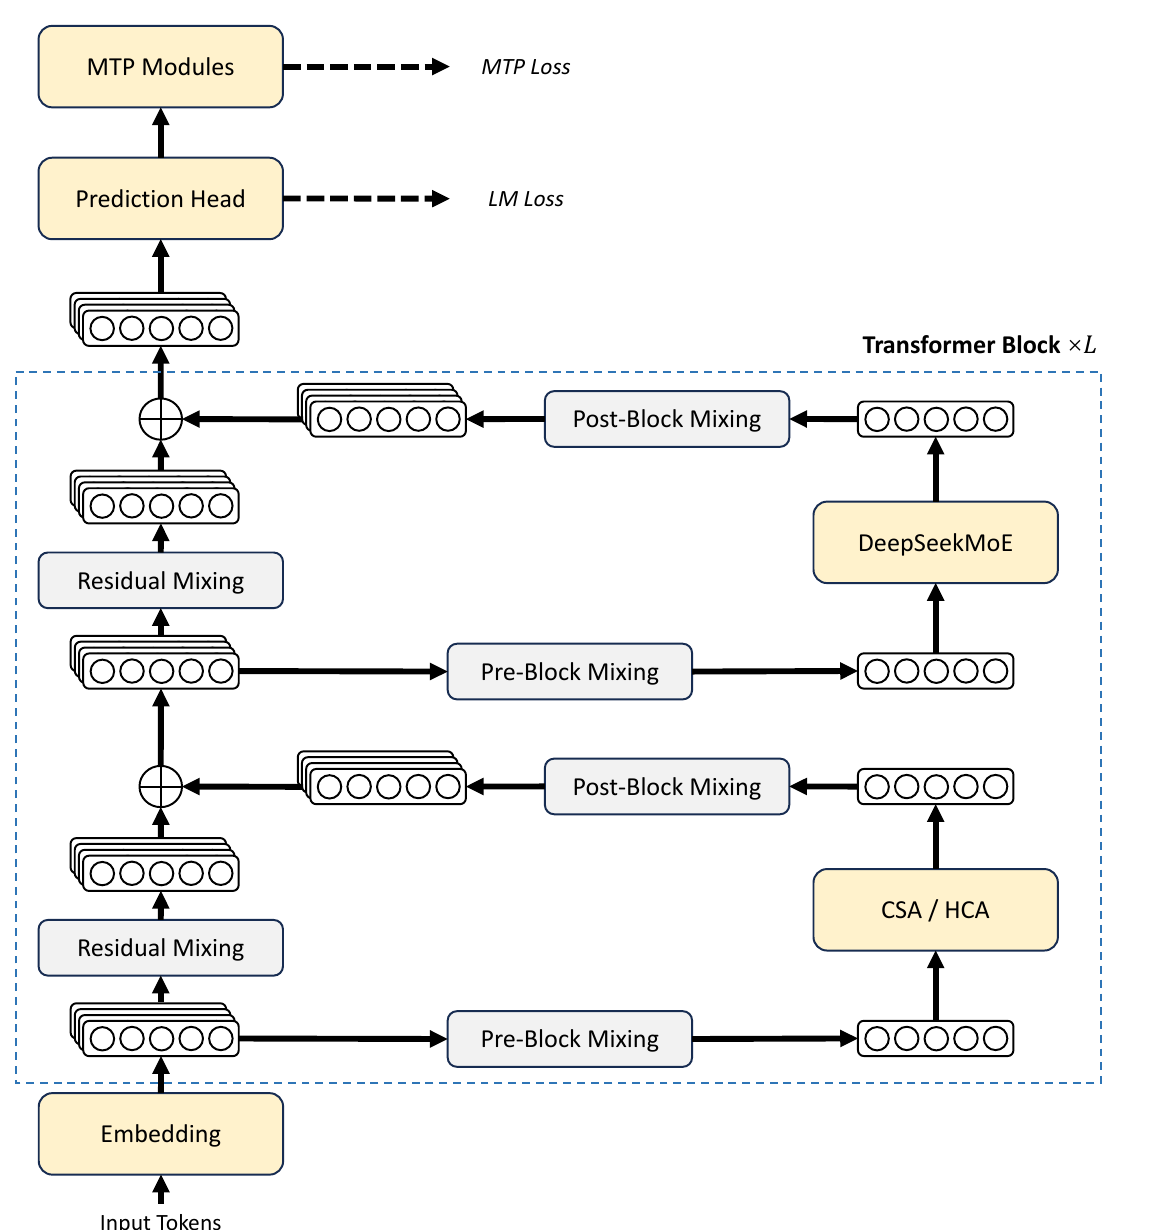
大部分は DeepSeek-V3 を引き継いでいる。フィードフォワード層は DeepSeekMoE で、共有専門家と細粒度のルーティング専門家を持ち、負荷分散には補助損失を使わないバイアス調整を使い、多 token 予測(MTP)も残している。小さな変更は二つある。ルーティングの親和度を計算する関数を Sigmoid から に変えたこと。そして最初の数層は、もともと密なフィードフォワード層だったところを MoE に変え、ただしハッシュルーティングを使って、token ID からどの専門家に送るかを直接決めるようにしたことだ。
図で最も目立つのは、残差ストリームが四つ重なったベクトルとして描かれていることで、これが mHC だ。
mHC:残差ストリームを広げ、さらに制約をかける
通常の残差接続は で、残差ストリームは一本だけ、幅は隠れ次元 に等しい。
Hyper-Connections(HC)は残差ストリームを 本に広げ、状態を にして、三つの小さな行列で読み書きの仕方を決める。
は 本の残差を一本に混ぜ、この層の入力にする。 はこの層の出力を各残差に配り戻す。 は各残差を互いに混ぜ合わせる。層自体の入出力は依然として 次元なので内部の設計は変えなくてよく、 は よりずっと小さいので、追加の計算はわずかだ。
HC の問題は、多くの層を積み重ねると数値が不安定になりやすいことだ。理由は想像に難くない。層ごとに を一つ掛けるので、そのスペクトルノルムが 1 より大きければ、数十層掛け合わせるうちに信号が爆発する。
mHC(Manifold-Constrained HC)は を二重確率行列に制限する。すべての要素が非負で、各行と各列の和がいずれも 1 になる行列だ。二重確率行列のスペクトルノルムはちょうど 1 なので、信号を増幅しない。二つの二重確率行列の積も二重確率行列なので、何層重ねても同じだ。 と は Sigmoid で非負かつ有界に制限し、信号同士が打ち消し合うのを避ける。
任意の行列を二重確率行列に射影するには、Sinkhorn-Knopp アルゴリズムを使う。まず指数を取ってすべての要素を正にし、それから列の正規化と行の正規化を繰り返す。V4 は 20 回反復する。 で一度試してみよう。
import numpy as np

rng = np.random.default_rng(0)
B_raw = rng.normal(scale=2.0, size=(4, 4))          # 制約をかけていない残差混合行列(n_hc = 4)
print("制約前のスペクトルノルム:", round(np.linalg.norm(B_raw, 2), 3))

M = np.exp(B_raw)                                     # まず指数を取り、すべての要素を正にする
for _ in range(20):                                   # t_max = 20
    M = M / M.sum(axis=0, keepdims=True)              # 各列の和を 1 にする
    M = M / M.sum(axis=1, keepdims=True)              # 各行の和を 1 にする

print("行和:", np.round(M.sum(axis=1), 4))
print("列和:", np.round(M.sum(axis=0), 4))
print("制約後のスペクトルノルム:", round(np.linalg.norm(M, 2), 4))

x = rng.normal(size=4)
y = x.copy()
for _ in range(60):                                   # 同じ残差混合を 60 層分掛け合わせる
    y = M @ y
print("入力のノルム:", round(np.linalg.norm(x), 3), " 60 層通過後:", round(np.linalg.norm(y), 3))
制約前のスペクトルノルム: 6.07
行和: [1. 1. 1. 1.]
列和: [1. 1. 1. 1.]
制約後のスペクトルノルム: 1.0
入力のノルム: 1.286  60 層通過後: 0.297
制約前の行列のスペクトルノルムは 6.07 で、60 層掛け合わせれば天文学的な数字になる。射影した後は 1.0 で、60 層掛け合わせても信号は収束するだけで、爆発しない。この例では効果を際立たせるため、60 層すべてに同じ行列を使った。実際のモデルでは層ごとに が違うが、どれも二重確率行列なので、結論は同じだ。
実際の 、、 は、入力に応じて動的に生成される。やり方は、 を平坦化して RMSNorm をかけ、小さな線形層に通し、静的なバイアスを加え、初期値の小さいゲート係数を掛けて、最後に上記の制約を適用する。V4 の二つのモデルはどちらも を使う。
CSA と HCA:二種類の圧縮注意
注意は長文脈のボトルネックだ。V4 は二種類の注意を設計し、交互に使う。
CSA(Compressed Sparse Attention) は、まず圧縮し、それからスパースに選ぶ。
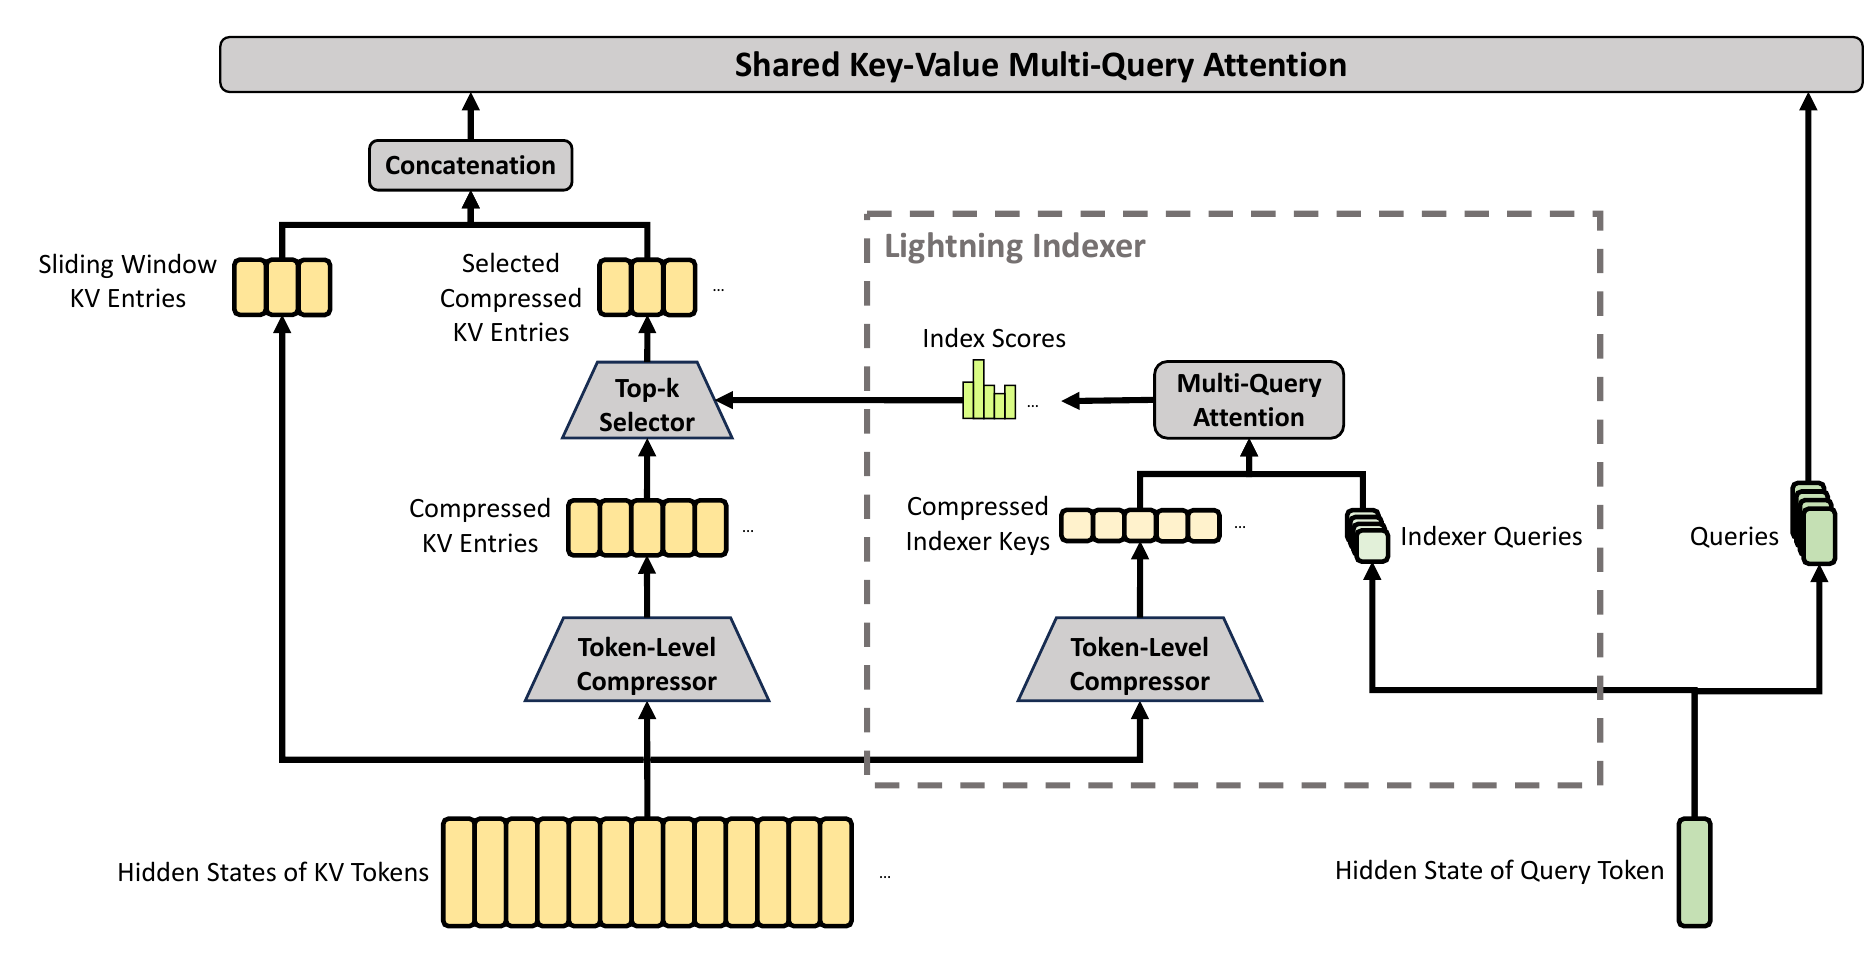
下から上へ見ていく。
第一段階は圧縮だ。 個の token ごとに、その KV を一つの項にまとめる。圧縮の重みは、学習可能な射影に位置バイアスを加えて softmax を通したもので決まり、この 個の token の加重平均に相当する。V4 は とする。
第二段階は選択だ。これは V3.2 から引き継いだ DeepSeek スパース注意(DSA)で、軽量な lightning indexer がすべての圧縮項を採点し、スコアが最も高い 個だけを選ぶ。V4-Pro は 、V4-Flash は 512。indexer 自体は FP4 精度で計算する。
第三段階は、近傍を補うことだ。圧縮項は「それより前のブロック全体」しか見られず、自分がいるブロック内の他の token は見えない。しかも言語モデルが最も必要とするのは、たいてい直近のコンテキストだ。そこで別にスライディングウィンドウの分岐を加え、直近 128 個の圧縮していない KV を残す。
最後に、各 KV 項は key と value を兼ね、すべてのクエリヘッドで共有される。多クエリ注意(MQA)の形だ。
HCA(Heavily Compressed Attention) はさらに強く圧縮し、 個の token ごとに一つの項にまとめるが、スパースな選択はせず、すべての圧縮項を見る。同じく 128 token のスライディングウィンドウも加える。
100 万 token で、各クエリがいくつの KV 項を見るのかを計算してみよう。
| 注意 | 圧縮後の KV 項数 | 各クエリが実際に見る項数 |
|---|---|---|
| 標準の注意 | 1,000,000 | 1,000,000 |
| CSA(、Pro の ) | 250,000 | |
| HCA() | 約 7,813 | 約 |
CSA はスパースな選択に頼り、各クエリは千項あまりしか見ないが、25 万の圧縮項の中から厳選できる。HCA は選ばないが、各項が 128 token を代表しており、コンテキスト全体の大まかな輪郭を見る。両者を交互に使い、一方が精密な検索を、もう一方が全体の概観を受け持つ。
KV キャッシュのサイズは、圧縮後にいくつの項を保存するかで決まる。報告によれば、一般的な BF16、8 グループの GQA、ヘッド次元 128 を基準とすると、V4 の 100 万 token での KV キャッシュはその 2% 程度しかない。これには他の節約策も加わっており、たとえば KV 項のうち RoPE の次元は BF16、その他の次元は FP8 にして、ほぼ半分を節約している。
報告は、この設計を訓練できるようにするための細部もいくつか挙げている。クエリと KV 項にはそれぞれ注意の前に RMSNorm をかけ、注意の logit の爆発を防ぐ。RoPE は最後の 64 次元にだけ使う。注意に学習可能な sink logit を加え、一つのヘッドの注意の合計が 1 未満になれるようにする。
Muon オプティマイザ
V4 はパラメータの大部分に Muon オプティマイザを使い、埋め込み層、予測ヘッド、RMSNorm の重み、mHC の静的バイアスには引き続き AdamW を使う。
Muon の核心は、モーメンタム行列を「直交化」し、更新のすべての特異値を 1 に近づけることだ。厳密にやるには特異値分解が必要で、コストが高すぎるので、Newton-Schulz 反復で近似する。
V4 のやり方は「ハイブリッド」の 10 回反復だ。最初の 8 回は を使って特異値を素早く 1 付近へ押し上げ、最後の 2 回は に切り替えて特異値を 1 に落ち着かせる。
注意のアーキテクチャ自体がすでにクエリと KV に RMSNorm をかけているので、注意の logit は爆発せず、V4 は他の Muon 実装で logit を抑えるために使われる QK-Clip も必要としない。
事前訓練
構成
| V4-Flash | V4-Pro | |
|---|---|---|
| 層数 / 隠れ次元 | 43 / 4,096 | 61 / 7,168 |
| ルーティング専門家(token あたりの活性化数) | 256(6) | 384(6) |
| CSA の選択数 | 512 | 1,024 |
| 総パラメータ / 活性化パラメータ | 284B / 13B | 1.6T / 49B |
| 訓練 token | 32T | 33T |
両者とも CSA の圧縮率は 4、HCA は 128 で、最初の 3 つの MoE 層はハッシュルーティングを使う。V4-Flash は最初の二層でスライディングウィンドウ注意だけを使い、V4-Pro は最初の二層で HCA を使い、その後は CSA と HCA が交互に並ぶ。
訓練は系列長 4K から始め、16K、64K、1M へと段階的に伸ばす。スパース注意は最初からは使わない。V4-Flash は最初の 1T token をまず密な注意でウォームアップし(V4-Pro の密な段階はもっと長い)、64K の長さになって初めてスパース注意を加え、その際まず lightning indexer を短くウォームアップする。学習率はほとんどの期間一定に保ち、最後に cosine で十分の一まで減衰させる。
後訓練の段階では、ルーティング専門家の重みと indexer の QK 経路に FP4 の量子化を考慮した訓練も行い、メモリと計算をさらに節約する。
損失スパイクへの対処
兆規模のパラメータを持つ MoE を訓練すると、損失スパイクはなかなか避けられない。著者らは、スパイクが常に MoE 層の外れ値と関係しており、しかもルーティングの仕組み自体が外れ値を増幅して悪循環を生むらしいことに気づいた。単純なロールバックでは一時しのぎにしかならず、スパイクはまた起こる。
有効な方法を二つ見つけたが、その原理はまだわからない、と彼らは率直に述べている。
- 予測ルーティング(Anticipatory Routing):第 ステップでは、現在のパラメータ で特徴を計算するが、ルーティングの決定は少し古いパラメータ で計算し、バックボーンとルーターが同期して更新されることによる悪循環を断ち切る。時間が約 20% 増えるので普段はオフにしておき、システムがスパイクを検出すると、自動で短くロールバックしてこのモードをしばらくオンにし、その後またオフにする。
- SwiGLU のクリッピング:SwiGLU の線形分岐を に制限し、ゲート分岐の上限を 10 にして、外れ値を直接抑え込む。
著者らによれば、この二つの手は V4-Flash と V4-Pro のどちらの訓練でも有効で、しかも性能に影響しない。
ベースモデルの比較
著者らは V3.2、V4-Flash、V4-Pro の三つのベースモデルを比較した。中でも V4-Flash が最も面白い。活性化パラメータも総パラメータも V3.2 より少ないのに、多くのベンチマークで V3.2 を上回り、特に知識系と長文脈のタスクで差をつけている。
後訓練:重みのマージから蒸留へ
まず専門モデル群を訓練する
後訓練の第一段階は V3.2 と似ている。領域ごとに、まず SFT を行い、次に GRPO で強化学習を行って、専門モデル群を訓練する。
推論の強度も専門モデルで実現する。V4 には三つの推論モードがある。思考なし、Think High、Think Max だ。各モードは異なる長さペナルティとコンテキスト長で訓練し、Think Max ではさらにシステムプロンプトの冒頭に指示を注入して、モデルに「最大限の努力をし、近道をしてはならない」と求め、思考過程をすべて書き出させる。
検証しにくいタスクについては、V4 はスコアを出力する報酬モデルをもう訓練せず、評価基準と生成型報酬モデル(GRM)を組み合わせる。しかも方策モデル自身に GRM を兼ねさせ、評価する能力と生成する能力を一緒に強化学習で最適化する。
マージの代わりに蒸留
次の一歩こそ、このノートが強調したいところだ。
十数個の専門モデルがあるとき、その能力をどうやって一つのモデルに統合するか。Command A は重みの線形マージを使い、V3.2 は混合強化学習を使った。V4 はどちらも使わず、複数教師の on-policy 蒸留(OPD)に切り替えた。
は訓練する生徒、 は 番目の専門モデル、 はその重みだ。「on-policy」とは、訓練データを生徒自身が生成し、生徒が書いた各 token に対して、各専門モデルが自分の確率分布を与えることを指す。KL は逆向きの で、生徒は数学の問題では自然と数学の専門モデルに寄り、コードの問題ではコードの専門モデルに寄る。
著者らは、こうする理由をはっきり書いている。知識を logit のレベルでそろえることで、従来の重みマージや混合強化学習でよく起きる性能低下を実際に避けられるのだという。この段階では十数個の教師モデルを使い、一つの生徒へ蒸留した。
細部を見ると、一般的な OPD の実装は語彙全体の KL を、各位置でサンプリングされた token 一つだけを見るものに簡略化し、それを強化学習のアドバンテージとして使う。資源はとても節約できるが、勾配の分散が大きく、訓練が不安定になる。V4 は語彙全体の logit による蒸留にこだわり、そのために十数個の教師が同時に完全な logit を提供するスケジューリングの問題まで解かなければならなかった。
Model Soups から Command A まで、モデルマージの論拠は一貫して「安さ」だった。データも訓練も要らず、平均すれば済む。V4 の選択は、データと計算資源があり、統合すべき専門モデルが十数個にもなり、能力の差も大きいなら、蒸留のコストを一度払ってマージの損失を取り除くほうが、DeepSeek にとっては見合うことを示している。
推論時のコンテキスト管理
100 万 token のコンテキストは、推論内容の残し方も変えた。V3.2 はツール呼び出しの間は思考内容を保持するが、ユーザーが新しいメッセージを送ると、それまでの思考をすべて捨てる。V4 はツール呼び出しのある場面では、会話全体の思考内容をすべて保持し、ユーザーのメッセージをまたいでも同じだ。一般的なチャットの場面では、従来のやり方を維持する。ツール呼び出しの書式も XML 風に変え、著者らによれば、エスケープ文字のミスやツール呼び出しの失敗が減る。
議論
成績
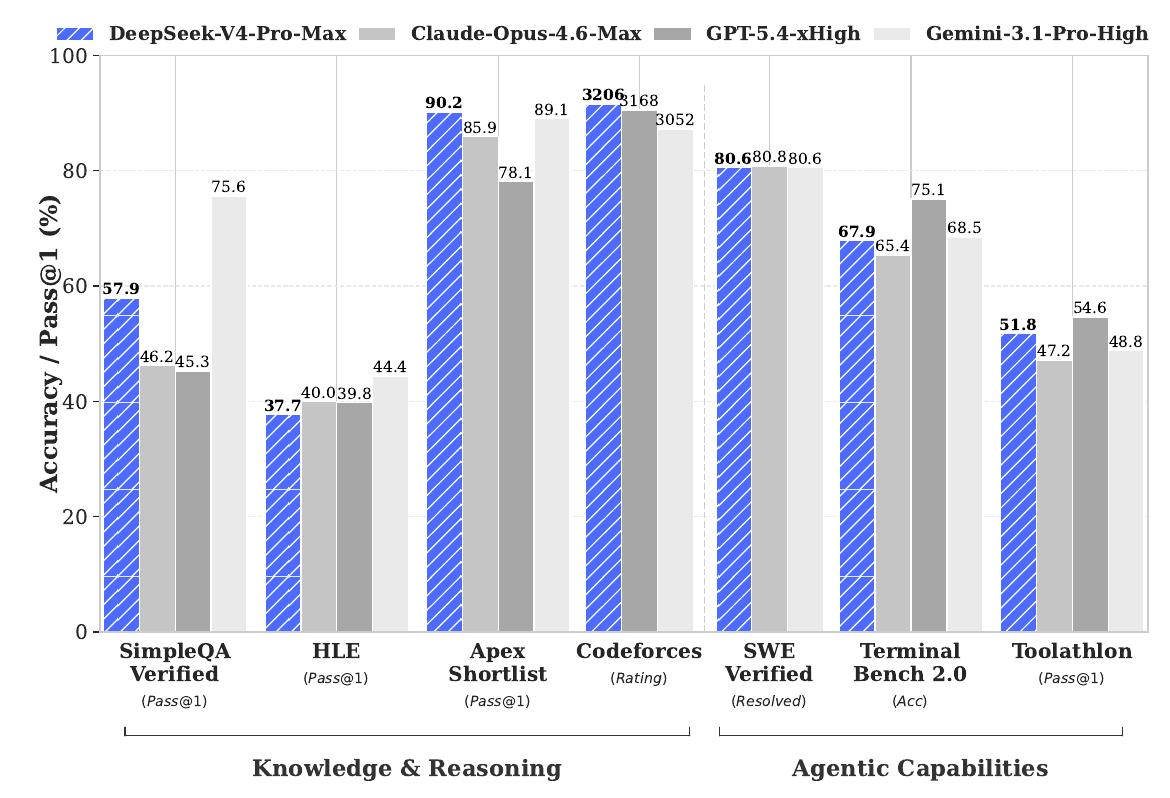
斜線の棒が V4-Pro-Max で、他の三つはクローズドモデルの最も強い推論設定だ。
知識系では、V4-Pro-Max は SimpleQA Verified で 57.9 を取り、Claude-Opus-4.6-Max の 46.2、GPT-5.4-xHigh の 45.3 より高いが、Gemini-3.1-Pro-High の 75.6 よりは明らかに低い。HLE は 37.7 で、他の三つ(40.0、39.8、44.4)よりやや低い。エージェントタスクでは、SWE Verified の 80.6 は他のモデルとほぼ同じで、Terminal Bench 2.0 は 67.9 と、GPT-5.4-xHigh の 75.1 に遅れる。
これは著者ら自身のまとめと一致する。オープンモデルの中で最良の成績であり、推論は最前線のクローズドモデルに迫り、エージェントタスクはトップクラスのオープンモデルと同等で、最前線のクローズドモデルにはやや劣る。
V4-Flash-Max は、パラメータが少ないぶん知識系の性能は劣るが、より多くの思考予算を与えれば、推論タスクで V4-Pro と同等になる。
著者ら自身が認める限界
結論にはとても率直な一節がある。長文脈の効率を極限まで追求するため、V4 のアーキテクチャはかなり大胆なものになった。一方でリスクを下げるため、以前に検証済みの部品や小技を数多く残し、その結果アーキテクチャ全体がかなり複雑になった。次はより包括的で原理に基づいた研究を行い、アーキテクチャを最も本質的な設計まで削ぎ落とす、と著者らは述べている。予測ルーティングと SwiGLU のクリッピングは有効だが、その原理はまだわかっていない。
また、報告名には「プレビュー版」と明記されており、比較の多くは著者ら自身の評価フレームワークで行われ、一部のエージェントタスクの比較は内部評価によるものだ。
結論
DeepSeek-V4 は、二種類の圧縮注意で 100 万 token のコンテキストを手の届くものにした。CSA は 4 倍に圧縮してから千項あまりを厳選し、HCA は 128 倍に圧縮して全体の輪郭を見る。mHC は残差ストリームを広げて二重確率行列で安定性を固め、Muon は収束を速める。その結果、100 万 token で V4-Pro の token あたりの計算量は前世代の四分の一ほど、KV キャッシュは十分の一ほどになった。
モデルマージの流れから見ると、この報告は面白い反例になる。同じく専門モデル群を一つのモデルに統合するのに、Command A は重みの平均を選び、DeepSeek は生徒に自分で書かせて、教師たちが token ごとに指導するやり方を選んだ。
マージの利点は安さ、蒸留の利点は正確さだ。DeepSeek の計算資源なら、明らかに後者が買える。