原論文
Essentially No Barriers in Neural Network Energy Landscape
- 発表先
- ICML 2018国際会議
- arXiv への初回投稿
- arXiv:1803.00885
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingnobarriers2018,
  title = {{Essentially No Barriers in Neural Network Energy Landscape}},
  author = {Felix Draxler and Kambis Veschgini and Manfred Salmhofer and Fred A. Hamprecht},
  year = {2018},
  eprint = {1803.00885},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1803.00885}
}
ニューラルネットワークの損失地形といえば、よく描かれるのは山と谷が連なる風景だ。
訓練とは、どこかから山を転がり落ちて、最後にどこかの谷底で止まることだ。谷底には広いものも狭いものもあり、広い谷底のほうが汎化しやすいとされる。異なる乱数シードは異なる谷底へ転がり込み、谷と谷の間は尾根で隔てられている。二つの谷底の重みを直線で結ぶと、途中の損失はいったん上がってから下がる。これも多くの人が実際に測ってきた結果だ。
ハイデルベルク大学の Draxler、Veschgini、Salmhofer、Hamprecht は、この描像に異なる見方を示した。著者らは画像処理の研究室と理論物理学研究所にまたがり、分子の統計力学から反応経路を探す道具を借りて、二つの谷底の間に山を越えずに回り込める道があるかを調べた。
答えは意外なものだった。CIFAR 上の ResNet と DenseNet で、見つかった道はほぼ平らだったのだ。
ほぼ同時期に、Garipov らのモード連結性も独立に同じ観察を得ている。二つの論文の経路の探し方はまったく異なる。
問題の定義
アーキテクチャと訓練データを固定すれば、損失はパラメータ だけの関数 になる。それぞれ収束まで訓練した二組のパラメータ 、 を取り、 から への連続な経路のうち、途中の最大の損失ができるだけ低いものを探したい。
この経路を最小エネルギー経路(minimum energy path、MEP)と呼び、経路上の最高点が二つの極小値の間の本当の鞍点になる。
著者らは「損失」と「エネルギー」を同義語として使う。物理学の習慣だ。損失地形の谷底は安定な状態で、鞍点は二つの状態の間で越えなければならない障壁である。
二次元なら格子を描いて、動的計画法で MEP を探せる。しかしネットワークのパラメータはゆうに数百万次元あり、初期経路から出発して、局所的な情報で少しずつ低いほうへ曲げていくしかない。見つかる経路が正確な MEP とは限らず、その最高点は鞍点のエネルギーの上界としてしか扱えない。
したがって、最高点の低い道を一本でも見つければ、二つの極小値の間の障壁はその値を超えないと証明できる。これがこの論文の論理だ。
問題を解く
ばねでつないだピボット
まず経路を離散化する。 個のピボット(pivot) を鎖状につなぎ、両端を二つの極小値 、 に固定する。
最も直感的なのは、ピボット同士をばねでつなぎ、次を最小化する方法だ。
第一項は各点を低いほうへ引き、第二項は点と点の間隔を保つ。
問題はばね定数 だ。 が小さすぎると、ピボットは低いほうへ滑り落ち、損失の高い領域ではかえって点がまばらになる。よりによって一番正確に測りたいのは最高点なのに。 が大きすぎると、ばねのエネルギーは経路の全長の二乗で増えるため、鎖全体がまっすぐに引っ張られ、角を切り取って本当の鞍点を見逃す。
Nudged Elastic Band
NEB(Nudged Elastic Band)は、簡単な修正でこのジレンマを解く。二種類の力を分け、それぞれ役に立つ方向だけを残す。
ピボット の局所的な接線方向を とすると、
損失による力は経路に垂直な成分だけを残し、経路を低いほうへ押す役目を担う。ばねの力は経路に平行な成分だけを残し、点を均等に並べる役目を担う。こうすれば、高い所の点が経路に沿って滑り落ちることも、ばねが経路をまっすぐにしてしまうこともない。
接線方向の取り方にも工夫がある。 は二つの隣接点のうち損失が高いほうを向く。こうすると経路に折れ角ができにくく、鞍点付近の近似もよくなる。
著者らは実装でさらに一歩進めた。異なる損失地形やピボット数のどれでも使える が見つからなかったため、ばねの力をいっそゼロにし、毎回まずピボットを経路に沿って等間隔に並べ直してから、垂直方向の損失の力をかける形に変えた。この変種は文献では string method とも呼ばれる。
二次元の小さな例でたどる
ニューラルネットワークはパラメータが多すぎて描けない。代わりに二次元の地形で、NEB が何をしているかを見てみよう。
第一項は単位円上の損失をゼロにし、第二項は円周に少し傾きを加えて、 と を二つの極小値にする。二点を結ぶ直線は原点を通り、そこでの損失は 1 だ。円周に沿って回り込めば、最高点はわずか約 0.1 になる。
import numpy as np

def loss(p):
    x, y = p[..., 0], p[..., 1]
    return (x**2 + y**2 - 1) ** 2 + 0.1 * y**2

def grad(p):
    x, y = p[..., 0], p[..., 1]
    r = x**2 + y**2 - 1
    return np.stack([4 * r * x, 4 * r * y + 0.2 * y], axis=-1)

def redistribute(path):
    seg = np.linalg.norm(np.diff(path, axis=0), axis=1)
    s = np.concatenate([[0], np.cumsum(seg)])
    t = np.linspace(0, s[-1], len(path))
    return np.stack([np.interp(t, s, path[:, d]) for d in range(2)], axis=1)

a, b = np.array([-1.0, 0.0]), np.array([1.0, 0.0])
path = np.linspace(a, b, 12)               # 出発点:直線上の 12 個のピボット
path[1:-1, 1] += 0.05                      # 少し押して、完全に対称な鞍点で止まらないようにする
line_max = loss(np.linspace(a, b, 201)).max()

for step in range(2000):
    path = redistribute(path)              # 著者らのやり方:ばねを外し、毎回等間隔に並べ直す
    for i in range(1, len(path) - 1):
        lo, hi = path[i - 1], path[i + 1]
        tau = (hi - path[i]) if loss(hi) > loss(lo) else (path[i] - lo)
        tau /= np.linalg.norm(tau)
        g = grad(path[i])
        f_perp = -(g - (g @ tau) * tau)    # 経路に垂直な損失の力だけを残す
        path[i] = path[i] + 0.05 * f_perp

fine = np.concatenate([np.linspace(p, q, 20, endpoint=False) for p, q in zip(path[:-1], path[1:])] + [path[-1:]])
print(f"直線上の最大損失:{line_max:.3f}")
print(f"NEB 経路の最大損失:{loss(fine).max():.3f}")
x, y = fine[loss(fine).argmax()] + 0.0
print(f"最高点の位置:({x:.2f}, {y:.2f})")
直線上の最大損失:1.000
NEB 経路の最大損失:0.098
最高点の位置:(-0.00, 0.96)
直線上の障壁は 1.0 だ。NEB は中間のピボットを円周の近くまで押し上げ、障壁は 0.098 まで下がる。この値がこの地形の鞍点のエネルギーだ。 に沿って の最小値を求めると、鞍点は 、 と計算できる。
接線の行は、損失の高い隣接点を向くという先ほどの規則を実装している。f_perp を完全な -g に置き換えると、中間の点は円周に沿って両端へ滑り、最後は二つの谷底の付近にすべて集まって、経路の最も高い所を測る点がなくなってしまう。
AutoNEB と最小全域木
数百万次元の空間では、最初はピボットが何個必要かわからない。AutoNEB は少数のピボットで NEB を数回回してから経路を調べる。隣り合う二つのピボットの間の損失が、両端からの線形補間による見積もりより「経路全体のエネルギー差」の 20% 以上高ければ、そこに新しいピボットを挿入する。こうして見落とされた山を見つけるため、隣接するピボットの各組の間で別に 9 点を評価する。
AutoNEB でも、局所的な最小エネルギー経路に捕まり、高めの鞍点を得ることがある。著者らはこれを一つの不等式で扱う。A から B、B から C への経路がわかっていれば、二つをつなげたものは A から C への一本の道になる。したがって
これは超距離(ultrametric)の性質だ。これがあれば、既知の経路ですべての極小値を一つのグラフにつなげさえすれば、どの極小値の組の間の障壁にも上界が得られる。ある経路が高すぎても、他の経路で迂回して置き換えられる。
そこで著者らは、問題を最小全域木の探索に変えた。まず最初の極小値を他のすべての極小値とつなぎ、次に木の中で最も高い辺を選んでは、AutoNEB でその両側の部分木の間により低い道を探す。見つかれば置き換え、見つからなければ元に戻す。これを全組を計算し終えるか、計算予算が尽きるまで繰り返す。AutoNEB の経路一本のコストは、ネットワークを一回最後まで訓練するのとほぼ同じだ。
議論
実験設定
各アーキテクチャで 10 個の極小値を訓練し、すべて異なるランダム初期化から得る。著者らは、それらが本当に異なることも確かめている。ResNet と DenseNet のどの二つの極小値でも、テスト集合で誤分類された標本の重なりは最大でも 70% だった。
アーキテクチャは三種類にわたる。
- スキップ接続のない基本的な CNN:幅 12~96 チャネルの単層 CNN と、48 チャネルの二層、三層 CNN。
- ResNet:ResNet-8、20、32、44、56。元論文の手順に従い 136 エポック訓練する。
- DenseNet:DenseNet-40-12 と DenseNet-100-12-BC。266 エポック訓練する。
データセットは CIFAR-10 と CIFAR-100。AutoNEB は極小値の組ごとに NEB を 14 サイクル回し、モーメンタム付き SGD で、学習率を 0.1 から 0.001 まで段階的に下げる。
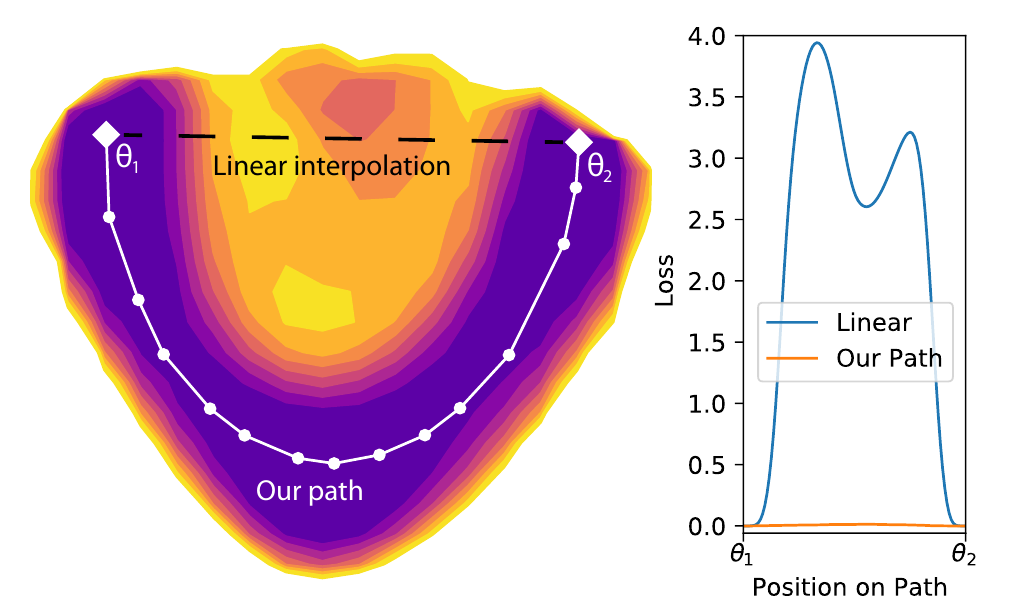
この図は百万次元の損失関数の二次元断面だ。直線は中ほどで広い高損失領域にぶつかり、最大で 4 近くになる。AutoNEB が見つけた経路は脇を回り込み、全区間で損失にほとんど起伏がない。
鞍点はどれほど低いか
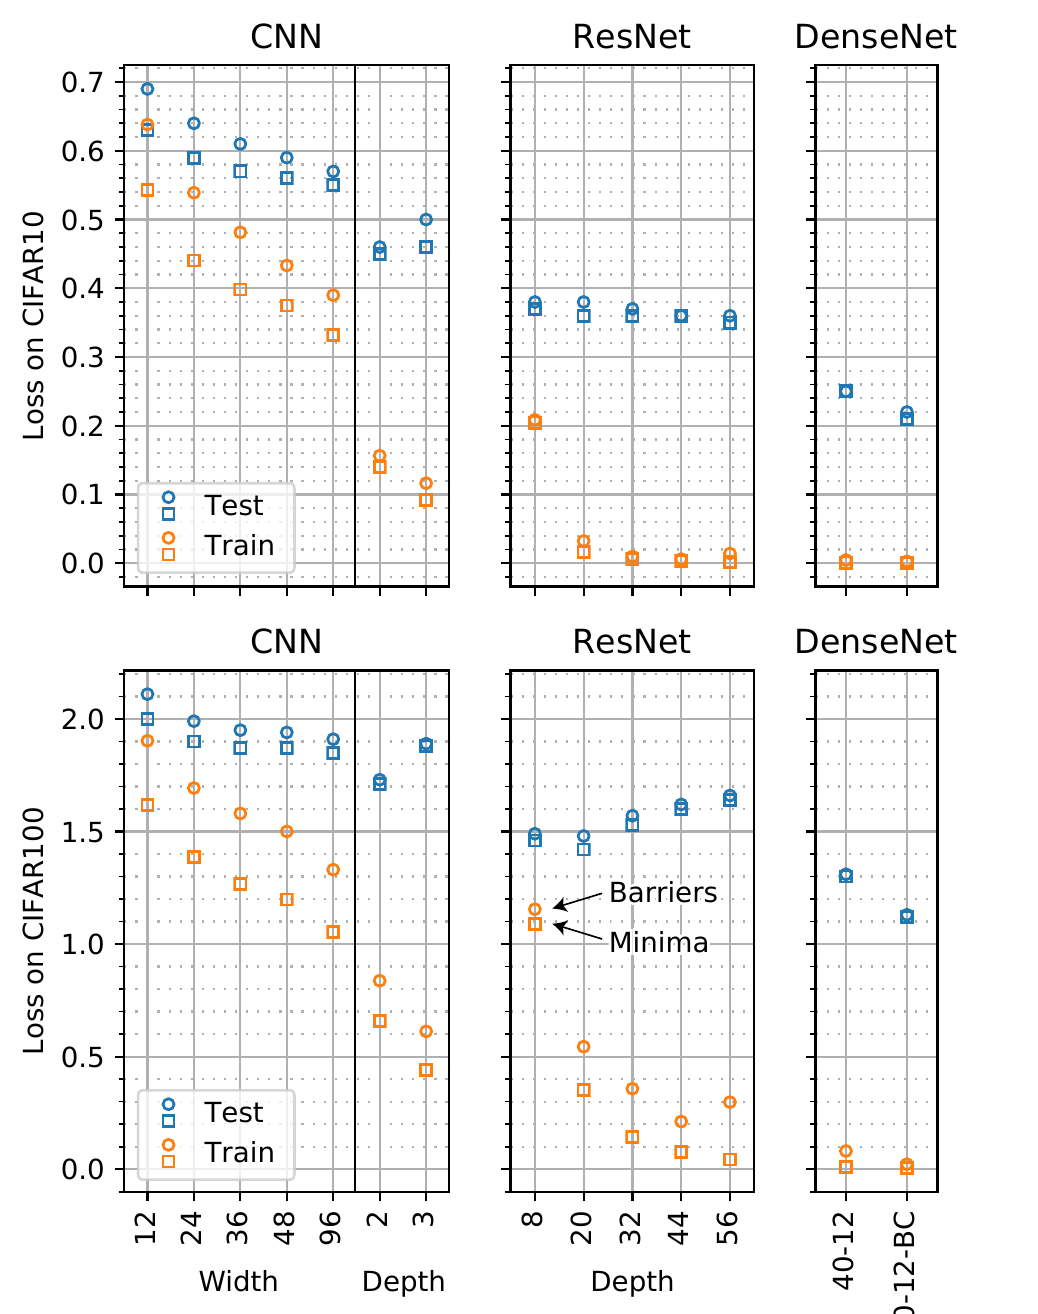
これが論文全体の中心となる結果だ。同じ色の四角と丸を比べて読む。四角は極小値の平均損失、丸は経路上の鞍点の平均損失で、両者が近いほど障壁は低い。
左の基本的な CNN で傾向が見える。幅を 12 から 96 に増やすと、訓練集合の鞍点は次第に極小値へ近づく。二層、三層と深くすると、差はさらに速く縮む。ResNet と DenseNet になると、CIFAR-10 の訓練鞍点は極小値にほぼ張りつく。
付録の Table B.1 に数値がある。CIFAR-10 の ResNet-56 では、極小値の平均訓練損失が 0.0022、鞍点が 0.0141。DenseNet-100-12-BC ではそれぞれ 0.0005 と 0.0026 だ。比率では何倍も違って見えるが、比較の基準が重要になる。未訓練のネットワークの CIFAR-10 での損失は で、深い残差ネットワークの鞍点はこれよりおよそ二桁小さく、同じモデルのテスト集合での損失と比べても一桁ほど小さい。
CIFAR-100 は難しく、障壁も高い。ResNet-56 の訓練損失は 0.0428 から 0.2978 に、DenseNet-100-12-BC は 0.0050 から 0.0223 に上がる。それでもランダム初期化のネットワークの約 4.6 という損失と比べれば、差はまだ小さい。
分類誤り率の変化も大きくない。付録によれば、経路に沿った最大の誤り率は、極小値と比べて ResNet で最大 0.7(CIFAR-10)と 2.9 ポイント(CIFAR-100)、DenseNet では 0.4 と 1.5 ポイント高いだけだ。
もう一つの測り方は、訓練曲線を見て、損失がいつ鞍点を下回るかを調べることだ。答えはかなり遅い。どのアーキテクチャも一回目の学習率減衰の後で、多くの ResNet と DenseNet では二回目の減衰の後、つまり訓練の最終段階になる。言い換えれば、これらの鞍点は「訓練終盤のモデル」とほぼ同じくらいよい。
経路はどんな形か
経路自体も素直だ。経路に沿って個々のパラメータが直線補間からどれだけずれるかを見ると、どの座標も滑らかに変化し、最大のずれは鞍点の付近に集中する。経路全体は、二点間の直線より 50%~2.5 倍長い。
著者らは結論で、経路上のテスト損失はわずかに低いことさえあるので、これらの経路を巨大なモデルアンサンブルとして使えるかもしれないと述べている。この方向は後に Garipov らの FGE がより本格的に実現した。
なぜこれほど平らなのか
論文に証明はなく、著者らは定性的な説明を二つ挙げる。
一つ目は頑健性だ。現代のネットワークは各層に数十~数百のチャネルを持ち、スキップ接続もある。一つのパラメータに小さな摂動を加えても、他の大量のパラメータが一緒に調整して埋め合わせられるので、モデルは少しずつ構造を変えながら、損失をほとんど上げずに済む。Dropout とアンサンブルは、まさにこの頑健性を利用し、強めている。ネットワークを大幅に圧縮しても損失がほとんど上がらないのも、同じ理由だ。
二つ目は冗長性で、著者らは XOR を例に挙げる。
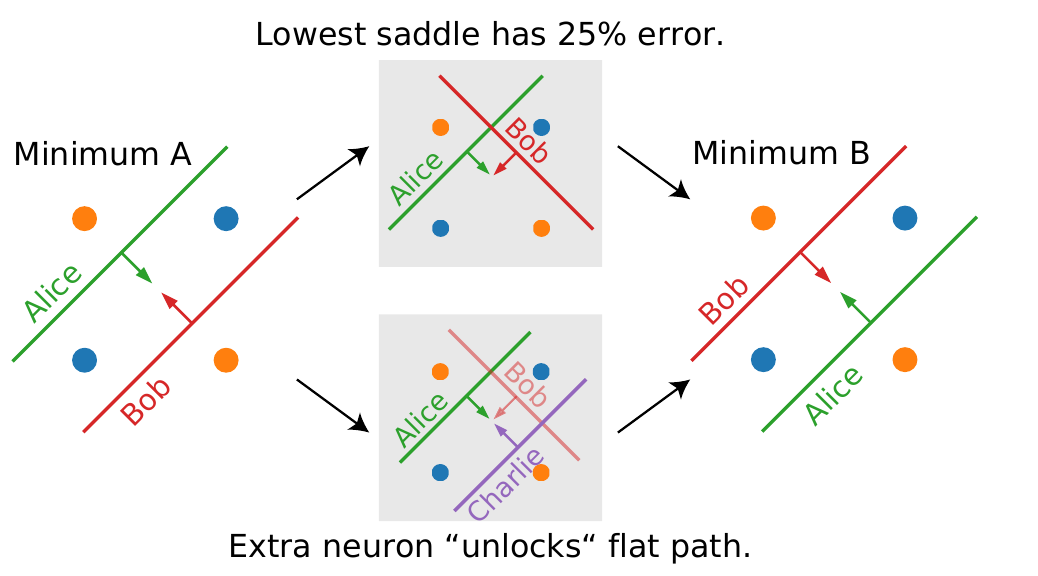
教科書で XOR を解く二層パーセプトロンは、隠れ層にニューロンを二つ持つ。著者らはそれを Alice と Bob と呼ぶ。二人の位置を入れ替える(次の層の重みも一緒に交換する)と、等価な別の極小値が得られる。ニューロンが二つしかないと、A から B へのどの連続な経路でも途中で少なくとも一点を誤分類し、最も低い鞍点でも誤り率は 25% になる。
ニューロン Charlie を一つ加えれば、リレーを組める。まず Charlie が Bob の代わりを務め、Bob はゆっくり Alice の位置へ移り、Alice が Charlie の仕事を引き継ぎ、最後に Charlie が退場する。次の層が移動中のニューロンを一時的に無視しさえすれば、全過程で一つも誤分類しない。
この例は、ニューロンの入れ替え(置換対称性)と追加の容量を結びつける。後に Entezari らや Git Re-Basin が追い続けたのは、まさに置換対称性が障壁において果たす役割だった。
制限
AutoNEB で得られるのは上界にすぎず、この現象がどんな条件で成り立つかは現時点では特徴づけられないと、著者らも認めている。実験は CIFAR-10/100 の画像分類だけで、モデルは最大でも DenseNet-100 だ。経路一本のコストが一回分の訓練に近いため、各アーキテクチャの極小値は 10 個にとどまる。
もう一つ混同しやすいのが「連結」の形だ。この論文が示したのは曲がった低損失経路が存在することで、直線補間ではやはり高い山にぶつかる。重み平均に必要なのは直線上に障壁がないことで、これはより厳しい条件だ。後の線形モード連結性や置換による整列の研究が扱うのは、まさにこの隔たりである。
結論
この論文は、化学で反応経路を探す道具を深層学習に持ち込み、ResNet と DenseNet について明快な観察を得た。独立に訓練した二つの極小値の間には、ほとんど坂を登らずに済む道がある。ネットワークが広く深いほど、その道は平らになる。
そのため谷底の描像は改める必要がある。低損失領域は一続きの低地に近く、各極小値はその低地の上の別々の場所にすぎない。
PyTorch 実装は fdraxler/PyTorch-AutoNEB にある。本気で大きなモデルに使う前に、予算をよく考えておこう。極小値を一組つなぐごとに、ネットワークをもう一回訓練するくらいの時間がかかる。