原論文
Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time
- 発表先
- ICML 2022国際会議
- arXiv への初回投稿
- arXiv:2203.05482
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingmodelsoups2022,
  title = {{Model soups: averaging weights of multiple fine-tuned models improves accuracy without increasing inference time}},
  author = {Mitchell Wortsman and Gabriel Ilharco and Samir Yitzhak Gadre and Rebecca Roelofs and Raphael Gontijo-Lopes and Ari S. Morcos and Hongseok Namkoong and Ali Farhadi and Yair Carmon and Simon Kornblith and Ludwig Schmidt},
  year = {2022},
  eprint = {2203.05482},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.05482}
}
大きなモデルの微調整では、学習率、重み減衰、訓練エポック数、データ拡張などのハイパーパラメータを何通りか試す。一群のモデルを訓練し、検証集合で最良の一つを選び、残りは削除するのが一般的だ。
削除するモデルにも、かなりの計算を使っている。ワシントン大学、Columbia、Google、Meta、テルアビブ大学の Wortsman、Ilharco らは、半年前の WiSE-FT でゼロショット CLIP と微調整後の CLIP を混ぜた。今度は、捨てられる一群に目を向けた。
全部加えて平均し、一鍋のスープにできないだろうか。
問題の定義
事前訓練重みを 、ハイパーパラメータ による微調整結果を 、 とする。この モデルには三つの使い方がある。
| 方法 | 推論時のモデル | 推論コスト |
|---|---|---|
| 検証集合で最良のものを選ぶ | ||
| 出力アンサンブル | ||
| モデルスープ |
原論文 Table 2 より整理。三つの訓練コストは同じ。
アンサンブルは通常最も高精度だが、推論で モデルをすべて実行する。スープは一つだけだが、平均した重みが使えるかが問題になる。
従来の重み平均とは前提が少し違う。SWA は同じ訓練軌跡上の点を平均する。この論文は同じ事前訓練重みから独立に微調整したモデルを平均し、ハイパーパラメータは大きく異なっていてもよい。
問題を解く
三種類のスープ
最も直接的な均等スープ(uniform soup)は、 モデルをすべて平均する。
明確なリスクもある。学習率が大きすぎるなど、ある設定のモデルが別の盆地へ進んで性能を落とすと、平均も引きずられる。
そこで著者らは貪欲スープ(greedy soup)に重点を置く。
import numpy as np

def average(models):
    return np.mean(np.stack(models), axis=0)

def greedy_soup(models, val_acc):
    """models 依驗證集準確率由高到低排好;val_acc(權重) 回傳驗證集準確率。"""
    soup = [models[0]]
    for m in models[1:]:
        if val_acc(average(soup + [m])) >= val_acc(average(soup)):
            soup.append(m)          # 加進去不會變差,就留下
    return average(soup)

# 小例子:二維輸入、兩個類別,用四筆驗證資料選湯的成員。
X = np.array([[2., 0.], [0., 2.], [1., 0.], [0., 1.]])
y = np.array([0, 1, 0, 1])
models = [np.diag([1., 0.5]), np.diag([0.5, 1.]), -4 * np.eye(2)]
val_acc = lambda w: np.mean((X @ w).argmax(axis=1) == y)
models = sorted(models, key=val_acc, reverse=True)
w = greedy_soup(models, val_acc)
print(w.tolist())
print(f"驗證準確率: {val_acc(w):.0%}")
[[0.75, 0.0], [0.0, 0.75]]
驗證準確率: 100%
モデルを検証精度順に並べ、最良のものから一つずつ鍋へ入れてみる。加えた後に検証精度が下がらなければ残し、下がれば飛ばす。最初に最良の単一モデルを入れるため、検証集合ではそれを下回らない。
例の最初の二モデルは四つのデータをすべて正しく分類し、平均後も正しい。三つ目を加えると分類方向が反転するため、除外される。ネットワークでは対応する各テンソルを平均し、選別の論理は同じだ。すでに モデルが入っているとき、新しい候補は 。毎回半分ずつ混ぜると、後から入れたモデルの重みが大きくなってしまう。
順序も効く。先に残したメンバーが後の候補平均を変え、貪欲探索は一巡しかしないため、その順序で許容できる配合を得る。順序をランダムにすると、ImageNet 精度は 81.03% から平均 80.79% になった。検証精度が下がらない性質は直接確認しているが、テスト集合とデプロイ先のデータは別途評価する必要がある。
この検証集合には、通常テストに使われる ImageNet 公式の validation 集合を使わない。著者らは訓練集合の約 2% をスープ選択用に分けている。
三つ目は学習スープ(learned soup)で、各モデル、さらには各層の混合係数を勾配降下で学ぶ。すべてのモデルを同時にメモリへ載せるため、大きなモデルには実用的でなく、付録で扱っている。
具体的には として、 で順伝播し、確保した検証データの交差エントロピーを最小化する。出力の温度パラメータも学ぶ。元の重みは固定し、配合係数を更新する。softmax により係数は正で、和は 1 になる。層別版では層ごとに を持たせ、柔軟に組み合わせる。付録の実装は AdamW、固定学習率 0.1 で 3 epochs 実行し、全候補の重みを保存する。逐次の貪欲な評価を省く代わりに、最適化とメモリが追加で必要になる。
議論
最良の点は中間にある
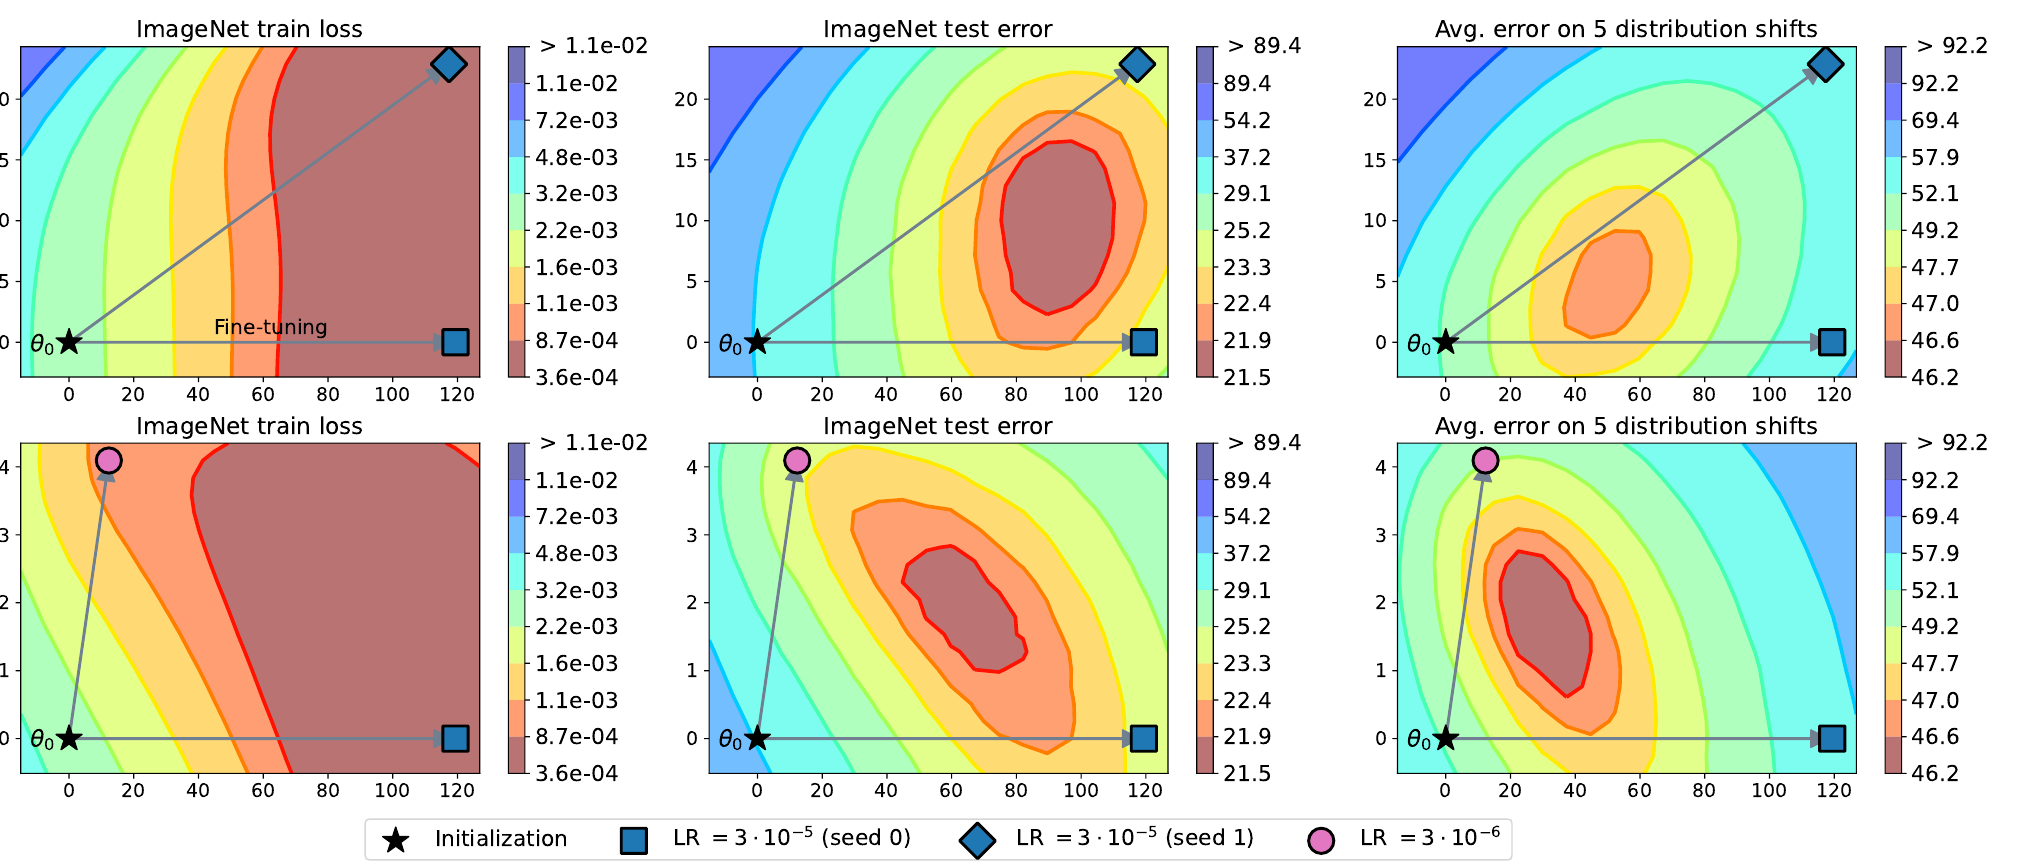
スープがよくなりうる理由を示す図だ。ゼロショット CLIP を二度微調整し、起点と二つの終点が張る平面に損失と誤り率を描いている。
左列の訓練損失では、二つの微調整結果はすでに低い領域にある。しかし中央と右のテスト誤り率では、等高線が盆地を作り、最小点は両者の間にある。三点とも谷底ではない。微調整が向かう低い訓練損失の場所と、テスト誤り率が最も低い場所にはずれがある。
角度が大きいほど、平均の利点が増す
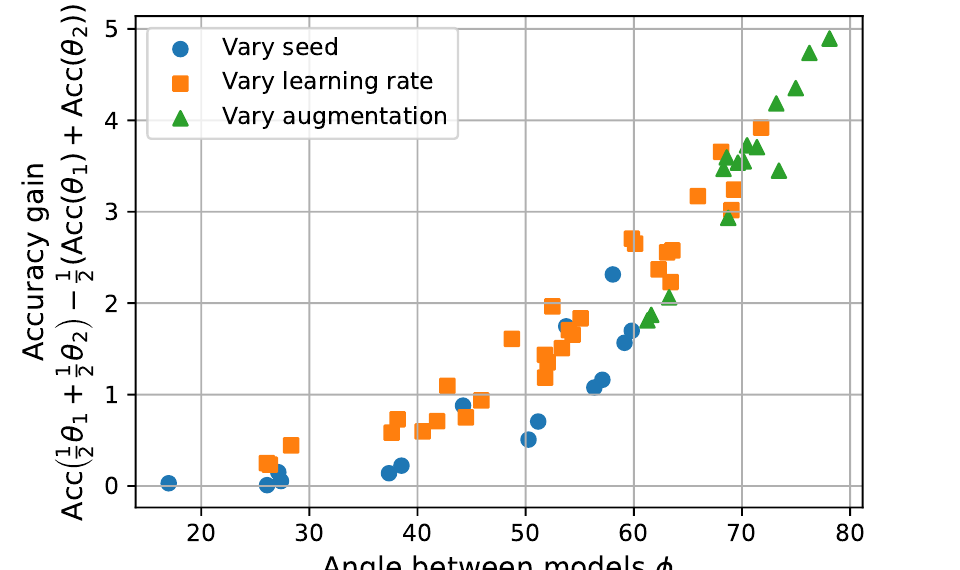
最良の点が中間にあるとして、平均の利点はどれほどか。著者らは「補間の利得」を次のように定義する。
そして二モデルの角度との関係を見る。 は と の間の角度で、事前訓練重みを原点にして二度の微調整がどちらへ進んだかを比べる。
点はおおむね右上がりの曲線を描く。シードだけを変えた青点は左下が多く、角度も利得も小さい。学習率やデータ拡張を変えると角度が大きくなりやすく、平均の利得も最大約 5 ポイントまで増える。
ハイパーパラメータを探索してから平均する理由でもある。モデル同士が異なるほど平均が役立つ。ただし、同じ盆地にとどまっていることが前提だ。
72 個の CLIP
主実験では CLIP ViT-B/32 を ImageNet 上で、ランダム探索のハイパーパラメータにより 72 回微調整する。
全モデルが事前訓練の起点を共有し、主設定では linear probe で分類ヘッドを初期化してからエンドツーエンドで微調整する。学習率(~)、weight decay、4~16 訓練 epochs、label smoothing、mixup、データ拡張を変える。通常の探索で生じるよいモデルも悪いモデルも残し、探索後にどれだけ追加の利得を得られるかを測る。
| 方法 | ImageNet | 五つのシフトの平均 |
|---|---|---|
| 最良の単一モデル | 80.38 | 47.83 |
| 均等スープ(全 72 モデル) | 79.97 | 51.45 |
| 貪欲スープ | 81.03 | 50.75 |
| 学習スープ(層別係数) | 81.37 | 50.87 |
| 72 モデルの出力アンサンブル | 81.19 | 50.77 |
精度(%)。原論文 Table 3 より整理。
均等スープは ImageNet で最良の単一モデルより低く、シフト後は 3 ポイント以上高い。一部のメンバーが平均を悪くしていることがわかる。貪欲スープは両方で最良の単一モデルを上回り、ImageNet は 72 モデルのアンサンブルよりわずか 0.16 ポイント低いだけで、推論は一度で済む。
この CLIP の貪欲スープは最終的に 5 メンバーだけを残す。ALIGN の別実験も 12 候補から 5 個を選んだ。層別 learned soup は 81.37% とさらに高いが、全体で一組の係数を使う版は 80.89% で貪欲スープより低い。貪欲な出力アンサンブルなら ImageNet は 81.90% まで上がる一方、シフト平均は 49.44% になる。手法の順位は選択目標によって変わり、最良の一列だけでは全体の利得を表せない。
二モデルのスープとアンサンブルも比較した。中程度の学習率では精度の相関が高く、ImageNet はアンサンブル、シフト後はスープが少しよい。学習率が大きすぎて二モデルが遠く離れると、アンサンブルが明確に勝つ。
記録を更新した一鍋
最も注目されたのは ViT-G/14 だ。Google の JFT-3B で事前訓練し、ImageNet で 58 回微調整したモデルから、貪欲スープが 14 個を選んだ。
| モデル | ImageNet | シフトの平均 |
|---|---|---|
| CoAtNet-7(当時の最高記録) | 90.88 | – |
| ViT-G、探索で最良の単一モデル | 90.78 | 84.68 |
| ViT-G、貪欲スープ | 90.94 | 85.02 |
Top-1 精度(%)。原論文 Table 1 より整理。
90.94% は当時の ImageNet 最高記録で、推論計算量は CoAtNet-7 より 25% 少ない。探索内の最良モデルからの改善は 0.16 ポイントで、追加の訓練予算は使っていない。
役立つ範囲
ALIGN、BASIC、WILDS の二データセット、BERT と T5 の四つの GLUE テキスト分類タスクでも試している。画像分類の傾向は共通している。テキスト分類も改善するが、画像ほど大きくなく、著者らは予備的な結果と位置づける。
テキスト実験は各タスクで 32 設定をランダム探索し、学習率、batch size、epochs、シードを変える。タスクは文対の言い換え MRPC、含意判定 RTE、文法的容認性 CoLA、感情分類 SST-2。指標も異なり、MRPC は accuracy と F1 の平均、CoLA は Matthews correlation、RTE と SST-2 は精度だ。BERT-base の RTE は 61.0 から 61.7、SST-2 は 92.5 から 93.0 へ改善し、MRPC と CoLA は増えない。T5-base の RTE は 78.3 から 79.1。この結果が支えるのは同じタスクの微調整モデルのマージで、四つの異なるタスクを一鍋で解く実験はしていない。
二つの制限も明記する。一つは範囲で、多くの実験は大規模で多様なデータによる事前訓練モデルを使う。ImageNet-22k の事前訓練に変えても貪欲スープは改善するが、幅はずっと小さい。もう一つは較正で、アンサンブルは確信度を改善するが、スープにはその効果がなかった。
較正の比較では、ハイパーパラメータ差を混ぜないよう、シードだけが異なる 20 モデルを使い、expected calibration error を測る。分類精度と予測確率の信頼性は別の要件だ。確率で拒答のしきい値を設定するなら、後者を直接確かめる必要がある。
同じ盆地にいても、なぜアンサンブルに負けるのか
幾何的な直感に加え、論文はスープと logit アンサンブルの交差エントロピー差も解析する。二モデルの補間の近似式には二つの部分がある。一つは線上の損失の二階微分、もう一つはスープの softmax 分布で測った端点 logit 差の分散だ。
線上の損失の曲がり方がスープに有利なら、第一の部分がスープの相対損失を下げる。第二の部分は出力アンサンブルに有利だ。二モデルがよく似て logit 差が小さいか、スープの予測が確かで softmax がほぼ一クラスに集中すれば、分散項は小さい。同じ盆地にあるというだけでは両者の差を予測しきれない理由がここにある。
この近似は、logits が線上でほぼ線形な場合に成立する。遠く離れた学習率 のモデルを除くと、近似値と実測した損失差との相関が高まる。学習率を にした地形では、二つの微調整終点の間に明確な障壁が見える。共通の起点でも、こうした失敗メンバーが生じるからこそ、貪欲な確認が役立つ。
結論
モデルスープは「探索後に一つだけ残す」を、「探索後にいくつか選んで平均する」へ変える。訓練コストは同じで、推論も一モデルのまま、CLIP と ViT-G では最良の一つを選ぶ方法を上回った。
条件は WiSE-FT と同じだ。全メンバーが同じ事前訓練重みから始まり、できれば同じ盆地にとどまる必要がある。貪欲スープの検証集合チェックは、盆地を出たメンバーを止める役割を持つ。
同じ基底から異なるハイパーパラメータで微調整したモデルが手元にあるなら、最良の一つを残す前に、この順序で一鍋作ってみよう。