原論文
REPAIR: REnormalizing Permuted Activations for Interpolation Repair
- 発表先
- ICLR 2023国際会議
- arXiv への初回投稿
- arXiv:2211.08403
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingrepair2022,
  title = {{REPAIR: REnormalizing Permuted Activations for Interpolation Repair}},
  author = {Keller Jordan and Hanie Sedghi and Olga Saukh and Rahim Entezari and Behnam Neyshabur},
  year = {2022},
  eprint = {2211.08403},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2211.08403}
}
2022 年末、「置換で整列した後、二つのネットワークをそのまま平均できるか」について、文献には互いに矛盾する二つの結果があった。
一方は、Singh と Jaggi が 2020 年に最適輸送(optimal transport)で行ったニューロンの整列だ。CIFAR-10 で精度 93% を超える二つの ResNet18 を整列してから線形補間しても、中点は最良でも 77% で、まだ 16 ポイント足りない。
もう一方は 2022 年 9 月の Git Re-Basin だ。幅を広げた ResNet で、CIFAR-10 上の独立に訓練した二つのモデルの障壁をほぼゼロにした。しかも比較した整列法の一つ「活性値照合」は、Singh と Jaggi の方法が含む特殊な場合そのものだった。
二つの結果がどうして同時に成り立つのか。
Hive AI の Keller Jordan と、Google、TU Graz の Sedghi、Saukh、Entezari、Neyshabur が共著したこの論文が答えを出した。後半の四人は、置換不変性の予想を示したのと同じ著者たちだ。
問題の定義
前回の Entezari らの調査で、整列後の障壁は幅とともに下がるが、深さとともに急激に上がることがすでにわかっていた。数層を超える MLP や CNN は、整列しても救えない。
著者らは、深さがいったい何を壊しているのかを知りたかった。
彼らは整列アルゴリズムの改良を続けるのではなく、補間後のネットワークを直接開けて、各層の活性値を見た。測り方は簡単だ。ある層について、訓練データの一バッチ上での各ニューロンの活性値の分散を計算し、合計して とする。補間モデルの を、二つの端点モデルの 、 と比べる。
比が 1 に近ければ、補間モデルの活性値は端点モデルと同じくらい活発だ。0 に近ければ、その層の出力は入力によってほとんど変わらない。
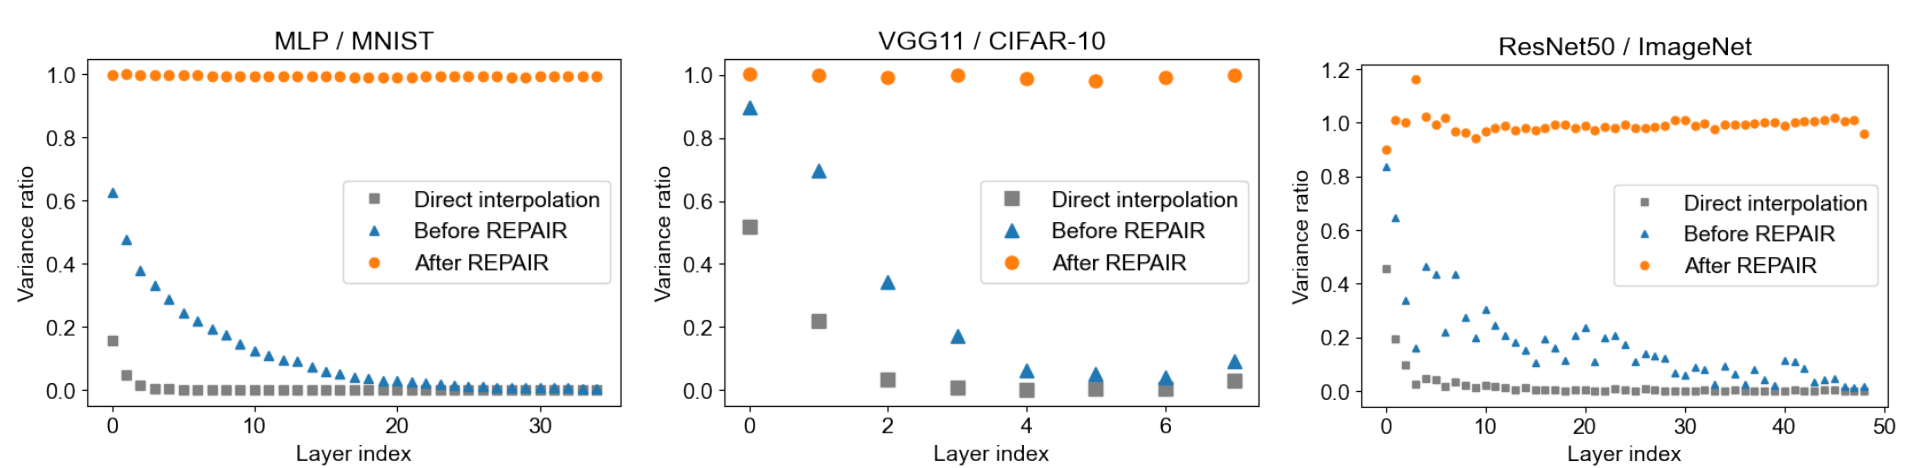
まず青の三角を見る。整列後、まだ補正していない補間モデルだ。MLP の第一層の分散比は約 0.6 で、その後一層ごとに下がり、35 層の最後の数層ではほぼゼロになる。VGG11 と ResNet50 も同じで、最後の数層の分散は十分の一以下に落ちる。
著者らはこの現象を分散崩壊(variance collapse)と呼ぶ。最後の数層の活性値はほぼ定数で、ネットワークはもう異なる入力を区別できず、精度がよくなるはずもない。
灰色の四角は整列せずに直接補間したもので、崩壊はさらに速い。
問題を解く
なぜ分散が縮むのか
まず補間ネットワークの第一層を見る。第一層の入力は元のデータそのものなので、あるニューロンの補間後の pre-activation(ReLU の前の値)は、ちょうど二つの端点の対応するニューロンの線形結合になる。
、 をデータとともに変わる確率変数とみなす。中点 を取ると、
第一項は本来あるべき分散、つまり両端の標準偏差を平均して二乗したものだ。第二項は差し引かれる部分で、二つのニューロンの相関係数が 1 未満なら必ず差し引かれる。
二つの端点の標準偏差がほぼ同じなら、式は次のように簡単になる。
どれだけうまく整列しても、独立に訓練した二つのネットワークがまったく同じニューロンを学ぶことはない。著者らの観察では、整列後にペアになったニューロンの相関係数はたいてい 0.4 程度にすぎない。代入すると、
第一層の分散は 30% 減る。
より深い層では、入力がすでに前の層で縮んだ活性値なので、このように厳密には導けない。著者らの直感では、この目減りは層ごとに積み重なる。各層で七割しか残らないと大ざっぱに仮定すれば、10 層後には しか残らない。
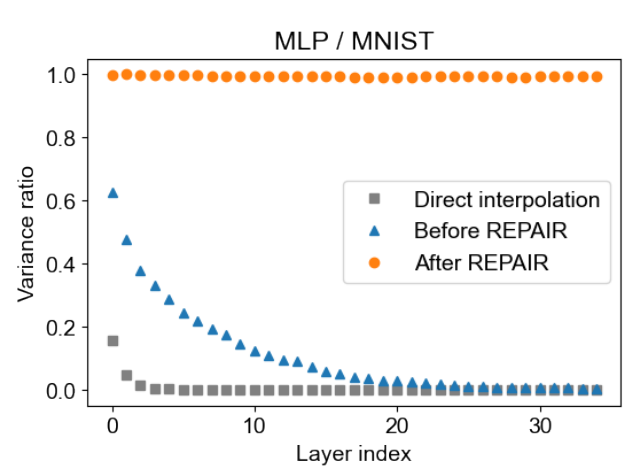
この大ざっぱな見積もりを MLP の実測と比べる。青の三角は第 0 層の約 0.62 から始まり、第 10 層でもまだ約 0.12 あり、0.03 前後まで下がるのは第 20 層あたりだ。実際の減衰は一層ごとに七割よりも遅いが、層を追って下がっていく形は同じである。
REPAIR が目指すもの
問題が統計量にあるなら、統計量を元に戻せばよい。補正する各チャネルについて、REPAIR は補間モデルに二つの条件を課す。
平均値の補間はもともと成り立つ。実際に崩れるのは二つ目だ。補正前はたいてい になっている。
どのチャネルを補正するかについて、著者らは VGG では各畳み込み層の出力を選ぶ。ResNet では畳み込み層の出力に加え、各残差ブロックの出力も補正する。
近似版:一つのスケーリング係数
第一層だけなら、補正係数は直接計算できる。端点モデルから 、、 を測れば、補間ニューロンの分散は
必要なスケーリング係数は「目標の標準偏差を実際の標準偏差で割ったもの」だ。
先ほどの数字を代入すると、 で両端の標準偏差が等しいとき となり、各ニューロンの出力を二割大きくすればよい。
この係数は第一層では厳密だが、より深い層では近似にすぎない。著者らが MNIST で 2~50 層の MLP を訓練して試すと、補正なしでは中点モデルは 6 層を超えると 90% を下回った。この近似補正を使えば、27 層まで 90% 以上を保てる。
近似版の利点は、端点モデルで順伝播するだけで済むことだ。統計量を計算しておけば、どの の補正係数も直接求められる。
厳密版:BatchNorm を借りて測る
ImageNet の ResNet50 のような難しい場合には、近似版では足りない。そこで著者らは厳密版を提案し、補間モデル上で直接順伝播する。
やり方は、補正する各モジュールの後ろに、一時的に BatchNorm 層を一つつなぐことだ。
from torch import nn

class RepairWrap(nn.Module):
    def __init__(self, module, channels):
        super().__init__()
        self.module = module
        self.bn = nn.BatchNorm2d(channels)      # 新しく加える層。まず train モードにする

    def set_goal(self, goal_mean, goal_std):
        self.bn.bias.data = goal_mean            # (1-α)·E[X1] + α·E[X2]
        self.bn.weight.data = goal_std           # (1-α)·std(X1) + α·std(X2)

    def forward(self, x):
        return self.bn(self.module(x))
BatchNorm は訓練モードでは、まず入力を平均 0、分散 1 に正規化し、weight を掛けて bias を加える。この二つのパラメータを目標の標準偏差と平均値に設定すれば、出力の統計量はちょうど条件どおりになる。
次に約 5,000 件の訓練データをネットワークに通し、新しく加えた BatchNorm に running mean と running variance を推定させる。元のネットワークにある BatchNorm はすべて凍結する。推定が終わって評価モードに切り替えると、新しい層は固定のスケーリングと平行移動になり、最後は直前の畳み込みの重みに融合できる。モデルのアーキテクチャは元とまったく同じになる。
ここに面白い対比がある。ネットワークがもともと各畳み込みの後に BatchNorm を持つなら、畳み込みの出力だけを補正するのは、数学的には BatchNorm の統計量を推定し直すのと同じだ。SWA は 2018 年に平均後のモデルをこう扱っていたが、独立に訓練した二つのネットワークの間で使った人はいなかった。REPAIR はこのやり方を、残差ブロックの出力と、BatchNorm のないネットワークへ広げた。
REPAIR と整列アルゴリズムは補い合う関係にある。著者らはこの論文で一貫して Li らの 2015 年の活性値相関による照合を使い、ハンガリー法で解く。残差接続のあるネットワークでは、同じ残差ストリーム上の各層に同じ置換を適用しなければならない。
議論
CIFAR-10 上の ResNet18
整列した二つの ResNet18 は、端点の CIFAR-10 テスト集合での精度が 95.5% だ。直接補間した中点はわずか 66.0% だが、REPAIR 後は中点が 94.1% になり、障壁は 1.5 ポイントしか残らない。比較対象の Singh と Jaggi の最適輸送による整列では、中点は 77.0% だった。
正規化層が矛盾を解く
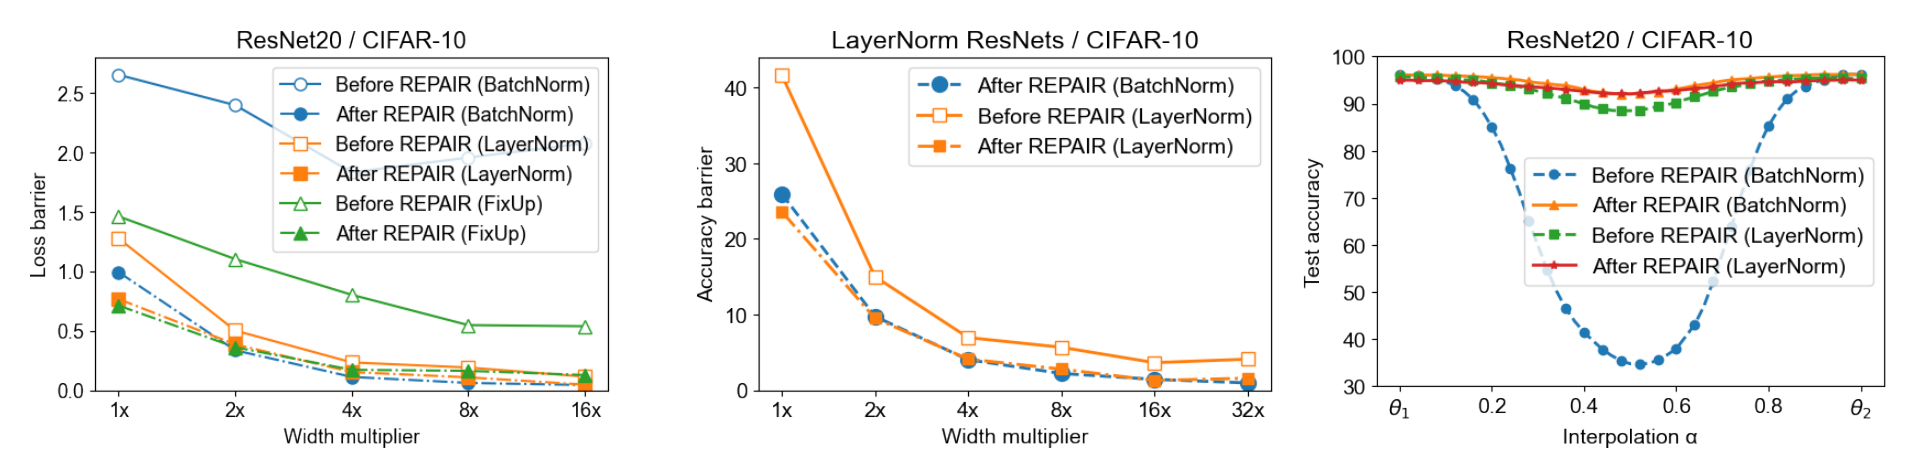
著者らは CIFAR-10 で ResNet20 を訓練し、BatchNorm、LayerNorm、正規化を使わない Fixup の三種類の正規化を比べる。幅の倍率は 1× から 16×(最後のブロックで 64 から 1024 チャネル)だ。
最も説得力があるのは右図だ。標準幅の BatchNorm 版は、補正前の中点が 34.7% まで落ちる。LayerNorm 版は補正前から 88.4% ある。補正後はどちらも 92.0% になる。
幅 8× でも同じだ。LayerNorm の中点は補正前から 90.3% あり、補正後は 93.2%。BatchNorm は補正前がわずか 32.3% で、補正後は 94.4%。左図では、幅を 16× まで広げると、補正後の BatchNorm と LayerNorm の損失障壁はどちらも 0.05 を下回る。
なぜ LayerNorm は特別なのか。著者らの説明では、LayerNorm は推論時にもその時の入力で正規化し直すため、各層で縮んだ分散が引き戻され、積み重ならない。BatchNorm は推論時には固定のアフィン変換にすぎず、縮みが層ごとに重なっていく。
これが冒頭の矛盾への答えだ。著者らが Git Re-Basin のコードを調べると、その ResNet は BatchNorm を LayerNorm に置き換えていた。Singh と Jaggi が使ったのは標準的な BatchNorm の ResNet18 で、どれほどうまく整列しても分散崩壊に足を引っ張られていた。
LayerNorm にも代償がある。同じ訓練設定で、LayerNorm 版の ResNet20 は CIFAR-10 で 92.4%、BatchNorm 版は 93.6% だ。
ImageNet
ImageNet では、整列後に直接補間した ResNet18、ResNet50、幅 2 倍の ResNet50 の中点精度は、いずれも 1% 未満だ。REPAIR 後はそれぞれ 41.1%、56.5%、64.2% になる。
残差ブロックの出力を補正するかどうかで、差は小さくない。ResNet50 で畳み込みの出力だけを補正すると中点は 53.2%、残差ブロックの出力も加えると 56.5% になり、障壁は 23.4 ポイントから 20.1 に下がる。
それでも、これはかなり大きな障壁だ。標準の ResNet50 は補正後も 20.1 ポイント、幅 2 倍では 12.9 ポイントが残る。著者らは、難しいデータセットでは、より広いネットワークでなければ障壁が十分に下がらないと推測している。
幅と深さ
10 層 MLP(幅 32~2048)と ResNet20(幅 1×~16×)について、MNIST、FashionMNIST、SVHN、CIFAR-10 の四つのデータセットのいずれでも、REPAIR は障壁を下げ、幅が広いほど低くなった。MNIST では狭めのネットワークでもゼロに近い。
深さについては、CIFAR-10 上の 11 層から 19 層の VGG で、補正前の障壁は深さとともに上がり、補正後は深さにほぼ関係なくなる。Entezari らの調査で見られた「深さが障壁を高くする」現象は、少なくとも一部が分散崩壊によるものだ。
異なるデータで訓練したモデルのマージ
最後の実験は Git Re-Basin の設定を再現する。CIFAR-100 の訓練画像 50,000 枚を 25,000 枚ずつ二つに分け、一つ目は前半 50 クラスの 80% と後半 50 クラスの 20%、二つ目はその逆にする。二つのネットワークは、それぞれ半分のクラスを得意とする。
整列して REPAIR で補正すると、補間経路上のかなりの数のモデルで、完全なテスト集合での損失が両端点のどちらよりも低くなった。最良は で、テスト損失は 1.30。Git Re-Basin が報告した最良値は 1.73 で、やはり にあった。著者らは、この差の一部は REPAIR によるもので、一部は標準の ResNet がもともと LayerNorm 版より強いことによると率直に述べている。
これはまだ置換と呼べるのか
著者らは議論の中で、誠実な問いを投げかけている。REPAIR によって低障壁になる場合が増え、Entezari の予想を支持するように見える。しかし REPAIR は補間モデルの pre-activation をスケーリングし直しており、もはや厳密な「置換後の線形補間」ではない。
言い換えれば、実用的な幅で、LayerNorm に置き換えないという前提では、置換だけでは足りず、こうした統計量の補正も必要らしい。予想自体はまだ証明されていない。
実務上は、REPAIR に訓練データが必要なことも覚えておきたい。端点モデルの統計量は訓練データで測り、厳密版ではさらに数千件のデータを補間モデルに通す。重みだけがあってデータがなければ、この手順は実行できない。
結論
この論文は、整列の問題に見えた現象を、補間ネットワーク内部の統計量まで追いかけた。二つのニューロンが完全に相関していない限り、平均すると分散は縮む。BatchNorm のネットワークではこの縮みが層ごとに重なり、最後にはネットワーク全体が入力に反応しなくなる。
補正方法は、各チャネルの平均値と標準偏差を、二つの端点の間の補間値に引き戻すだけだ。CIFAR-10 の ResNet18 の障壁は、Singh と Jaggi の最適輸送による整列で残っていた 16 ポイントから 1.5 に下がり、ImageNet の ResNet50 は 1% 未満から 56.5% まで回復した。
普段から重み平均をしているなら、平均した後に BatchNorm の統計量を推定し直すのを忘れないように。公式コードは KellerJordan/REPAIR にあり、補正には数千件の訓練データで一度順伝播するだけでよい。
SWA は 2018 年にすでにこれをやっていた。ただ、そのとき平均していたのは、すべて同じ訓練軌跡上のモデルだった。