原論文
A Systematic Study of In-the-Wild Model Merging for Large Language Models
- arXiv への初回投稿
- arXiv:2511.21437
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmerginginthewildmerging2025,
  title = {{A Systematic Study of In-the-Wild Model Merging for Large Language Models}},
  author = {Oğuz Kağan Hitit and Leander Girrbach and Zeynep Akata},
  year = {2025},
  eprint = {2511.21437},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2511.21437}
}
マージ論文の実験は、通常きれいに設計される。八つの画像分類データセット、七つの NLP タスクのように、各専門モデルを明確に分かれたタスクで微調整し、混ぜた後で個別に測る。
現実は違う。Hugging Face の同じ Llama や Qwen に何百、何千もの微調整版があり、数学、ロールプレイ、別の指示データなど、目的は重なりも衝突もする。会社に蓄積した微調整モデルも、似た状況だろう。
Koç 大学、ミュンヘン工科大学、Helmholtz Munich、MCML の Oğuz Kağan Hitit、Leander Girrbach、Zeynep Akata は、この「野生」の版を混ぜ、基底、さらにはどの単独版よりもよいモデルを得られるかと問うた。
問題の定義
異質で衝突しうる微調整版を対象に、一般的な言語能力を評価する。ソースの訓練タスクは評価範囲の一部しか覆わない。
問いは三つだ。
- 複数の微調整版を単純に混ぜ、基底よりよくできるか。
- 重み補間を中心とするどの手法ならできるか。
- 近年画像でよい「部分空間」マージは、言語モデルの野外でも有効か。
基底と単独版の両方を超えれば、建設的干渉(constructive interference)を観察できる可能性がある。評価は基底との比較と、プール全体の最高平均スコアの微調整版との比較の二段階。この最強版は固定の参照で、抽出部分集合に入るとは限らない。
問題を解く
新手法ではなく、再現可能な評価手順に重点を置く。
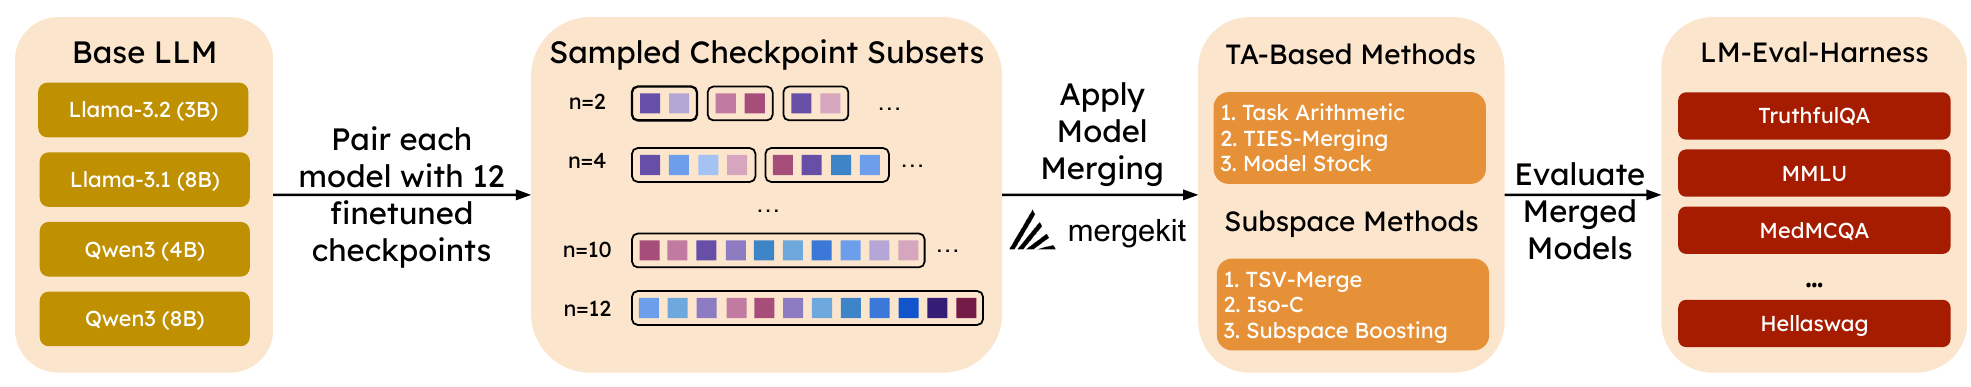
基底と微調整版:Llama-3.2-3B-Instruct、Llama-3.1-8B-Instruct、Qwen3 4B、Qwen3 8B の四つ。各々に Hugging Face から異なる目的・領域の公開 12 版を集める。Llama は Instruct が起点で、家族内で基底を共有し、四家族を交差して混ぜない。
手法:タスク算術系はタスク算術()、TIES-Merging(、各層の絶対値上位 10% を保持)、Model Stock。部分空間系は TSV-Merge、Iso-C、Subspace Boosting の計六つ。すべて mergekit を使い、付録で選んだ係数を先に固定する。
抽出: は 2、4、6、8、10、12。組合せが多いため、各 で一様に 15 部分集合を引く。 は一つだけ。全手法に同じ集合を使い、差をアルゴリズムに限定する。
評価:lm-evaluation-harness で ARC、HellaSwag、Winogrande、MMLU、GPQA、BBH、MMLU-Pro、TruthfulQA など、Open LLM Leaderboard の標準 16 評価を行う。対話テンプレートは適用せず、精度を報告する。
多くは 0-shot、BBH は 3-shot、MMLU-Pro は 5-shot。float16 を使い、batch size は harness が自動選択する。選択式・知識テストのプロンプトを固定できるが、完全な対話、ツール使用、特定のロールプレイは測らない。平均スコアが低い版も、元の用途には適しているかもしれない。
タスク算術の尺度をそろえる
見落としやすいのが、mergekit の normalization が有効な点だ。第 差分を 、配合重みを とすると、実際の変更は、
、 なら差分の平均を取る。十二版を直接加算すると、その 12 倍になる。再現には「TA、」だけでなく normalization の設定も必要だ。
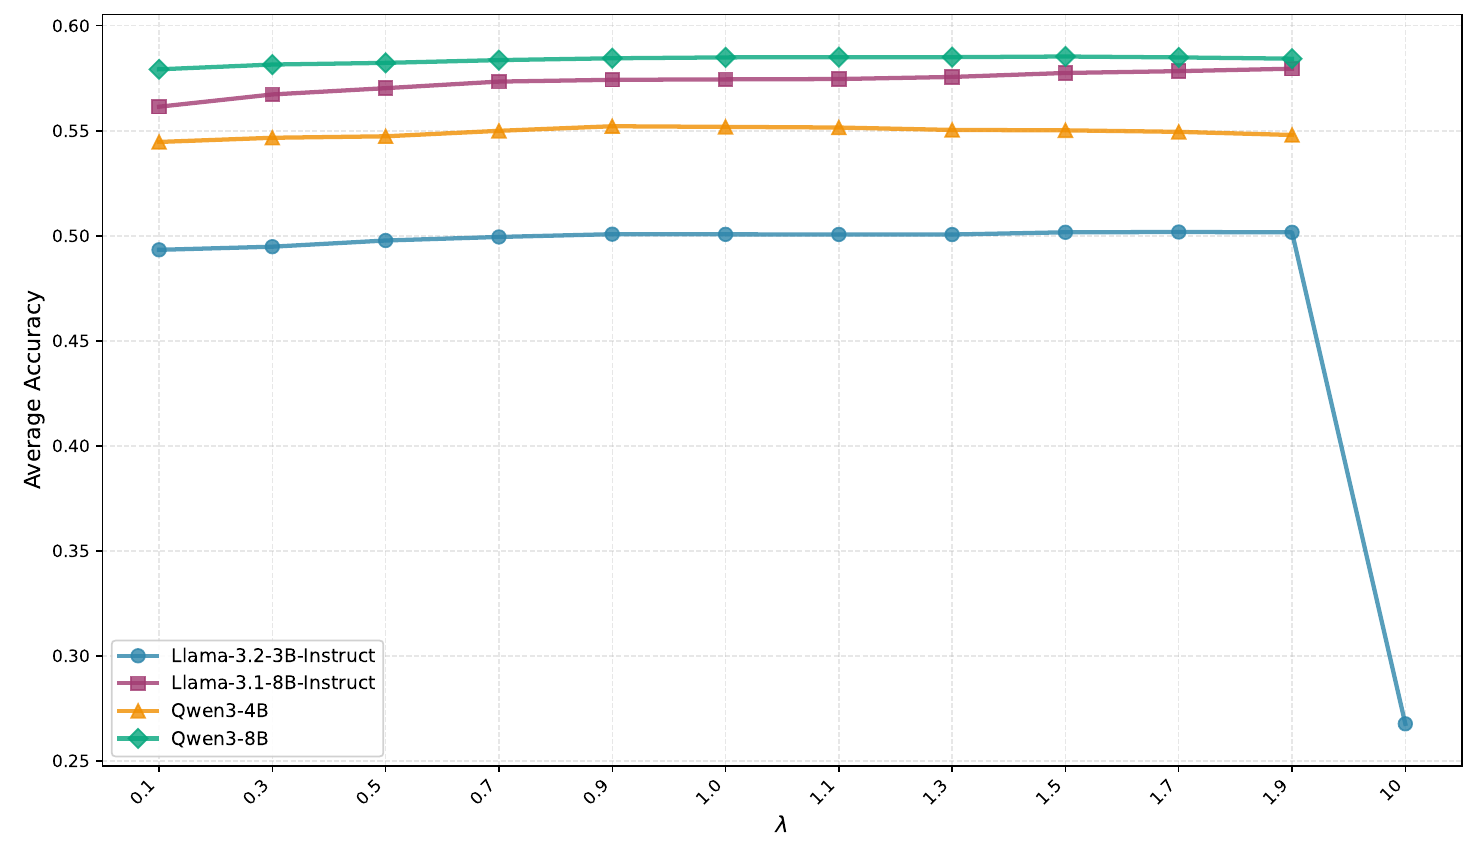
付録では有効時に を 0.1~1.9 へ変えてもほぼ平らで、10 で大きく下がる。無効にすると通常の探索範囲でも とともに急速に悪化する。「単純なタスク算術が最も安定」は、平均とスケーリングの配合での結果だ。
原図の横軸は 、縦軸は平均精度、色は四基底。上は normalization 有効で右端に も加え、下は無効だ。横軸は列挙した係数の位置で、特に右端の二点の実際の間隔は異なる。
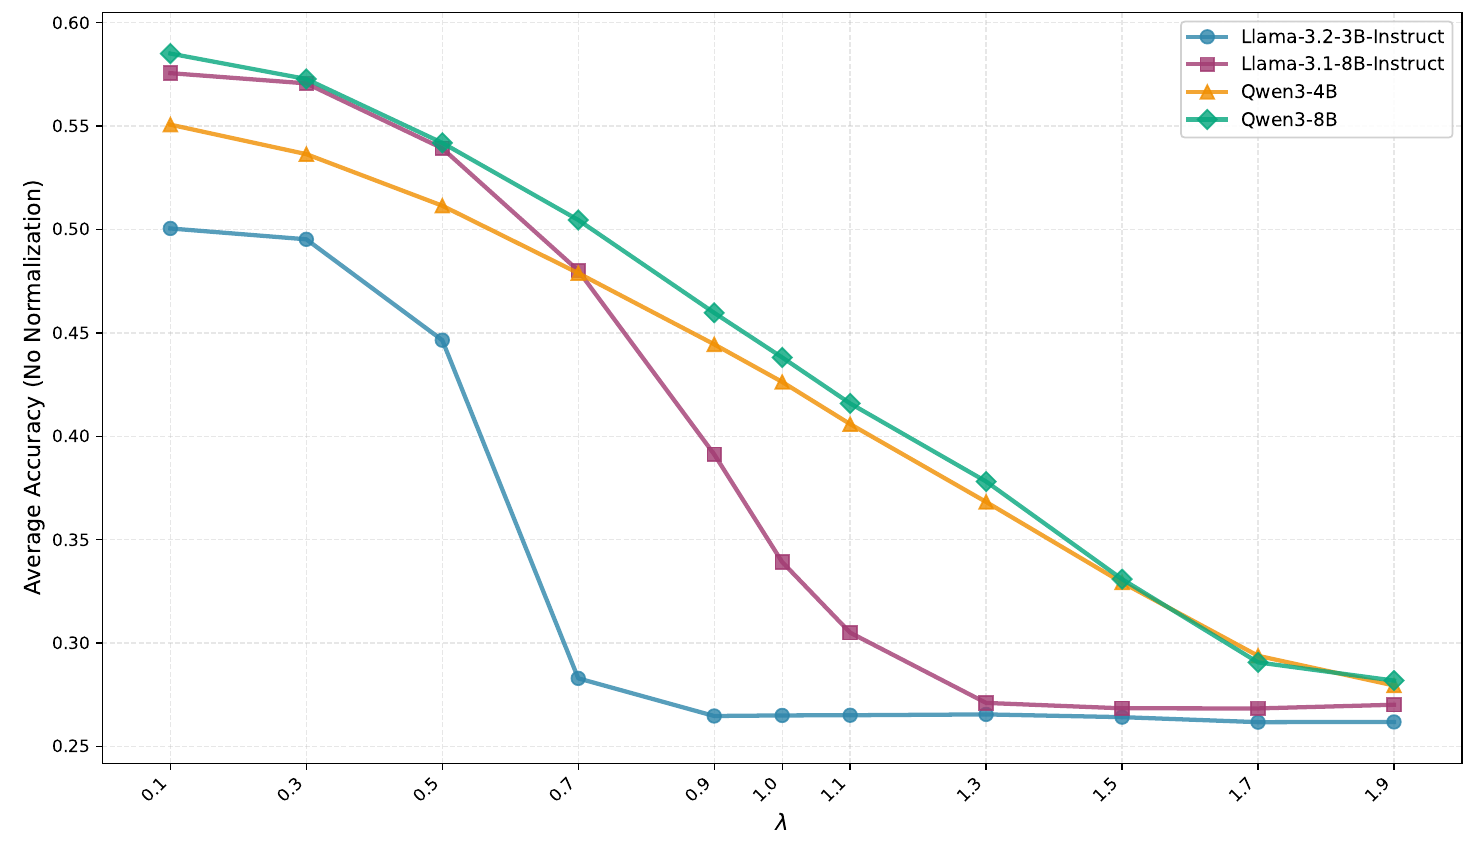
下は複数の変更を合計してから拡大した結果で、上の平均とは大きく違う。真偽値一つを写し忘れるだけで、逆の曲線になりうる。
議論
安定して改善するのはタスク算術
| 手法 | |||||||
|---|---|---|---|---|---|---|---|
| タスク算術 | 25 / −1.11 | 49 / −0.02 | 88 / +0.50 | 100 / +0.74 | 100 / +0.87 | 100 / +0.93 | 100 / +1.02 |
| Model Stock | 25 / −1.11 | 53 / +0.02 | 77 / +0.06 | 82 / +0.09 | 82 / +0.10 | 80 / +0.11 | 100 / +0.13 |
| TIES-Merging | 25 / −1.11 | 78 / +0.11 | 85 / +0.14 | 87 / +0.18 | 85 / +0.17 | 80 / +0.17 | 75 / +0.13 |
四基底の平均。原論文 Table 1 より整理。各マスの前は基底を超えた組合せの割合(%)、後は論文報告の平均相対改善(%)。 は微調整版そのもの。
では基底に勝つのは約四分の一で、平均では 1.11% 下がる。後の改善は、たまたま強い版を一つ引いたためではない。
タスク算術の傾向は明確だ。2 版では約半分が基底に勝ち、 以降は、今回抽出した四基底の全組合せが勝つ。平均改善も とともに増え続け、 で約 1% になる。
100% は今回引いた組合せがすべて合格したという範囲だ。各家族の は 15 部分集合、 は一つだけで、Hugging Face の全組合せは未評価だ。高い勝率でも平均差は小さくありうる。安定性と改善幅を測る二つの値を一緒に読む必要がある。
改善幅は小さい。著者らのまとめでも、全タスク平均の利得は多くが 1% 未満だ。
TIES-Merging の勝率も低くないが、改善は約 0.1~0.2% で頭打ちになる。Qwen3 8B は数が増えると下がり、 の +0.16 から の −0.08 になる。著者らは異質な版ではタスクベクトルの大きさに敏感だと考える。Model Stock は重み自体が遠くへ行かず、ほぼ基底に沿う。
最良の一つには勝てるか
プール全体の最良微調整版との比較では、タスク算術が四基底のうち三つで超えた。 では、二つの Qwen と Llama 3.2 3B で全体に有利な結果になる。
例外の Llama 3.1 8B には非常に強い一版があり、基底を超えても、この固定参照には届かない。「既存の一つを直接選ぶ」基準を残しておかないと、マージと評価に時間を使い、元からある選択肢へ近づくだけになるかもしれない。
部分空間法は、混ぜるほど下がる
近年、TSV-Merge や Iso-C は画像マージの基準で好成績だった。各層のタスクベクトルを特異値分解し、低ランク部分空間で干渉を扱う。TSV-Merge はタスクごとの重要な特異方向を残してタスク間で直交化し、Iso-C は特異値分布を平らにする。
野外の言語モデルではうまくいかず、TSV-Merge と Iso-C の平均精度は版数とともに下がり続ける。著者らは切り詰めと直交化によって有用な情報を徐々に失うと説明する。
基底からの距離も測る。タスク算術、TIES、Model Stock のタスクベクトル長()は多くが 50 以内。一方 Iso-C と TSV-Merge は 100~300、二つの 8B では 300 を超えることが多い。遠いほど性能が下がる。基底の盆地を出て、破滅的忘却を起こすほど重みを動かすと著者らは考える。
一層の の更新 を見ると、SVD は に分ける。TSV-Merge は各ソースの特異方向を約 残して合わせ、直交化する。 が増えるほど各ソースの方向が減る。Iso-C は合計更新を分解し、全特異値を平均値に変えて、弱い方向を相対的に強める。方向の組合せや強弱を変えるため、元の差分の平均とは明確に異なる。
Subspace Boosting は同じようには崩れない
三つ目は分けて見る。Subspace Boosting はマージ更新の特異値の累積比率で打切り点を選び、それより弱い特異値を打切り値まで引き上げる。TA や TIES の後に接続でき、結果も TA+SB、TIES+SB に分かれる。独立したモデル選択法ではない。
しきい値は 0.2 固定。TA+SB は少数版でばらつきが大きく、 は平均 23% しか基底に勝たないが、 では 100%、平均改善 +1.07。TIES+SB は安定し、十二版で +0.36。同じ条件の TSV-Merge は −2.36、Iso-C は −5.36 だった。部分空間法でも結果は異なる。TA+SB は TA 自体に近く、追加の特異値スペクトル操作による明確で安定した上積みはなかった。
モデルプールを整理してみる
付録では数学三専門、医療三専門を選び、Qwen3 4B と 8B で同領域の三つと、二領域の六つのマージを比べる。評価も数学と医療へ変える。8B は両領域を混ぜても個別マージと近く、4B の TA、TIES も保つが、一部の部分空間版には大きな差がある。
ランダムなプールには、重なりや方向の違う変更が混ざる。ソースの得意分野を確かめて目的を持って組むと、結果は変わる。主実験は整列、クラスタ分け、候補選別を意図的に省いており、慎重に選んだすべての配合の価値を判定する実験としては使えない。
距離解析も同じ範囲で使いたい。同一家族で変更ノルムと低下の相関は有用な異常の手がかりだが、規模や正規化が異なるネットワーク間では、 の絶対値に 50 や 300 という共通のしきい値を適用できない。よい領域を離れる仮説を支えるもので、全候補の途中の損失障壁を直接測ったものではない。
結論
結論は二段階ある。
目的が異なり衝突しうるコミュニティ微調整版でも、最初期の単純なタスク算術で基底よりよくでき、版が多いほど安定する。
ただし改善幅は限られる。TIES と Model Stock は基底近く、一部の部分空間配合は低下し、TA+SB は TA の傾向に沿う。プール選択、normalization、評価プロンプトの固定が、この成績を読むために重要だ。
同じ基底で由来の異なる微調整版が一群あるなら、まずタスク算術で混ぜてみよう。凝った方法へ進む前に、マージ重みが基底からどこまで離れたかを測っておきたい。