原論文
Averaging Weights Leads to Wider Optima and Better Generalization
- 発表先
- UAI 2018国際会議
- arXiv への初回投稿
- arXiv:1803.05407
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingswa2018,
  title = {{Averaging Weights Leads to Wider Optima and Better Generalization}},
  author = {Pavel Izmailov and Dmitrii Podoprikhin and Timur Garipov and Dmitry Vetrov and Andrew Gordon Wilson},
  year = {2018},
  eprint = {1803.05407},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1803.05407}
}
2018 年 2 月末、Garipov、Izmailov らはモード連結性(mode connectivity)の論文を発表し、FGE というアンサンブル手法も提案した。訓練の終盤に短周期の循環学習率へ切り替え、学習率が底に達するたびに重みを保存する。最後に保存した複数のモデルで推論し、出力を平均する。
FGE は一つのモデルを訓練する時間で、良好なアンサンブルを得られる。しかし推論では、すべてのモデルを一度ずつ動かす必要がある。
2 週間後、同じ著者グループがこの論文を公開した。FGE の保存点をパラメータ空間で眺めると、よい領域の縁に散らばり、真ん中が空いていることに気づいた。
それなら、重みを直接平均して、真ん中に立てばいい。
問題の定義
SGD の軌跡上の重みを平均する発想自体は新しくない。凸最適化では、Ruppert が 1988 年に、Polyak と Juditsky が 1992 年に、反復点の平均によって収束が速くなることを解析している。ニューラルネットワークでも、減衰する学習率とともに指数移動平均(EMA)を保つ実践があった。著者らが試すと、その EMA の収束後の性能は通常の SGD とほぼ同じだった。
問題は学習率にある。学習率を減衰し続けると、SGD の軌跡は一点に収束する。そこで平均しても軌跡を少し滑らかにする程度で、平均しない結果とあまり変わらない。
著者らは SGD によい領域をもう少し歩かせ、その後で平均したいと考えた。平均した点の汎化がよくなる理由も調べている。
問題を解く
アルゴリズム
SWA の手順は短い。
- 通常の学習率スケジュールで訓練する。論文では総予算の約 75% まで進める。
- 固定学習率、または から へ線形に減衰する循環学習率に切り替え、訓練を続ける。
- 固定の 反復ごとに、その時点の重み を平均へ加える。循環学習率では を 1 周期にし、学習率が最も低い時点で点を取る。
- 訓練終了後、 を最終モデルにする。
第 3 ステップは逐次更新する算術平均だ。 は取り込んだ点の数で、0 から始める。最初の点がそのまま平均となり、二つ目を加えると各点が半分ずつになる。三つ目では古い平均に 、新しい点に を掛け、最終的に各点が ずつになる。すべての重みを保存する必要はなく、新しい点ほど大きく重みづけする EMA とも異なる。
循環学習率の細部も分けておこう。SWA は 1 周期の中で線形に下げるだけで、底に達すると上限へ直接戻す。
FGE の三角形の周期には、ゆっくり上げ直す後半がある。SWA はその部分を省く。最後の平均がよければ、途中の各スナップショットの精度は多少低くてもよいからだ。固定学習率でより遠くまで進み、個々の点の性能が下がっても、平均ではよい結果が得られる。
論文の CIFAR 設定では、VGG と WRN の SWA 段階は固定学習率 0.01。Preactivation ResNet は CIFAR-10 で 0.01、CIFAR-100 で 0.05 を使い、毎エポック一度収集する。PyramidNet は 3 エポックの周期で 0.05 から 0.001 へ下げる。各アーキテクチャに合わせた設定なので、実装時も自分の検証データで開始時点と学習率を選ぶ必要がある。
BatchNorm は再計算する
見落としやすい点がある。BatchNorm があるネットワークでは、訓練中に蓄積した平均と分散は各 に対応し、 用にはなっていない。著者らは訓練終了後、 で訓練データをもう一度順伝播し、統計量を集め直す。
PyTorch は後に、逐次平均と統計量の再計算を torch.optim.swa_utils に実装した。線形層と BatchNorm だけの小さなネットワークで違いを見てみよう。二つのスナップショットの線形重みを、単位行列の 1 倍と 3 倍にする。
import torch
from torch import nn
from torch.utils.data import DataLoader
from torch.optim.swa_utils import AveragedModel, update_bn

model = nn.Sequential(nn.Linear(2, 2, bias=False), nn.BatchNorm1d(2))
swa_model = AveragedModel(model)
with torch.no_grad():
    for scale in [1.0, 3.0]:
        model[0].weight.copy_(scale * torch.eye(2))
        swa_model.update_parameters(model)

print("平均權重:", swa_model.module[0].weight.tolist())
print("重算前的均值:", swa_model.module[1].running_mean.tolist())
loader = DataLoader(torch.tensor([[1., 2.], [3., 4.]]), batch_size=2)
update_bn(loader, swa_model)
print("重算後的均值:", swa_model.module[1].running_mean.tolist())
平均權重: [[2.0, 0.0], [0.0, 2.0]]
重算前的均值: [0.0, 0.0]
重算後的均值: [4.0, 6.0]
平均モデルの線形層は で、二つの入力は BatchNorm の前で と になる。そのため平均は になるはずだ。学習可能なパラメータだけを平均しても、running mean は元の のまま残る。update_bn で初めて新しい重みに合う。この例は統計量の更新だけを示し、分類器の訓練は行っていない。
実際の訓練では、SWA 段階に入った後も元のモデルを通常どおり勾配で更新し、サンプリング頻度に合わせて update_parameters を呼ぶ。すべての平均を終えてから update_bn を一度実行し、最後に eval() へ切り替えて評価する。再計算には訓練データを使い、ラベルも逆伝播も必要ない。
重みの平均がアンサンブルに近づく理由
FGE は出力を、SWA は重みを平均する。両者はいつ近くなるのか。著者らは一次展開で答えている。
FGE の保存点を 、その平均を 、各点との差を とすると、 になる。ネットワーク出力 を の近くで展開する。
について平均すると、一次項の和は となり、二次の項だけが残る。
点同士が十分近ければ、アンサンブル出力と平均重みの出力の差は二次の微小量になる。FGE は意図的に小さな歩幅で点を探すため、SWA は一つのモデルで FGE のアンサンブルを近似できる。
この導出には、近傍で が十分滑らかで、二次の剰余項も小さいという前提がある。遠く離れたモデルや、異なるランダム初期化から訓練したモデルでは が大きくなり、この展開から重み平均と出力平均の近さを結論づけられない。SWA が集めるのは、同じ訓練軌跡の後半の点だ。
著者らは CIFAR-100 の ResNet-164 で 20 エポックの FGE を実行した。隣接スナップショット間のクラス確率ベクトルの差の平均ノルムは 0.126、SWA と FGE アンサンブルの間では 0.079 だった。隣接スナップショットの予測クラス一致率は最大でも 87.33% だが、SWA とアンサンブルは 95.26%。一次項が相殺される導出を実測と照らし合わせると、出力は近いものの差は残っている。
議論
縁に立つ SGD
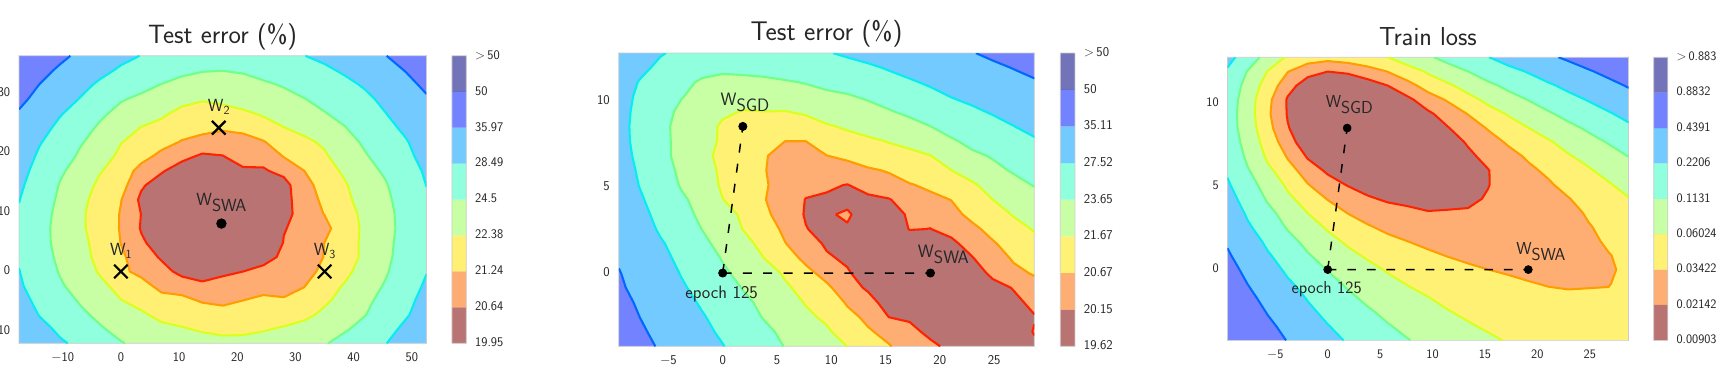
CIFAR-100 の Preactivation ResNet-164 の図だ。左を見ると SWA の動機がわかる。FGE の三つの標本は赤い領域の外周に並び、平均 は中央に位置する。
中央と右は一緒に読む。同じ 125 エポック目の重みから、SGD と SWA をそれぞれ最後まで実行している。右の訓練損失では、 は低損失領域に入っているが、縁に寄っている。中央のテスト誤り率では、 のほうが より最小誤り率の位置に近い。
訓練損失とテスト誤り率の地形は完全には重ならず、少しずれている。低損失領域の縁に立つと、地形がわずかにずれるだけでテスト誤り率が上がる。真ん中なら余裕がある。
著者らは二つの実験でこの説明を支える。一つ目は、各解から 10 本のランダム方向へ進む実験だ。下図の横軸は移動距離、左はテスト誤り率、右は訓練損失。青が SWA、緑が SGD で、各線が一つの方向に対応する。
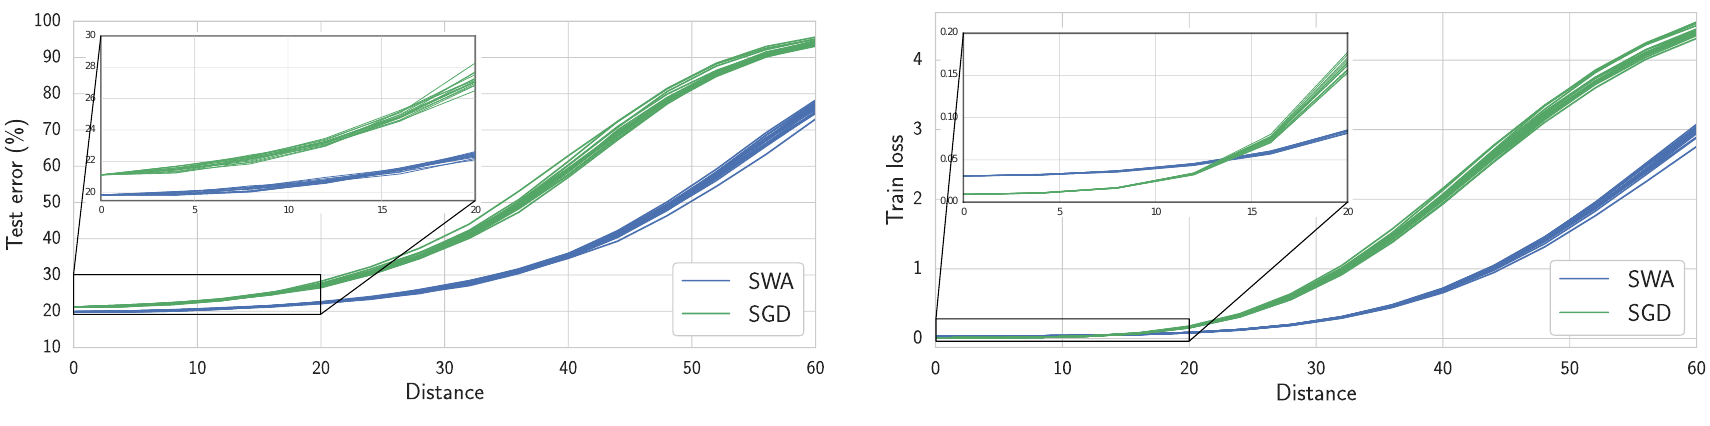
距離 0 では訓練損失は近く、SGD のほうが少し低いほどだ。しかし SWA の曲線はずっと広く、同じだけ誤り率が上がるまでに、より遠くへ動ける。この断面は、それぞれの解を離れた際の感度を調べている。
二つ目は と を結ぶ直線を調べるものだ。訓練損失とテスト誤り率の位置は明確にずれ、 は平坦な領域の境界にあり、すぐ隣が急斜面になっている。著者らは、SWA と SGD は同じ盆地にあり、SWA はその中のより平坦な位置を見つけると結論づける。訓練損失は少し高いことが多く、厳密には損失の局所最小点ではない。
CIFAR と ImageNet
CIFAR では通常のスケジュールで予算の約 75% を使い、残りを SWA に切り替える。CIFAR-100 の Preactivation ResNet-164 では、通常の SGD が 78.49%、同じ総予算の SWA は 79.77%。FGE アンサンブルの 79.84% にほぼ並び、推論は一つのモデルで済む。予算を 1.5 倍にすると SWA は 80.35% に達する。VGG-16 は 72.55% から 73.91%、WRN-28-10 は 80.82% から 81.46% になった。SWA Table 1
ImageNet では torchvision の訓練済みモデルに、循環学習率で 5 または 10 エポック追加する。
| モデル | SGD | SWA 5 epochs | SWA 10 epochs |
|---|---|---|---|
| ResNet-50 | 76.15 | 76.83 ± 0.01 | 76.97 ± 0.05 |
| ResNet-152 | 78.31 | 78.82 ± 0.01 | 78.94 ± 0.07 |
| DenseNet-161 | 77.65 | 78.26 ± 0.09 | 78.44 ± 0.06 |
Top-1 精度(%)。原論文 Table 2 より整理。
三つのアーキテクチャとも 0.6~0.9 ポイント改善し、追加したのは元の訓練量の一部だけだ。
予算と平坦さは分けて読む
ここまでの「同じ予算」は VGG、ResNet、WRN に当てはまる。PyramidNet と Shake-Shake は標準予算をすべて使った後に、0.25 または 0.5 予算分の SWA を追加しており、論文には の成績がない。CIFAR-100 の PyramidNet-272 は SGD の 83.41% から の 84.16% へ、CIFAR-10 の Shake-Shake は 96.93% から の 97.16% へ上がるが、 は 97.12% だった。平均回数や訓練量を増やす効果にも限りがある。
追加コストは、訓練中の平均重み一式の保存、標本を加えるたびのパラメータごとの加重計算、最後の BatchNorm 再推定の順伝播だ。デプロイ時には平均モデルだけを残すため、パラメータ数と 1 回の推論量は元のモデルと同じになる。活性値の保存量が大きい画像訓練では、著者らが測ったメモリ増加は小さい。重みがメモリの大部分を占める場合は、重み一式の追加を個別に評価する必要がある。
平坦さも読み直そう。測っているのは、指定したパラメータ表現における 10 本のランダム方向と、SGD から SWA への特定方向だ。特に後者では、SGD の片側が急で、もう片側は平らなことがわかる。ニューラルネットワークの地形の見かけの幅は、パラメータの再スケーリングでも変わるため、平坦さだけで汎化を説明することへの異論も論文は扱っている。この証拠が支えるのは、ここでのアーキテクチャと訓練設定の幾何的説明であり、実際には検証精度を直接測る必要がある。
結論
SWA の手順は短い。訓練後半の学習率を比較的高く保ち、通過した重みを平均し、BatchNorm を再計算する。考え方も難しくない。SGD がよい領域の縁に止まるところを、平均で中央へ戻す。
自分で使うときに忘れやすいのは最後の一手だ。BatchNorm があるなら、平均後に update_bn を実行し、統計量を平均重みに合わせよう。
この平均は、後に遠くまで広まった。2024 年の Llama 3 技術報告が後訓練のモデル平均を説明するとき、最初に引用しているのがこの論文だ。