原論文
Language Models are Super Mario: Absorbing Abilities from Homologous Models as a Free Lunch
- 発表先
- ICML 2024国際会議
- arXiv への初回投稿
- arXiv:2311.03099
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelmergingdare2023,
  title = {{Language Models are Super Mario: Absorbing Abilities from Homologous Models as a Free Lunch}},
  author = {Le Yu and Bowen Yu and Haiyang Yu and Fei Huang and Yongbin Li},
  year = {2023},
  eprint = {2311.03099},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2311.03099}
}
2023 年後半、Hugging Face には同じ Llama 2 から微調整したモデルが大量にあった。WizardLM は指示追従、WizardMath は数学に強く、プログラミング向けの版もある。
すべてできるモデルを作る直接的な方法は、データを集めて微調整し直すことだ。しかし重みだけ公開し、訓練データは取得できないモデルも多い。取得できても、13B、70B の再訓練は安くない。
Alibaba の Le Yu、Bowen Yu、Haiyang Yu、Fei Huang、Yongbin Li は、スーパーマリオがアイテムを取るようなものだと考えた。同じ系統のモデルの能力を、再訓練も GPU も使わず、直接「吸収」できるだろうか。
まず答えるのは、微調整が重みをどれほど変えるか、という基礎的な問いだ。
問題の定義
事前訓練重みを 、タスク の教師あり微調整(SFT)後を とし、差を delta パラメータと呼ぶ。
タスク算術のタスクベクトルと同じだ。TIES-Merging は、多くの delta が冗長で他モデルの重要な変更を薄めると指摘し、絶対値上位 20% だけを残した。
著者らの観察はさらに踏み込む。複数の言語モデルで SFT 前後の差を測ると、多くは 0.002 以内で、強い冗長性がある。大部分をそのまま捨てても、モデルは使えるのだろうか。
問題を解く
捨ててから、拡大する
DARE は Drop And REscale の略で、名前どおりの操作だ。
各 delta を確率 でゼロにし、残りに を掛ける。最後は とする。
捨て方はランダムで、大きさを見ない。TIES や通常の枝刈りと異なる点だ。
なぜ拡大するのか
線形層で考えよう。入力 、事前訓練重み 、バイアス 、差分 、 に対し、第 出力は、
DARE は delta だけを変える。各 は確率 で残って 倍され、確率 で 0 になる。その項の期待値は、
なら、元の に戻る。これは入力を固定した一つの線形層の等式だ。後ろには非線形性があり、前層のランダム変更は次層の入力も変えるため、モデル全体は別に測る必要がある。
著者らはこれを「大まかな証明」と呼ぶ。期待値を保っても、一度の抽出の誤差が小さいとは限らず、捨てられる量は実験で確認する。
二つの delta で見てみよう。 の等確率の四マスクをすべて列挙し、ネットワークは訓練しない。
import numpy as np
from itertools import product

delta = np.array([0.001, 0.002])
x = np.array([1., 2.])
p = 0.5
outputs = []
for dropped in product([0, 1], repeat=2):
    kept_delta = (1 - np.array(dropped)) * delta / (1 - p)
    outputs.append(float(kept_delta @ x))
print("各遮罩的 delta 輸出:", np.round(outputs, 6).tolist())
print(f"原本: {delta @ x:.6f}, 遮罩平均: {np.mean(outputs):.6f}")
各遮罩的 delta 輸出: [0.01, 0.002, 0.008, 0.0]
原本: 0.005000, 遮罩平均: 0.005000
四つの平均は正しいが、一つだけなら 0 にも、元の 2 倍にもなりうる。DARE がモデルを作る際にマスクを引くのは一度だけだ。デプロイ後に毎回引き直すことも、四モデルを全部実行することもない。能力保持を説明するには、ランダムな摂動の大きさも見る必要がある。
もう一歩進めると、固定の delta 値 に対する DARE 後の分散は、
ベルヌーイマスクから直接計算できる。 では倍率が 9、 では 99。delta と破棄率が大きいほど、一度の摂動を小さく抑えにくい。入力固定、マスク独立の線形層では、出力摂動の分散に各 が加算される。後の失敗例を理解する助けになるが、モデル規模と許容できる の関係は実験で決める必要がある。
マージの前処理にする
DARE 自体はマージしない。各モデルに先に適用し、その後で既存の手法へ渡す前処理だ。タスク算術なら、
非ゼロの delta が少なくなれば、モデル同士が重なる位置も減り、干渉を減らせると考える。
二モデルのマスクが独立なら、同じマスが両方で生き残る確率は 。 では、元は両 delta が変更しうる座標の約 1% だけが同時に残る。直接の重なりは減るが、残った値は 10 倍になる。品質は重なり、尺度、元モデルの能力を一緒に見る必要がある。
議論
どこまで捨てられるか
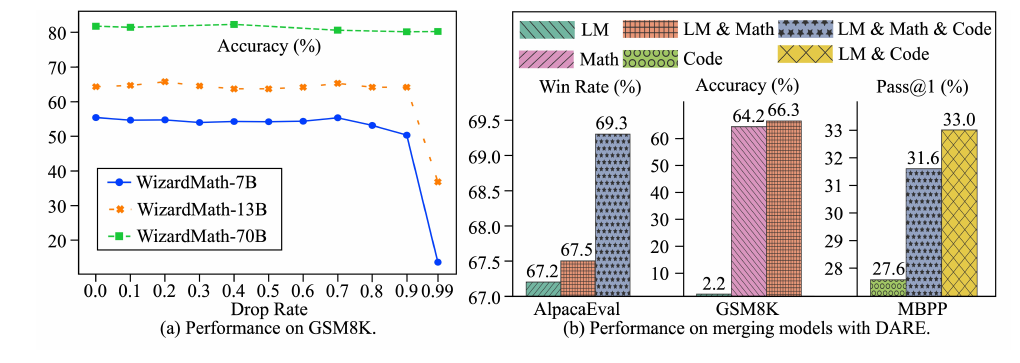
左は破棄率の WizardMath への影響だ。三サイズとも 90% まではほぼ変わらず、99% では 7B と 13B が崩れるが、70B は維持する。
著者らは、SFT の delta は 90%、場合によっては 99% 捨てられるほど冗長で、大きいモデルほど高い破棄率に耐えるとまとめる。encoder 系の BERT、RoBERTa の GLUE でも似た傾向があり、0.9 を超えてから明確に下がる。
探索値は 。Decoder の指示追従は AlpacaEval win rate、数学は GSM8K、MATH の精度、コードは HumanEval、MBPP の pass@1 を使い、greedy decoding で生成する。Encoder は BERT-base と RoBERTa-base の八 GLUE タスクで、精度、F1、相関係数などをタスク別に測る。各図の性能維持は各指標に対応し、WizardMath-70B の GSM8K での高い耐性を全専門モデルへ広げることはできない。
GLUE は元の訓練集合の 10% を検証に分け、公式 validation をテストにする。破棄率を保留データで選べる。最も極端な 99% は達成できた例であり、実用では低い破棄率から探索できる。
三つの 13B をマージする
Llama-2-13b 由来の WizardLM-13B(LM、指示追従)、WizardMath-13B(Math、数学)、llama-2-13b-code-alpaca(Code、コード)をマージする。WizardCoder-Python-13B は CodeLlama-13b-Python 由来で基底が違うため選ばない。
| モデル | DARE | AlpacaEval | GSM8K | HumanEval | MBPP |
|---|---|---|---|---|---|
| LM | – | 67.20 | 2.20 | 36.59 | 34.00 |
| Math | – | – | 64.22 | – | – |
| タスク算術:LM + Math | なし | 67.04 | 66.34 | 28.66 | 30.60 |
| タスク算術:LM + Math | あり | 67.45 | 66.26 | 26.83 | 32.40 |
| TIES:LM + Math | なし | 68.63 | 15.77 | 37.80 | 35.60 |
| TIES:LM + Math | あり | 68.70 | 36.16 | 36.59 | 37.00 |
| タスク算術:LM + Math + Code | なし | 69.03 | 58.45 | 18.29 | 29.80 |
| タスク算術:LM + Math + Code | あり | 69.28 | 56.48 | 23.17 | 31.60 |
原論文 Table 1 の一部より整理。「–」はそのモデルでは評価しない項目。
目立つのは 1 行目と 3 行目だ。WizardLM の GSM8K は 2.20 しかないが、WizardMath とタスク算術でマージすると 66.34 になり、WizardMath の 64.22 も上回る。これは DARE なしでもでき、加えた場合は 66.26 とほぼ同じだ。
DARE が特に役立つのは TIES だ。絶対値で先に刈る TIES は、この組合せでは数学能力を傷つけ、GSM8K が 15.77 になる。DARE の後に TIES を使うと 36.16 へ戻る。著者らは、DARE 後は delta の大半が 0 なので、TIES はその 0 を刈るだけとなり、有用な値を傷つけないと説明する。
この TIES は原論文の固定配合とも異なる。DARE 論文の decoder 実験は保持率 0.5、0.7、0.9、係数 0.5、1.0 を探索し、DARE の有無を比べる。このソースモデルと探索設定での改善を示しており、15.77 だけから他タスクでの TIES の効果を判断することはできない。
すべての数値がよくなるわけでもない。三モデルでは GSM8K が 58.45 から 56.48 に下がる。encoder で五つのマージ法に組み合わせた平均改善は −0.03%~0.84% にとどまり、マージモデルは単独の専門モデルに及ばないことも多い。
llama-2-13b-code-alpaca のコード能力が WizardLM-13B より弱いことにも気づいた。各ソースモデル自体が十分よく訓練されていることが、マージの前提だと結論づける。
拡大は必要だ
拡大の役割を調べるため、捨てるだけの DropOnly を作り、同じ入力で元のモデルと処理後の隠れ表現の近さを層ごとに比較する。
下図の左は WizardMath-7B の GSM8K 入力、右は BERT の CoLA 入力。横軸が層、縦軸が元の表現との平均コサイン類似度だ。同じ破棄率の DARE と DropOnly を対にして読む。
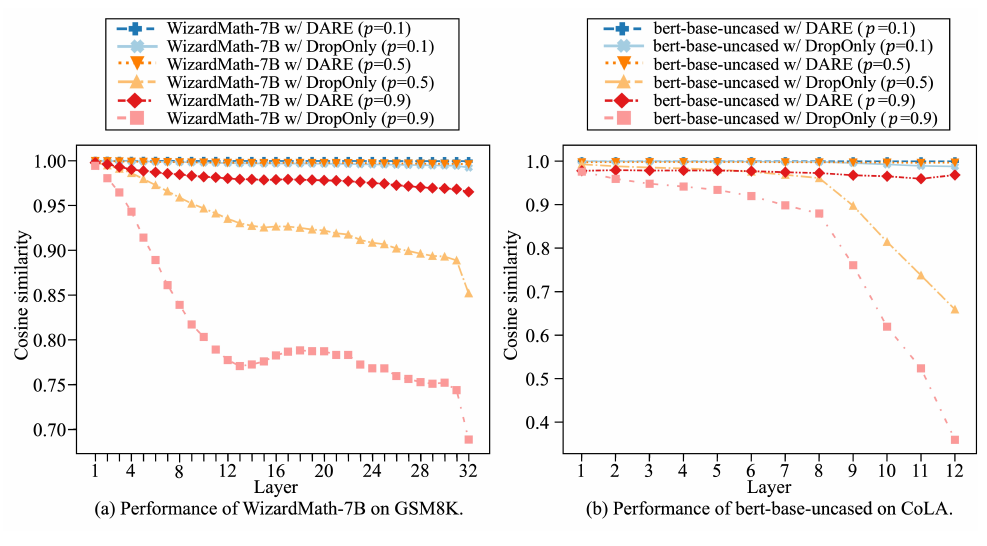
DARE は 90% 捨てても全層で 0.95 以上を保つ。DropOnly が保つのは だけで、WizardMath-7B では が約 0.85、 が約 0.68 に下がる。性能も同じく、捨てるほど両者の差が広がる。
絶対値による枝刈り(magnitude pruning、MP)後の拡大も比較する。7B で 70% 捨てると、AlpacaEval は 43.85 から 10.61、GSM8K は 46.70 から 0.37、HumanEval は 21.34 から 3.05 に落ちる。著者らは、大きい値だけを残してさらに拡大すると、出力が制御できなくなると考える。
使えないのはどんな場合か
前提は delta が小さいことだ。失敗例では WizardCoder-Python-13B の基底を、実際の CodeLlama-13b-Python でなく Llama-2-13b にして delta を求める。CodeLlama は Llama 2 からさらに 5,000 億のコード関連 token を訓練しており、重みが遠くまで動いている。この差は絶対値が 0.01 を超えることが多いが、CodeLlama-13b-Python との差は 0.0002 以内だ。
すると 10% 捨てるだけで、HumanEval と MBPP の pass@1 は 63.41、55.4 から 0 へ落ちた。継続事前訓練後は delta が約 0.03 に達し、DARE が適用できなくなる。
0.002 はこのモデル群での観察範囲で、構造を問わない安全しきい値ではない。尺度はモデルや層で変わり、入力も出力摂動を増幅する。正しい基底との差の分布を調べ、複数の で保持曲線を見るのが実用的だ。両方が「13B」で形状が一致するだけでは、同じ基底の共有を確かめたことにならない。
微調整後の重み全体を捨てると、delta だけの場合と違い、10% でも性能はほぼゼロに落ちるという。著者らは、SFT は新能力を加えるより、事前訓練にある能力を呼び起こしていると解釈する。
疎な delta と小さなモデルも区別したい。復元重みは で、基底は完全な dense モデルのままだ。差分を九割捨てても、推論のパラメータ数と行列積は自動的に九割減らない。「共通基底+疎な差分」の保存は複数版の保存量を減らせる可能性があるが、対応する形式と読み込みが必要だ。主に示したのは能力保持とマージであり、70B を 0.7B のネットワークに縮めてはいない。
ランキングに登場する
最後に Mistral-7B 由来を DARE でマージし、supermario v1、v2 を作った。2024 年 1 月 28 日には、v2 が Open LLM Leaderboard の 7B 級で平均 75.49 の首位だった。
並ぶ Beagle14-7B、NeuralBeagle14-7B も、モデルカードに mergekit によるマージとある。その頃の 7B 上位はマージモデルで埋まり、スコアにはデータ汚染の懸念も出始めた。
結論
DARE は方法以上に発見が面白い。SFT の重み変更は非常に小さく、大部分をランダムに捨てて残りを拡大しても使える。大きなモデルほど多く捨てられる。
前処理として干渉を減らすことが多く、特に TIES との組合せに役立つ。ただし改善が 1 ポイントに満たない場合もあり、後退することもある。
マージに使うなら、delta を実際の基底との差で求めたかを確認しよう。基底を間違えると、一割捨てただけで何も残らなくなる。